
Willekeurige normale gegevens genereren
Willekeurige normale gegevens genereren maakt een symmetrische, klokvormige willekeurige steekproef. U stelt het aantal rijen en kolommen, het gemiddelde, de standaardafwijking en het aantal decimalen in. Gebruik het om procesgegevens te simuleren voor regelkaarten of capabiliteitsanalyse, procedures te valideren of Monte Carlo-simulaties uit te voeren. Genereer minimaal 30 waarden. Er wordt geen vaste seed gebruikt, dus kopieer de gegevens om ze opnieuw te gebruiken.
Laatst beoordeeld
Belangrijkste conclusie
Willekeurige normale gegevens genereren levert een willekeurige steekproef uit een normale (gaussische) verdeling met het opgegeven gemiddelde en de standaardafwijking, om procesgegevens te simuleren en statistische procedures te testen.
Op deze pagina
- Wat is Willekeurige normale gegevens genereren?
- Wanneer gebruikt u Willekeurige normale gegevens genereren?
- Richtlijnen voor correct gebruik van Willekeurige normale gegevens genereren
- Alternatieven: wanneer u Willekeurige normale gegevens genereren niet gebruikt
- Voorbeeld van Willekeurige normale gegevens genereren
- Zo genereert u willekeurige normale gegevens
Wat is Willekeurige normale gegevens genereren?
Random Normal Data genereert een dataset met waarden die een normale (gaussische) verdeling volgen, de klassieke symmetrische klokvormige curve. U geeft het aantal rijen, het gemiddelde (het midden) en de standaardafwijking (de spreiding) op, en de tool levert een willekeurige steekproef uit die verdeling.
Eenvoudige definities: Genereert willekeurige getallen met de vorm van een klokcurve, gecentreerd op het gemiddelde dat u opgeeft en met een spreiding die door de standaardafwijking wordt bepaald.
Wanneer gebruikt u Willekeurige normale gegevens genereren?
- Gebruik het om procesgegevens te simuleren voor het testen van regelkaarten of capabiliteitsanalyse voordat er echte gegevens beschikbaar zijn.
- Gebruik het om statistische procedures te valideren door gegevens met bekende eigenschappen te genereren en te bevestigen dat de verwachte resultaten worden gevonden.
- Gebruik het voor training, onderwijs en Monte Carlo-simulaties van normaal verdeelde processen.
Richtlijnen voor correct gebruik van Willekeurige normale gegevens genereren
- Er wordt geen vaste seed gebruikt, dus elke Calculate geeft nieuwe waarden; kopieer de gegenereerde gegevens als u dezelfde dataset opnieuw wilt gebruiken.
- Gebruik realistische waarden voor het gemiddelde en de standaardafwijking wanneer u het werkelijke procesgedrag simuleert.
- Genereer minimaal 30 waarden zodat de normale vorm duidelijk tot uiting komt.
Alternatieven: wanneer u Willekeurige normale gegevens genereren niet gebruikt
- Als het proces rechtsscheef en altijd positiefis, gebruik dan Random Lognormal Data
- Voor goed/fout-aantallengebruikt u Random Binomial Data
- Voor simulaties van de tijd tussen storingengebruikt u Random Exponential of Weibull Data
Voorbeeld van Willekeurige normale gegevens genereren
De volgende stappen om Willekeurige normale gegevens te genereren:
- Om Willekeurige normale gegevens te genereren, vult u de vereiste opties in.
- Analyseer de gegevens nu in Zometric Statistical Software op https://statsai.zometric.com/.
- Kies voor Willekeurige normale gegevens genereren Statistical module> Random Data > Generate Random Normal Data
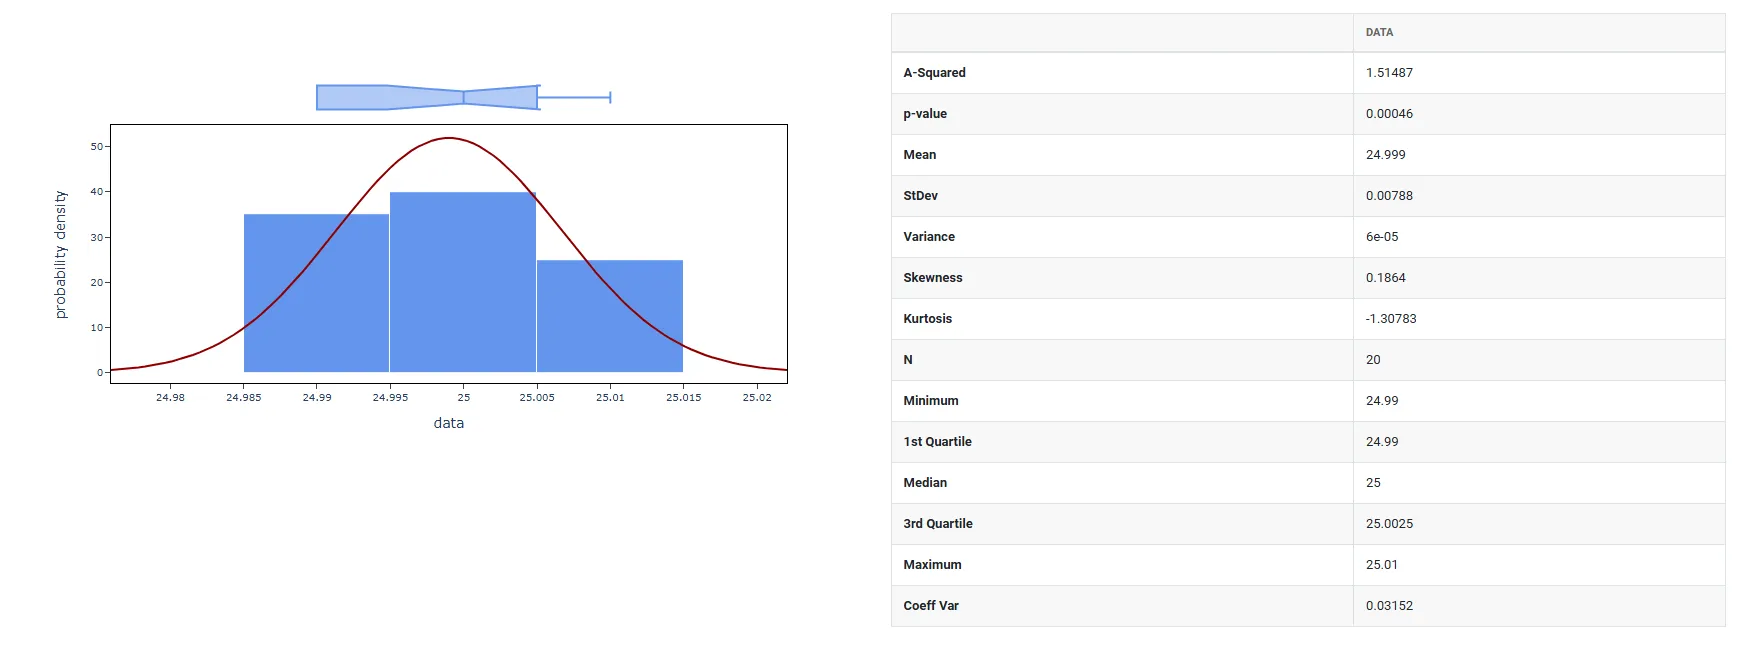
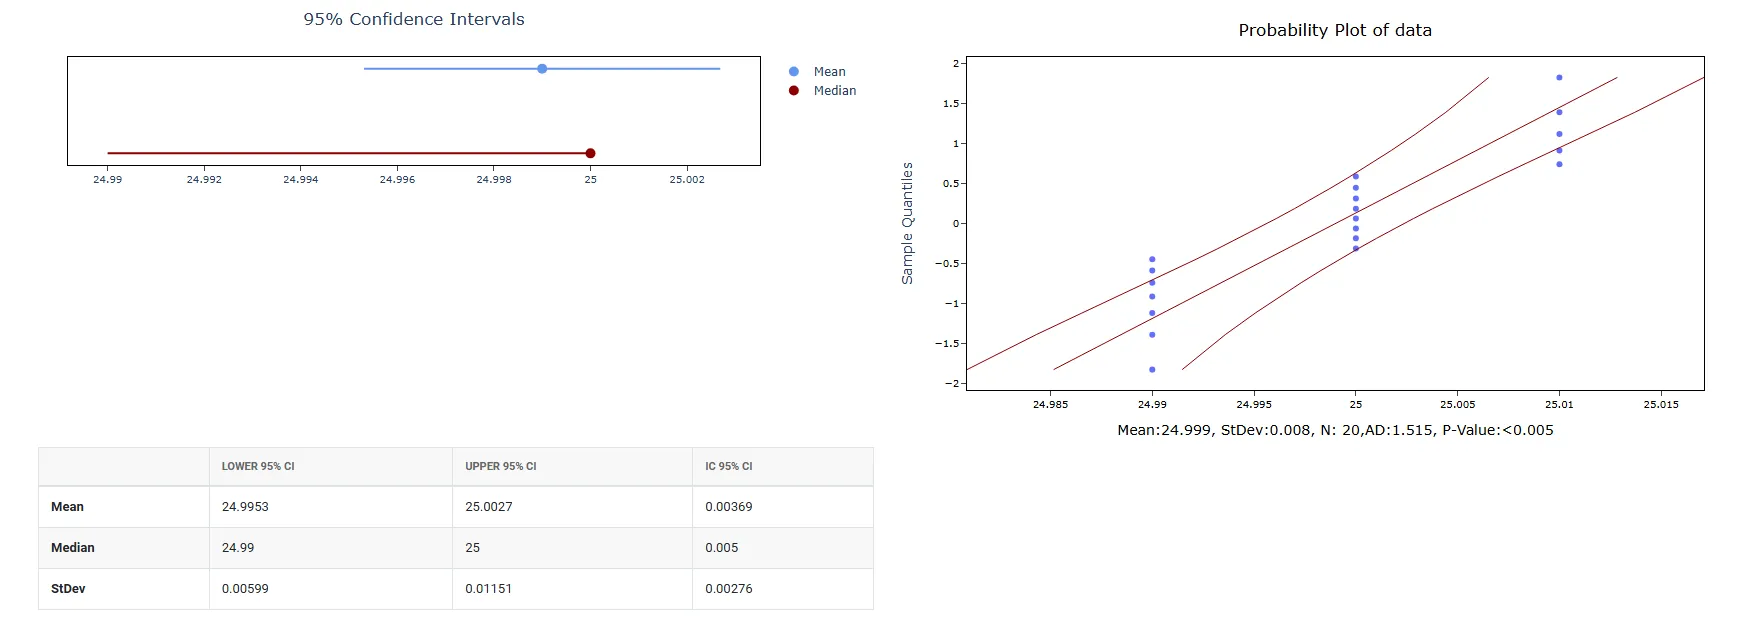
4. Na gebruik van bovenstaande tool wordt de uitvoer als volgt weergegeven:
Zo genereert u willekeurige normale gegevens
De handleiding is als volgt:
- Log in bij Zometric Statistical Software op https://statsai.zometric.com/
- Kies op de startpagina Statistical Tool> Random Data>Generate Random Normal Data.
- Vul vervolgens de vereiste opties in.
- Klik ten slotte onderaan de pagina op Calculate en u krijgt de gewenste resultaten.
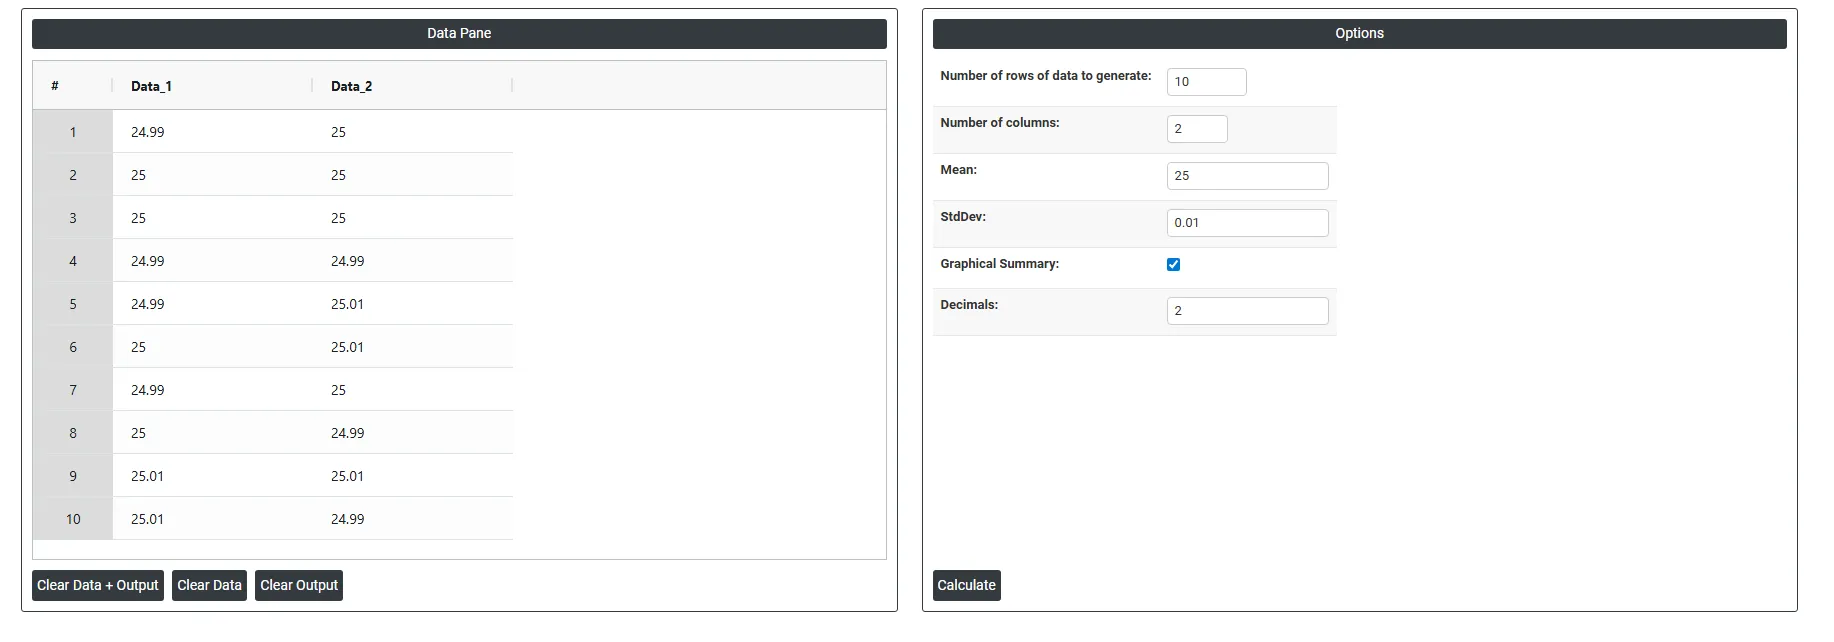
Op het dashboard van Willekeurige normale gegevens genereren is het venster in twee delen verdeeld.
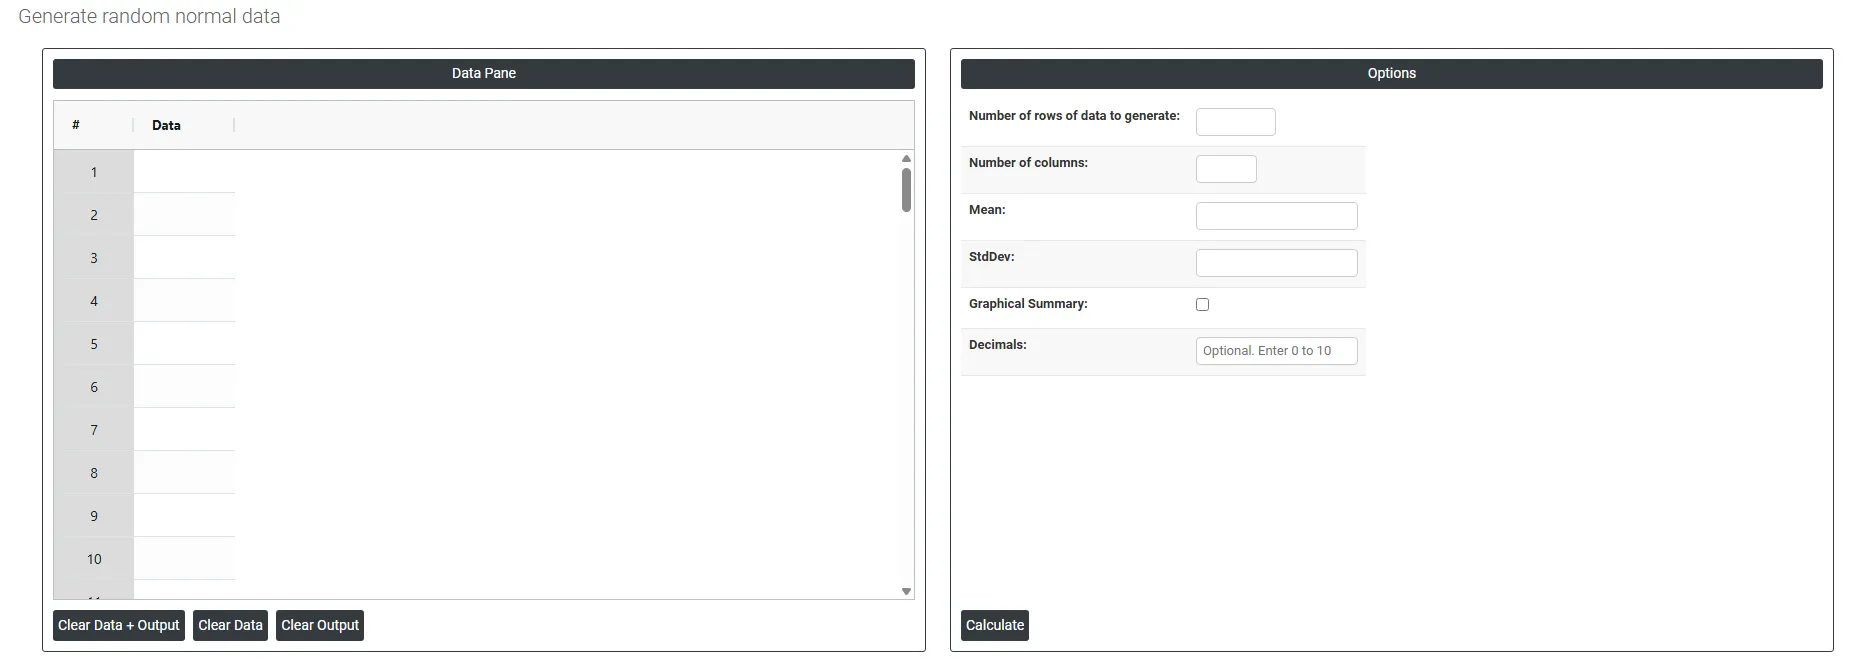
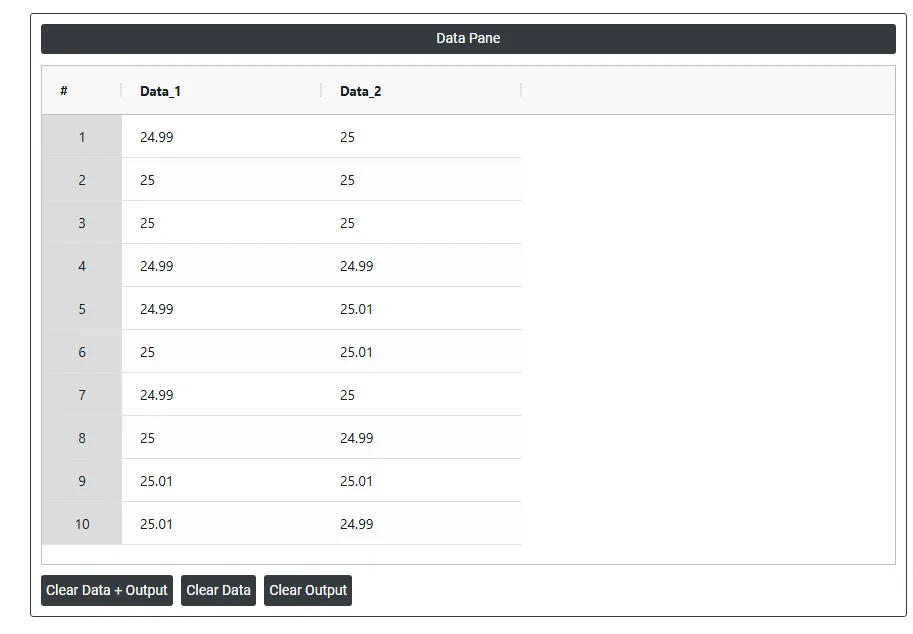
Links bevindt zich de Data Pane. In de Data Pane vormt elke rij gegenereerde willekeurige gegevens. De gegevens worden gegenereerd nadat u de vereiste opties hebt ingevuld.
Rechts staan veel opties, als volgt:
- Number of rows of data to generate: Geeft aan hoeveel willekeurige datapunten worden gegenereerd. Bij 10 worden bijvoorbeeld precies 10 rijen met willekeurige waarden gemaakt, allemaal zichtbaar in de data pane.
- Number of columns: Geeft aan hoeveel variabelen (kolommen) elke rij heeft. Bij 3 worden bijvoorbeeld 3 kolommen met willekeurig gegenereerde gegevens naast elkaar in de data pane gemaakt.
- Mean: De gemiddelde waarde die als middelpunt wordt gebruikt bij het genereren van de willekeurige gegevens. De willekeurige getallen worden rond deze waarde verdeeld; als u het gemiddelde dus op 50 zet, clusteren de gegenereerde gegevens rond 50, met waarden die boven en onder dit punt spreiden volgens de standaardafwijking.
- StdDev (standard deviation): Bepaalt hoe ver de gegenereerde waarden van het gemiddelde spreiden. Een kleine waarde houdt de getallen dicht rond het gemiddelde bijeen; een grote waarde geeft een bredere spreiding. De willekeurige gegevens worden met deze parameter gegenereerd, en de grafische samenvatting analyseert en toont die spreiding vervolgens visueel.
- Graphical summary: Nadat de willekeurige gegevens zijn gegenereerd met het gemiddelde en de standaardafwijking die u hebt opgegeven, levert deze optie een grafische analyse van die gegevens, zoals een histogram dat laat zien hoe de gegenereerde waarden zijn verdeeld. Het is een visueel resultaat op basis van de zojuist gemaakte gegevens.
- Decimals: Bepaalt het aantal decimalen van de gegenereerde willekeurige waarden zelf. Bij 2 wordt bijvoorbeeld elk gegenereerd getal afgerond op 2 decimalen, zoals 47.83 of 52.16. Bij 0 worden alleen gehele getallen gemaakt.
Veelgestelde vragen
Wat doet Willekeurige normale gegevens genereren?
Het genereert een dataset met waarden die een normale (gaussische) verdeling volgen, de symmetrische klokvormige curve. U geeft het aantal rijen, het gemiddelde (het midden) en de standaardafwijking (de spreiding) op, en de tool levert een willekeurige steekproef uit die verdeling. U kunt ook het aantal kolommen en decimalen instellen.
Wanneer moet u willekeurige normale gegevens genereren?
Gebruik het om procesgegevens te simuleren voor het testen van regelkaarten of capabiliteitsanalyse voordat er echte gegevens beschikbaar zijn, om statistische procedures te valideren door gegevens met bekende eigenschappen te genereren en de resultaten te controleren, en voor training, onderwijs en Monte Carlo-simulaties van normaal verdeelde processen.
Hoeveel waarden moet u genereren voor normale gegevens?
Genereer minimaal 30 waarden zodat de normale vorm duidelijk tot uiting komt, en gebruik realistische waarden voor het gemiddelde en de standaardafwijking wanneer u het werkelijke procesgedrag simuleert. Er wordt geen vaste seed gebruikt, dus elke Calculate geeft nieuwe waarden; kopieer de gegenereerde gegevens als u dezelfde dataset opnieuw wilt gebruiken.
Wanneer gebruikt u een andere verdeling voor willekeurige gegevens in plaats van de normale?
Als het proces rechtsscheef en altijd positief is, gebruik dan in plaats daarvan willekeurige lognormale gegevens. Voor goed/fout-aantallen gebruikt u willekeurige binomiale gegevens. Voor simulaties van de tijd tussen storingen gebruikt u willekeurige exponentiële of Weibull-gegevens. Willekeurige normale gegevens passen bij continue, symmetrische, klokvormige processen.