
Individual Distribution Identification: beste verdelingsfit
Individual Distribution Identification fit meerdere kansverdelingen tegelijk aan uw gegevens en beoordeelt welke verdeling statistisch de beste fit geeft. In plaats van normaliteit te veronderstellen, toetst deze tool een breed scala aan verdelingen — waaronder Weibull, lognormaal, exponentieel, logistisch, gamma en andere — en rangschikt ze op hoe goed ze de vorm en het gedrag van uw gegevens beschrijven.
Laatst beoordeeld
Belangrijkste conclusie
Individual Distribution Identification fit meerdere kansverdelingen tegelijk aan uw gegevens en beoordeelt welke verdeling statistisch de beste fit geeft.
Op deze pagina
- Wat is Individual Distribution Identification?
- Wanneer gebruikt u Individual Distribution Identification?
- Richtlijnen voor correct gebruik van Individual Distribution Identification
- Alternatieven: wanneer u Individual Distribution Identification niet gebruikt
- Voorbeeld van Individual Distribution Identification
- Zo voert u Individual Distribution Identification uit
Wat is Individual Distribution Identification?
Individual Distribution Identification fit meerdere kansverdelingen tegelijk aan uw gegevens en beoordeelt welke verdeling statistisch de beste fit geeft. In plaats van normaliteit te veronderstellen, toetst deze tool een breed scala aan verdelingen — waaronder Weibull, lognormaal, exponentieel, logistisch, gamma en andere — en rangschikt ze op hoe goed ze de vorm en het gedrag van uw gegevens beschrijven.
Dit is essentieel voor capabiliteitsanalyse op niet-normale gegevens, waar het gebruik van de verkeerde verdeling onnauwkeurige schattingen van Pp, Ppk of Cp, Cpk en misleidende voorspellingen van het defectpercentage oplevert.
Eenvoudige definitie: Een tool die uw gegevens toetst aan veel verschillende statistische verdelingen en aangeeft welke het best past — zodat u een nauwkeurige capabiliteitsanalyse kunt uitvoeren, ook wanneer de gegevens niet normaal verdeeld zijn.
Wanneer gebruikt u Individual Distribution Identification?
- Gebruik het wanneer uw gegevens een normaliteitstoets niet doorstaan en u de juiste verdeling moet vaststellen vóór een capabiliteitsanalyse.
- Gebruik het bij procesgegevens die van nature scheef zijn — zoals cyclustijden, faaltijden, chemische concentraties of deeltjesgroottes.
- Gebruik het vóór het toepassen van niet-normale capabiliteitsanalyse om te zorgen dat de gekozen verdeling het procesgedrag nauwkeurig weergeeft.
- Gebruik het wanneer een Box-Cox-transformatie niet geschikt is — bijvoorbeeld wanneer de gegevens nullen of negatieve waarden bevatten.
Richtlijnen voor correct gebruik van Individual Distribution Identification
- Verzamel minstens 50 tot 100 datapunten om de verdelingsfit betrouwbaar te maken — kleine steekproeven geven te weinig informatie om tussen verdelingen te kunnen onderscheiden.
- Gebruik goodness-of-fit-statistieken (Anderson-Darling) en waarschijnlijkheidsplots samen bij het kiezen van de beste verdeling — vertrouw niet alleen op de p-waarde.
- Kies een verdeling die fysiek zinvol is voor het proces — een verdeling met de laagste AD-statistiek maar zonder fysieke grondslag is mogelijk niet de beste keuze.
- Zorg dat de gegevens afkomstig zijn van een stabiel, beheerst proces vóór het fitten van verdelingen — verdelingsfits op gegevens van een onstabiel proces leveren betekenisloze resultaten op.
- Overweeg Johnson- of Box-Cox-transformatie als alternatief wanneer geen standaardverdeling goed past.
Alternatieven: wanneer u Individual Distribution Identification niet gebruikt
- Als de gegevens al als normaal zijn bevestigd, ga dan direct verder met de standaard Procescapabiliteit (normale verdeling) — verdelingsidentificatie is dan onnodig.
- Als u alleen normaliteit wilt controleren zonder andere verdelingen te onderzoeken, gebruik dan een eenvoudige Normaliteitstoets
- Als de gegevens duidelijke fysieke grenzen of een bekend verdelingstypehebben, geef die verdeling dan rechtstreeks op in de capabiliteitsanalyse in plaats van alle opties te toetsen.
Voorbeeld van Individual Distribution Identification
Een ingenieur neemt een aselecte steekproef van capsules en registreert hun calciumgehalte. Om de best passende gegevensverdeling te bepalen, voert hij een individuele verdelingsidentificatie uit. De toets in de volgende stappen:
- De benodigde gegevens verzameld.
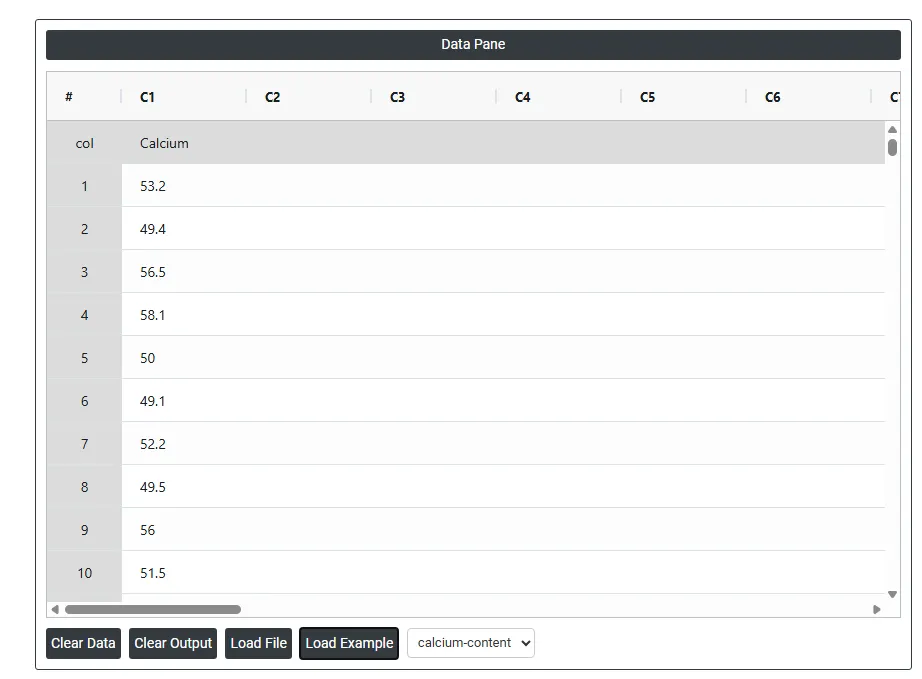
- Analyseer de gegevens nu in Zometric Statistical Software op https://statsai.zometric.com/.
- Om Individual Distribution Identification te vinden, kiest u Statistical module> Hypothesis Test> Individual Distribution Identification.
- Voer in de tool de gegevens en de overige invoer als volgt in:
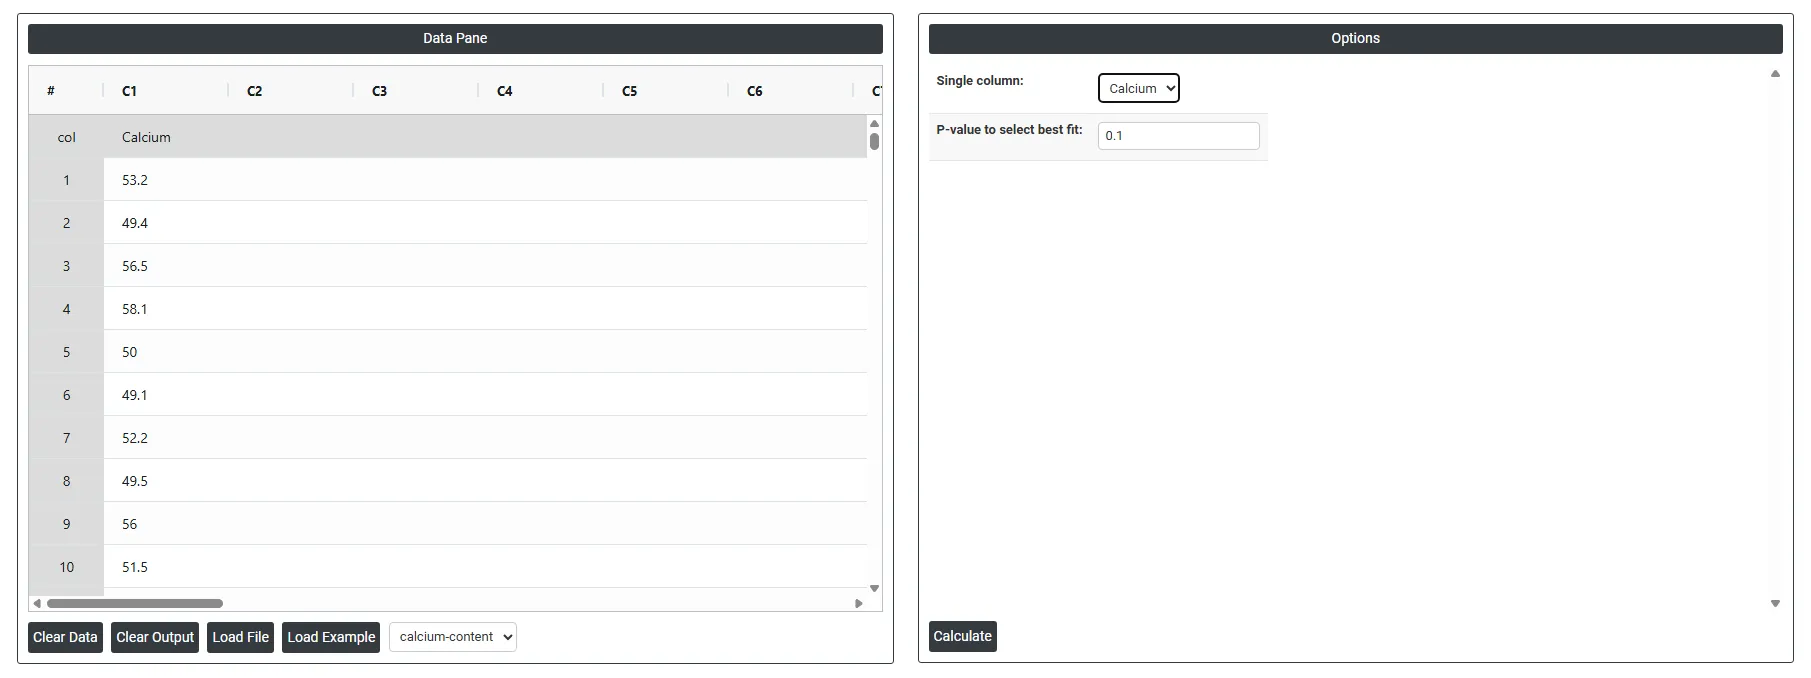
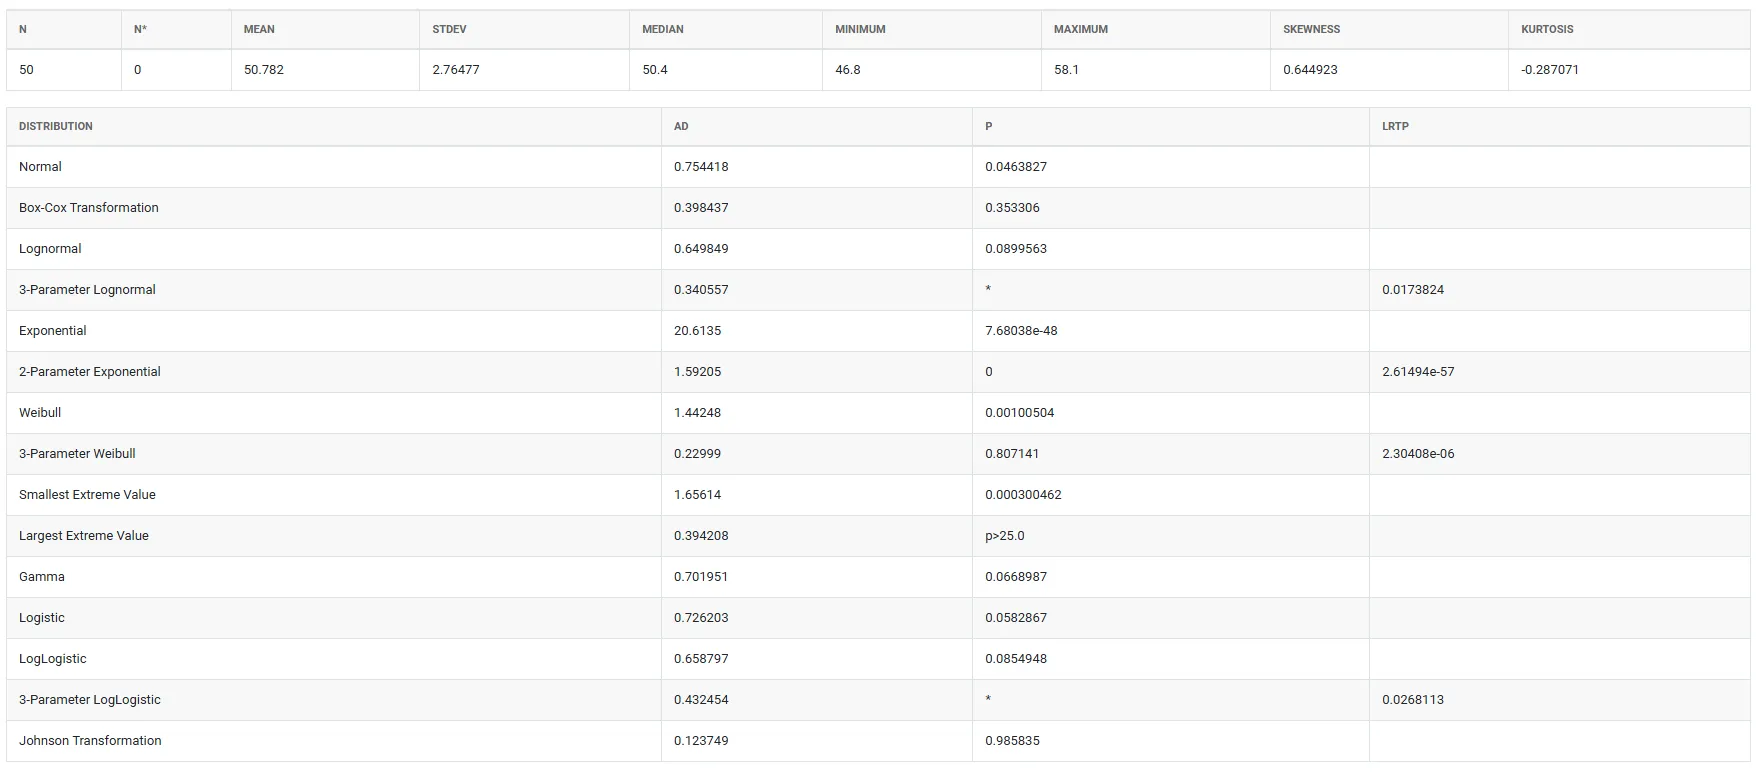
5. Na gebruik van de bovengenoemde tool wordt de uitvoer als volgt weergegeven:
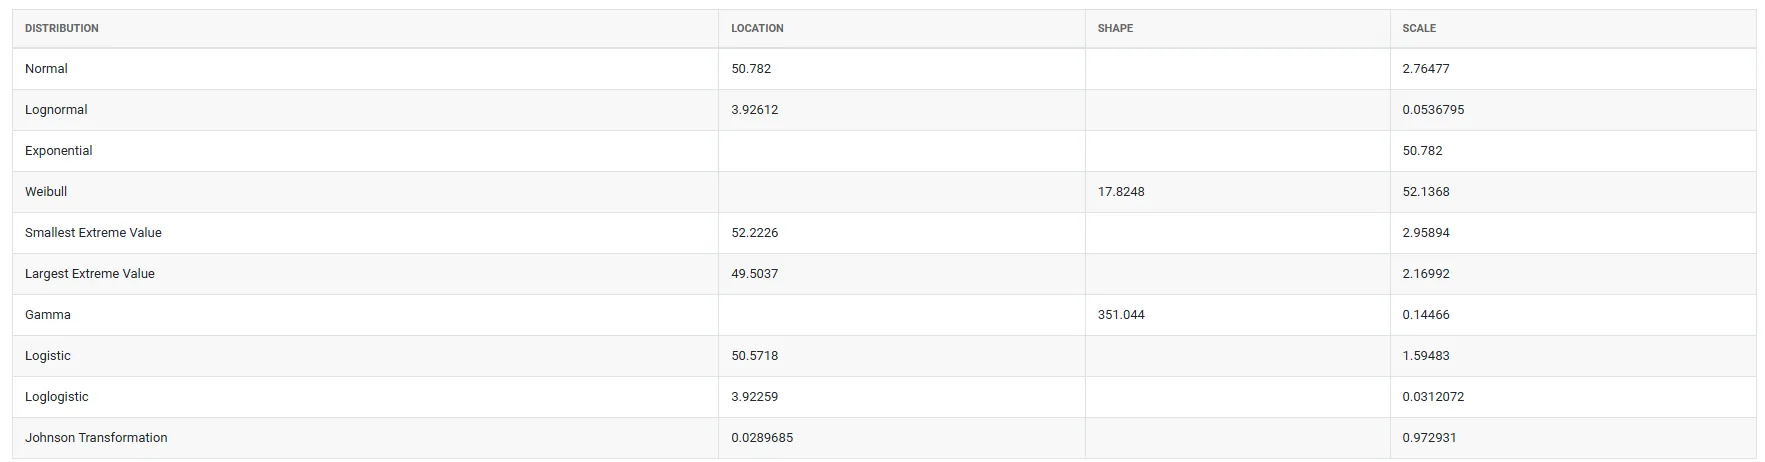
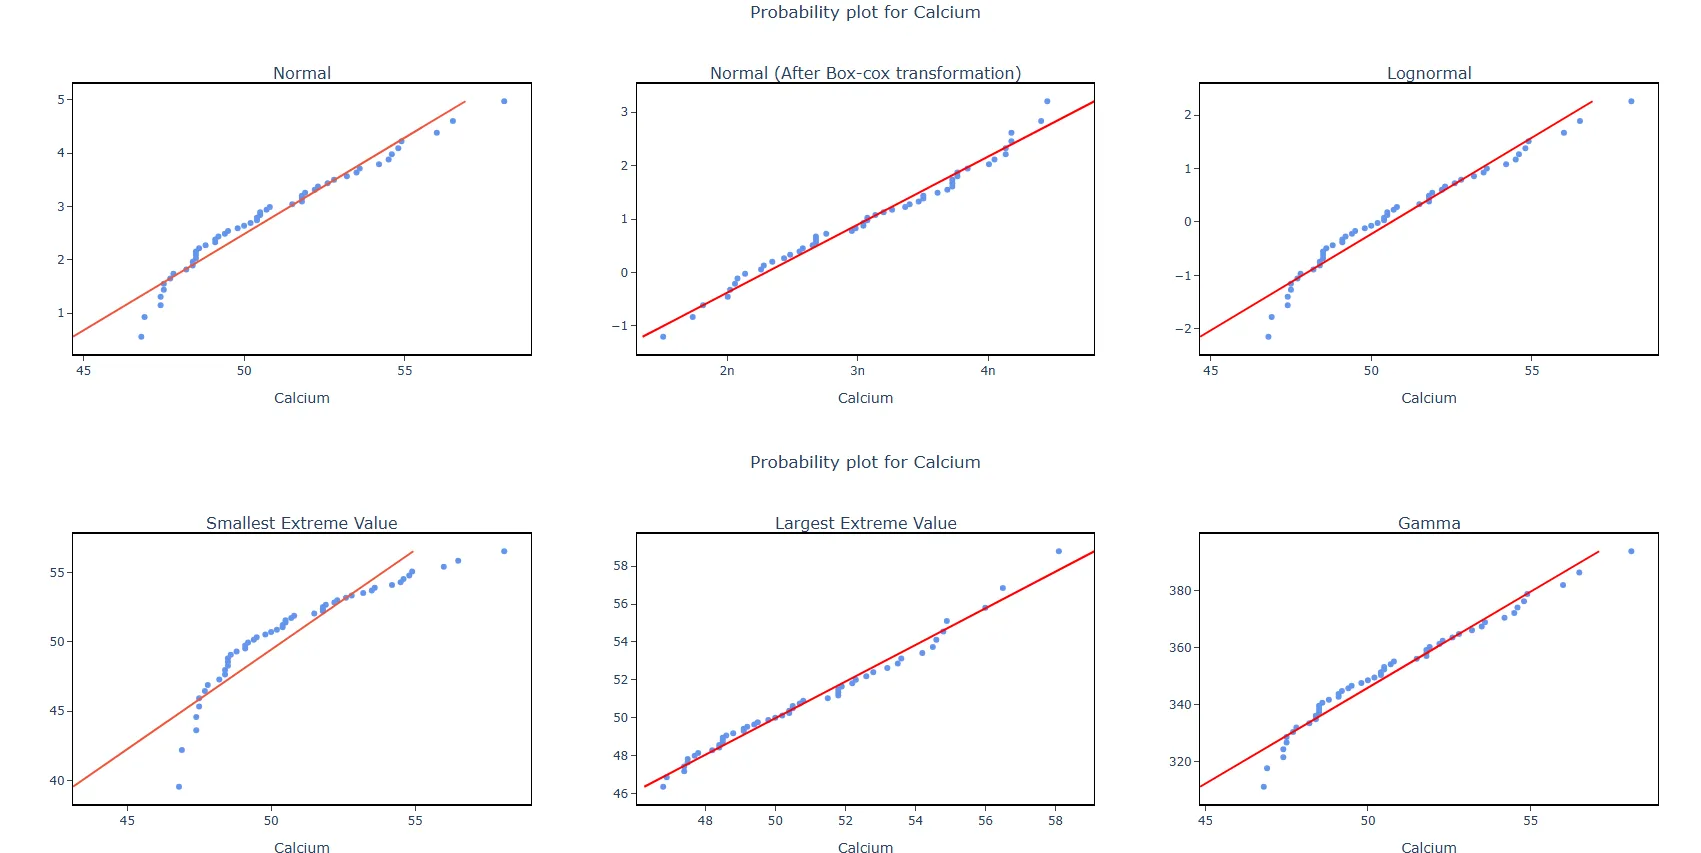
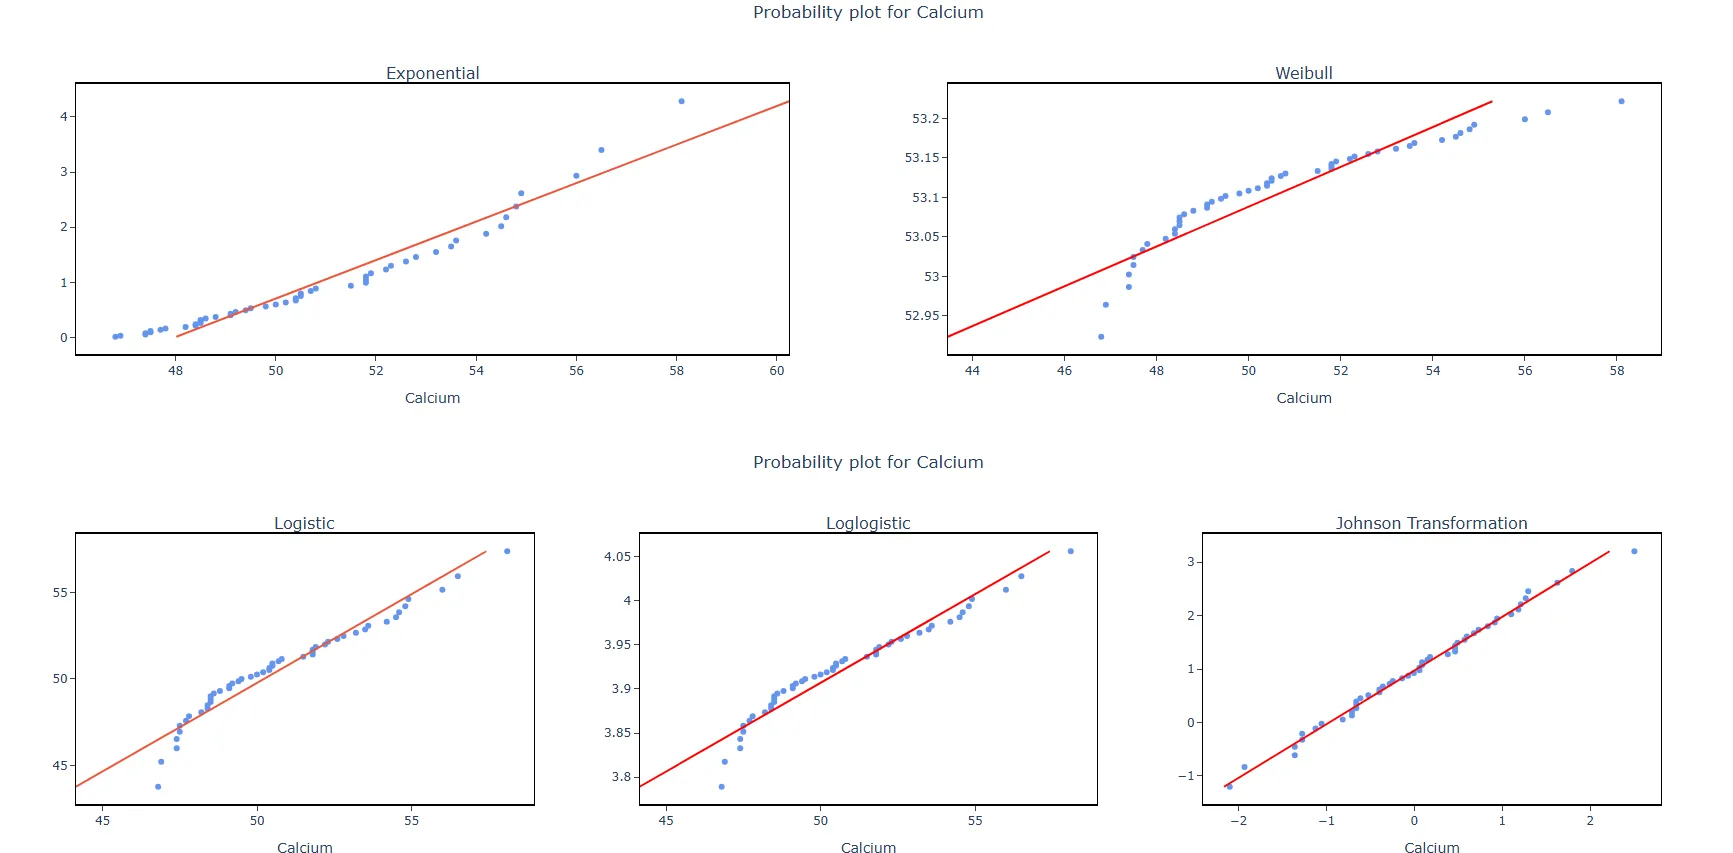
Zo voert u Individual Distribution Identification uit
De handleiding is als volgt:
- Meld u aan bij Zometric Statistical Software op https://statsai.zometric.com/
- Kies op de startpagina Statistical Tool> Hypothesis Test >Individual Distribution Identification .
- Werk vervolgens de gegevens handmatig bij, of kopieer (Ctrl+C) de gegevens volledig uit een Excel-blad en plak (Ctrl+V) ze hier.
- Vul de vereiste opties in.
- Klik ten slotte onderaan de pagina op Calculate en u krijgt de gewenste resultaten.
Op het dashboard van Individual Distribution Identification is het venster in twee delen verdeeld.
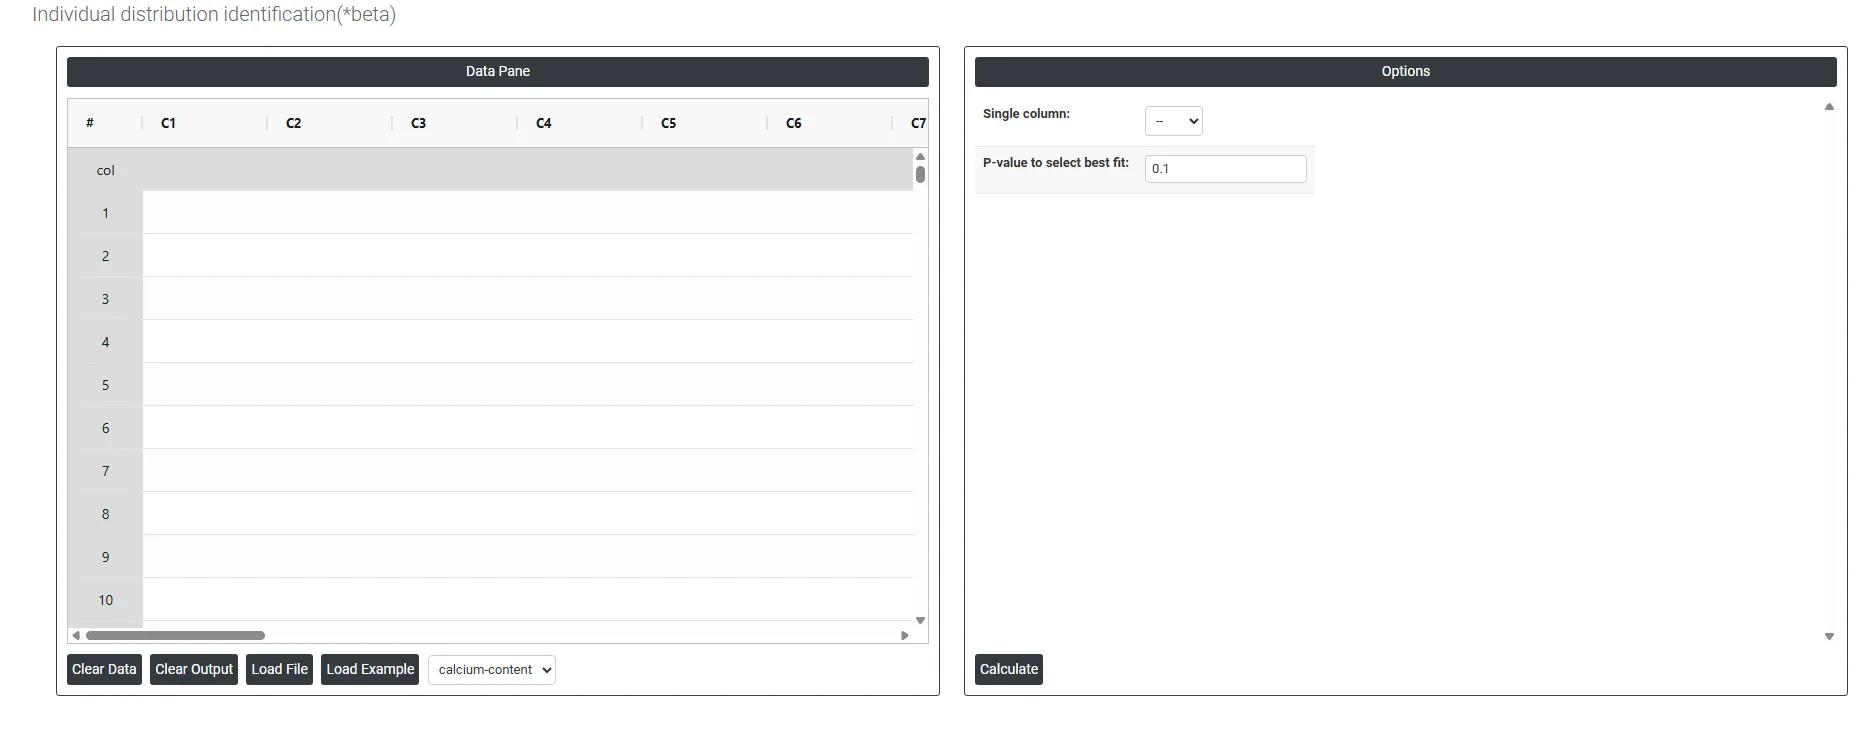
Links bevindt zich het Data Pane. In het Data Pane vormt elke rij één subgroep. Gegevens kunnen handmatig worden ingevoerd, of u kunt de gegevens volledig kopiëren (Ctrl+C) uit een Excel-blad en hier plakken (Ctrl+V).
Load example: Er worden voorbeeldgegevens geladen.
Load File: Hiermee laadt u Excel-gegevens rechtstreeks.
Rechts staan veel opties, als volgt:
- Single Column: Selecteer de kolom met de continue gegevens waaraan u verdelingen wilt fitten — bijvoorbeeld metingen zoals calciumgehalten, cyclustijden, treksterkte of deeltjesgroottes. De tool neemt alle waarden in deze kolom en toetst ze gelijktijdig aan meerdere kansverdelingen om te bepalen welke de vorm en het gedrag van uw gegevens het best beschrijft. Er kan slechts één kolom tegelijk worden geselecteerd, omdat elke variabele afzonderlijk wordt beoordeeld.
- P-Value to Select Best Fit: Stelt de significantiedrempel in waarmee wordt bepaald welke verdelingen een aanvaardbare fit met uw gegevens geven. De standaardwaarde is 0.05, wat betekent dat elke verdeling waarvan de Anderson-Darling-p-waarde voor de goodness-of-fit groter is dan 0.05 als statistisch aanvaardbare fit geldt — er is onvoldoende bewijs om die verdeling als model voor uw gegevens te verwerpen. Zo interpreteert u de p-waarde in deze context:
- P-waarde > 0.05 — de verdeling past acceptabel bij de gegevens. Hoe hoger de p-waarde, hoe sterker het bewijs dat de verdeling een goede match is.
- P-waarde ≤ 0.05 — de verdeling past niet goed bij de gegevens en mag niet worden gebruikt voor capabiliteitsanalyse of verdere modellering.
- Wanneer meerdere verdelingen aanvaardbare p-waarden geven, kies dan die met de hoogste p-waarde als primaire kandidaat — maar combineer dit altijd met een visuele beoordeling van de waarschijnlijkheidsplot en overweeg of de gekozen verdeling fysiek zinvol is voor uw proces. Een verdeling die statistisch past maar geen logische grondslag heeft voor uw gegevenstype, moet in twijfel worden getrokken vóór gebruik.
Veelgestelde vragen
Wat is individual distribution identification?
Individual distribution identification fit meerdere kansverdelingen tegelijk aan uw gegevens, waaronder Weibull, lognormaal, exponentieel, logistisch en gamma, en rangschikt ze op hoe goed ze de gegevens beschrijven. Het is essentieel voor capabiliteitsanalyse op niet-normale gegevens, omdat het gebruik van de verkeerde verdeling onnauwkeurige schattingen van Pp, Ppk, Cp of Cpk en misleidende voorspellingen van het defectpercentage oplevert.
Wanneer gebruikt u individual distribution identification?
Gebruik het wanneer gegevens een normaliteitstoets niet doorstaan en u vóór de capabiliteitsanalyse de juiste verdeling nodig hebt, wanneer procesgegevens van nature scheef zijn, zoals cyclustijden, faaltijden, chemische concentraties of deeltjesgroottes, en wanneer een Box-Cox-transformatie niet geschikt is, bijvoorbeeld omdat de gegevens nullen of negatieve waarden bevatten.
Hoe kiest u de best passende verdeling?
Een verdeling waarvan de Anderson-Darling-p-waarde boven de drempel ligt, standaard 0.05, is een aanvaardbare fit; op of onder de drempel mag de verdeling niet worden gebruikt. Wanneer meerdere verdelingen passen, neemt u die met de hoogste p-waarde als primaire kandidaat, maar bekijkt u ook de waarschijnlijkheidsplot en controleert u of de verdeling fysiek zinvol is voor het proces.
Hoeveel datapunten hebt u nodig voor distributie-identificatie?
Verzamel minstens 50 tot 100 datapunten, omdat kleine steekproeven te weinig informatie geven om tussen verdelingen te kunnen onderscheiden. De gegevens moeten bovendien afkomstig zijn van een stabiel, beheerst proces, omdat het fitten van verdelingen aan gegevens van een onstabiel proces betekenisloze resultaten oplevert.