
Procescapabiliteit voor meerdere variabelen (Multiple Variables Process Capability)
Multiple Variables Process Capability beoordeelt twee of meer kolommen, zoals holtes, machines of lijnen, tegen één gedeelde LSL/USL en een optionele Target. Gebruik het om het slechtst presterende proces te vinden zonder afzonderlijke rapporten te vergelijken. Elke variabele wordt als normaal verdeeld aangenomen, zonder normaliteitstoets per variabele. De uitvoer is één vergelijkingstabel met N, Mean, StDev, Pp, Ppk, Cpm en PPM, plus een histogram per variabele.
Laatst beoordeeld
Belangrijkste conclusie
Multiple Variables Process Capability vergelijkt meerdere parallelle processen, zoals matrijsholtes, machines of lijnen, met één gedeelde specificatie in één tabel met Pp, Ppk en Cpm, zodat zichtbaar wordt welk proces het slechtst is.
Op deze pagina
Doel
Multiple Variables Process Capability beantwoordt een specifieke, veelvoorkomende vraag die de bestaande capabiliteitstools van de app slechts indirect konden beantwoorden: wanneer hetzelfde kenmerk wordt gemeten over meerdere parallelle variabelen — verschillende holtes van een spuitgietmatrijs, verschillende machines, verschillende lijnen — tegen één gedeelde specificatie, welke is dan het slechtst? In plaats van N afzonderlijke capabiliteitsrapporten te draaien en ze op het oog te vergelijken, levert deze tool ÉÉN geïntegreerde vergelijkingstabel naast elkaar en één set histogrammen, zodat de indices van de Cp/Cpk-familie van elke variabele in dezelfde tabel staan.
Belangrijkste mogelijkheden
- Selecteer willekeurig 2 of meer kolommen en krijg één samengestelde vergelijkingstabel in plaats van N gestapelde rapporten.
- Eén LSL/USL-paar wordt uniform op elke geselecteerde variabele toegepast, zodat de vergelijking altijd appels met appels vergelijkt tegen dezelfde specificatie.
- Een optionele gedeelde Target voegt de Cpm-index per variabele toe aan dezelfde vergelijkingstabel.
- Histogrammen per variabele met de gedeelde specificatiegrenzen erover, naast de samengestelde tabel.
- Configureerbare K-sigma-tolerantiemultiplicator, in lijn met de andere capabiliteitstools van de app.
Statistische methoden
Elke geselecteerde variabele/kolom wordt behandeld als een onafhankelijk proces en doorloopt dezelfde engine voor normale capabiliteit die het normale pad van de tool Automated Process Capability gebruikt. Voor elk wordt σ_overall geschat met de methode van de voortschrijdende spreidingsbreedte (MRbar/d2, of mediaan van de voortschrijdende spreidingsbreedte), en wordt de standaard op z gebaseerde familie van prestatie-indices berekend: Pp = (USL − LSL) / (K·σ), Ppu = (USL − x̄) / ((K/2)·σ), Ppl = (x̄ − LSL) / ((K/2)·σ), Ppk = min(Ppu, Ppl), met de standaardwaarde K = 6. Elke variabele gaat hier altijd uit van normaliteit — er is in deze tool geen normaliteitstoets per variabele of routering voor niet-normale gegevens.
Wanneer een gedeelde Target is opgegeven, wordt per variabele ook Cpm berekend: Cpm = (USL − LSL) / (K·√(mean((x − Target)²))), waarmee een variabele wordt afgestraft waarvan het gemiddelde naast de streefwaarde ligt, ook als de spreiding alleen anders capabel zou lijken.
Omdat elke variabele wordt beoordeeld tegen dezelfde LSL/USL (en Target, indien opgegeven), zijn de resulterende Ppk- en Cpm-waarden rechtstreeks te vergelijken tussen variabelen — de variabele met de laagste Ppk (of Cpm) in de vergelijkingstabel is de slechtst presterende ten opzichte van de gedeelde specificatie.
PPM Expected wordt berekend uit de staartkans van de gefitte normale verdeling voorbij elke specificatiegrens voor die variabele; PPM Observed is de empirische fractie van de eigen steekproef van die variabele die buiten de specificatiegrenzen valt — zodat een gebruiker gevallen kan opsporen waarin beide verschillen (een teken dat de aanname van de normale verdeling voor die variabele mogelijk niet opgaat).
Invoervelden en opties
Veld | Beschrijving |
Process variables | Verplicht. Selecteer 2 of meer kolommen om te vergelijken — elke kolom wordt behandeld als een eigen proces. |
LSL / USL | Toegepast op elke geselecteerde variabele. |
Target | Optioneel. Voegt de Cpm-index per variabele toe aan de vergelijkingstabel. |
Tolerance (K) | Multiplicator die op sigma wordt toegepast bij het vormen van de capabiliteitstolerantieband; standaard 6. |
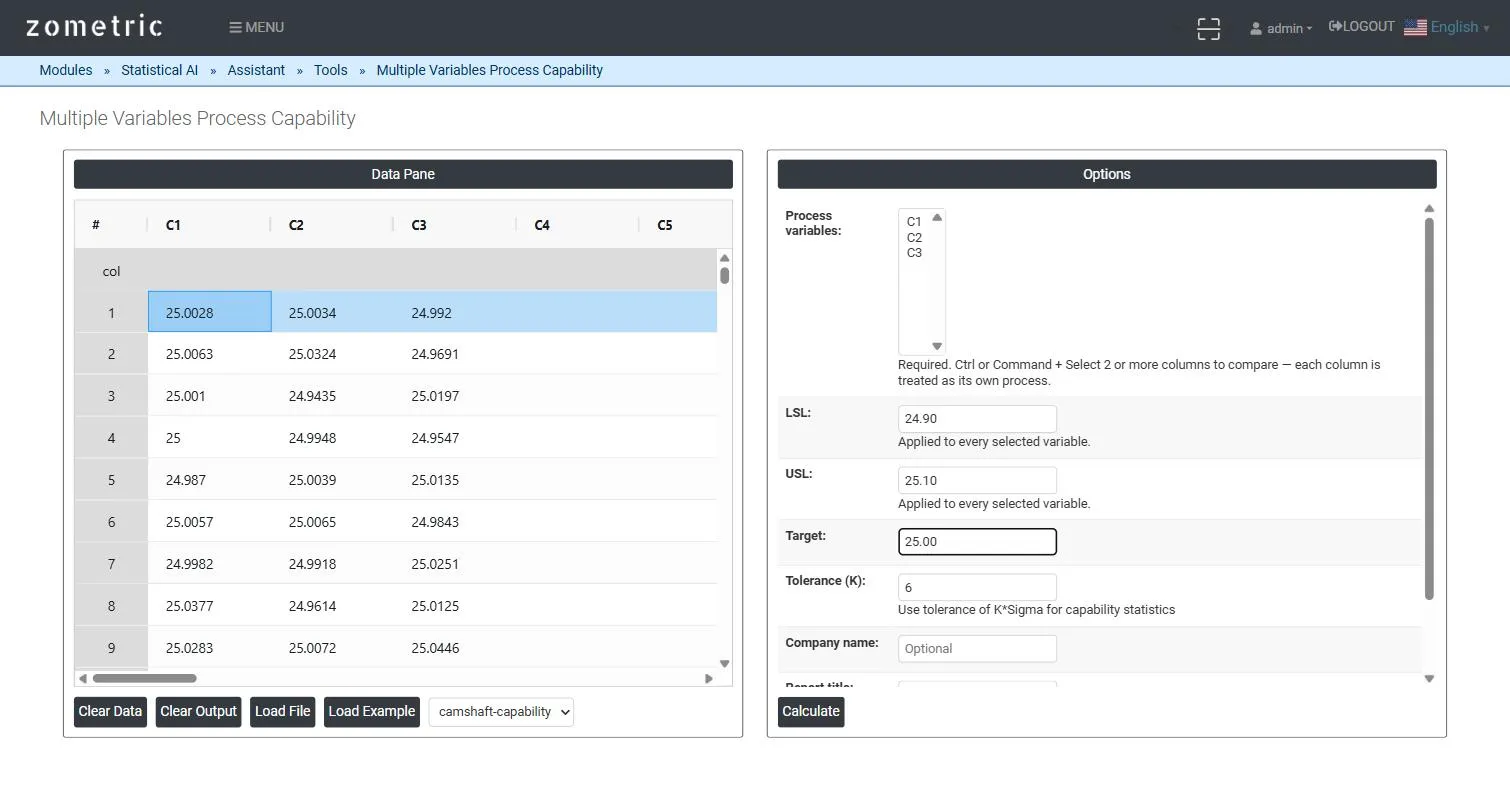
Figuur 1 — Data pane met boringsdiametermetingen van 3 holtes in C1–C3, alle drie geselecteerd als Process variables, met een gedeelde LSL/USL/Target.
Beschrijving van de uitvoer
- Comparison table — één rij per geselecteerde variabele met N, Mean, StDev, Pp, Ppl, Ppu, Ppk, Cpm (wanneer Target is opgegeven), PPM Expected en PPM Observed, alles tegen dezelfde gedeelde specificatiegrenzen.
- Per-variable histogram — de eigen verdeling van elke variabele met de gedeelde referentielijnen LSL/Target/USL en een gefitte normale curve.
- PDF-export van het volledige vergelijkingsrapport via Download as PDF.
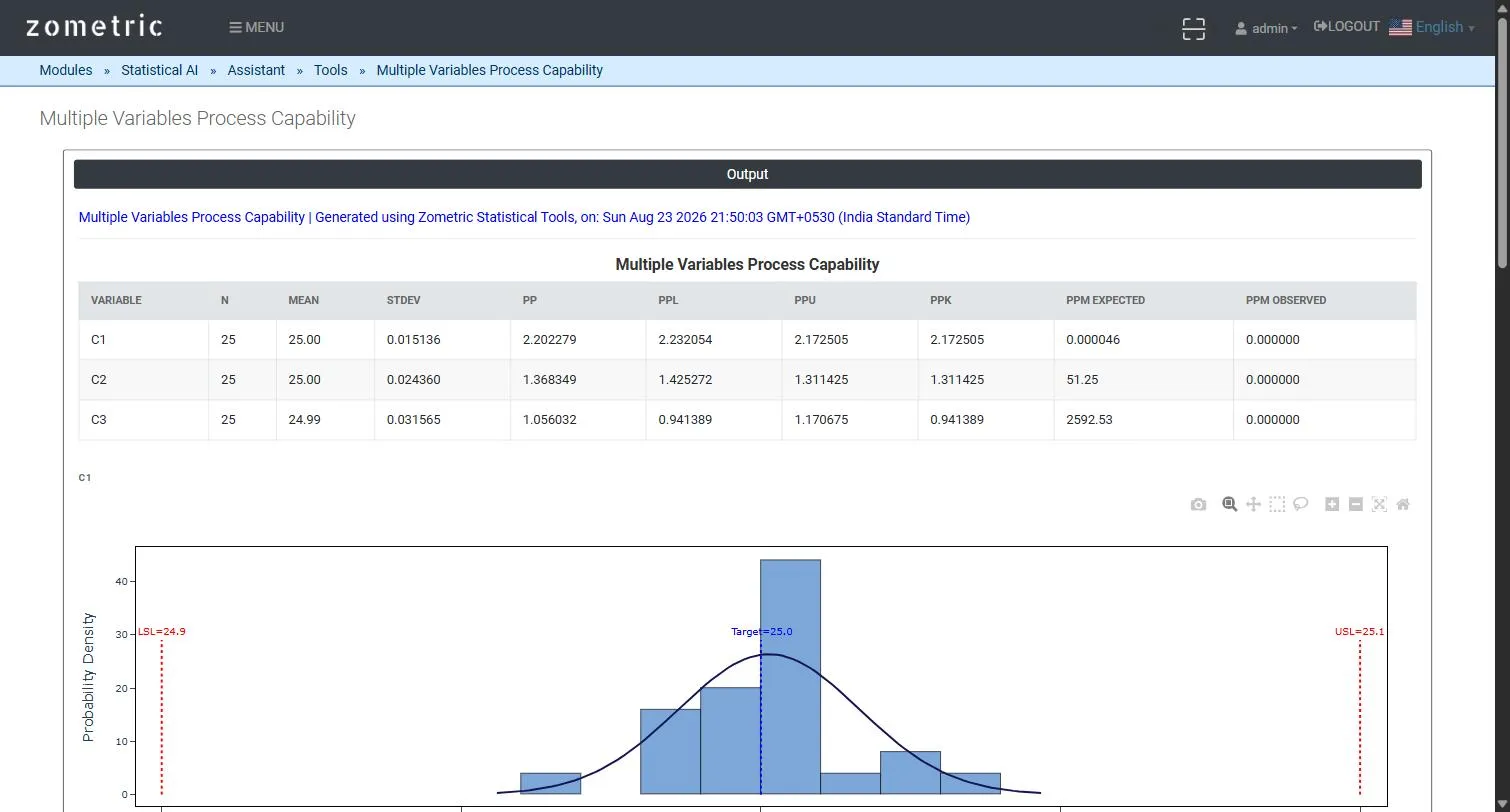
Figuur 2 — De geïntegreerde vergelijkingstabel (N, Mean, StDev, Pp, Ppl, Ppu, Ppk, Cpm, PPM Expected, PPM Observed per variabele) met het histogram van de eerste variabele.
Uitgewerkt voorbeeld
Een spuitgietmatrijs heeft 3 holtes die hetzelfde onderdeel produceren; de boringsdiameter (mm) wordt gemeten aan 25 onderdelen uit elke holte (C1 = holte 1, C2 = holte 2, C3 = holte 3), tegen een gedeelde LSL = 24.90, USL = 25.10, Target = 25.00. De vergelijkingstabel toont holte 1 met de kleinste spreiding (Ppk ≈ 2.17, Cpm ≈ 2.24) en holte 3 zichtbaar slechter (Ppk ≈ 0.94) — waardoor onmiddellijk holte 3 wordt aangewezen als de holte die aandacht nodig heeft, zonder dat drie afzonderlijke rapporten hoeven te worden gedraaid en handmatig vergeleken.
Veelgestelde vragen
Wat is Multiple Variables Process Capability?
Het is een capabiliteitsanalyse die hetzelfde kenmerk, gemeten over meerdere parallelle variabelen zoals verschillende matrijsholtes, machines of lijnen, vergelijkt tegen één gedeelde specificatie. In plaats van afzonderlijke rapporten levert het één vergelijkingstabel naast elkaar met Pp-, Ppl-, Ppu-, Ppk-, Cpm- en PPM-waarden, zodat de slechtst presterende variabele gemakkelijk te herkennen is.
Hoe herkent u het slechtste proces in een capabiliteitsstudie met meerdere variabelen?
Omdat elke variabele wordt beoordeeld tegen dezelfde LSL, USL en Target, zijn de Ppk- en Cpm-waarden rechtstreeks vergelijkbaar. De variabele met de laagste Ppk, of de laagste Cpm wanneer een Target is opgegeven, presteert het slechtst ten opzichte van de gedeelde specificatie en moet als eerste worden onderzocht.
Veronderstelt Multiple Variables Process Capability normaliteit?
Ja. Elke variabele wordt geanalyseerd met een berekening voor normale capabiliteit en er is geen normaliteitstoets per variabele of routering voor niet-normale gegevens. Het vergelijken van PPM Expected, uit de staart van de gefitte normale verdeling, met PPM Observed, de werkelijke fractie buiten de specificatie, helpt variabelen te vinden waarvoor beide verschillen, een teken dat de normaliteitsaanname mogelijk niet opgaat.
Wat voegt Cpm toe aan de vergelijking?
Wanneer een gedeelde Target is opgegeven, wordt Cpm voor elke variabele berekend als (USL - LSL) gedeeld door K maal de wortel uit de gemiddelde gekwadrateerde afwijking van de Target. Het straft een variabele af waarvan het gemiddelde naast de streefwaarde ligt, ook als de spreiding alleen anders capabel zou lijken.