
Procescapabiliteit meerdere variabelen (niet-normaal)
Deze tool vergelijkt de capabiliteit van twee of meer kolommen met één specificatie wanneer de gegevens scheef zijn, zoals deeltjesgrootte, vlakheid of onzuiverheid. Hij fit één gekozen model uit vijftien, waaronder Weibull, Lognormal, Box-Cox en Johnson, aan elke kolom, met de Z-Score- of ISO-methode. Elke kolom heeft minstens 4 waarden nodig. De uitvoer is een tabel met Pp, PPL, PPU, Ppk en PPM, plus histogrammen.
Laatst beoordeeld
Belangrijkste conclusie
Multiple Variables Process Capability (Nonnormal) vergelijkt meerdere processen met één specificatie wanneer de gegevens niet normaal zijn, past op elk dezelfde verdeling toe en zet Pp, Ppk en PPM naast elkaar.
Op deze pagina
Doel
Multiple Variables Process Capability (Nonnormal) vergelijkt de capabiliteit van meerdere processen, lijnen, machines of nesten met één specificatie wanneer de gegevens niet normaal verdeeld zijn. Het fit dezelfde verdeling afzonderlijk aan elke kolom en zet Pp, PPL, PPU, Ppk en de verwachte en waargenomen aantallen onderdelen per miljoen buiten specificatie naast elkaar in één tabel, met een histogram per kolom. Gebruik het voor scheve kenmerken zoals deeltjesgrootte, vlakheid, rondloop of onzuiverheid, waar een op de normale verdeling gebaseerde Ppk de staart verkeerd inschat, en u de processen wilt rangschikken.
Belangrijkste mogelijkheden
- Twee of meer kolommen, elk behandeld als een eigen proces en onafhankelijk gefit.
- Vijftien modellen: Weibull, Exponential, Logistic, Loglogistic, Largest en Smallest Extreme Value, 2-Parameter Exponential, 3-Parameter Weibull, Gamma, Lognormal, 3-Parameter Lognormal, 3-Parameter LogLogistic, Box-Cox- en Johnson-transformaties, en een Mixed Distribution (ISO 22514-2).
- Z-Score- of ISO-percentielmethode voor de indices.
- Eenzijdige of tweezijdige specificaties, toegepast op elke kolom.
- Vergelijkingstabel met Pp, PPL, PPU, Ppk, PPM Expected en PPM Observed, en een histogram van elke kolom met de specificatiegrenzen en de gefitte kromme.
Statistische methoden
Voor elke kolom wordt de gekozen verdeling gefit met maximum likelihood (Weibull, Gamma en Exponential met de drempelwaarde vast op 0; de 3-parametermodellen schatten die). Lognormal gebruikt het gemiddelde en de standaardafwijking van de gelogaritmeerde gegevens. Box-Cox en Johnson transformeren de gegevens naar normaal en werken op de getransformeerde schaal; de Mixed Distribution fit een mengsel van normale verdelingen, waarbij het aantal componenten wordt gekozen met BIC tenzij het vast is ingesteld. Elke kolom heeft minstens 4 waarden nodig.
Z-Score-methode (standaard): de gefitte kansen voorbij elke grens worden omgezet in normale scores, Z_USL = Φ⁻¹(F(USL)) en Z_LSL = Φ⁻¹(F(LSL)), waarbij F de gefitte cumulatieve verdeling is. Dan geldt PPU = Z_USL / 3, PPL = −Z_LSL / 3, Pp = (Z_USL − Z_LSL) / 6 en Ppk = min(PPL, PPU). ISO-methode: de indices gebruiken de gefitte percentielen X₀.₁₃₅, X₅₀ en X₉₉.₈₆₅ (de punten die hetzelfde ±3σ-aandeel dekken als bij een normale verdeling): Pp = (USL − LSL) / (X₉₉.₈₆₅ − X₀.₁₃₅), PPL = (X₅₀ − LSL) / (X₅₀ − X₀.₁₃₅), PPU = (USL − X₅₀) / (X₉₉.₈₆₅ − X₅₀). Met slechts één grens wordt Pp niet gegeven en is Ppk de eenzijdige index.
PPM Expected is het gefitte aandeel van de populatie buiten de grenzen, maal 1,000,000; PPM Observed is het aandeel van de steekproefwaarden buiten de grenzen. Dit zijn totale indices (lange termijn) uit alle gegevens. Ze zijn slechts zo goed als de verdeling: hetzelfde model wordt op elke kolom toegepast, dus controleer de fit van elke kolom (bijvoorbeeld met Identificatie van individuele verdeling) voordat u de kolommen vergelijkt.
Invoervelden en opties
Veld | Beschrijving |
Process variables | Vereist. Twee of meer numerieke kolommen om te vergelijken; elke kolom wordt afzonderlijk gefit. |
Fit distribution | Vereist. Een van de hierboven genoemde vijftien modellen (standaard Weibull), toegepast op elke kolom. |
Mixture components | Alleen voor Mixed Distribution (ISO 22514-2): Auto (gekozen met BIC, standaard) of 2 tot 6 componenten. |
Method of analysis | Z-Score (standaard) of ISO. |
LSL / USL | Specificatiegrenzen die op elke kolom worden toegepast; minstens één is vereist en LSL moet lager zijn dan USL. |
Company name / Report title | Optionele tekst voor het rapport; standaardtitel Multiple Variables Process Capability (Nonnormal). |
Data Options: Subset (optional) | Exclude matching rows (standaard) of Include only matching rows, op rijnummers (bijv. 3,7,12-15) en/of een voorwaarde. |
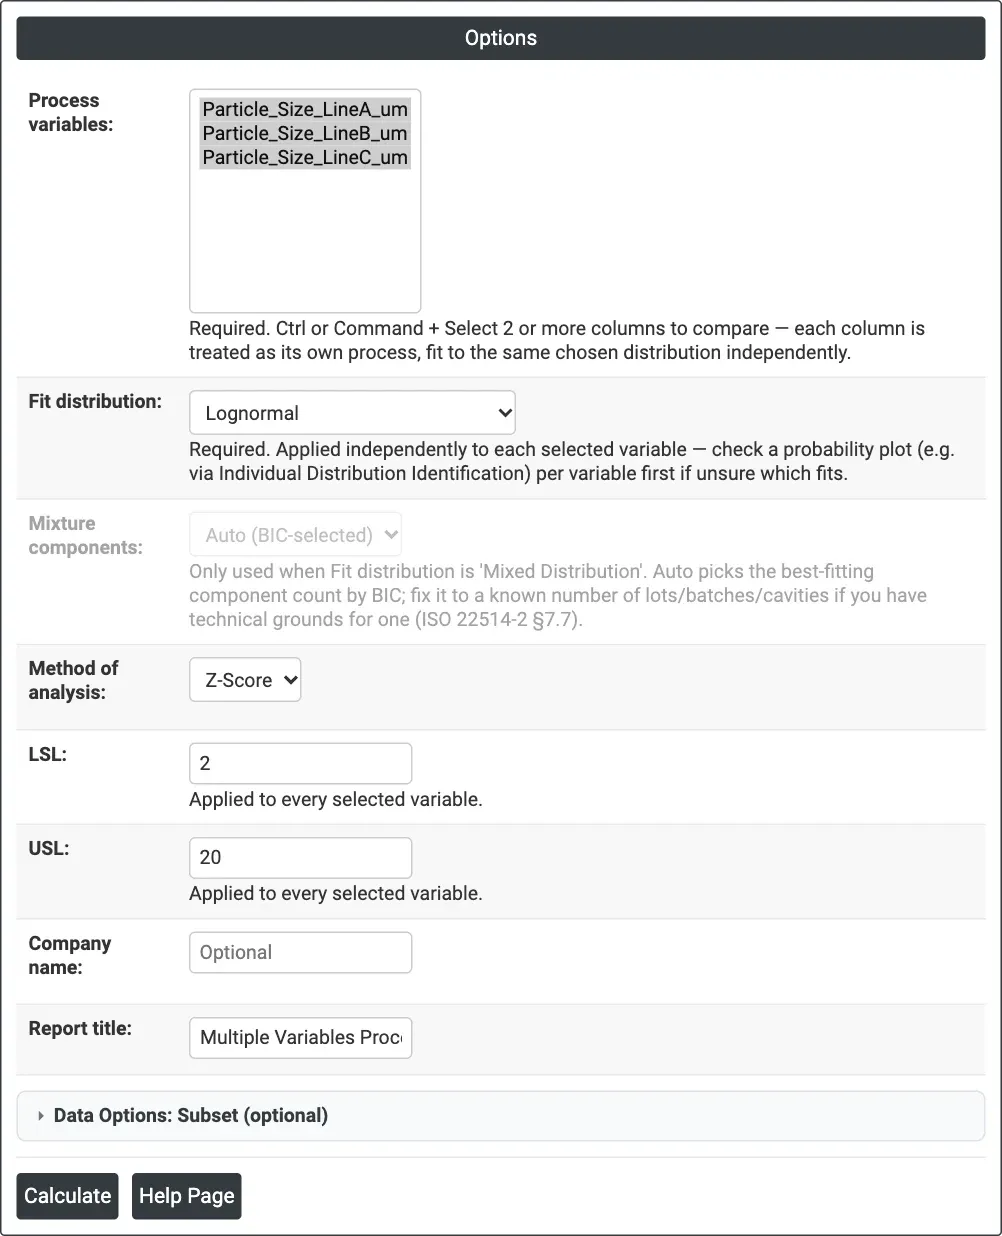
Figuur 1 — Opties voor het voorbeeld: deeltjesgrootte van drie lijnen, Lognormal, Z-Score-methode, LSL 2 µm en USL 20 µm.
Beschrijving van de uitvoer
- Multiple Variables Process Capability (Nonnormal) — één rij per kolom: Variable, N, Distribution, Pp, PPL, PPU, Ppk, PPM Expected en PPM Observed.
- Histogram of <distribution> Distribution — één per kolom, onder de kolomnaam, met de LSL en USL en de gefitte dichtheidskromme.
- PDF-export via Download.
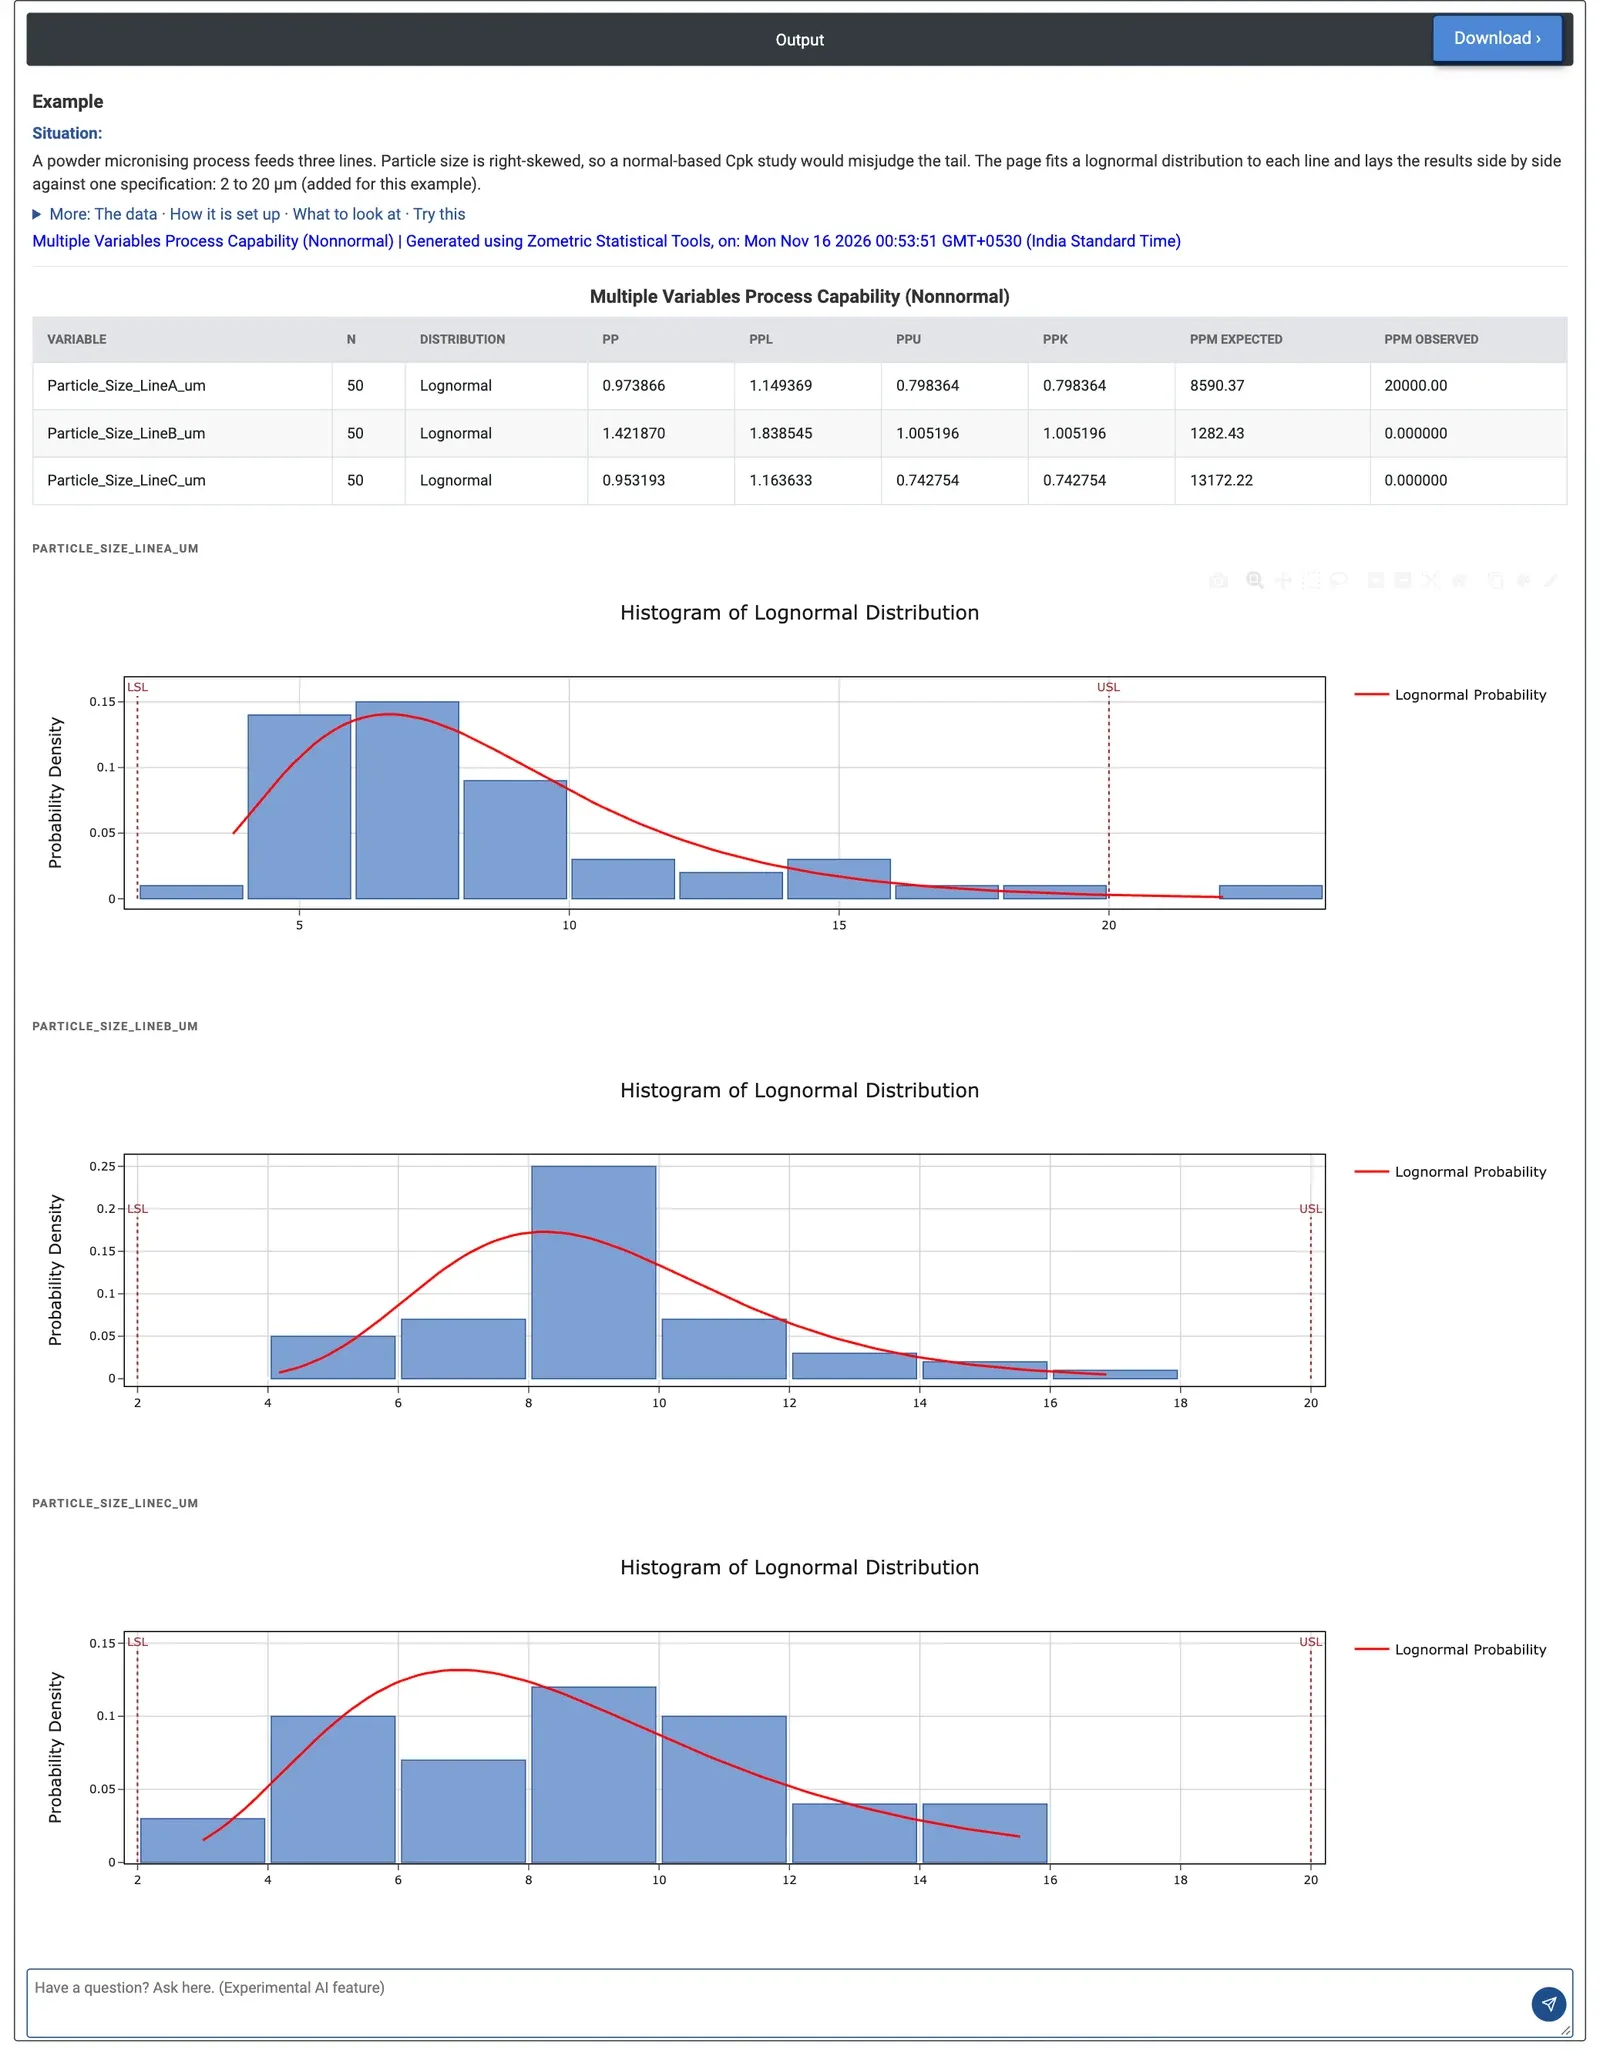
Figuur 2 — Vergelijkingstabel en lognormale histogrammen voor de drie lijnen: Ppk 0.798 voor lijn A, 1.005 voor lijn B en 0.743 voor lijn C, met PPU onder PPL op elke lijn; alleen lijn A heeft een monster boven de USL.
Uitgewerkt voorbeeld
Een proces voor het microniseren van poeder voedt drie lijnen en de deeltjesgrootte is rechtsscheef (mediaan ongeveer 7 tot 9 µm, met een lange staart naar grove deeltjes). De procesingenieur wil de lijnen vergelijken met een specificatie van 2 tot 20 µm, met 50 monsters van elke lijn. Process variables = Particle_Size_LineA_um, Particle_Size_LineB_um en Particle_Size_LineC_um, Fit distribution = Lognormal, Method of analysis = Z-Score, LSL = 2, USL = 20.
Lijn A heeft een Ppk van 0.798 en 8,590 PPM verwacht buiten specificatie; één monster (22.11 µm) ligt al boven 20 µm, dus er worden 20,000 PPM waargenomen. Lijn B is de beste, met een Ppk van 1.005 en 1,282 PPM verwacht, maar nog steeds onder het gebruikelijke doel van 1.33. Lijn C is het riskantst, met een Ppk van 0.743 en 13,172 PPM verwacht. Op elke lijn is PPU lager dan PPL: het risico zijn grove deeltjes boven 20 µm, niet fijne deeltjes onder 2 µm, dus verbeterwerk moet zich op de grove staart richten, te beginnen met lijn C. De histogrammen laten hetzelfde beeld zien: elke gefitte kromme heeft zijn lange staart richting de USL en bij lijn A ligt één staaf erbuiten.
Het model doet ertoe. Met de ISO-methode dalen de Ppk-waarden naar 0.694, 1.008 en 0.619, met dezelfde rangorde. Met een Weibull-fit wordt PPL op elke lijn de lagere index en verandert de rangorde (Ppk 0.641, 0.948 en 0.798, lijn A nu het slechtst). Anderson-Darling-statistieken die los van deze pagina zijn berekend, geven de voorkeur aan de lognormale verdeling voor lijn A en B (0.79 tegenover 2.17, en 0.63 tegenover 1.34) maar aan de Weibull voor lijn C (0.20 tegenover 0.55), dus de lijnen moeten een voor een worden gecontroleerd voordat de rangorde voor beslissingen wordt gebruikt.
Veelgestelde vragen
Wanneer gebruikt u niet-normale capabiliteitsanalyse voor meerdere variabelen?
Gebruik het om de capabiliteit van meerdere processen, lijnen, machines of nesten met één specificatie te vergelijken en te rangschikken wanneer de gegevens niet normaal verdeeld zijn. Typische voorbeelden zijn scheve kenmerken zoals deeltjesgrootte, vlakheid, rondloop of onzuiverheid, waar een op de normale verdeling gebaseerde Ppk de staart van de verdeling verkeerd inschat.
Wat is het verschil tussen de Z-Score- en de ISO-methode?
De Z-Score-methode zet de gefitte kansen voorbij elke grens om in normale scores en deelt door 3 om PPU en PPL te geven. De ISO-methode gebruikt de gefitte 0.135e, 50e en 99.865e percentielen in plaats van de spreiding van plus of min 3 sigma bij een normale verdeling. Beide kunnen verschillende Ppk-waarden geven, zoals het uitgewerkte voorbeeld laat zien, al kan de rangorde gelijk blijven.
Waarom doet de keuze van de verdeling ertoe bij niet-normale capabiliteit?
De indices zijn slechts zo goed als de gefitte verdeling en hetzelfde model wordt op elke kolom toegepast. In het uitgewerkte voorbeeld veranderde het overschakelen van Lognormal naar Weibull welke index de lagere was en veranderde het de rangorde van de lijnen. Controleer de fit van elke kolom, bijvoorbeeld met Identificatie van individuele verdeling, voordat u ze vergelijkt.
Wat is het verschil tussen PPM Expected en PPM Observed?
PPM Expected is het aandeel van de populatie volgens de gefitte verdeling buiten de specificatiegrenzen, maal 1,000,000. PPM Observed is het aandeel van de werkelijke steekproefwaarden buiten de grenzen. Beide zijn totale maten voor de lange termijn, berekend uit alle gegevens in elke kolom.