
Nominale logistische regressie
Nominale logistische regressie is een statistisch hulpmiddel om het verband te analyseren tussen een of meer voorspellende variabelen en een categorische responsvariabele met drie of meer ongeordende categorieën — zoals kras, deuk of scheur. Ze voorspelt de kans dat elke categorie optreedt op basis van de waarden van de voorspellers.
Laatst beoordeeld
Belangrijkste conclusie
Nominale logistische regressie is een statistisch hulpmiddel om het verband te analyseren tussen een of meer voorspellende variabelen en een categorische responsvariabele met drie of meer ongeordende categorieën.
Op deze pagina
- Wat is nominale logistische regressie?
- Wanneer gebruikt u nominale logistische regressie?
- Richtlijnen voor correct gebruik van nominale logistische regressie
- Alternatieven: wanneer u nominale logistische regressie niet gebruikt
- Voorbeeld van nominale logistische regressie
- Zo voert u nominale logistische regressie uit
Wat is nominale logistische regressie?
Nominale logistische regressie is een statistisch hulpmiddel om het verband te analyseren tussen een of meer voorspellende variabelen en een categorische responsvariabele met drie of meer ongeordende categorieën — zoals kras, deuk of scheur. Ze voorspelt de kans dat elke categorie optreedt op basis van de waarden van de voorspellers.
Wanneer gebruikt u nominale logistische regressie?
Voorspellende variabelen
- Voorspellers kunnen zijn: continu, categorisch of een mix van beide
- Discrete variabelen kunnen als continu of categorisch worden behandeld, afhankelijk van het aantal niveaus en het doel van de analyse
- Slechts één continue voorspeller met een continue respons → gebruik Gefitte-lijnplot
- Meerdere voorspellers met een continue respons → gebruik Regressiemodel fitten
Responsvariabele
- De respons moet drie of meer categorieën zonder natuurlijke volgorde hebben (bijv. kleur, materiaaltype, defecttype)
- Als de respons continu is → gebruik Regressiemodel fitten
- Als de respons twee categorieën heeft (goed/fout) → gebruik Binaire logistische regressie
- Als de respons geordende categorieën heeft (laag/gemiddeld/hoog) → gebruik Ordinale logistische regressie
Richtlijnen voor correct gebruik van nominale logistische regressie
- De responsvariabele moet drie of meer ongeordende categorieënhebben; als de categorieën een natuurlijke volgorde hebben, gebruik dan in plaats daarvan ordinale logistische regressie.
- Voorspellers kunnen continu of categorischzijn; zorg dat elke variabele correct is geclassificeerd voordat u de analyse uitvoert.
- Zorg dat de gegevens de doelpopulatie nauwkeurig weergeven; vertekende of onvolledige gegevens leveren onbetrouwbare voorspellingen op.
- Verzamel voldoende datapunten per categorie — te weinig waarnemingen in een categorie maakt het model instabiel en de voorspellingen onbetrouwbaar.
- Meet alle variabelen zo nauwkeurig mogelijk; fouten in de invoergegevens verlagen rechtstreeks de nauwkeurigheid van de voorspelde kansen.
- Registreer gegevens in de volgorde waarin ze worden verzameld om tijdsafhankelijke patronen te herkennen die de resultaten kunnen beïnvloeden.
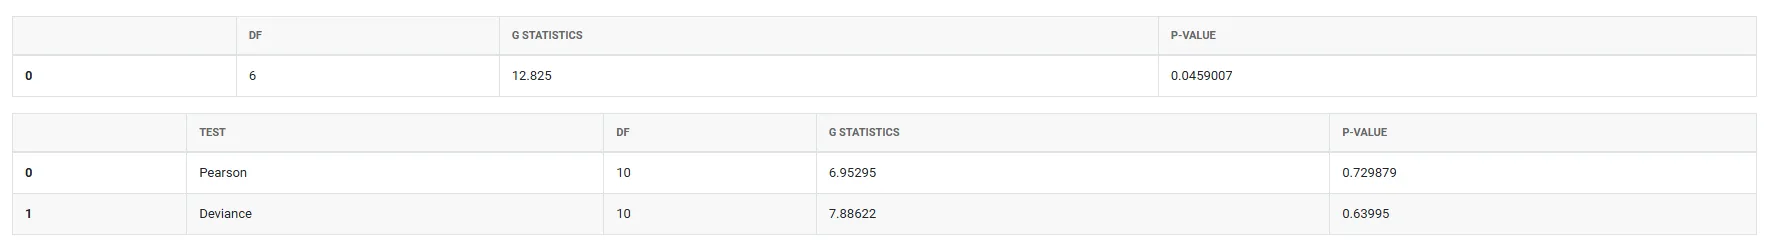
- Valideer het model na het fitten met aanpassingsmaten (goodness-of-fit) en residudiagnostiek; een slecht passend model levert misleidende categorievoorspellingen op.
- Controleer dat geen enkele categorie te weinig waarnemingen heeft — zeldzame categorieën verlagen de betrouwbaarheid van het model en kunnen schattingsproblemen veroorzaken.
Alternatieven: wanneer u nominale logistische regressie niet gebruikt
- Als de responsvariabele continuis, gebruik dan in plaats daarvan Regressiemodel fitten .
- Als u slechts één continue voorspeller met een continue respons hebt, gebruik dan in plaats daarvan Gefitte-lijnplot .
- Als de respons twee categorieën heeft (bijv. goed/fout), gebruik dan in plaats daarvan Binaire logistische regressie .
- Als de responscategorieën een natuurlijke volgorde hebben (bijv. laag/gemiddeld/hoog), gebruik dan in plaats daarvan Ordinale logistische regressie .
- Als u één categorische voorspeller met een continue respons hebt, gebruik dan in plaats daarvan Eenweg-ANOVA .
Voorbeeld van nominale logistische regressie
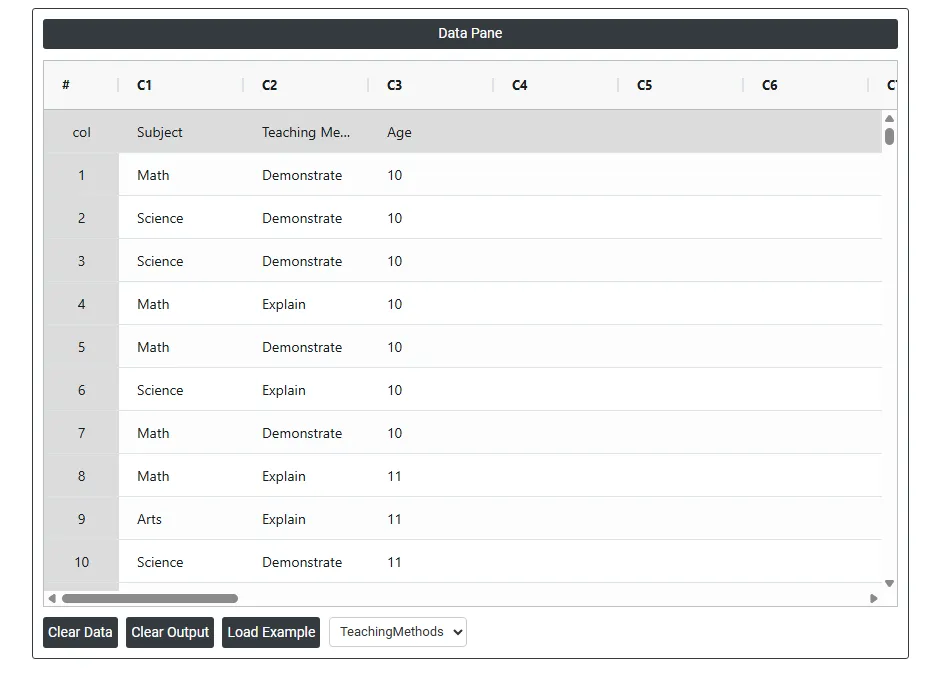
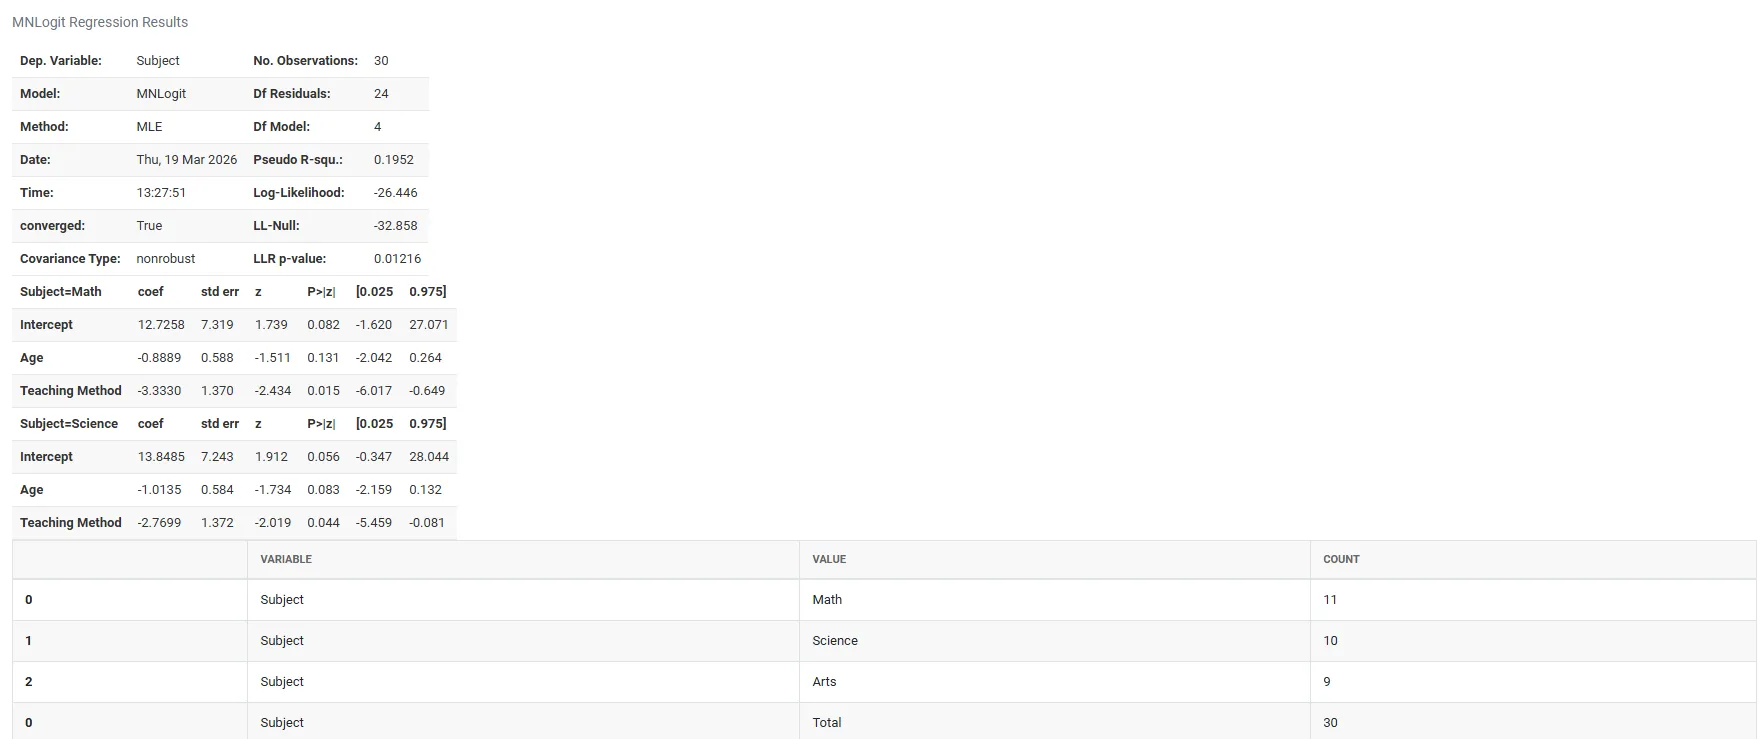
Om de effectiviteit van verschillende lesmethoden te evalueren, verzamelt een schoolbeheerder gegevens van 30 leerlingen, waarbij per leerling het favoriete vak wordt vastgelegd samen met de lesmethode die in hun klas wordt gebruikt. Omdat de responsvariabele — vakvoorkeur (wiskunde, natuurkunde of taal) — categorisch is zonder inherente volgorde, past de beheerder nominale logistische regressie toe. Deze analyse helpt te onderzoeken hoe de leeftijd van de leerlingen (van 10 tot 13) en het type lesmethode (demonstratie of uitleg) samenhangen met hun vakvoorkeur. De volgende stappen:
- De benodigde gegevens verzameld.
- Analyseer de gegevens nu in Zometric Statistical Software op https://statsai.zometric.com/.
- Om nominale logistische regressie te vinden, kiest u Statistical module> Regression>Nominal Logistic Regression.
- Voer in de tool de gegevens en de overige invoer als volgt in:
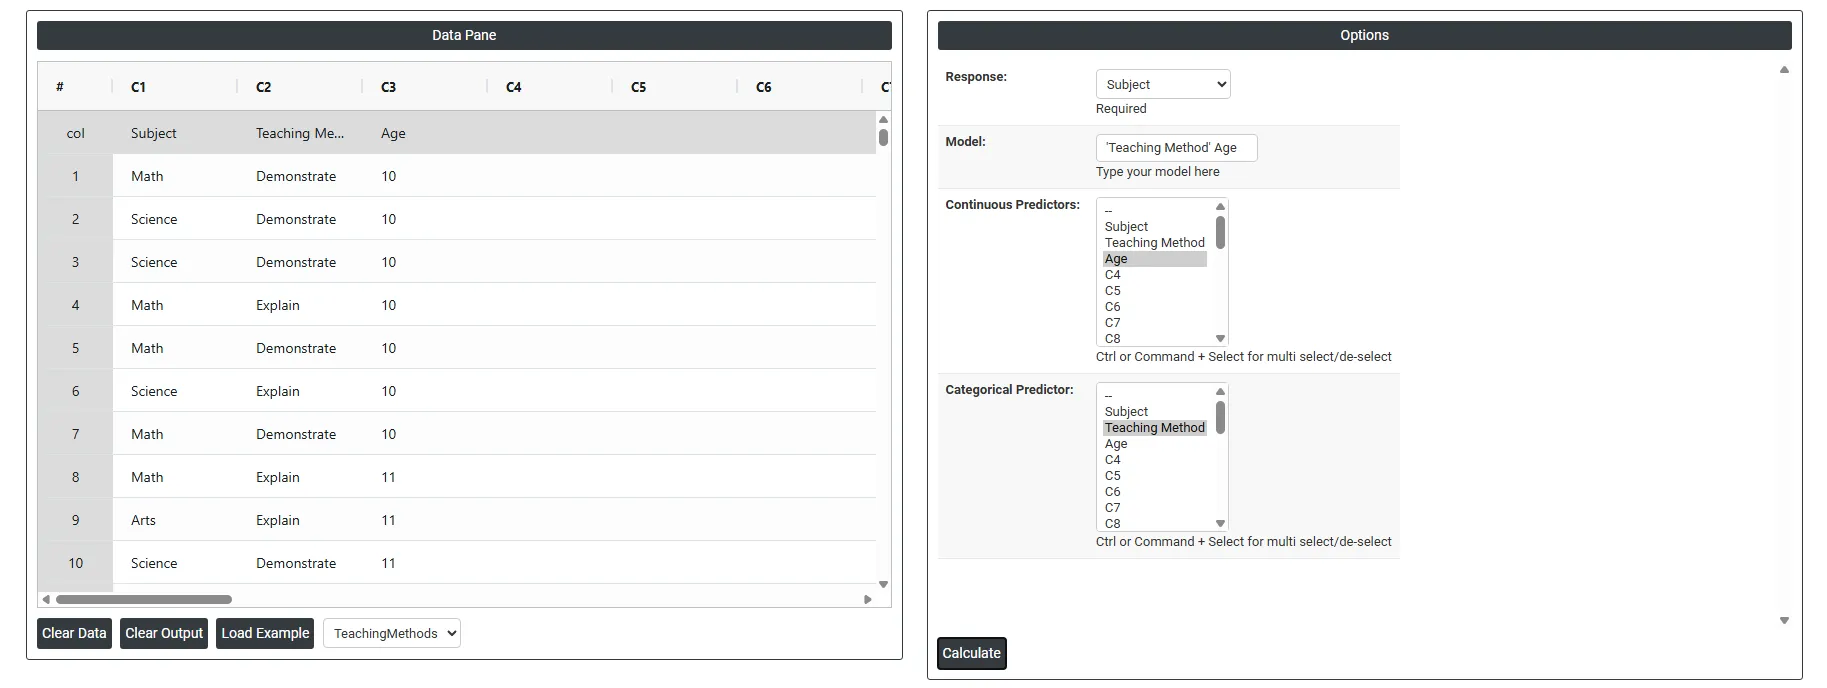
5. Na gebruik van de bovengenoemde tool wordt de uitvoer als volgt weergegeven
Zo voert u nominale logistische regressie uit
De handleiding is als volgt:
- Meld u aan bij Zometric Statistical Software op https://statsai.zometric.com/
- Kies op de startpagina Statistical Tool> Regression > Nominal Logistic Regression.
- Werk vervolgens de gegevens handmatig bij, of kopieer (Ctrl+C) de gegevens volledig uit een Excel-blad en plak (Ctrl+V) ze, of gebruik de optie Load Example, waarmee de voorbeeldgegevens worden geladen.
- Vul vervolgens de vereiste opties in.
- Klik ten slotte onderaan de pagina op Calculate en u krijgt de gewenste resultaten.
Op het dashboard van nominale logistische regressie is het venster in twee delen verdeeld.
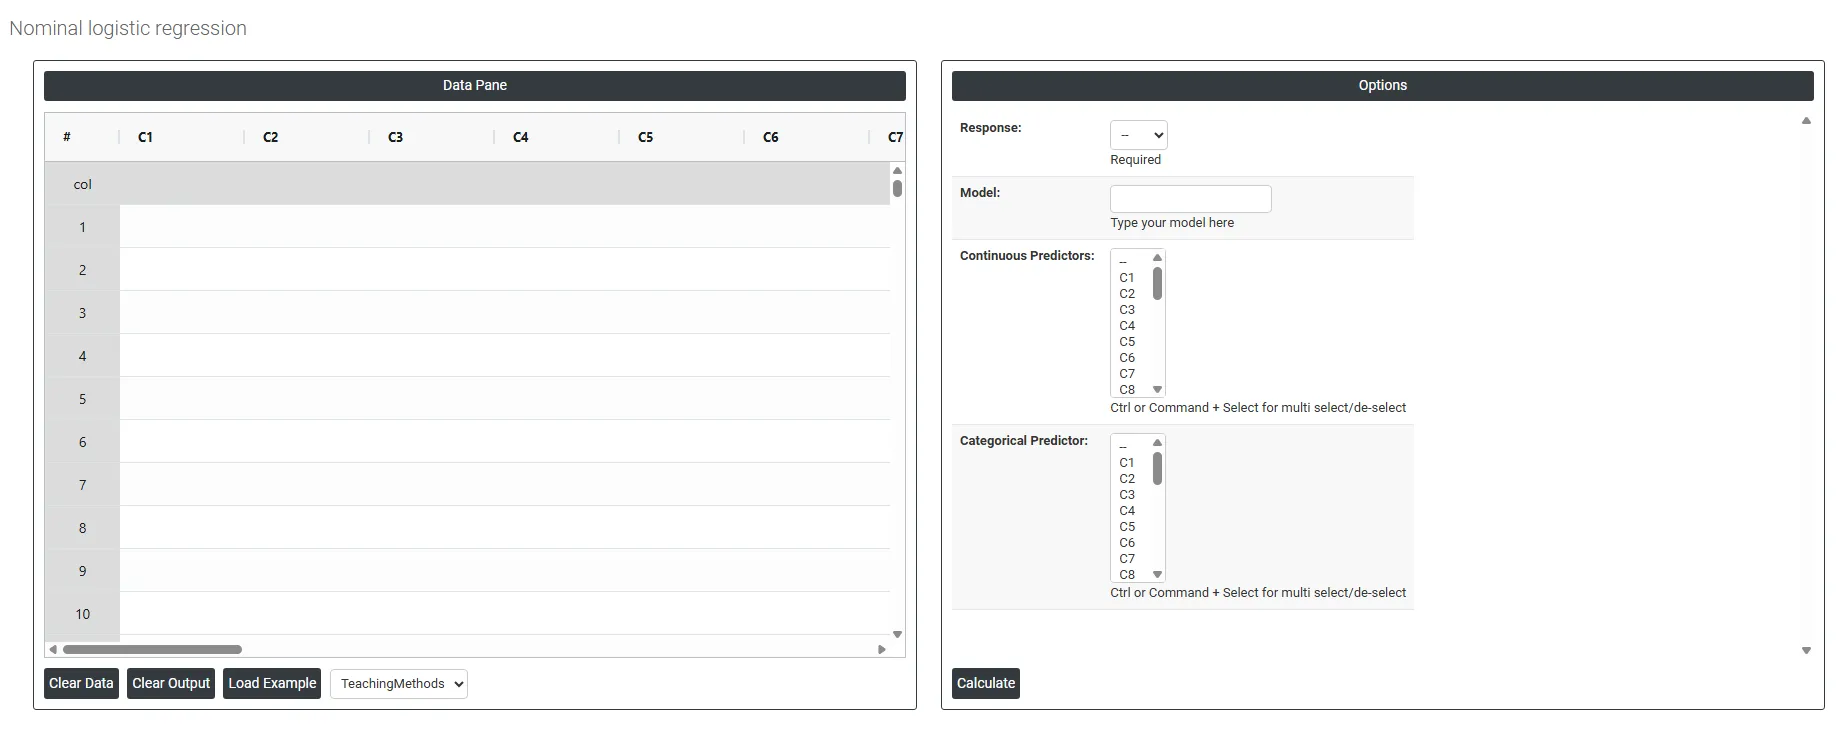
Links bevindt zich het Data Pane. In het Data Pane vormt elke rij één subgroep. Gegevens kunnen handmatig worden ingevoerd, of u kunt de gegevens volledig kopiëren (Ctrl+C) uit een Excel-blad en hier plakken (Ctrl+V).
Load example: Er worden voorbeeldgegevens geladen.
Load File: Hiermee laadt u Excel-gegevens rechtstreeks.
Rechts staan de volgende opties:
- Response: De uitkomstvariabele die u wilt voorspellen of classificeren — ze moet drie of meer categorieën zonder natuurlijke volgordebevatten, zoals defecttype (kras, deuk, scheur) of betaalmethode (contant, kaart, online). Het model schat de kans dat elke categorie optreedt op basis van de opgegeven waarden van de voorspellers.
- Categorical Predictor: Een voorspellende variabele met een vaste set afzonderlijke groepen of labels, zoals machinetype, ploeg of materiaal. Tussen deze groepen bestaat geen meetbare afstand. Elke categorie wordt als een apart niveau behandeld en het model schat hoe elke groep de kans op elke responscategorie beïnvloedt.
- Continuous Predictor: Een voorspellende variabele die elke meetbare numerieke waarde binnen een bereik kan aannemen, zoals temperatuur, druk of tijd. Het model gebruikt deze waarden om te schatten hoe een toename van de voorspeller met één eenheid de kans verschuift dat de respons in elke categorie valt.
- Model: Bepaalt welke voorspellers en interactietermen in de analyse worden opgenomen. Standaard bouwt de analyse een hoofdeffectenmodel met alle geselecteerde voorspellers. U kunt het aanpassen om interactietermen (bijv. A*B) op te nemen als u denkt dat twee voorspellers samen de respons beïnvloeden. De keuze van de juiste modelstructuur is belangrijk — onnodige termen voegen ruis toe, terwijl ontbrekende kerntermen tot onnauwkeurige voorspellingen leiden.
Veelgestelde vragen
Wat is nominale logistische regressie?
Nominale logistische regressie analyseert het verband tussen een of meer voorspellende variabelen en een categorische respons met drie of meer ongeordende categorieën, zoals kras, deuk of scheur. Ze voorspelt de kans dat elke responscategorie optreedt op basis van de waarden van de voorspellers. Voorspellers kunnen continu, categorisch of een mix van beide zijn.
Wat is het verschil tussen nominale en ordinale logistische regressie?
Nominale logistische regressie is bedoeld voor een respons met drie of meer categorieën zonder natuurlijke volgorde, zoals kleur, materiaaltype of defecttype. Als de categorieën een natuurlijke volgorde hebben, zoals laag, gemiddeld en hoog, gebruik dan ordinale logistische regressie. Gebruik voor een respons met twee categorieën, zoals goed/fout, binaire logistische regressie.
Wat zijn de vereisten voor nominale logistische regressie?
De respons moet drie of meer ongeordende categorieën hebben en elke categorie heeft voldoende waarnemingen nodig, omdat zeldzame categorieën het model instabiel maken en schattingsproblemen kunnen veroorzaken. De gegevens moeten de doelpopulatie weergeven, nauwkeurig worden gemeten en in verzamelvolgorde worden geregistreerd. Valideer het model na het fitten met aanpassingsmaten (goodness-of-fit) en residudiagnostiek.
Hoe voert u nominale logistische regressie uit in Zometric Statistical Software?
Kies Statistical Tool > Regression > Nominal Logistic Regression en voer de gegevens in of plak ze. Selecteer de Response, eventuele Categorical en Continuous Predictors en definieer het Model, dat standaard een hoofdeffectenmodel is en interactietermen zoals A*B kan bevatten. Klik vervolgens op Calculate om de resultaten te krijgen.