
Niet-normale procescapabiliteit (Non-Normal Process Capability)
Gebruik niet-normale procescapabiliteit voor continue gegevens die scheef zijn of een verdeling volgen zoals Weibull, exponentieel, gamma of lognormaal. Verzamel minimaal 100 datapunten uit een stabiel proces en controleer of de verdeling past. Voer LSL en USL in en kies de Z-scoremethode of de ISO 22514-percentielmethode. De uitvoer bevat capabiliteitsindexen en het voorspelde percentage output buiten de specificatie.
Laatst beoordeeld
Belangrijkste conclusie
Niet-normale procescapabiliteit beoordeelt of een proces output binnen de specificatiegrenzen levert wanneer de gegevens niet normaal verdeeld zijn, door een geschikte verdeling zoals Weibull of lognormaal aan te passen.
Op deze pagina
- Wat is niet-normale procescapabiliteit?
- Wanneer gebruikt u niet-normale procescapabiliteit?
- Richtlijnen voor correct gebruik van niet-normale procescapabiliteit
- Alternatieven: wanneer u geen niet-normale procescapabiliteit gebruikt
- Voorbeeld van niet-normale procescapabiliteit
- Zo voert u een niet-normale procescapabiliteitsanalyse uit
Wat is niet-normale procescapabiliteit?
Niet-normale procescapabiliteit is een methode om het vermogen van een proces te beoordelen om output binnen de gestelde grenzen te leveren wanneer de gegevens afwijken van een normale verdeling. Deze analyse is cruciaal wanneer de gegevens kenmerken vertonen zoals scheefheid, uitschieters, of een andere verdeling volgen dan de normale klokvormige kromme. Door het juiste niet-normale verdelingsmodel te kiezen, beoordeelt deze analyse hoe nauwkeurig de procesresultaten aan de klanteisen voldoen, meet ze de totale procesprestatie en voorspelt ze het percentage output dat waarschijnlijk buiten het aanvaardbare bereik valt. Deze aanpak helpt vast te stellen of het proces betrouwbaar aan de gewenste normen kan voldoen, ook wanneer de gegevensverdeling niet normaal is.
Eenvoudig gezegd is het een manier om te zorgen dat een proces goed werkt, ook wanneer de gegevens er niet uitzien zoals we verwachten.
Wanneer gebruikt u niet-normale procescapabiliteit?
Niet-normale procescapabiliteit moet worden gebruikt wanneer de gegevens die u analyseert geen normale verdeling volgen, dat wil zeggen dat ze niet de typische klokvormige kromme hebben die symmetrisch is en rond het gemiddelde is gecentreerd. Hier zijn enkele situaties waarin u niet-normale procescapabiliteit gebruikt:
- Scheve gegevens: Als uw gegevens naar links of rechts scheef zijn, wat betekent dat de meeste waarden aan één kant geclusterd zijn, is een niet-normale capabiliteitsanalyse geschikter.
- Aanwezigheid van uitschieters: Als uw gegevens extreme waarden bevatten die niet in het algemene patroon passen, kunnen ze een normale verdeling vertekenen. Onderzoek ze eerst; als ze een echt onderdeel zijn van een proces met lange staarten, kan een niet-normale verdeling de staart beter modelleren dan de normale verdeling.
- Niet-symmetrische verdelingen: Wanneer de gegevens een patroon vertonen dat niet symmetrisch is (bijv. lognormale of exponentiële verdelingen), helpt niet-normale procescapabiliteit voor een nauwkeurigere beoordeling.
- Meerdere pieken: Als uw gegevens meer dan één piek hebben (bimodale of multimodale verdeling), volgen ze geen normale verdeling; dit betekent meestal dat de gegevens uit meer dan één processtroom komen (bijvoorbeeld verschillende machines of partijen), die moeten worden gescheiden voordat de capabiliteit wordt beoordeeld.
- Proceskenmerken: Sommige processen leveren van nature niet-normale gegevens op door de aard van het proces of het product. Slijtage in de tijd, batchprocessen of processen met inherente grenzen kunnen bijvoorbeeld niet-normale gegevens opleveren.
Richtlijnen voor correct gebruik van niet-normale procescapabiliteit
- Gebruik continue gegevens voor de analyse; bij attribuutgegevens past u in plaats daarvan Binomial of Poisson Capability Analysis toe.
- Verzamel minimaal 100 datapunten voor betrouwbare schattingen van de procescapabiliteit en een juiste weergave van de procesvariatie.
- Zorg dat het proces stabiel en onder controle is voordat u een capabiliteitsanalyse uitvoert, zo nodig met hulpmiddelen zoals de Xbar-S-kaart of Nonnormal Capability Sixpack.
- De gegevens moeten de gekozen niet-normale verdeling nauwkeurig volgen; gebruik Individual Distribution Identification om de beste aanpassing voor nauwkeurige capabiliteitsschattingen te vinden.
Alternatieven: wanneer u geen niet-normale procescapabiliteit gebruikt
- Als u niet zeker weet welke niet-normale verdeling bij uw gegevens past, gebruik dan vóór de analyse Individual Distribution Identification.
- Gebruik voor het controleren van de procesbeheersing en de geschiktheid voor een specifieke niet-normale verdeling eerst Nonnormal Capability Sixpack.
- Om de variatie binnen subgroepen en de potentiële capabiliteit samen met de totale capabiliteit te schatten, gebruikt u Normal Capability Analysis om niet-normale gegevens te transformeren en op basis van een normale verdeling te beoordelen.
Voorbeeld van niet-normale procescapabiliteit
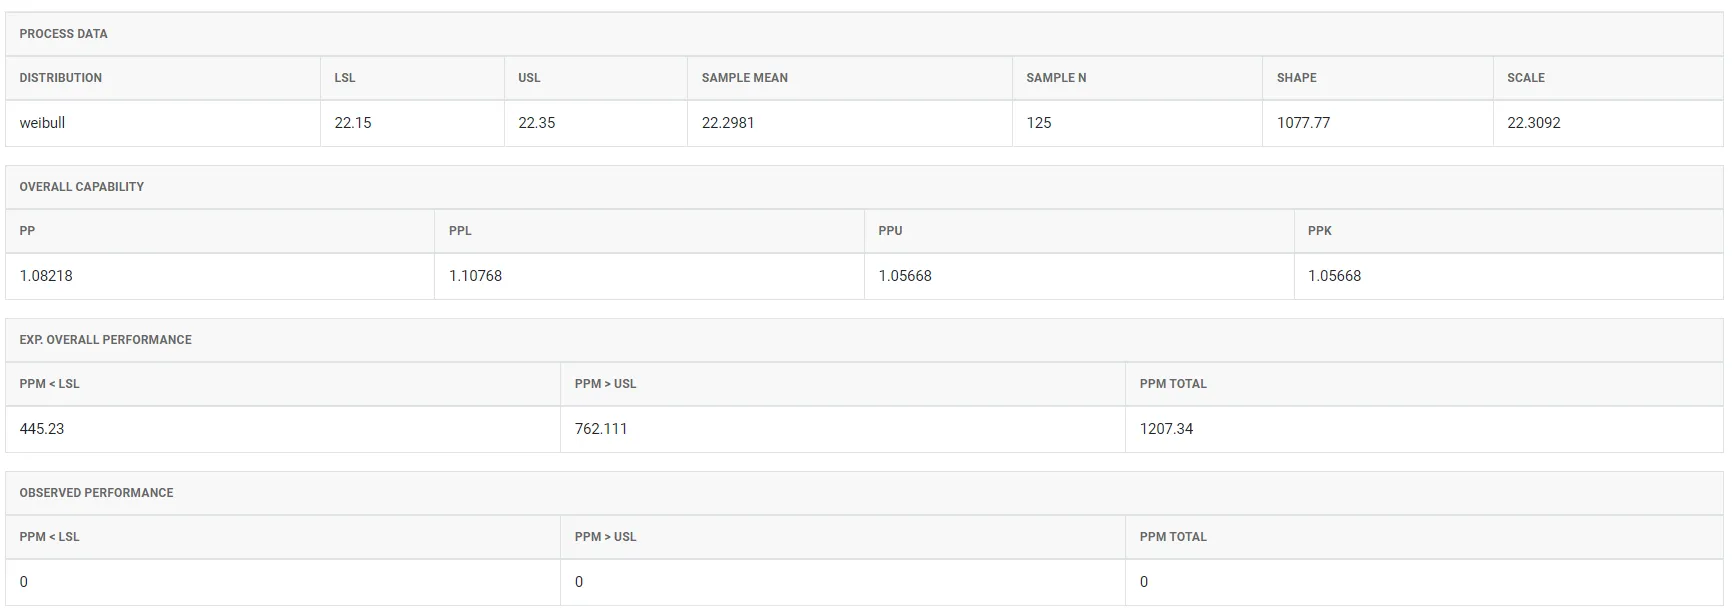
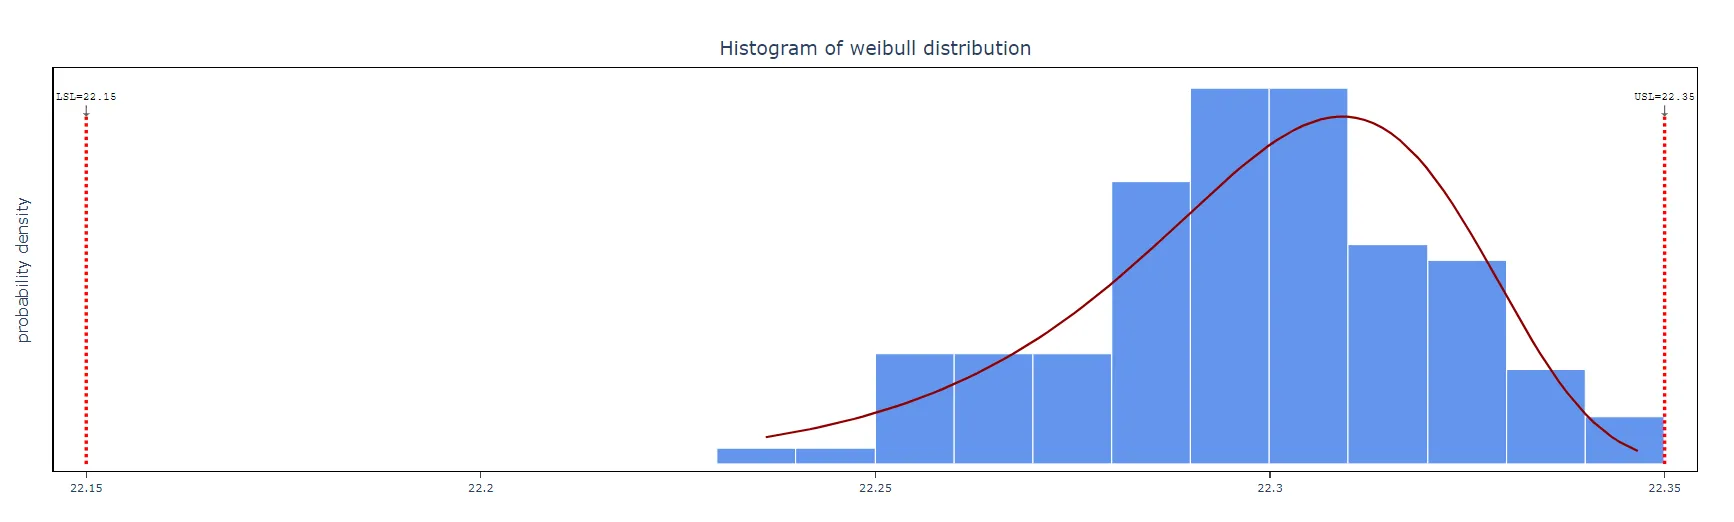
Een fabrikant van automobielonderdelen beoordeelt of een boormachine aan de specificaties voor een kritiek onderdeel kan voldoen. Het onderdeel moet binnen een bereik vallen: onderste specificatiegrens (LSL) van 22.15 en bovenste specificatiegrens (USL) van 22.35. Om dit te evalueren neemt de ingenieur 125 monsters van de machine en voert de volgende stappen uit:
- De benodigde gegevens verzameld.
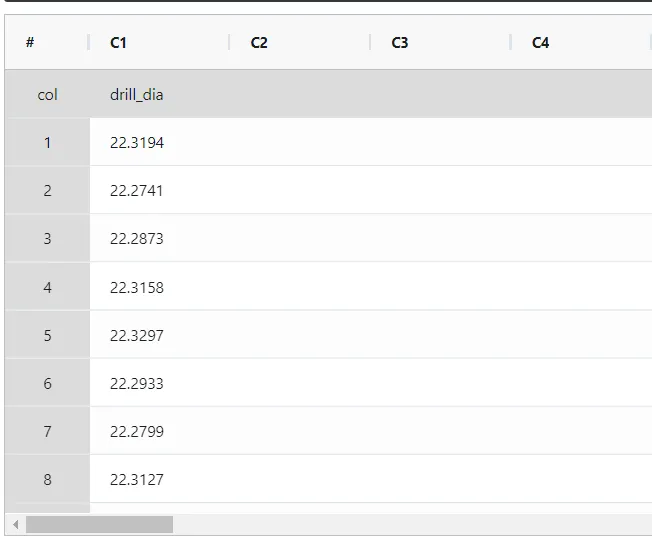
- Analyseer de gegevens nu in Zometric Statistical Software op https://statsai.zometric.com/.
- Kies voor niet-normale procescapabiliteit Statistical module> Process Capability>Non-Normal Process Capability.
- Voer in de tool de gegevens samen met de overige invoer als volgt in:
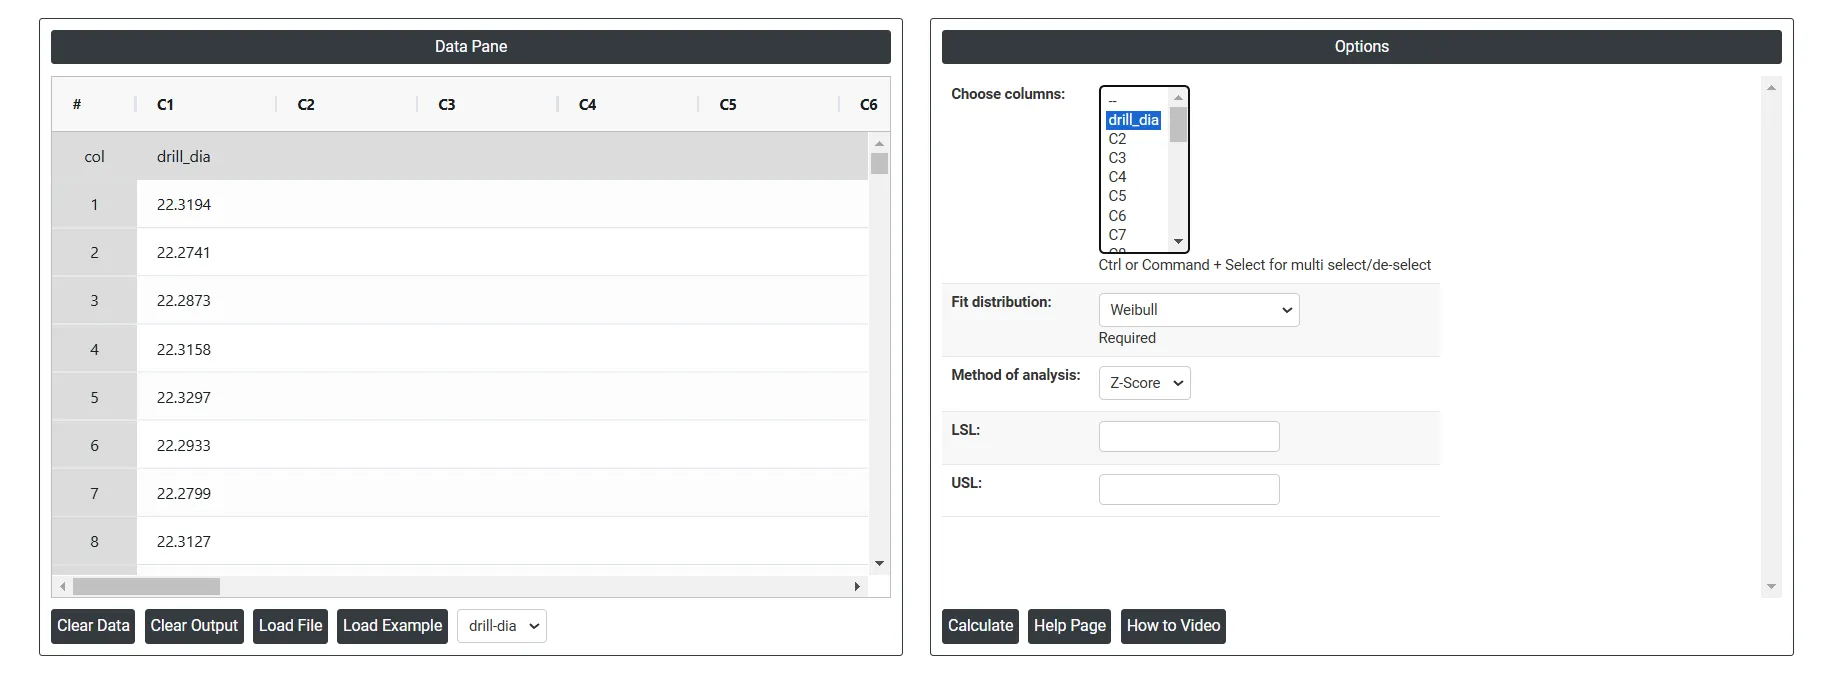
5. Na gebruik van bovenstaande tool wordt de uitvoer als volgt opgehaald:
Zo voert u een niet-normale procescapabiliteitsanalyse uit
De handleiding is als volgt:
- Log in bij Zometric Statistical Software op https://statsai.zometric.com/
- Kies op de startpagina Statistical Tool> Process Capability >Non-Normal Process Capability.
- Klik op Non Normal Process Capability om het dashboard te openen.
- Werk vervolgens de gegevens handmatig bij, of kopieer (Ctrl+C) de gegevens volledig uit een Excel-sheet en plak (Ctrl+V) ze hier.
- Selecteer vervolgens de aan te passen verdeling, voer de LSL en USL in en kies de analysemethode.
- Klik ten slotte onderaan de pagina op Calculate en u krijgt de gewenste resultaten.
Op het dashboard van Non Normal Process Capability is het venster in twee delen gesplitst.
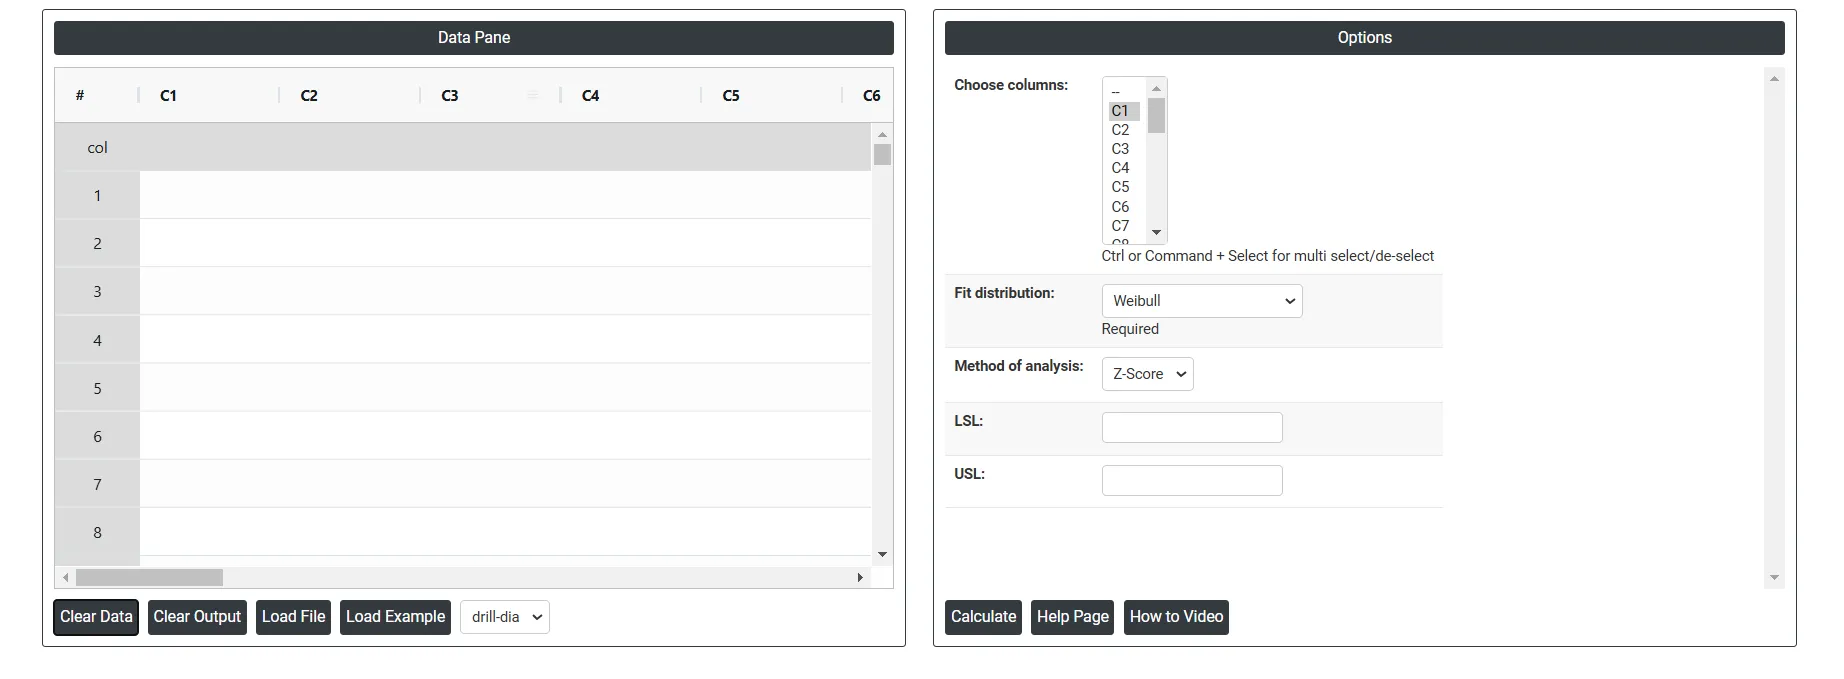
Links bevindt zich de Data Pane. In de Data Pane vormt elke rij één subgroep. Gegevens kunnen handmatig worden ingevoerd, of u kunt de gegevens volledig uit een Excel-sheet kopiëren (Ctrl+C) en hier plakken (Ctrl+V).
Load example: Voorbeeldgegevens worden geladen.
Load File: Hiermee laadt u de Excel-gegevens rechtstreeks.
Rechts zijn de volgende opties beschikbaar:
- Fit Distribution:
- Weibull distribution: De Weibull-verdeling is een flexibel statistisch model dat wordt gebruikt in techniek, medisch onderzoek, financiën en klimatologie, met name voor het analyseren van gegevens over de tijd tot uitval en het verwerken van scheve procesgegevens. Ze wordt gedefinieerd door drie parameters: vorm, schaal en drempel. De 3-parameter-Weibull-verdeling bevat alle drie, terwijl de 2-parameterversie, waarin de drempel ontbreekt, alleen voor positieve waarden wordt gebruikt. De vormparameter beïnvloedt de scheefheid van de verdeling, de schaalparameter geeft het punt aan waarop naar verwachting 63.2% van de populatie is uitgevallen en de drempelparameter verschuift de verdeling langs de tijdas. Deze verdeling is cruciaal voor het voorspellen van uitval, het schatten van levenscycli en het begrijpen van complexe gegevenspatronen. Ze is ook veelzijdig inzetbaar voor kwaliteitsbeheersing en risicobeheer.Exponential: De exponentiële verdeling is een continue kansverdeling die vaak wordt gebruikt bij procescapabiliteitsanalyse van niet-normale gegevens, met name in situaties zoals gegevens over de tijd tot uitval met een constante faalfrequentie, en tussenaankomsttijden van gebeurtenissen in een Poisson-proces, waarin gebeurtenissen continu en onafhankelijk met een constant gemiddeld tempo plaatsvinden. Deze verdeling is ideaal om de tijd tot een specifieke gebeurtenis te modelleren; dankzij haar geheugenloze eigenschap is ze geschikt voor situaties waarin het verleden de toekomst niet beïnvloedt, wat een nauwkeurige analyse van scheve gegevens die geen normale verdeling volgen mogelijk maakt.Logistic: De logistische verdeling speelt een belangrijke rol bij niet-normale procescapabiliteitsanalyse , vooral wanneer de gegevens symmetrisch maar niet normaal verdeeld zijn. De logistische verdeling lijkt qua vorm op de normale verdeling maar heeft zwaardere staarten, wat betekent dat ze meer kans toekent aan extreme waarden. Deze eigenschap maakt haar nuttig bij bepaalde capabiliteitsanalyses waarbij de gegevens vaak uitschieters hebben of een grotere spreiding dan de normale verdeling aankan.Loglogistic: De loglogistische verdeling wordt gebruikt voor positieve, rechtsscheve gegevens waarvan de logaritme een logistische verdeling volgt. Ze lijkt op de lognormale verdeling maar heeft zwaardere staarten, waardoor ze geschikt is voor processen waarin grote waarden waarschijnlijker zijn dan een lognormale verdeling voorspelt.Largest Extreme Value: De Largest Extreme Value-verdeling is essentieel bij niet-normale procescapabiliteitsanalyse wanneer het om gegevens gaat die op maximumwaarden zijn gericht of om rechtsscheve verdelingen. Ze zorgt ervoor dat extreme waarden nauwkeurig worden gemodelleerd, wat leidt tot betrouwbaardere capabiliteitsbeoordelingen en beter onderbouwde beslissingen over procesprestatie en risico’s.Smallest Extreme Value: De Smallest Extreme Value-verdeling (SEV) speelt een cruciale rol bij niet-normale procescapabiliteitsanalyse, vooral wanneer de gegevens scheef zijn en niet bij de normale verdeling passen. De SEV-verdeling is bijzonder nuttig om de minimumwaarden in een dataset te modelleren, zoals de kortste tijd tot uitval of de zwakste schakel in een keten van gebeurtenissen.2-Parameter Exponential: De 2-parameter exponentiële verdeling wordt gedefinieerd door een schaalparameter (λ) en een drempelparameter (θ). De drempelparameter verschuift de verdeling θ eenheden naar rechts, wat een minimale wachttijd aangeeft voordat gebeurtenissen kunnen optreden. De schaalparameter bepaalt het tempo waarmee gebeurtenissen na de drempel optreden.3- Parameter Weibull: De 3-parameter-Weibull-verdeling wordt gedefinieerd door een vormparameter (β), een schaalparameter (η) en een drempelparameter (γ). De vormparameter (β) bepaalt het gedrag van de faalfrequentie, de schaalparameter (η) geeft de karakteristieke levensduur aan en de drempelparameter (γ) verschuift de verdeling en vertegenwoordigt de minimale tijd voordat uitval begint. Deze verdeling wordt gebruikt om levensduurgegevens met een initiële wachtperiode voordat gebeurtenissen kunnen optreden te modelleren, wat extra flexibiliteit geeft voor een nauwkeuriger aanpassing aan de gegevens.Gamma: De gammaverdeling is een continue kansverdeling die wordt gekenmerkt door een vormparameter (k of α) en een schaalparameter (θ). Ze wordt vooral gebruikt om de wachttijd tot een bepaald aantal gebeurtenissen te modelleren, waardoor ze ideaal is voor processen met opgetelde tijden of scheve gegevens.Lognormal: De lognormale verdeling is een continue kansverdeling waarbij de logaritme van de stochastische variabele normaal verdeeld is. Ze wordt gekenmerkt door positieve scheefheid en gedefinieerd door het gemiddelde (μ) en de standaardafwijking (σ) van de onderliggende normale verdeling. Ze wordt veel gebruikt in de financiële wereld, de levenswetenschappen en betrouwbaarheidsanalyse en modelleert gegevens die positief moeten blijven en multiplicatieve groei of rechtsscheef gedrag vertonen.
- LSL: Dit is de minimaal aanvaardbare waarde voor een procesmeting. Elke waarde onder deze grens geeft aan dat het product of proces niet aan de kwaliteitsnormen voldoet en als defect wordt beschouwd.
- USL: Dit is de maximaal aanvaardbare waarde voor een procesmeting. Elke waarde boven deze grens geeft eveneens aan dat het product of proces buiten de specificatie valt en niet aan de kwaliteitseisen voldoet.
- Method of Analysis:
- Z-Score: De Z-scoremethode gebruikt de aangepaste verdeling om de kans te bepalen dat een waarde voorbij elke specificatiegrens valt en zet die om in een equivalente standaardnormale Z-waarde. Capabiliteitsindexen worden vervolgens uit deze Z-waarden berekend (elke eenzijdige index is gelijk aan Z gedeeld door 3), zodat ze vergelijkbaar zijn met de indexen voor normale gegevens. De methode helpt prestatieproblemen te identificeren en maakt datagestuurde beslissingen voor kwaliteitsverbetering mogelijk.
Gebruik deze methode wanneer:
- De gegevens geen normale verdeling volgen, wat bij veel processen in de praktijk gebruikelijk is.
- U een flexibelere aanpak nodig hebt die verschillende verdelingen kan verwerken (bijv. exponentieel, lognormaal).
- U procescapabiliteitsindexen (Cp, Cpk) wilt berekenen die gestandaardiseerd zijn in termen van hoeveel standaardafwijkingen het procesgemiddelde van de specificatiegrenzen verwijderd is.
Voordelen:
- De Z-scoremethode geeft een duidelijker inzicht in de procesprestatie ten opzichte van de specificatiegrenzen door de capabiliteit in standaardafwijkingen uit te drukken.
- Ze maakt betere vergelijkingen tussen verschillende processen of karakteristieken mogelijk, zelfs wanneer de gegevens niet normaal zijn.
- ISO: De ISO-methode volgt de norm ISO 22514 voor niet-normale capabiliteitsanalyse. Ze berekent capabiliteitsindexen rechtstreeks uit percentielen van de aangepaste verdeling: het 0.135e en 99.865e percentiel, die in een normale verdeling overeenkomen met ±3 standaardafwijkingen, en de mediaan als procescentrum. Deze methode verdient de voorkeur wanneer naleving van internationale kwaliteitsnormen vereist is.
- Download as Excel: Hiermee wordt het resultaat in Excel-formaat weergegeven, dat eenvoudig kan worden bewerkt en met de optie Load File opnieuw kan worden geladen voor berekeningen.
Veelgestelde vragen
Wat is niet-normale procescapabiliteit?
Niet-normale procescapabiliteit beoordeelt het vermogen van een proces om output binnen de specificatiegrenzen te leveren wanneer de gegevens geen normale verdeling volgen. Door een geschikt niet-normaal verdelingsmodel aan te passen, beoordeelt ze de totale procesprestatie en voorspelt ze het percentage output dat waarschijnlijk buiten het aanvaardbare bereik valt.
Wanneer gebruikt u een niet-normale capabiliteitsanalyse?
Gebruik haar wanneer continue gegevens scheef of niet-symmetrisch zijn, of afkomstig zijn van een proces dat van nature niet-normale gegevens oplevert, zoals slijtage in de tijd of processen met inherente grenzen. Onderzoek uitschieters eerst en scheid gegevens met meer dan één piek in hun processtromen, zoals verschillende machines of partijen, voordat u de capabiliteit beoordeelt. Gebruik voor attribuutgegevens Binomial of Poisson Capability Analysis.
Hoeveel gegevens hebt u nodig voor niet-normale procescapabiliteit?
Verzamel minimaal 100 datapunten voor betrouwbare capabiliteitsschattingen. Het proces moet vóór de analyse stabiel en onder controle zijn en de gegevens moeten de gekozen verdeling nauwkeurig volgen. Als u niet zeker weet welke verdeling past, gebruik dan eerst Individual Distribution Identification.
Wat is het verschil tussen de Z-score- en de ISO-methode voor niet-normale capabiliteit?
De Z-scoremethode gebruikt de aangepaste verdeling om de kans voorbij elke specificatiegrens te bepalen en zet die om in een equivalente standaardnormale Z-waarde; elke eenzijdige index is gelijk aan Z gedeeld door 3, zodat de indexen vergelijkbaar zijn met die voor normale gegevens. De ISO-methode volgt ISO 22514 en berekent de indexen uit het 0.135e en 99.865e percentiel van de aangepaste verdeling, met de mediaan als procescentrum.