
Niet-normale procescapabiliteit
Niet-normale procescapabiliteitsanalyse meet hoe goed een proces aan zijn specificatiegrenzen voldoet wanneer de onderliggende gegevens geen normale (klokvormige) verdeling volgen. In plaats van een normaliteitsaanname op scheve of ongebruikelijke gegevens af te dwingen, fit deze analyse een erkende niet-normale verdeling — zoals Weibull, lognormaal, exponentieel of gamma — aan de gegevens en berekent ze vervolgens capabiliteitsindices op basis van de werkelijke vorm van die verdeling.
Laatst beoordeeld
Belangrijkste conclusie
Niet-normale procescapabiliteitsanalyse meet hoe goed een proces aan zijn specificatiegrenzen voldoet wanneer de onderliggende gegevens geen normale (klokvormige) verdeling volgen.
Op deze pagina
- Wat is niet-normale procescapabiliteit?
- Wanneer gebruikt u niet-normale procescapabiliteit?
- Richtlijnen voor correct gebruik van niet-normale procescapabiliteit
- Alternatieven: wanneer u geen niet-normale procescapabiliteit gebruikt
- Voorbeeld van niet-normale procescapabiliteit?
- Zo voert u een niet-normale procescapabiliteitsanalyse uit.
Wat is niet-normale procescapabiliteit?
Niet-normale procescapabiliteitsanalyse meet hoe goed een proces aan zijn specificatiegrenzen voldoet wanneer de onderliggende gegevens geen normale (klokvormige) verdeling volgen. In plaats van een normaliteitsaanname op scheve of ongebruikelijke gegevens af te dwingen, fit deze analyse een erkende niet-normale verdeling — zoals Weibull, lognormaal, exponentieel of gamma — aan de gegevens en berekent ze vervolgens capabiliteitsindices op basis van de werkelijke vorm van die verdeling.
Standaard capabiliteitsindices zoals Cp en Cpk gaan uit van normaliteit. Wanneer aan die aanname niet wordt voldaan, worden die indices onnauwkeurig en kunnen ze de werkelijke procescapabiliteit zowel over- als onderschatten. Niet-normale capabiliteit lost dit op door het juiste verdelingsmodel te gebruiken, wat een veel eerlijker en preciezer beeld geeft van de vraag of het proces consequent product binnen de specificatie kan leveren.
Eenvoudige definities: Een capabiliteitsanalyse voor scheve of niet-normale gegevens — ze fit de juiste verdeling aan uw gegevens en berekent daarna capabiliteitsindices op basis van die werkelijke vorm, in plaats van een onjuiste normaliteitsaanname af te dwingen.
Wanneer gebruikt u niet-normale procescapabiliteit?
- Gebruik deze analyse wanneer uw procesgegevens continu zijn maar een normaliteitstoets niet doorstaan — bijvoorbeeld cyclustijden, sterktemetingen of chemische concentraties die sterk scheef zijn.
- Gebruik deze analyse wanneer een waarschijnlijkheidsplot of normaliteitstoets bevestigt dat uw gegevens een specifieke niet-normale verdeling volgen, zoals Weibull, lognormaal, exponentieel of gamma.
- Gebruik deze analyse wanneer een Box-Cox- of Johnson-transformatie niet geschikt of praktisch is — bijvoorbeeld wanneer de getransformeerde gegevens moeilijk te interpreteren zijn in de oorspronkelijke eenheden.
- Gebruik deze analyse wanneer de tool Individual Distribution Identification de best passende verdeling voor uw gegevens heeft bevestigd.
Richtlijnen voor correct gebruik van niet-normale procescapabiliteit
- Voer altijd eerst Individual Distribution Identification uit om de best passende verdeling te bepalen voordat u die in deze analyse selecteert — een verkeerde verdeling geeft misleidende capabiliteitsindices.
- Verzamel ten minste 100 datapunten zodat het fitten van de verdeling betrouwbare en stabiele parameterschattingen oplevert.
- Zorg dat het proces stabiel en statistisch beheerst is voordat u de capabiliteitsanalyse uitvoert — een instabiel proces geeft zinloze capabiliteitscijfers, ongeacht welke verdeling wordt gebruikt.
- Gebruik deze analyse niet voor attribuutgegevens of telgegevens — gebruik in plaats daarvan binomiale of Poisson-capabiliteit.
- Controleer de gekozen verdeling met aanpassingsmaten en waarschijnlijkheidsplots — een hoge p-waarde en een rechte lijn in de waarschijnlijkheidsplot bevestigen een goede fit.
- Capabiliteitsindices zoals Pp, Ppk, Cp en Cpk worden gerapporteerd op basis van de percentielen van de gefitte verdeling in plaats van veelvouden van de standaardafwijking — interpreteer ze dienovereenkomstig.
Alternatieven: wanneer u geen niet-normale procescapabiliteit gebruikt
- Situatie
Gebruik in plaats daarvan
De gegevens zijn normaal verdeeld
Normale (standaard) capabiliteitsanalyse
De gegevens kunnen naar normaliteit worden getransformeerd
Capabiliteitsanalyse met Box-Cox- of Johnson-transformatie
De verdeling is onbekend of onduidelijk
Niet-parametrische procescapabiliteit
De gegevens zijn goed/fout of aantallen defecte eenheden
Binomiale capabiliteitsanalyse
De gegevens zijn aantallen gebeurtenissen (defecten per eenheid)
Poisson-capabiliteitsanalyse
Een gecombineerd grafisch en statistisch rapport is nodig
Capability Six Pack (Between/Within)
Voorbeeld van niet-normale procescapabiliteit?
Een fabrikant van auto-onderdelen ontwikkelt een kritisch onderdeel voor een OEM-klant. Om de kwaliteit te waarborgen, controleert een ingenieur of een boormachine aan de specificaties kan voldoen. Het onderdeel moet binnen een bereik vallen: een LSL (onderste specificatiegrens) van 22.15 en een USL (bovenste specificatiegrens) van 22.35. De ingenieur neemt 125 monsters van de machine en voert een machinecapabiliteitsstudie uit. De volgende stappen:
- De benodigde gegevens verzameld.
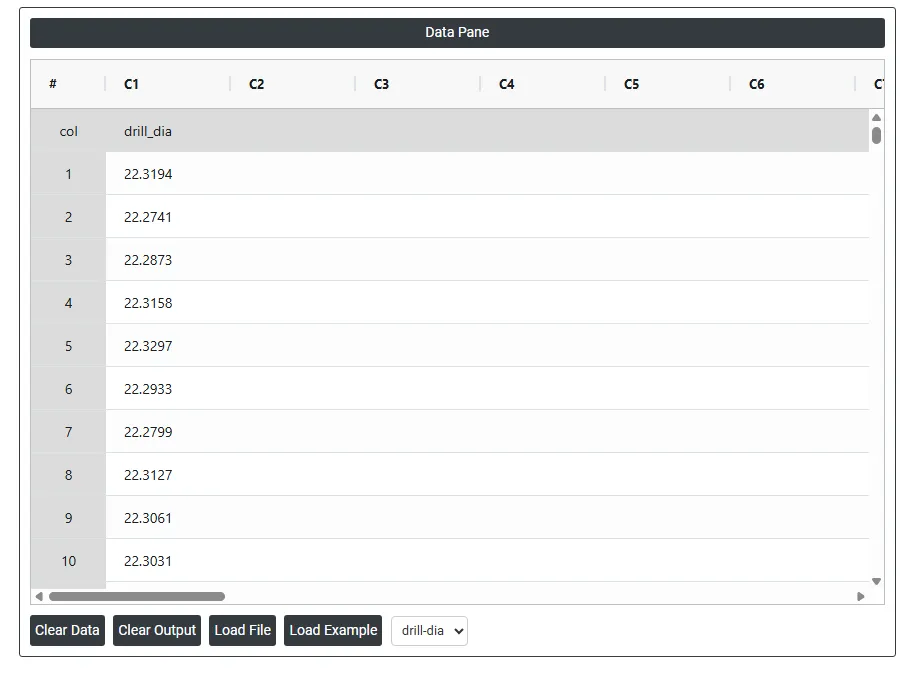
- Analyseer de gegevens nu in Zometric Statistical Software op https://statsai.zometric.com/.
- Om niet-normale procescapabiliteit te vinden, kiest u Statistical module> Control Chart>Non-Normal Process Capability.
- Voer in de tool de gegevens en de overige invoer als volgt in:
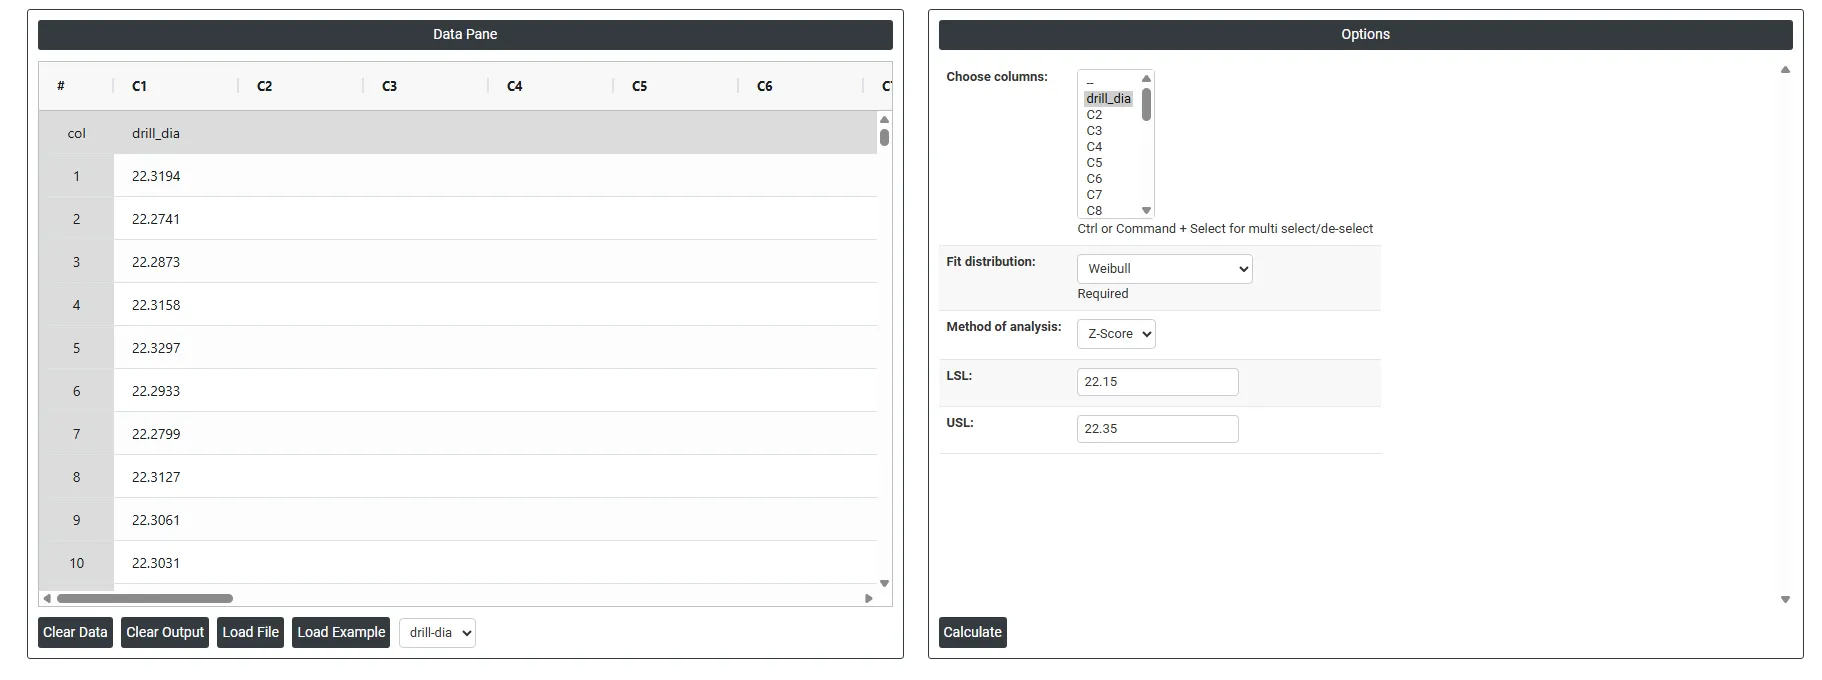
5. Na gebruik van de bovengenoemde tool wordt de uitvoer als volgt weergegeven:
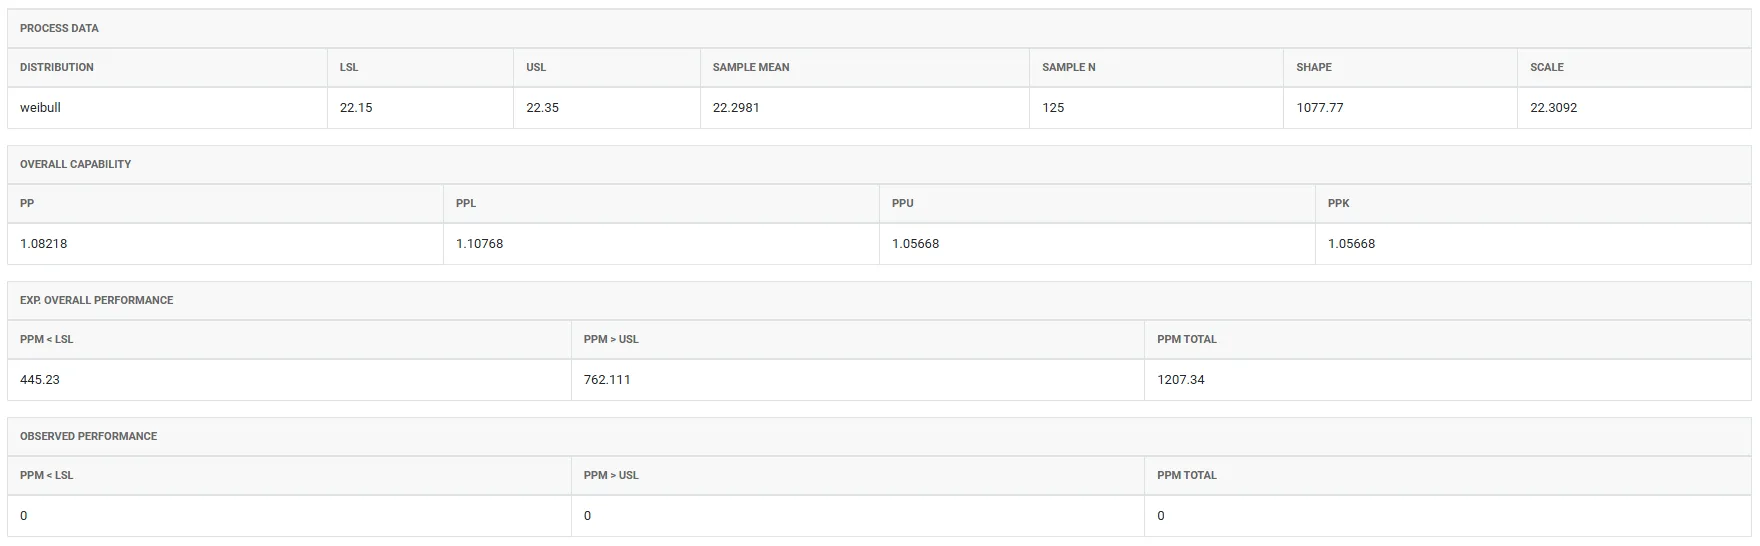
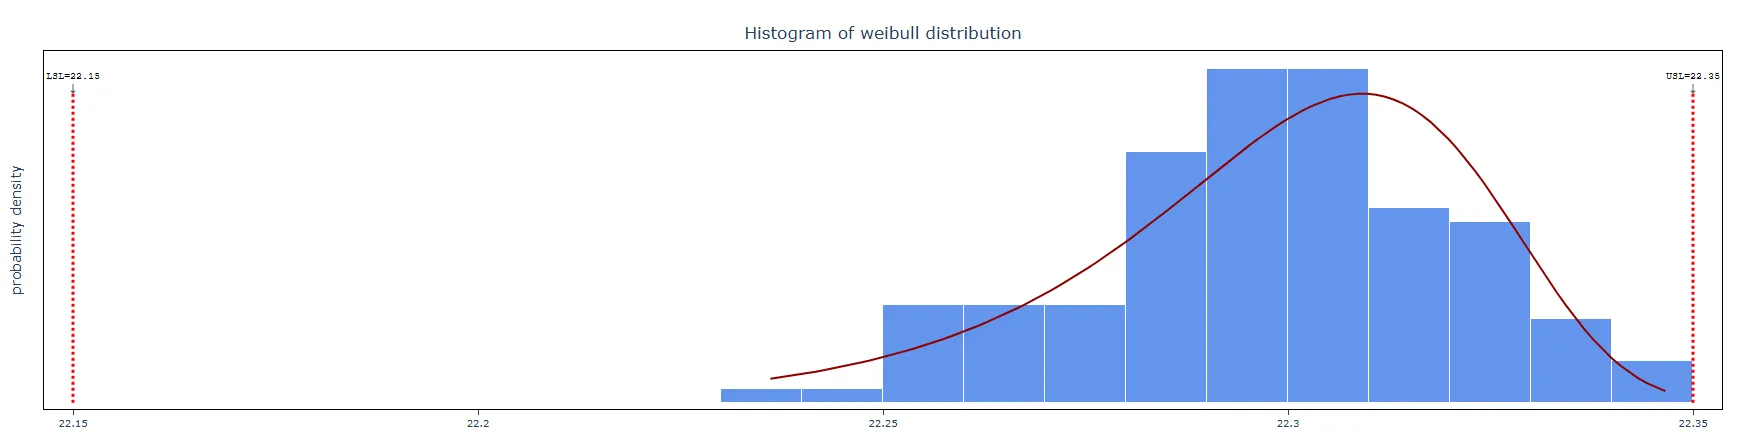
Zo voert u een niet-normale procescapabiliteitsanalyse uit.
De handleiding is als volgt:
- Meld u aan bij Zometric Statistical Software op https://statsai.zometric.com/
- Kies op de startpagina Statistical Tool> Control Chart>Non-Normal Process Capability .
- Werk vervolgens de gegevens handmatig bij, of kopieer (Ctrl+C) de gegevens volledig uit een Excel-blad en plak (Ctrl+V) ze hier.
- Vul de vereiste opties in.
- Klik ten slotte onderaan de pagina op Calculate en u krijgt de gewenste resultaten.
Op het dashboard van Non-Normal Process Capability is het venster in twee delen verdeeld.
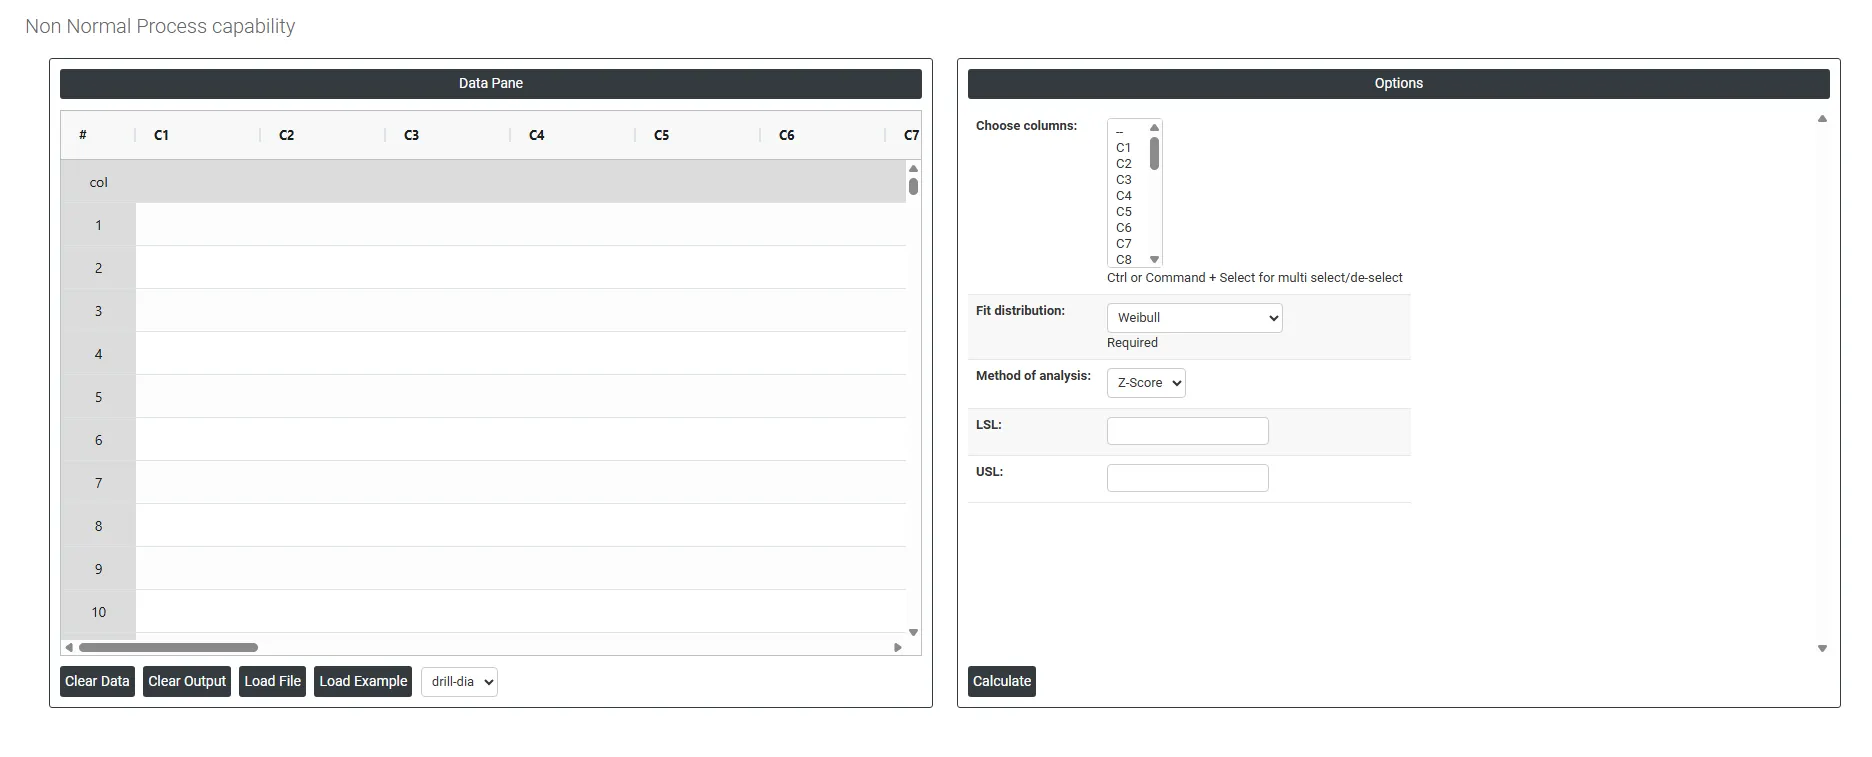
Links bevindt zich het Data Pane. In het Data Pane vormt elke rij één subgroep. Gegevens kunnen handmatig worden ingevoerd, of u kunt de gegevens volledig kopiëren (Ctrl+C) uit een Excel-blad en hier plakken (Ctrl+V).
Load example: Er worden voorbeeldgegevens geladen.
Load File: Hiermee laadt u Excel-gegevens rechtstreeks.
Rechts staan de volgende opties:
- Choose Columns Selecteer de kolom(men) met uw continue meetgegevens. Gebruik Ctrl of Command + klik om meerdere kolommen tegelijk te selecteren. Dit zijn de werkelijke procesmetingen — zoals boordiameters, treksterktes of cyclustijden — die op capabiliteit ten opzichte van de specificatiegrenzen worden geanalyseerd met de geselecteerde niet-normale verdeling.
- Fit Distribution Selecteer de verdeling die de vorm van uw gegevens het best beschrijft. Dit is de meest kritieke instelling in de analyse — de capabiliteitsindices worden berekend op basis van de wiskundige eigenschappen van de gekozen verdeling, dus een verkeerde keuze geeft onnauwkeurige resultaten. Voer altijd eerst Individual Distribution Identification uit om te bevestigen welke verdeling bij uw gegevens past voordat u deze keuze maakt. Beschikbare opties en hun typische toepassingen:
- Weibull — veel gebruikt voor betrouwbaarheids-, vermoeiingslevensduur- en uitvaltijdgegevens. Gaat goed om met naar rechts scheve gegevens en is een van de meest flexibele en breed toegepaste niet-normale verdelingen.
- Exponential — gebruikt voor gegevens over de tijd tussen onafhankelijke willekeurige gebeurtenissen, zoals de tijd tussen machinestoringen of binnenkomende servicemeldingen. Gaat uit van een constante faalfrequentie.
- Logistic — qua vorm vergelijkbaar met de normale verdeling maar met zwaardere staarten. Gebruikt wanneer de gegevens symmetrisch zijn maar meer extreme waarden hebben dan normaliteit zou voorspellen.
- Loglogistic — een naar rechts scheve verdeling voor overlevings- en betrouwbaarheidsgegevens, vergelijkbaar met de lognormale verdeling maar met zwaardere staarten. Geschikt voor uitvaltijd- of inkomensachtige gegevens.
- Largest Extreme Value — modelleert de verdeling van de maximumwaarde in een steekproef. Gebruikt wanneer de gegevens piekmetingen weergeven, zoals maximale spanning, waterstanden bij overstromingen of hoogste temperaturen.
- Smallest Extreme Value — modelleert de verdeling van de minimumwaarde in een steekproef. Veel gebruikt voor minimale sterkte of kleinste waargenomen metingen.
- 2-Parameter Exponential — een uitbreiding van de standaard exponentiële verdeling met een drempelparameter, waardoor de verdeling bij een andere waarde dan nul kan beginnen. Nuttig wanneer metingen niet onder een bepaald minimum kunnen liggen.
- 3-Parameter Weibull — voegt een locatieparameter (drempel) toe aan de standaard Weibull-verdeling, waardoor de verdeling bij een punt ongelijk aan nul kan beginnen. Nuttig wanneer onder een bekend minimum geen uitval of metingen kunnen optreden.
- Gamma — een flexibele naar rechts scheve verdeling die veel wordt toegepast op procestijden, wachttijden, neerslaghoeveelheden en andere positieve continue metingen die matig scheef zijn.
- Lognormal — gebruikt wanneer de logaritme van de gegevens normaal verdeeld is. Veel voorkomend bij chemische concentraties, deeltjesgroottes, reparatietijden en financiële gegevens waarbij de waarden strikt positief en naar rechts scheef zijn.
- Method of Analysis Bepaalt hoe de capabiliteitsstatistieken en specificatiegrenzen worden geïnterpreteerd en gerapporteerd. Er zijn twee opties:
- Z-Score — berekent de capabiliteit door specificatiegrenzen om te zetten in gestandaardiseerde Z-scores op basis van de percentielen van de gefitte verdeling. Dit drukt de capabiliteit uit in het aantal standaardafwijkingen dat de specificatiegrenzen van het procesmidden liggen, waardoor de resultaten vergelijkbaar zijn met standaard capabiliteitsindices voor de normale verdeling zoals Cp en Cpk.
- ISO — volgt de methodiek van de norm ISO 22514 voor niet-normale capabiliteitsanalyse. Deze methode berekent capabiliteitsindices rechtstreeks uit de percentielen van de verdeling (met name het 0.135e en het 99.865e percentiel, die overeenkomen met de ±3-sigmagrenzen van een normale verdeling), zonder omzetting naar Z-scores. Dit is de voorkeursmethode wanneer naleving van internationale kwaliteitsnormen vereist is.
- LSL (Lower Specification Limit) De minimaal aanvaardbare waarde van de meting. Elk datapunt onder deze waarde geldt als buiten de specificatie. Voer de LSL in die uw technische tekening, klanteis of productspecificatie voorschrijft. Ten minste één specificatiegrens (LSL of USL) moet worden opgegeven — beide kunnen worden ingevoerd als de meting tweezijdige specificaties heeft.
- USL (Upper Specification Limit) De maximaal aanvaardbare waarde van de meting. Elk datapunt boven deze waarde geldt als buiten de specificatie. Voer de USL in van uw technische tekening of productspecificatie. Als de procesgrootheid slechts een eenzijdige eis heeft — bijvoorbeeld een minimale sterkte zonder bovengrens — hoeft alleen de relevante grens te worden ingevoerd.
Veelgestelde vragen
Wat is niet-normale procescapabiliteitsanalyse?
Niet-normale procescapabiliteitsanalyse meet hoe goed een proces aan zijn specificatiegrenzen voldoet wanneer de gegevens geen normale verdeling volgen. In plaats van een normaliteitsaanname af te dwingen, fit ze een erkende verdeling zoals Weibull, lognormaal, exponentieel of gamma en berekent ze capabiliteitsindices uit de werkelijke vorm van die verdeling.
Waarom geen standaard Cp en Cpk gebruiken voor niet-normale gegevens?
Standaard Cp en Cpk gaan uit van normaliteit. Wanneer gegevens scheef of anderszins niet-normaal zijn, worden die indices onnauwkeurig en kunnen ze de werkelijke procescapabiliteit zowel over- als onderschatten. Het juiste verdelingsmodel geeft een eerlijker en preciezer beeld van de vraag of het proces consequent product binnen de specificatie kan leveren.
Hoe kiest u de juiste verdeling voor niet-normale capabiliteit?
Voer eerst Individual Distribution Identification uit om de best passende verdeling te vinden en controleer die vervolgens met aanpassingsmaten en waarschijnlijkheidsplots; een hoge p-waarde en een rechte lijn in de waarschijnlijkheidsplot wijzen op een goede fit. Een verkeerde verdeling geeft misleidende capabiliteitsindices. Past geen enkele verdeling, gebruik dan niet-parametrische procescapabiliteit.
Wat is het verschil tussen de methoden Z-Score en ISO?
De methode Z-Score zet specificatiegrenzen om in gestandaardiseerde Z-scores op basis van de percentielen van de gefitte verdeling, waardoor de resultaten vergelijkbaar zijn met Cp en Cpk voor de normale verdeling. De methode ISO volgt ISO 22514 en berekent indices rechtstreeks uit het 0.135e en het 99.865e percentiel van de gefitte verdeling, en heeft de voorkeur wanneer naleving van internationale normen vereist is.