
Niet-lineaire regressie
Nonlinear Regression fit een curve waarvan de parameters niet lineair voorkomen aan één respons en één voorspeller. Gebruik haar wanneer de fysica of chemie van het proces de vorm van de curve bepaalt. Kies een van zeven ingebouwde functies of een zelf gedefinieerde, en geef zinvolle startwaarden op. De uitvoer bevat parameterschattingen met standaardfouten en betrouwbaarheidsintervallen, een fitted line plot, een correlatiematrix en een lack-of-fit-toets.
Laatst beoordeeld
Belangrijkste conclusie
Niet-lineaire regressie fit een curve waarvan de parameters niet-lineair voorkomen, zoals een exponentiële nadering van een limiet, om parameters zoals een grenswaarde of snelheidsconstante te schatten met betrouwbaarheidsintervallen.
Op deze pagina
Doel
Nonlinear Regression fit een curve waarvan de parameters niet lineair voorkomen, zoals een exponentiële nadering van een limiet, een verzadigingscurve of een S-vormige groeicurve, aan één respons en één voorspeller. Gebruik haar wanneer de fysica of chemie van het proces u de vorm van de curve vertelt en u schattingen van de parameters wilt, zoals een grenswaarde of een snelheidsconstante, met betrouwbaarheidsintervallen.
Belangrijkste mogelijkheden
- Zeven ingebouwde verwachtingsfuncties: exponentiële afname, exponentiële groei, macht, logistisch met 3 parameters, Michaelis-Menten, Gompertz en kwadratisch.
- Zelf gedefinieerde verwachtingsfunctie in X met parameters b1, b2, …, met + − * / ^ en exp, log, ln, log10, sqrt, abs, sin, cos, tan, arctan.
- Fitten met Gauss-Newton, Levenberg-Marquardt of Trust Region Reflective, met uw eigen startwaarden, iteratielimiet en tolerantie.
- Parameterschattingen met standaardfouten en betrouwbaarheidsintervallen, en hun correlatiematrix.
- Fitted line plot met optionele betrouwbaarheids- en voorspellingsbanden.
- Lack-of-fit-toets wanneer de voorspeller herhaalde waarden heeft.
- Optionele kolom met gewichten en residuplots.
Statistische methoden
De tool zoekt de parameterwaarden θ die de kwadratensom van de fouten SSE = Σ (yᵢ − f(xᵢ, θ))² minimaliseren, of Σ wᵢ (yᵢ − f(xᵢ, θ))² met een kolom gewichten. Levenberg-Marquardt (standaard) en Trust Region Reflective gebruiken de kleinste-kwadratenoplossers van SciPy; Gauss-Newton gebruikt stapverhalvering en rapporteert het aantal iteraties. De iteratie stopt wanneer de relatieve verandering in SSE en in de parameters onder de convergentietolerantie komt. Rijen met een ontbrekende waarde in de respons, voorspeller of gewichten worden weggelaten.
Standaardfouten komen uit de lineaire benadering in de oplossing: Cov(θ) = MSE·(JᵀJ)⁻¹, waarbij J de matrix van afgeleiden van f naar de parameters is en MSE = SSE / (n − p) voor p parameters; S = √MSE. Betrouwbaarheidsintervallen zijn θ ± t(1−α/2, n−p)·SE. De betrouwbaarheidsband voor de curve gebruikt dezelfde benadering; de voorspellingsband voegt MSE toe voor één enkele nieuwe meting. Deze intervallen zijn bij benadering en worden onbetrouwbaar als de parameters slecht bepaald zijn, wat zich toont als correlaties nabij ±1 in de correlatiematrix.
Wanneer sommige voorspellerwaarden herhaald zijn, wordt de foutenkwadratensom gesplitst in zuivere fout (spreiding tussen herhalingen) en lack of fit, en F = MS lack-of-fit / MS pure error toetst of de gekozen curve past. Startwaarden doen ertoe: ingebouwde functies starten vanaf vaste standaardwaarden (bijvoorbeeld a = 1, b = 1 voor Michaelis-Menten), met c op de mediaan van X voor de logistische en Gompertz-curven; een zelf gedefinieerde functie vereist één startwaarde per parameter. Geef waarden dicht bij wat u verwacht, anders kan de fit mislukken of een slecht lokaal minimum vinden.
Invoervelden en opties
Veld | Beschrijving |
Response (Y) / Predictor (X) | Numerieke kolommen; moeten verschillend zijn. Vereist. |
Expectation function | Exponential decay y = a·exp(−b·x) (standaard), Exponential growth, Power y = a·x^b, Logistic (3-param), Michaelis-Menten y = a·x/(b + x), Gompertz, Quadratic, of User-defined expectation function. |
Expectation function (user-defined) | Getoond bij de keuze voor zelf gedefinieerd. Formule in X met parameters b1, b2, …, bijv. b1 * exp(-b2 * X). |
Weights (optional) | Kolom met gewichten voor gewogen kleinste kwadraten. |
Starting values (space-separated) | Eén waarde per parameter, in volgorde. Optioneel voor ingebouwde functies (standaardwaarden worden gebruikt als het leeg is), vereist voor een zelf gedefinieerde. |
Confidence level | Standaard 95. |
Fitting algorithm | Gauss-Newton, Levenberg-Marquardt (standaard) of Trust Region Reflective. |
Maximum number of iterations / Convergence tolerance | Standaardwaarden 200 en 1e-05. |
Display confidence interval on fitted curve / Display prediction interval on fitted curve | Voegt de banden toe aan de fitted line plot. Standaard uit. |
Histogram of residuals / Normal plot of residuals / Residuals versus fits / Residuals versus order / Four in one | Residuplots; Four in one tekent alle vier samen. |
Residuals versus the variables | Zet de residuen uit tegen een gekozen kolom. |
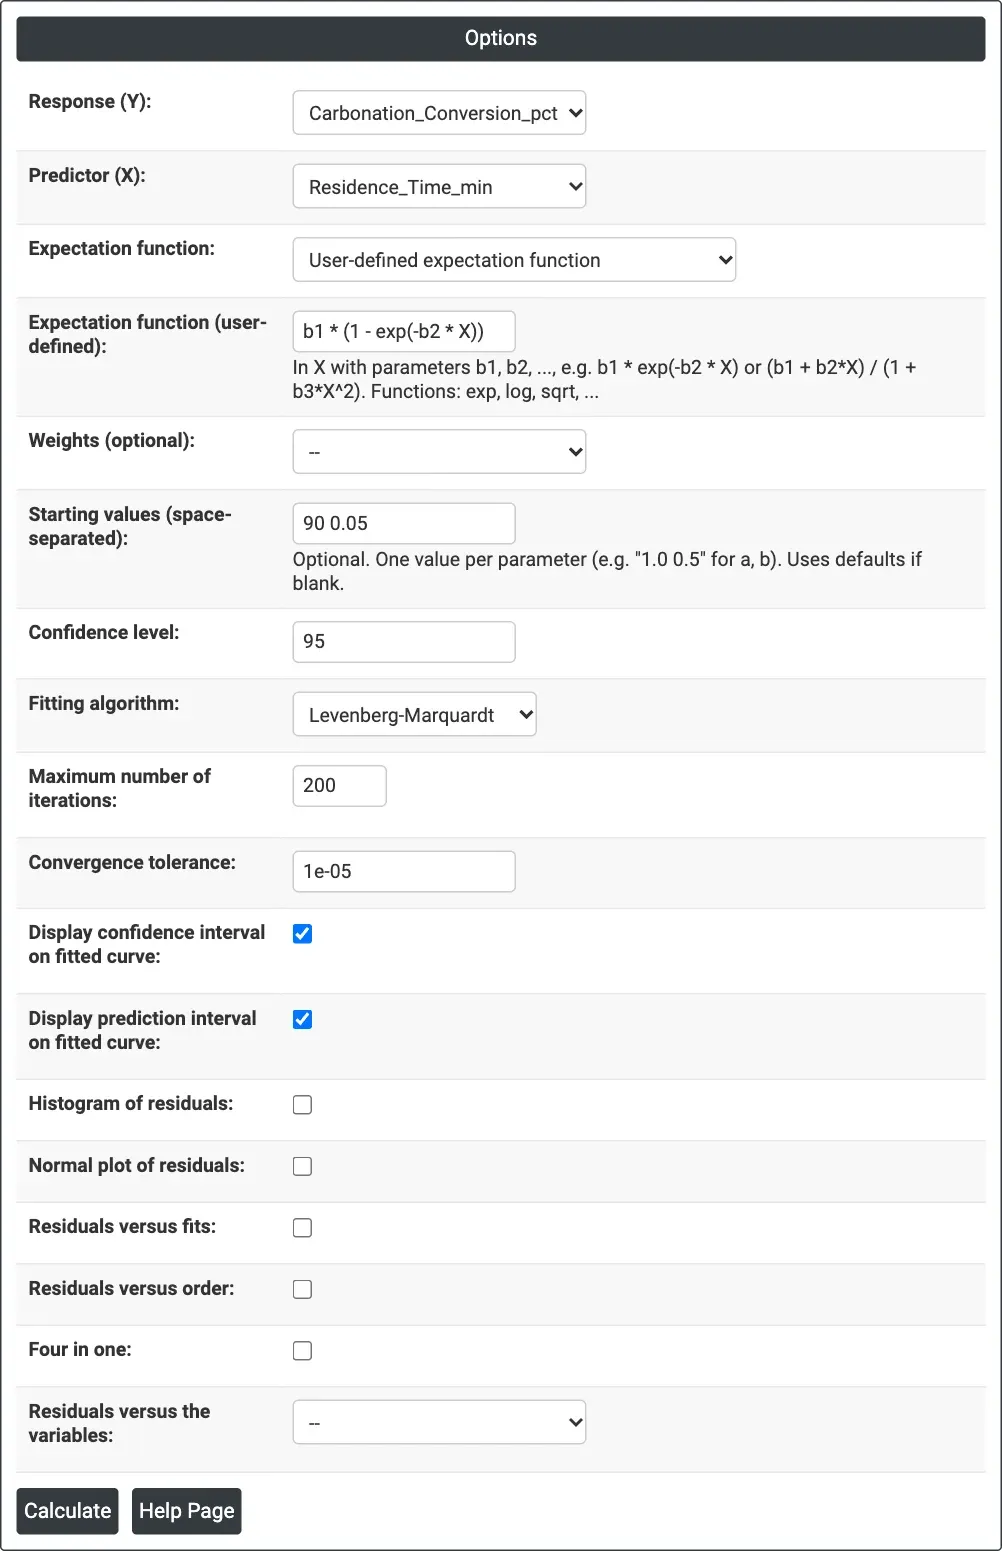
Figuur 1 — Opties voor het carbonatatievoorbeeld: zelf gedefinieerde functie b1 * (1 - exp(-b2 * X)) met startwaarden 90 en 0.05, betrouwbaarheids- en voorspellingsbanden aangevinkt.
Beschrijving van de uitvoer
- Method — algoritme, maximaal aantal iteraties, tolerantie en, voor Gauss-Newton, de gebruikte iteraties.
- Starting Values for Parameters — de waarden waarmee de fit startte.
- Regression Equation — de gefitte curve met de kolomnamen.
- Parameter Estimates — Estimate, SE Estimate en betrouwbaarheidsgrenzen voor elke parameter.
- Summary of Fit — Final SSE, DFE, MSE en S.
- Fitted Line Plot — gegevens, gefitte curve en optionele CI- en PI-banden.
- Correlation Matrix for Parameter Estimates.
- Lack-of-Fit — rijen voor fout, lack-of-fit en zuivere fout met F en P, wanneer de voorspeller herhaalde waarden heeft.
- Residuplots, indien geselecteerd.
- Pdf-export via Download.
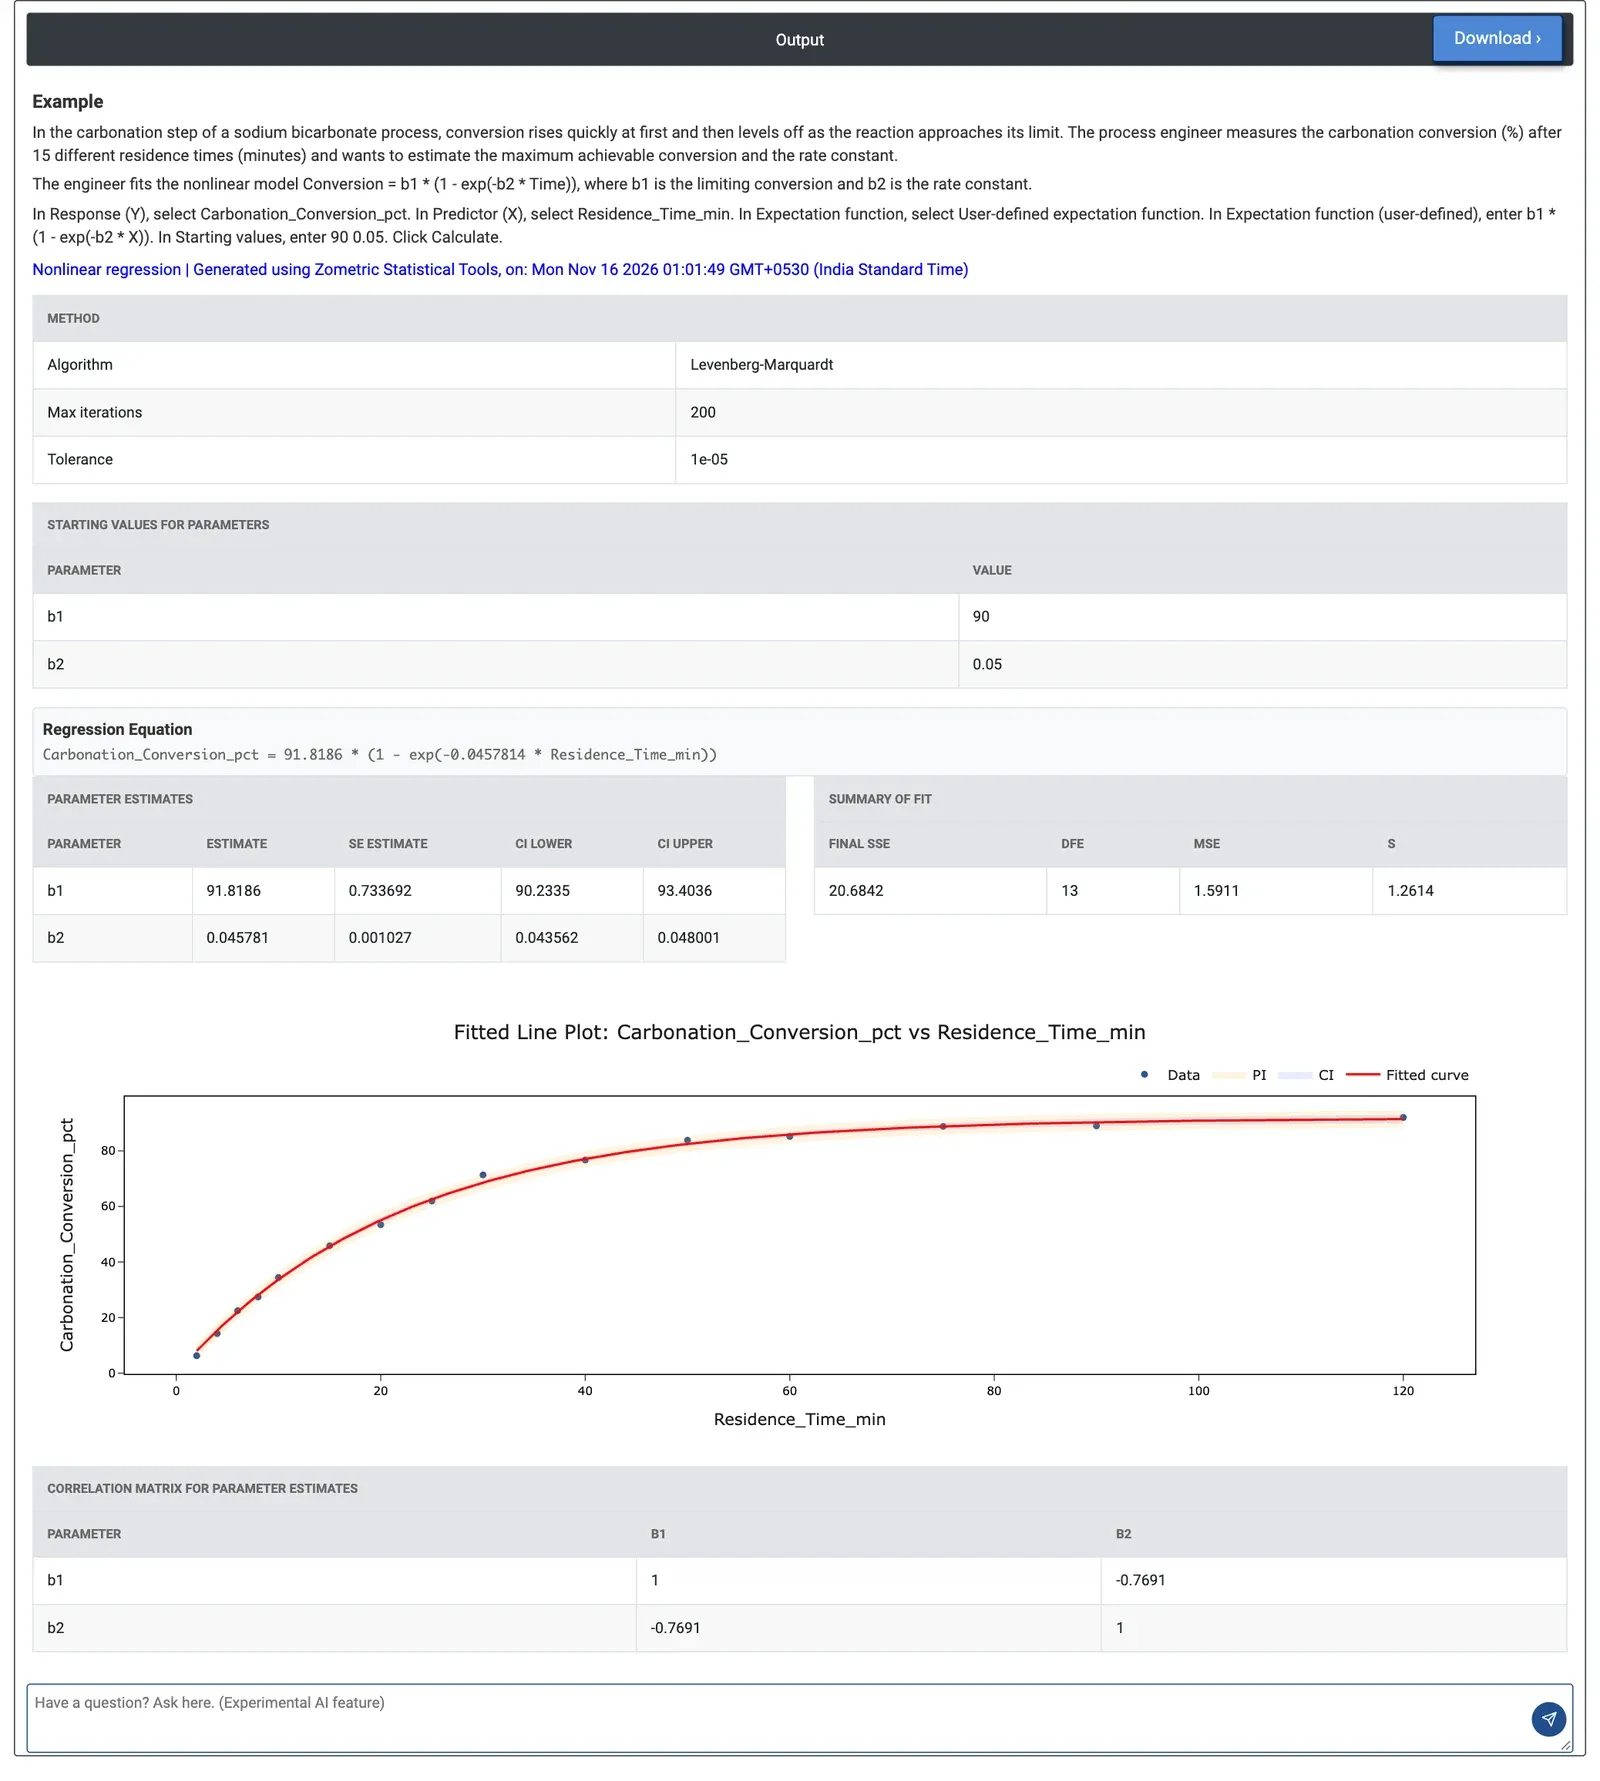
Figuur 2 — Carbonatatieconversie tegen verblijftijd: grensconversie b1 = 91.82% en snelheidsconstante b2 = 0.0458 per minuut, S = 1.26.
Uitgewerkt voorbeeld
In de carbonatatiestap van een natriumbicarbonaatproces stijgt de conversie snel en vlakt daarna af. Een procesingenieur meet de conversie (%) bij 15 verblijftijden van 2 tot 120 minuten en wil de grensconversie en de snelheidsconstante weten. De ingenieur voert het eerste-ordemodel Conversion = b1·(1 − exp(−b2·Time)) in als zelf gedefinieerde functie, geeft startwaarden 90 en 0.05 op en vinkt beide banden aan.
De fit convergeert naar b1 = 91.82% (95%-BI 90.23 tot 93.40) en b2 = 0.0458 per minuut (95%-BI 0.0436 tot 0.0480). S is 1.26 procentpunt, klein ten opzichte van een bereik van 6 tot 92%, en de punten liggen over de hele lengte op de curve. De correlatie tussen b1 en b2 is −0.77: matig, dus beide parameters zijn goed bepaald. Gauss-Newton geeft dezelfde schattingen in 3 iteraties. Omdat er geen herhaalde verblijftijden zijn, wordt geen lack-of-fit-toets getoond.
Uit de gefitte curve wordt 90% van de grensconversie bereikt bij ln(10)/b2 ≈ 50 minuten en 95% bij ongeveer 65 minuten; bij 30 minuten is de conversie slechts ongeveer 69%. Verblijftijden ruim boven een uur leveren weinig extra conversie op, wat de ingenieur helpt bij het vaststellen van de doorzet van de toren.
Veelgestelde vragen
Wat is niet-lineaire regressie?
Niet-lineaire regressie fit een curve waarvan de parameters niet lineair voorkomen, zoals een exponentiële nadering van een limiet, een verzadigingscurve of een S-vormige groeicurve, aan één respons en één voorspeller. Ze zoekt de parameterwaarden die de kwadratensom van de fouten minimaliseren en rapporteert ze met standaardfouten en betrouwbaarheidsintervallen.
Wanneer gebruikt u niet-lineaire regressie?
Gebruik niet-lineaire regressie wanneer de fysica of chemie van het proces u de vorm van de curve vertelt en u schattingen van de parameters wilt, zoals een grenswaarde of een snelheidsconstante. Ingebouwde vormen zijn onder meer exponentiële afname en groei, macht, logistisch met 3 parameters, Michaelis-Menten, Gompertz en kwadratisch, of u kunt uw eigen functie definiëren.
Waarom doen startwaarden ertoe bij niet-lineaire regressie?
De fit is iteratief en begint dus bij startwaarden. Ingebouwde functies gebruiken vaste standaardwaarden, terwijl een zelf gedefinieerde functie één startwaarde per parameter vereist. Waarden dicht bij wat u verwacht helpen de fit te laten convergeren; slechte startwaarden kunnen de fit laten mislukken of op een slecht lokaal minimum laten uitkomen.
Hoe weet u of een niet-lineaire regressiefit betrouwbaar is?
Controleer S en hoe dicht de punten de curve volgen, en bekijk de residuplots. De betrouwbaarheidsintervallen zijn bij benadering en worden onbetrouwbaar als parameters slecht bepaald zijn, wat zich toont als correlaties nabij plus of min 1 in de correlatiematrix van de parameters. Wanneer voorspellerwaarden herhaald zijn, toetst een lack-of-fit-F-toets of de gekozen curve past.