
OECD-beslisboom voor statistische toetsen
De OECD Statistical Decision Tree-tool is een begeleid statistisch analysesysteem, gebouwd op het beslissingskader voor het kiezen en toepassen van de juiste statistische toets op experimentele gegevens. In plaats van dat gebruikers zelf door ingewikkelde statistische theorie moeten navigeren, volgt de tool automatisch het OECD-beslispad — in elke fase beoordeelt ze gegevenstype, normaliteit, homogeniteit van varianties en aantal groepen — en past ze de passende toets toe.
Laatst beoordeeld
Belangrijkste conclusie
De OECD Statistical Decision Tree-tool is een begeleid statistisch analysesysteem, gebouwd op het beslissingskader voor het kiezen en toepassen van de juiste statistische toets op experimentele gegevens.
Op deze pagina
- Wat is OECD?
- Wanneer gebruikt u OECD?
- Stap 1 — Beoordeling van het gegevenstype
- Stap 2 — Normaliteitscontrole (continue gegevens)
- Stap 3 — Parametrisch pad
- Stap 4 — Niet-parametrisch pad
- Richtlijnen voor correct gebruik van OECD
- Alternatieven: wanneer u OECD niet gebruikt
- Voorbeeld van OECD
- Zo voert u OECD uit
Wat is OECD?
De OECD Statistical Decision Tree-tool is een begeleid statistisch analysesysteem, gebouwd op het beslissingskader voor het kiezen en toepassen van de juiste statistische toets op experimentele gegevens. In plaats van dat gebruikers zelf door ingewikkelde statistische theorie moeten navigeren, volgt de tool automatisch het OECD-beslispad — in elke fase beoordeelt ze gegevenstype, normaliteit, homogeniteit van varianties en aantal groepen — en past ze de passende toets toe.
De tool is ontworpen om te waarborgen dat statistische conclusies wetenschappelijk geldig, volledig reproduceerbaar en conform internationaal erkende richtlijnen zijn. Dit is vooral cruciaal in toxicologie, milieukunde, farmaceutisch onderzoek en studies voor regelgevende indieningen, waar de keuze van de statistische toets gedocumenteerd, onderbouwd en bij een audit verdedigbaar moet zijn.
Eenvoudige definitie: Een slimme, geautomatiseerde tool die het statistische beslisschema van de OECD stap voor stap volgt — ze beoordeelt uw gegevenstype, verdeling en groepsstructuur — om automatisch de juiste statistische toets te kiezen en toe te passen, zodat u altijd een geldig en verdedigbaar resultaat krijgt.
Wanneer gebruikt u OECD?
- De OECD-schemabenadering wordt gebruikt wanneer u een volledige statistische vergelijkingsketen in één keer moet uitvoeren, in plaats van toets voor toets te beslissen terwijl u verdergaat. In plaats van na elke toets te stoppen om te bepalen wat er volgt, voert u vooraf uw gegevenskenmerken in — gegevenstype, normaliteitsresultaat, variantieresultaat — en wordt de hele beslisboom in één keer afgehandeld.
- Het is in de eerste plaats een vergelijkingskader — het is specifiek ontworpen om te bepalen welke statistische toets geschikt is bij het vergelijken van groepen (2 groepen of 3+ groepen) onderling of met een controlegroep. In plaats van bij elke stap toets voor toets te beslissen, voert u vooraf uw gegevenskenmerken in. Vooral gebruikt in de farmaceutische sector.
De tool volgt het OECD-schema in een strikt logische volgorde. Elke stap levert een beslissing op die bepaalt welke tak van het pad daarna wordt gevolgd. Als u deze stroom begrijpt, kunt u de uitvoer van de tool beter interpreteren en begrijpen waarom een bepaalde statistische toets voor uw specifieke gegevens is gekozen.
Stap 1 — Beoordeling van het gegevenstype
Het eerste beslispunt bepaalt of uw gegevens continu of discreet/quantaal zijn. Dit onderscheid stuurt het hele verdere pad.
Gegevenstype
Beschrijving en voorbeelden
Continue gegevens
Gemeten numerieke waarden die elke waarde binnen een bereik kunnen aannemen — zoals lichaamsgewicht, enzymactiviteit, orgaangewicht, concentratie of hematologische parameters. Bij continue gegevens gaat de tool door naar een normaliteitscontrole.
Discrete of quantale gegevens
Tellingen, percentages, proporties, rangordes of categorische uitkomsten — zoals het aantal aangedane dieren, de incidentie van een laesie, aan- of afwezigheid van een respons of ernstscores. Bij deze gegevens gaat de tool direct door naar de keuze van een niet-parametrische of categorische toets.
Stap 2 — Normaliteitscontrole (continue gegevens)
Voor continue gegevens controleert de tool met de geselecteerde normaliteitstoetsen of de gegevens een normale (klokvormige) verdeling volgen. Het resultaat bepaalt welk statistisch pad wordt gevolgd.
Als normaliteit NIET wordt verworpen (p ≥ α) — gegevens zijn normaal:
→ De tool gaat verder langs het parametrische pad.
→ Parametrische toetsen hebben een groter onderscheidend vermogen en moeten altijd worden gebruikt wanneer normaliteit is bevestigd.
Als normaliteit WEL wordt verworpen (p < α) — gegevens zijn niet-normaal:
→ Er wordt een gegevenstransformatie geprobeerd (log, wortel, enz.).
→ Normaliteit wordt opnieuw gecontroleerd op de getransformeerde gegevens.
→ Als de getransformeerde gegevens normaal zijn → worden parametrische toetsen op de getransformeerde gegevens toegepast.
→ Als de getransformeerde gegevens nog steeds niet-normaal zijn → gaat de tool over op het niet-parametrische pad.
Stap 3 — Parametrisch pad
Zodra de gegevens als normaal zijn bevestigd (of met succes naar normaliteit zijn getransformeerd), bepaalt de tool de passende parametrische toets op basis van het aantal groepen dat wordt vergeleken.
2 groepen vergelijken
De tool controleert de homogeniteit van varianties met de F-toets om te bepalen of de twee groepen statistisch gelijke variantie hebben.
Resultaat homogeniteit van varianties
Toegepaste statistische toets
Varianties gelijk (F-toets niet significant)
De t-toets van Student wordt toegepast. Dit is de standaard tweesteekproef-t-toets die gelijke variantie in beide groepen veronderstelt.
Varianties ongelijk (F-toets significant)
De methode van Satterthwaite (t-toets van Welch) wordt toegepast. Deze variant veronderstelt geen gelijke variantie en past de vrijheidsgraden dienovereenkomstig aan.
3 of meer groepen vergelijken
De tool controleert de homogeniteit van varianties met de toets van Bartlett, de toets van Levene of de Brown-Forsythe-toets.
Resultaat homogeniteit van varianties
Toegepaste statistische toets
Varianties gelijk (niet significant)
Variantieanalyse (ANOVA) wordt toegepast. → Als ANOVA significant is: de toets van Dunnett wordt uitgevoerd voor paarsgewijze vergelijking van elke behandelgroep met de controlegroep. → Als ANOVA niet significant is: verdere toetsing is niet nodig. Stop.
Varianties ongelijk (significant)
De tool gaat direct door naar de passende toets die geen homogeniteit van varianties veronderstelt.
Stap 4 — Niet-parametrisch pad
Wanneer gegevens niet kunnen worden genormaliseerd, of wanneer de gegevens uit tellingen, percentages of rangorden bestaan, volgt de tool het niet-parametrische pad.
Gegevenssituatie
Toegepaste toets
Uitkomst / vervolg
Telling-/percentage-/rangordegegevens, ≥ 3 groepen
Kruskal-Wallis-toets
Indien significant → toets van Dunn (post-hoc). Indien niet significant → stop.
Telling-/percentage-/rangordegegevens, 2 groepen
Mann-Whitney U-toets
Directe vergelijking tussen twee onafhankelijke groepen.
Categorische gegevens of indices
Chikwadraattoets
De keuze van de toets hangt af van de specifieke gegevensstructuur en de onderzoeksopzet.
Richtlijnen voor correct gebruik van OECD
- Zorg dat gegevens correct en consistent worden ingevoerd — invoerfouten in de invoerfase planten zich voort door elke volgende beslissing in de boom en kunnen ertoe leiden dat een verkeerde toets wordt toegepast.
- Selecteer responskolommen zorgvuldig — als meerdere responsen zijn geselecteerd, moet elke kolom een volledige, onafhankelijke groepsdatasetvertegenwoordigen. Als één respons is geselecteerd, zorg dan dat de factorkolom het groepslidmaatschap van elke waarneming correct en volledig aangeeft.
- Houd beide normaliteitstoetsen, Anderson-Darling en Shapiro-Wilk , actief (de standaard). Twee onafhankelijke toetsen die dezelfde normaliteitsconclusie bevestigen, versterken de wetenschappelijke verdedigbaarheid van het gekozen pad.
Alternatieven: wanneer u OECD niet gebruikt
- Als uw studie niet aan OECD-richtlijnen hoeft te voldoen en geen regelgevende context heeft, gebruik dan rechtstreeks de meest geschikte specifieke statistische toets — het OECD-beslisboomkader voegt gestructureerde overhead toe die voor louter verkennende of academische analyses onnodig kan zijn.
- Als uw studie regressie, correlatieanalyse of dosis-responsmodellering vereist in plaats van een eenvoudige groepsvergelijking, gebruik dan de passende regressie- of modelleringstools — de OECD-tool is specifiek ontworpen voor vergelijking van groepsgemiddelden, niet voor het fitten van verbanden tussen continue variabelen.
- Als u gepaarde waarnemingen hebt — bijvoorbeeld metingen voor en na bij hetzelfde proefdier of dezelfde persoon — gebruik dan een gepaarde t-toets of de Wilcoxon-rangtekentoets . De OECD-beslisboom zoals hier geïmplementeerd veronderstelt onafhankelijke groepen.
- Als de gegevens van nature tijdreeksen of longitudinaal zijn, waarbij metingen zich over meerdere opeenvolgende tijdstippen ontwikkelen, gebruik dan ANOVA voor herhaalde metingen, gemengde-effectenmodellen of tijdreeksanalyse
- Als het primaire analysedoel equivalentietoetsing of beoordeling van niet-inferioriteit is in plaats van het opsporen van verschillen, gebruik dan speciale equivalentietoetsprocedures in plaats van het standaard superioriteitskader van de OECD-beslisboom.
Voorbeeld van OECD
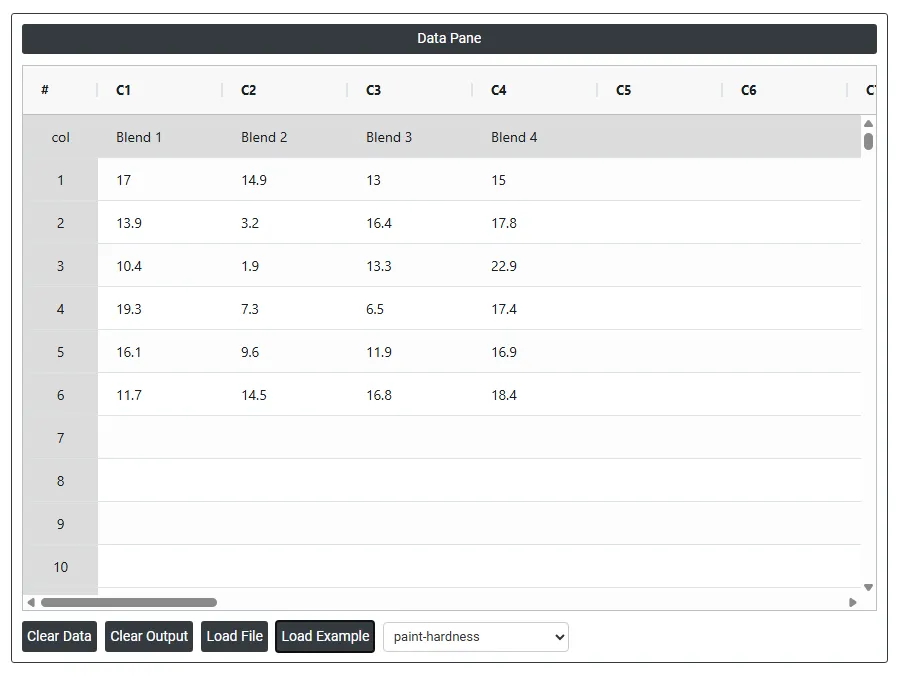
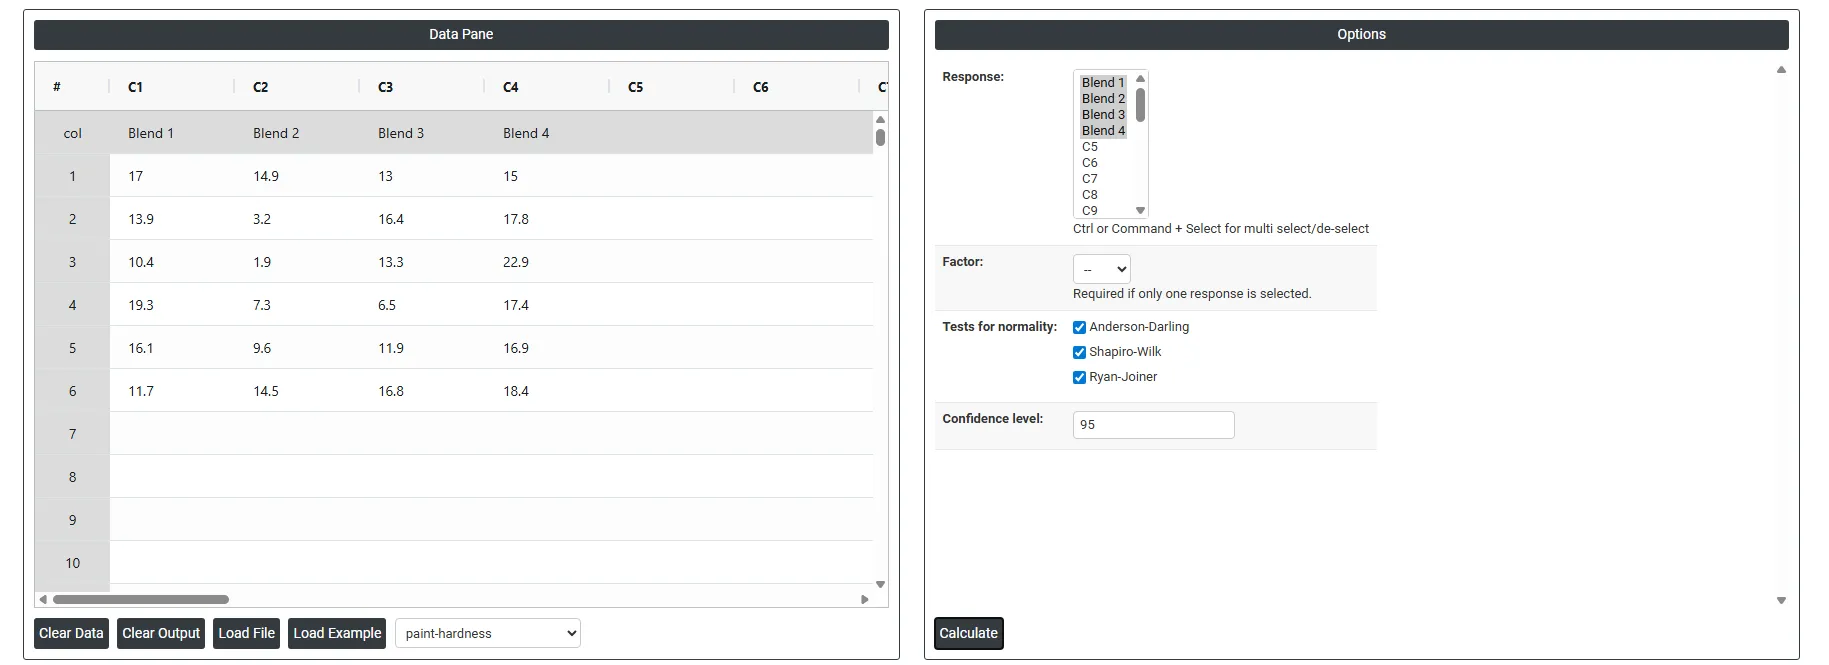
Een chemisch ingenieur wil de hardheid van vier verfmengsels vergelijken. Van elk verfmengsel zijn zes monsters op een stuk metaal aangebracht, dat vervolgens is uitgehard. Daarna is de hardheid van elk monster gemeten. De volgende stappen:
- De benodigde gegevens verzameld.
2. Analyseer de gegevens nu in Zometric Statistical Software op https://statsai.zometric.com/.
3. Om OECD te vinden, kiest u Statistical module> OECD>OECD.
4. Voer in de tool de gegevens en de overige invoer als volgt in:
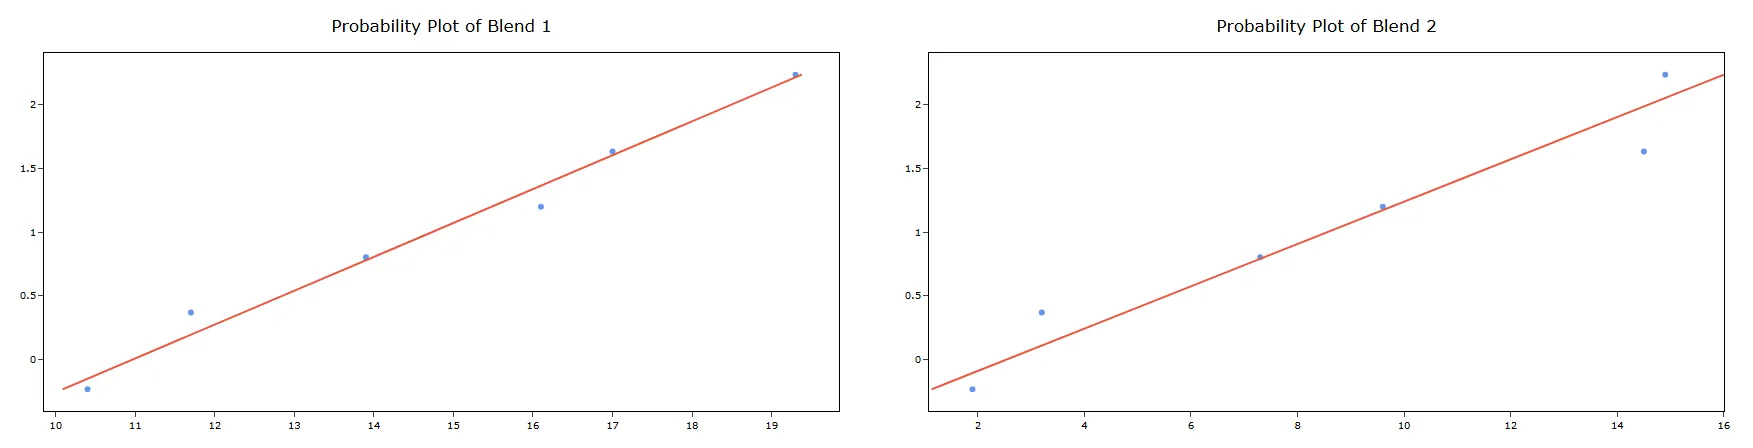
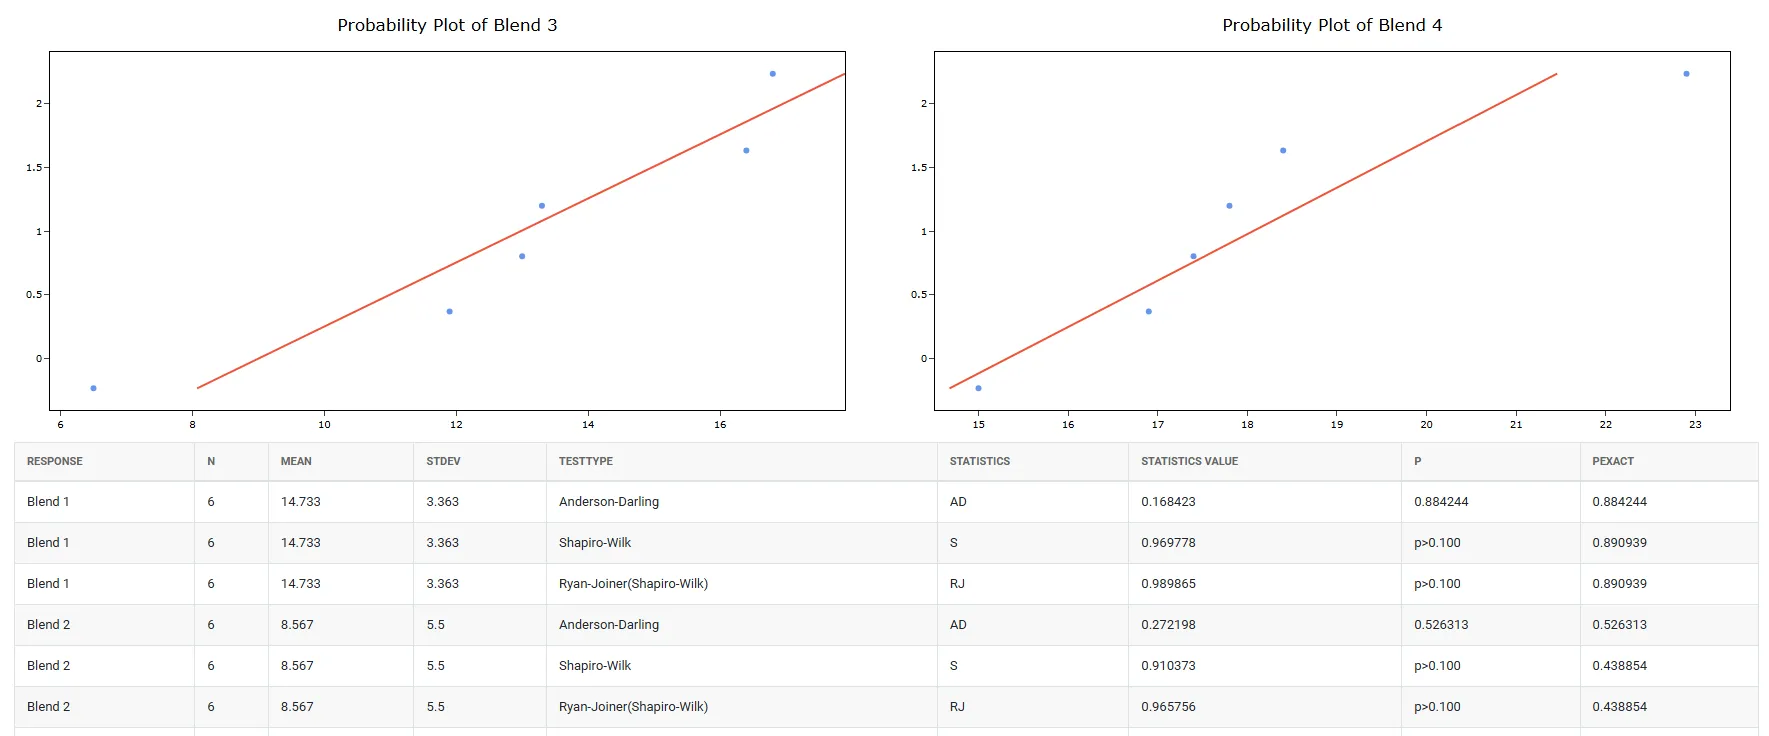
5. Na gebruik van de bovengenoemde tool wordt de uitvoer als volgt weergegeven:
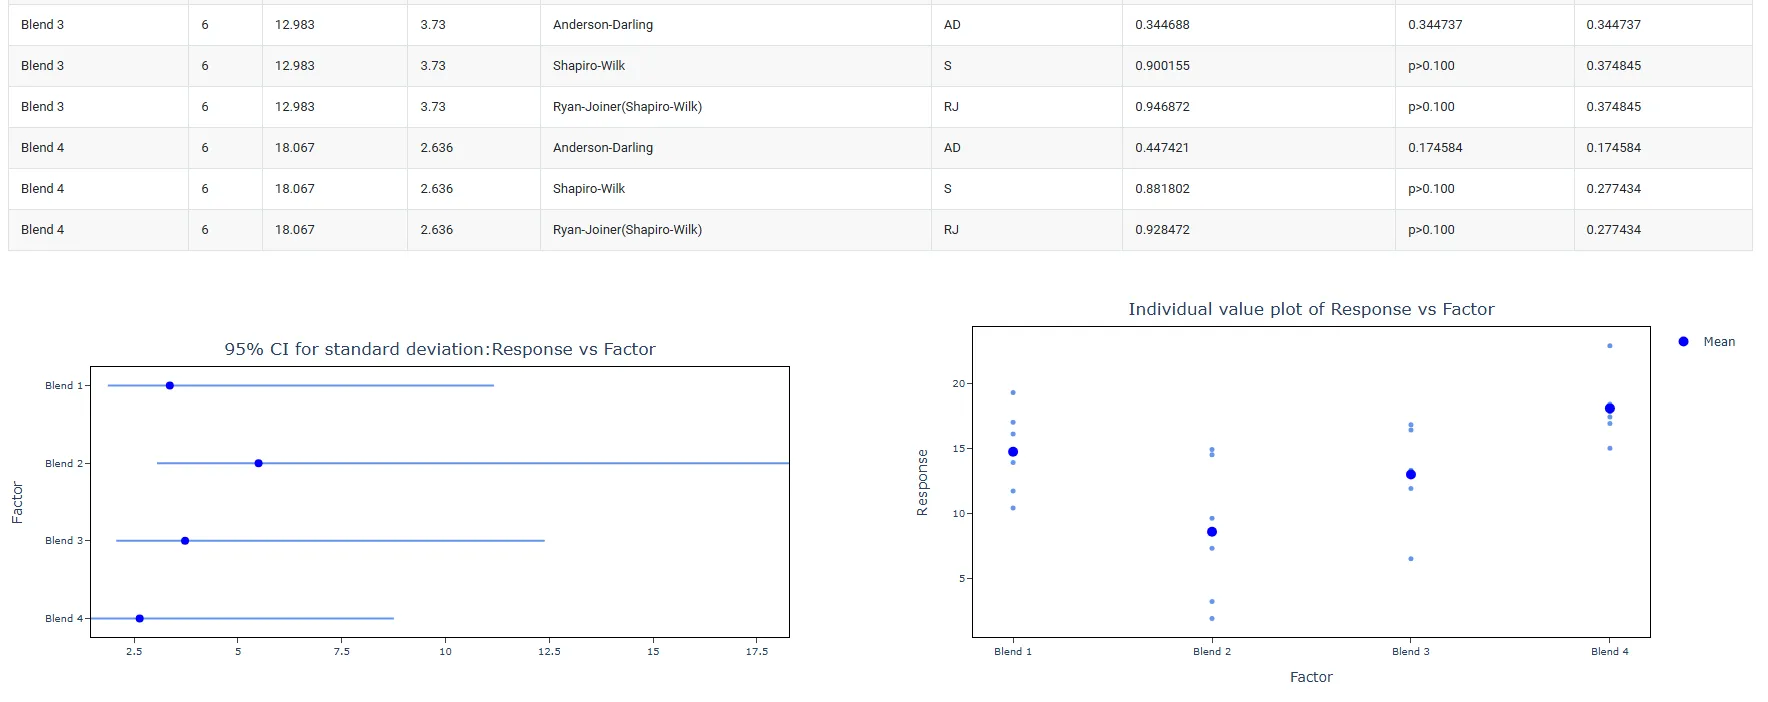
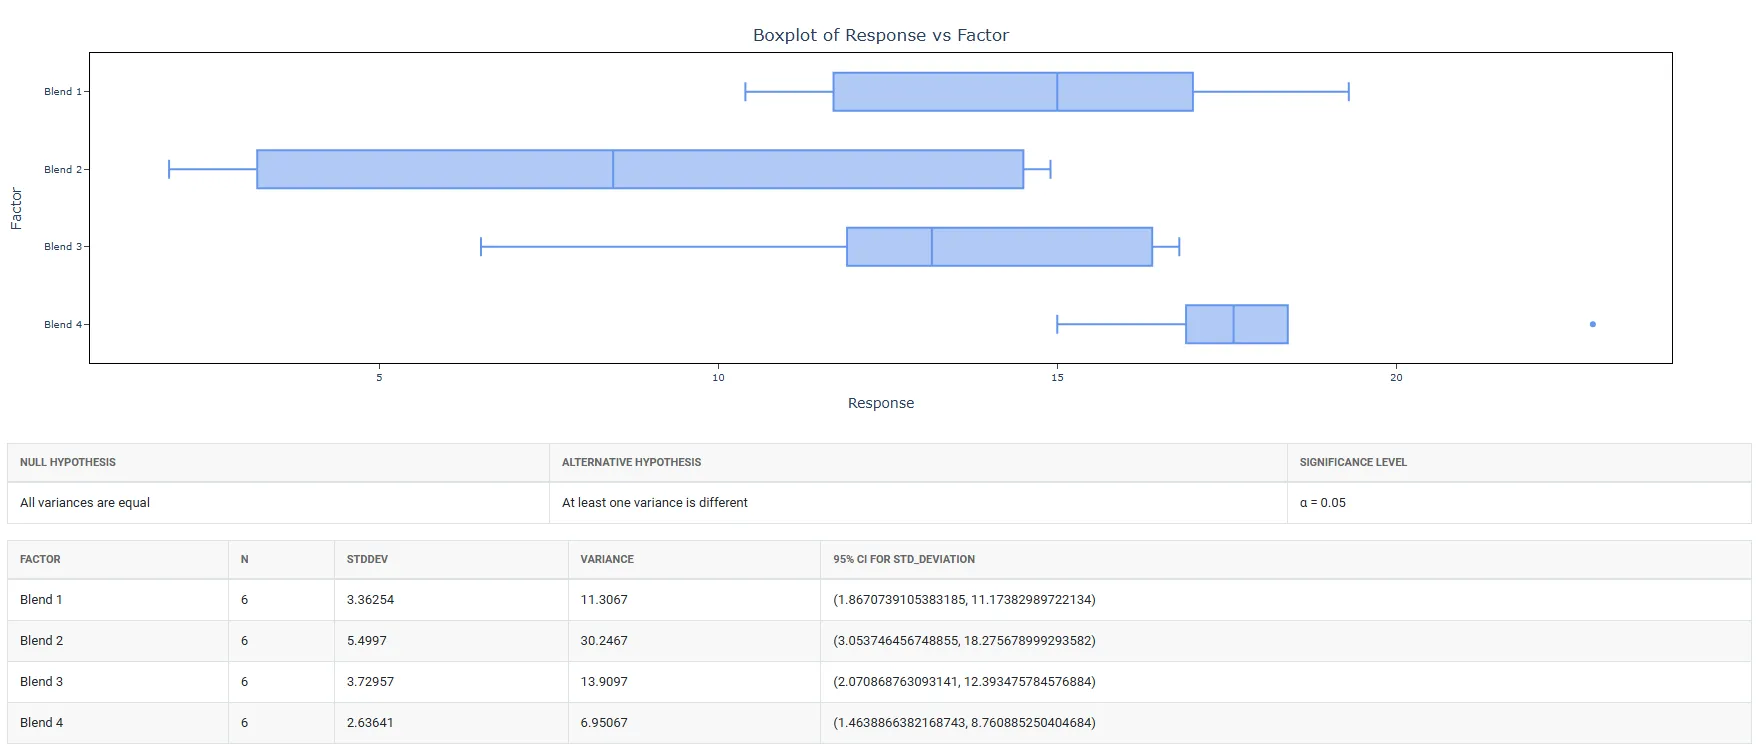
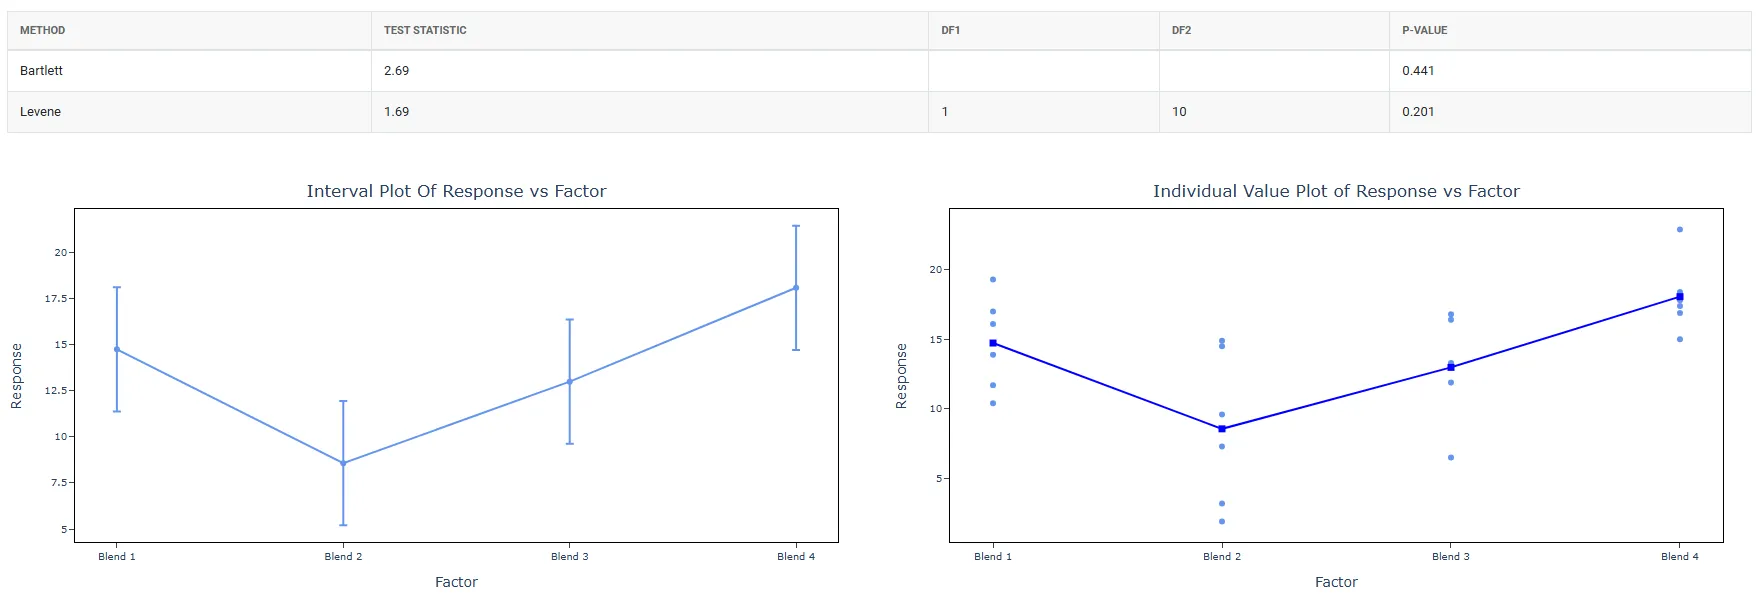
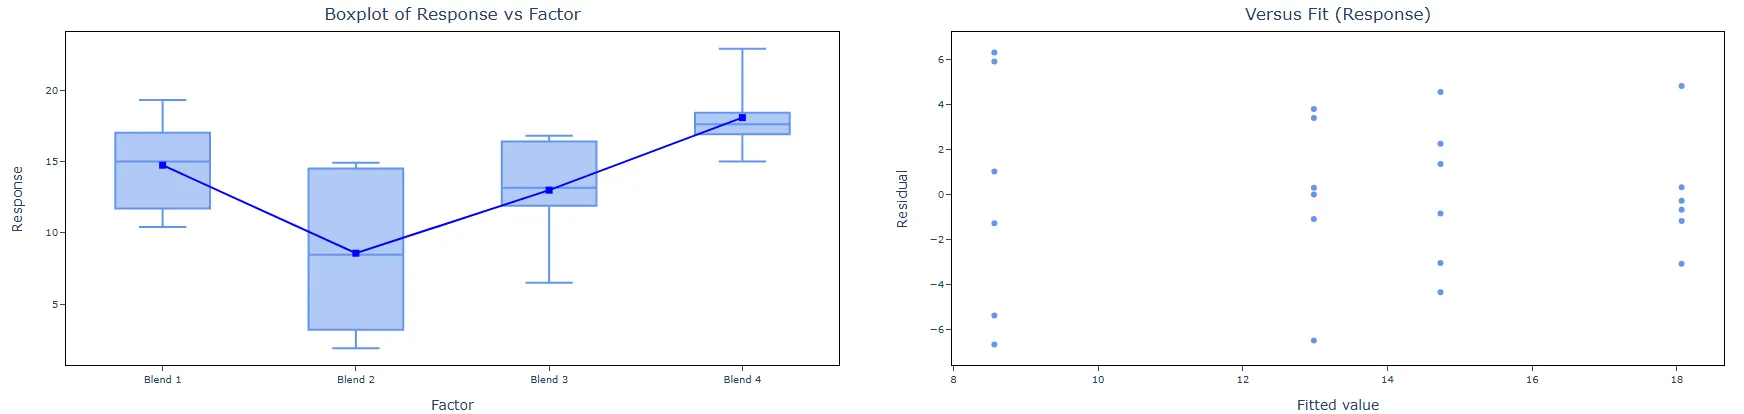
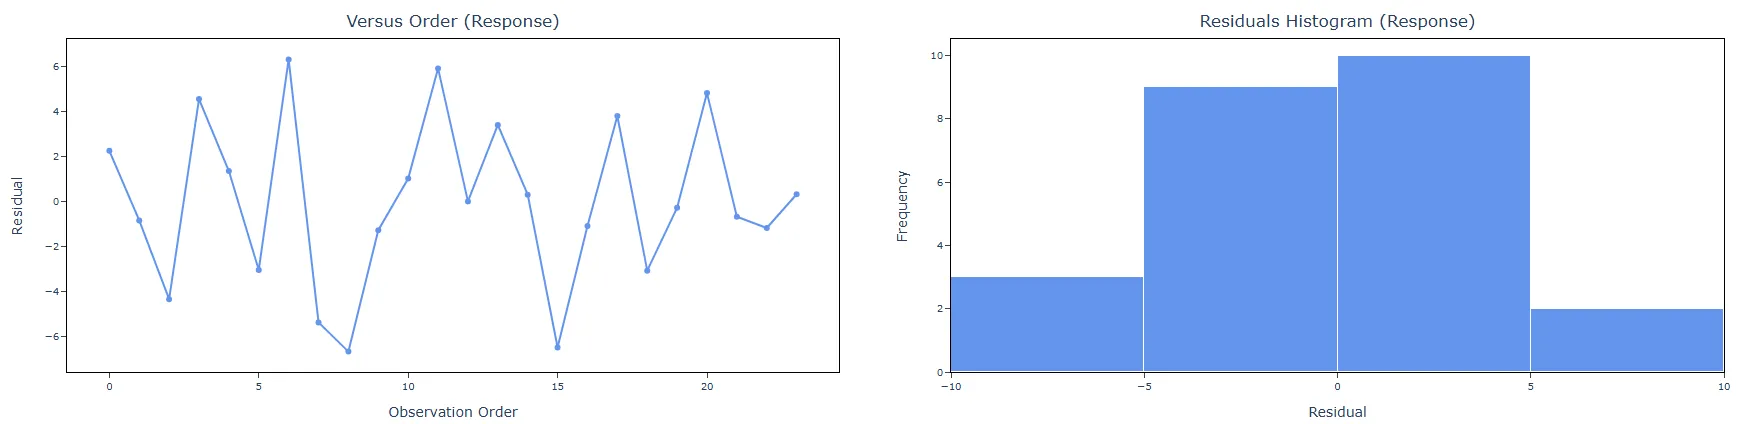
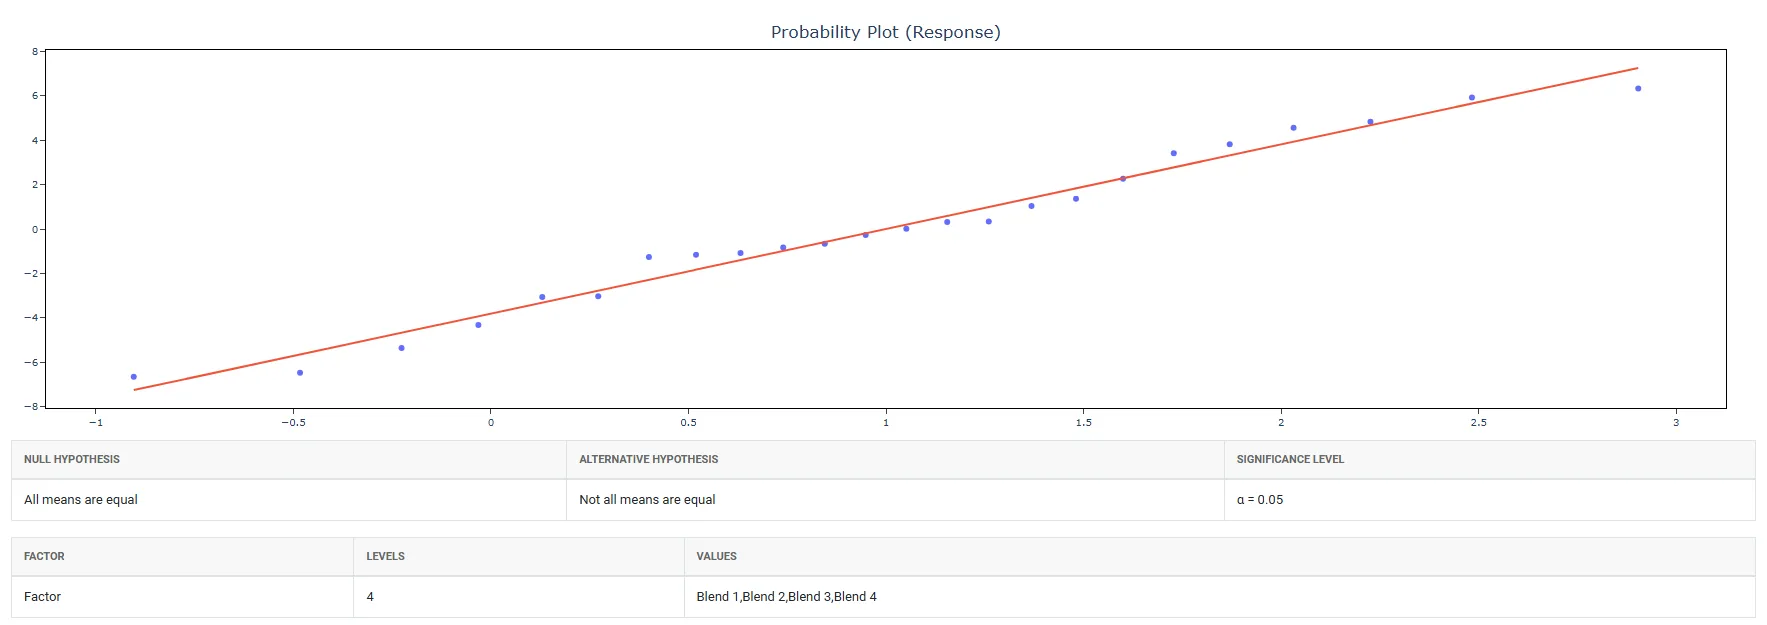
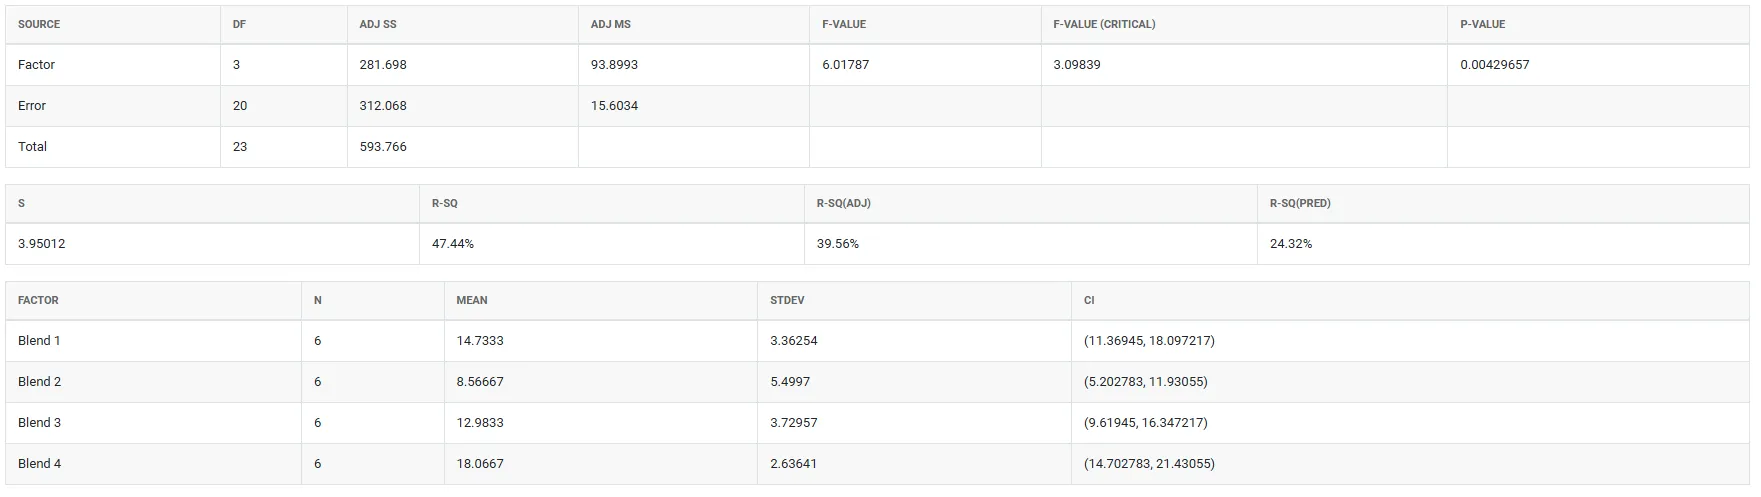
Zo voert u OECD uit
De handleiding is als volgt:
- Meld u aan bij Zometric Statistical Software op https://statsai.zometric.com/
- Kies op de startpagina Statistical Tool> OECD>OECD.
- Werk vervolgens de gegevens handmatig bij, of kopieer (Ctrl+C) de gegevens volledig uit een Excel-blad en plak (Ctrl+V) ze, of gebruik de optie Load Example, waarmee de voorbeeldgegevens worden geladen.
- Vul vervolgens de vereiste opties in.
- Klik ten slotte onderaan de pagina op Calculate en u krijgt de gewenste resultaten.
Op het dashboard van OECD is het venster in twee delen verdeeld.
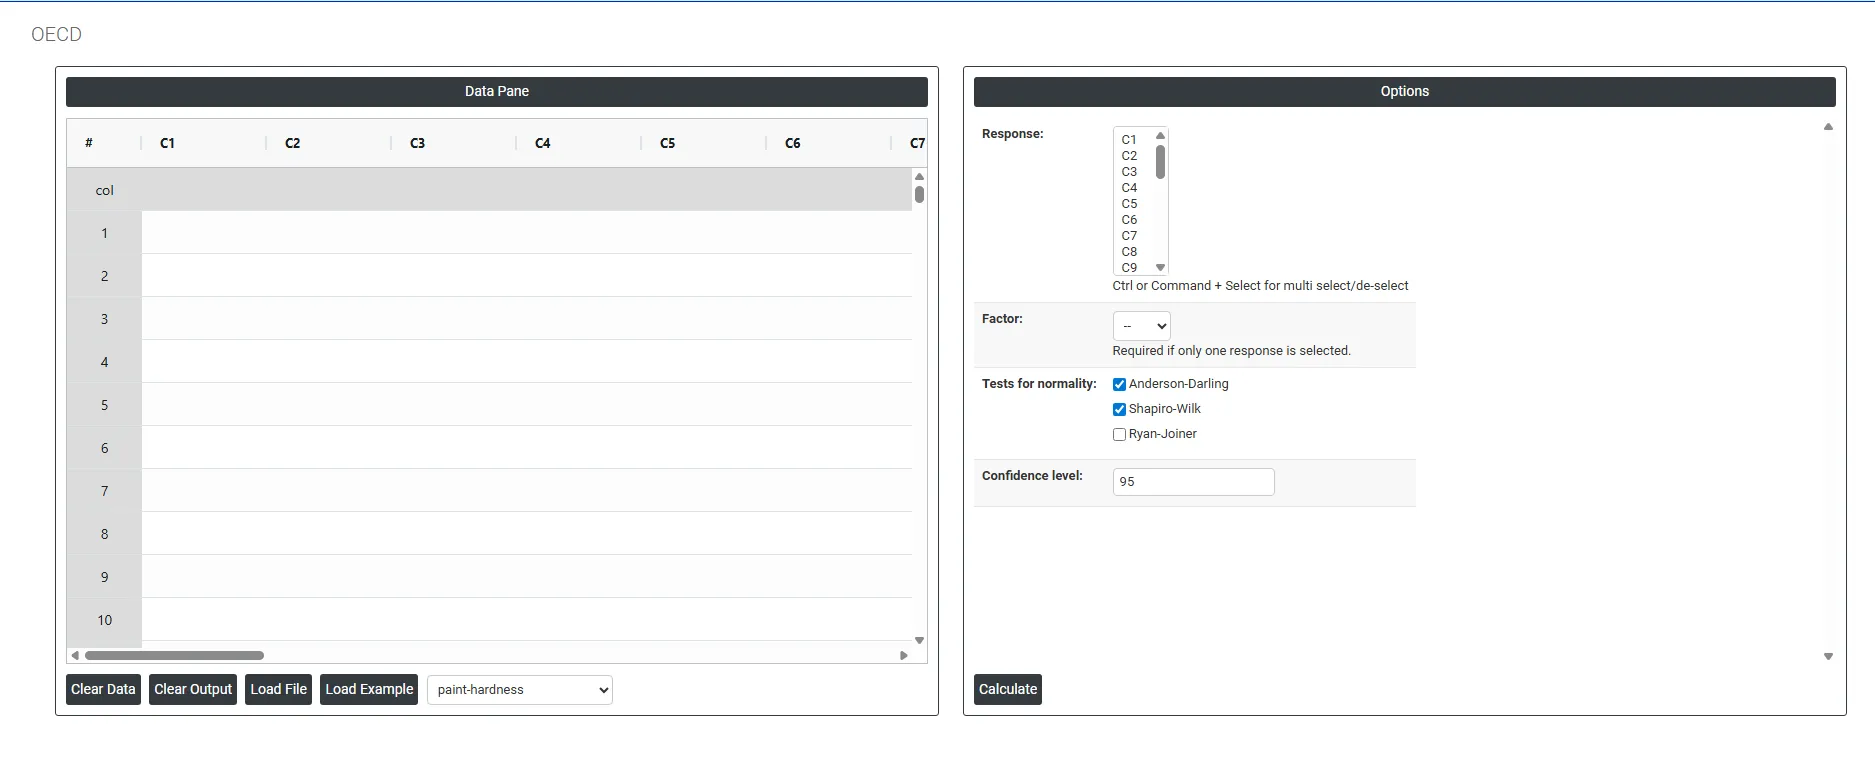
Links bevindt zich het Data Pane. In het Data Pane vormt elke rij één subgroep. Gegevens kunnen handmatig worden ingevoerd, of u kunt de gegevens volledig kopiëren (Ctrl+C) uit een Excel-blad en hier plakken (Ctrl+V).
Load example: Er worden voorbeeldgegevens geladen.
Load File: Hiermee laadt u Excel-gegevens rechtstreeks.
Rechts staan veel opties, als volgt:
- Response: Selecteer de kolom of kolommen met de uitkomstmetingen die u wilt analyseren — zoals lichaamsgewicht, enzymactiviteit, tumorincidentie, hematologische waarden of een ander eindpunt dat in de studie over groepen heen is vastgelegd. Gebruik Ctrl of Command + klik om meerdere responskolommen tegelijk te selecteren.
Het aantal geselecteerde responskolommen bepaalt rechtstreeks of de optie Factor vereist is:
Selectie
Hoe de tool zich gedraagt
Meerdere responsen geselecteerd
Elke geselecteerde kolom vertegenwoordigt een afzonderlijke groep. De tool gebruikt de kolommen zelf om de groepen te definiëren — er is geen extra Factor-kolom nodig. De metingen in elke kolom worden rechtstreeks met elkaar vergeleken.
Eén respons geselecteerd
Alle metingen staan gestapeld in één kolom en er moet een aparte Factor-kolom worden geselecteerd om aan te geven bij welke groep elke meting hoort. Zonder de Factor-kolom kan de tool niet bepalen welke waarnemingen bij welke groep horen.
⚠ Belangrijk: Wanneer één respons is geselecteerd, wordt het veld Factor verplicht. De tool vraagt u een Factor-kolom te selecteren voordat de analyse kan doorgaan.
- Factor: Selecteer de kolom die het groepslidmaatschap van elke waarneming aangeeft. Deze kolom bevat categorische labels of codes die aangeven bij welke experimentele groep elke gegevensrij hoort — bijvoorbeeld Control, Low Dose, Mid Dose, High Dose of Group 1, Group 2, Group 3. De factorkolom vertelt de tool hoe de enkele responskolom in afzonderlijke groepen voor vergelijking moet worden gesplitst. Zonder correcte opgave van de factor zouden alle metingen als behorend tot dezelfde groep worden behandeld en zou geen zinvolle vergelijking mogelijk zijn. Dit veld is alleen vereist wanneer precies één responskolom is geselecteerd. Wanneer meerdere responskolommen zijn geselecteerd, vertegenwoordigt elke kolom een groep en is geen Factor nodig. Het veld is grijs of wordt genegeerd wanneer meerdere responsen zijn geselecteerd
- Tests for Normality: Bepaalt welke statistische toets of toetsen in stap 2 van de beslisboom worden gebruikt om te beoordelen of de responsgegevens een normale verdeling volgen. De uitkomst van deze toets bepaalt of voor de hele analyse het parametrische of het niet-parametrische analysepad wordt gevolgd. Er zijn drie toetsen beschikbaar:
- Anderson-Darling : Een krachtige omnibus-normaliteitstoets die bijzondere nadruk legt op de staarten van de verdeling — de extreem hoge en lage waarden. Hierdoor is ze vooral gevoelig voor afwijkingen van normaliteit in de staarten, die in toxicologische en milieugegevens vaak de praktisch belangrijkste gebieden zijn. De Anderson-Darling-toets wordt aanbevolen voor algemeen gebruik bij een breed scala aan steekproefomvangen en is bijzonder effectief wanneer wordt verwacht dat het staartgedrag afwijkt van de normale verdeling.
- Shapiro-Wilk: Algemeen beschouwd als de krachtigste en meest betrouwbare normaliteitstoets voor kleine steekproefomvangen — doorgaans n < 50 — wat de meest voorkomende situatie is in studies volgens OECD-richtlijnen, waar de groepsgroottes vaak 5 tot 20 dieren bedragen. De Shapiro-Wilk-toets is de primaire normaliteitstoets waarnaar in de statistische OECD-richtlijnen wordt verwezen en is de standaardkeuze in farmaceutische en toxicologische statistiek. Het wordt sterk aanbevolen deze toets in analyses van regelgevende studies altijd actief te houden.
- Ryan-Joiner: Een op correlatie gebaseerde normaliteitstoets die beoordeelt hoe nauw de gegevens het patroon volgen dat van een normale verdeling wordt verwacht, door de correlatie te meten tussen de waargenomen gegevens en de theoretische normale kwantielen. Ze is conceptueel vergelijkbaar met de Shapiro-Wilk-toets maar gebruikt een andere rekenmethode. Minder vaak vereist in regelgevend werk, maar kan worden geactiveerd wanneer de beoordelende instantie specifiek om een op correlatie gebaseerde normaliteitsbeoordeling vraagt of daaraan de voorkeur geeft.
- Wanneer meerdere normaliteitstoetsen zijn geselecteerd, voert de tool alle aangevinkte toetsen uit en rapporteert alle resultaten. De algehele normaliteitsbeslissing is gebaseerd op de meest conservatieve uitkomst — als een geselecteerde toets niet-normaliteit aangeeft (p < α), worden de gegevens als niet-normaal behandeld en wordt het niet-parametrische pad gevolgd
Confidence Level (Default: 95): Stelt de significantiedrempel in die consistent wordt gebruikt voor elke hypothesetoets in de hele beslisboom — inclusief de normaliteitstoets, de toets op homogeniteit van varianties en de uiteindelijke groepsvergelijkingstoets. De ingevoerde waarde vertegenwoordigt het betrouwbaarheidspercentage en het bijbehorende alfaniveau (α) dat voor alle beslissingen wordt gebruikt, wordt berekend als (100 − Confidence Level) ÷ 100.
Betrouwbaarheidsniveau
Alfaniveau en wanneer te gebruiken
95 (standaard)
Alpha = 0.05. Het standaard betrouwbaarheidsniveau voor de meeste wetenschappelijke en regelgevende OECD-studies. Er is 5% kans op een fout-positieve conclusie. Dit is het niveau dat het vaakst wordt vereist door OECD-richtlijnen en regelgevende instanties wereldwijd.
99
Alpha = 0.01. Conservatievere toetsing — er is sterker bewijs nodig voordat een significant resultaat wordt verklaard. Vermindert fout-positieven maar kan kleinere werkelijke effecten missen. Gebruik dit wanneer de gevolgen van een fout-positief bijzonder ernstig zijn.
90
Alpha = 0.10. Gevoeligere toetsing — detecteert kleinere verschillen maar vergroot het risico op fout-positieve conclusies. Alleen geschikt voor verkennende of pilotstudies waarin het missen van een echt effect de grotere zorg is.
Veelgestelde vragen
Wat is de OECD-beslisboom voor statistische toetsen?
De OECD Statistical Decision Tree-tool is een begeleid analysesysteem dat de juiste statistische toets voor experimentele gegevens kiest en toepast. Ze volgt het OECD-beslispad en beoordeelt in elke fase gegevenstype, normaliteit, homogeniteit van varianties en aantal groepen, zodat conclusies reproduceerbaar en verdedigbaar zijn. Ze wordt gebruikt in toxicologie, milieukunde, farmaceutisch onderzoek en regelgevende indieningen.
Welke toetsen past de OECD-beslisboom toe op normale gegevens?
Voor twee groepen controleert een F-toets de variantie: gelijke varianties leiden tot de t-toets van Student en ongelijke varianties tot de methode van Satterthwaite (t-toets van Welch). Voor drie of meer groepen controleert de toets van Bartlett, Levene of Brown-Forsythe de variantie; bij gelijke varianties wordt ANOVA toegepast, gevolgd door de toets van Dunnett tegen de controlegroep als ANOVA significant is.
Wat gebeurt er in de OECD-beslisboom wanneer gegevens niet normaal zijn?
Als normaliteit wordt verworpen, wordt een transformatie zoals log of wortel geprobeerd en wordt normaliteit opnieuw gecontroleerd. Als de getransformeerde gegevens nog steeds niet-normaal zijn, wordt het niet-parametrische pad gevolgd: Kruskal-Wallis met de post-hoctoets van Dunn voor drie of meer groepen, de Mann-Whitney U-toets voor twee groepen en de chikwadraattoets voor categorische gegevens of indices.
Wanneer gebruikt u de OECD-beslisboom niet?
Gebruik hem niet voor gepaarde waarnemingen, die een gepaarde t-toets of Wilcoxon-rangtekentoets vereisen, voor regressie of dosis-responsmodellering, voor tijdreeksen of longitudinale gegevens, of voor equivalentie- en niet-inferioriteitstoetsing. Zonder regelgevende OECD-context is het rechtstreeks gebruiken van de meest geschikte specifieke toets mogelijk eenvoudiger.