
1-Sample Poisson Rate Test (eénsteekproef-toets voor Poisson-frequentie)
De 1-Sample Poisson Rate Test schat een gebeurtenisfrequentie per blootstellingseenheid en vergelijkt die met een veronderstelde frequentie. Gebruik hem voor aantallen onafhankelijke gebeurtenissen in een vaste blootstelling, niet voor goed/afkeur-gegevens. De gegevens kunnen een kolom met aantallen zijn of een steekproefomvang en een totaal. Hij biedt de exacte methode of de normale benadering en geeft de steekproeffrequentie, het betrouwbaarheidsinterval en een p-waarde.
Laatst beoordeeld
Belangrijkste conclusie
De 1-Sample Poisson Rate Test schat met een betrouwbaarheidsinterval de frequentie waarmee gebeurtenissen optreden, zoals defecten per paneel of storingen per maand, en toetst of die afwijkt van een streef- of historische frequentie.
Op deze pagina
Doel
De 1-Sample Poisson Rate Test schat de frequentie waarmee gebeurtenissen optreden, zoals defecten per paneel, storingen per maand of gesprekken per uur, en vergelijkt die met een streef- of historische frequentie. Hij geeft de frequentie met een betrouwbaarheidsinterval en, indien gewenst, een toets of de frequentie afwijkt van, of hoger of lager is dan de veronderstelde waarde. Gebruik hem voor aantallen gebeurtenissen in een vaste hoeveelheid blootstelling (eenheden, oppervlakte, tijd) waarbij elke gebeurtenis onafhankelijk is, en niet voor goed/afkeur-resultaten, waarvoor de eénsteekproef-proportietoets nodig is.
Belangrijkste mogelijkheden
- Gegevens als kolom met aantallen (één aantal per eenheid) of als samenvatting: steekproefomvang en totaal aantal voorvallen.
- Exacte methode (exacte Poisson-toets en exact betrouwbaarheidsinterval) of normale benadering (z-toets).
- Tweezijdige of eenzijdige alternatieven, met een bijpassend tweezijdig interval of eenzijdige grens.
- Frequentie per eenheid van elke waarnemingslengte, bijv. per paneel, per 100 m² of per ploegendienst.
- Alleen een betrouwbaarheidsinterval, zonder toets, wanneer Perform hypothesis test is uitgevinkt.
Statistische methoden
Bij N eenheden, elk waargenomen over een lengte t (Length of observation, standaard 1), is de totale blootstelling T = N·t. Als in totaal X gebeurtenissen worden geteld, is de steekproeffrequentie λ̂ = X / T. Onder de nulhypothese volgt het aantal X een Poisson-verdeling met gemiddelde μ₀ = λ₀·T, waarbij λ₀ de veronderstelde frequentie is.
Exacte methode: voor Rate > hypothesized rate is de p-waarde P(X ≥ x | μ₀), voor Rate < hypothesized rate is die P(X ≤ x | μ₀), en bij de tweezijdige toets telt de p-waarde de kans in de tegenovergestelde staart erbij op voorbij het aantal dat volgens de likelihood-ratioregel even onwaarschijnlijk is. Het betrouwbaarheidsinterval is het exacte (Garwood-)interval uit de chikwadraatverdeling: onder = χ²(α/2; 2x) / (2T), boven = χ²(1 − α/2; 2x + 2) / (2T), waarbij α / 2 voor een eenzijdige grens door α wordt vervangen.
Normale benadering: z = (λ̂ − λ₀) / √(λ₀ / T), met de p-waarde uit de standaardnormale verdeling, en het interval λ̂ ± z·√(λ̂ / T), afgekapt bij nul. Ze ligt dicht bij de exacte methode wanneer het verwachte aantal groot is. Beide methoden veronderstellen dat gebeurtenissen onafhankelijk optreden met een constante frequentie, zodat de variantie van de aantallen gelijk is aan hun gemiddelde; als de aantallen veel meer variëren dan het gemiddelde (clusters van defecten), is de p-waarde te klein.
Invoervelden en opties
Veld | Beschrijving |
Data | Summarized data (standaard) of Counts in a column. |
Sample | Bij Counts in a column: de kolom met aantallen, één per eenheid. Aantallen moeten hele getallen van 0 of hoger zijn; lege cellen worden genegeerd. |
Sample size / Total occurrences | Bij Summarized data: het aantal eenheden en het totale aantal getelde gebeurtenissen. |
Perform hypothesis test | Standaard aangevinkt. Vink uit om alleen de frequentie en het betrouwbaarheidsinterval te krijgen. |
Hypothesized rate | Vereist voor de toets. De streef- of historische frequentie per waarnemingslengte; groter dan 0. |
Confidence level | Standaard 95; 75 tot 100. |
Alternative hypothesis | Rate ≠ hypothesized rate (standaard), Rate < hypothesized rate of Rate > hypothesized rate. |
Method | Exact (standaard) of Normal approximation. |
Length of observation | Standaard 1. De hoeveelheid blootstelling voor elke eenheid, in de eenheden waarin de frequentie is uitgedrukt. |
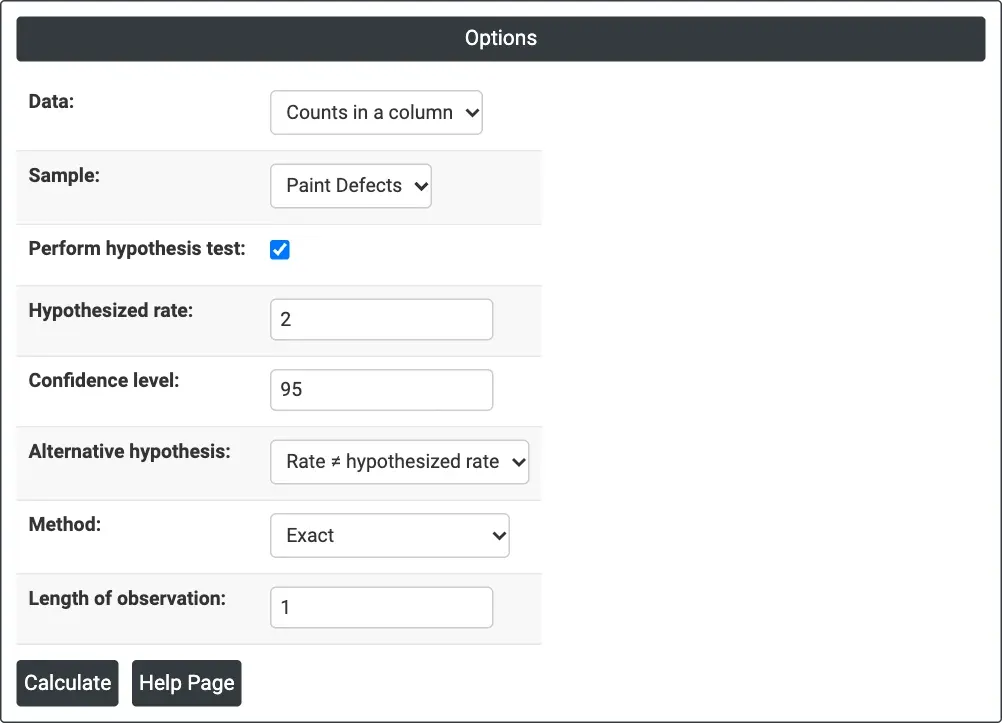
Figuur 1 — Opties voor het voorbeeld: verfdefecten geteld op elk paneel, veronderstelde frequentie 2, tweezijdig, exacte methode.
Beschrijving van de uitvoer
- Descriptive Statistics — N, Total Occurrences, Sample Rate en het betrouwbaarheidsinterval voor λ (of een onder- of bovengrens bij een eenzijdige toets), met opmerkingen die de kolom, de methode en elke andere waarnemingslengte dan 1 vermelden.
- Test — de nul- en alternatieve hypothese, en de P-Value (met de Z-Value voor de normale benadering).
- PDF-export via Download.
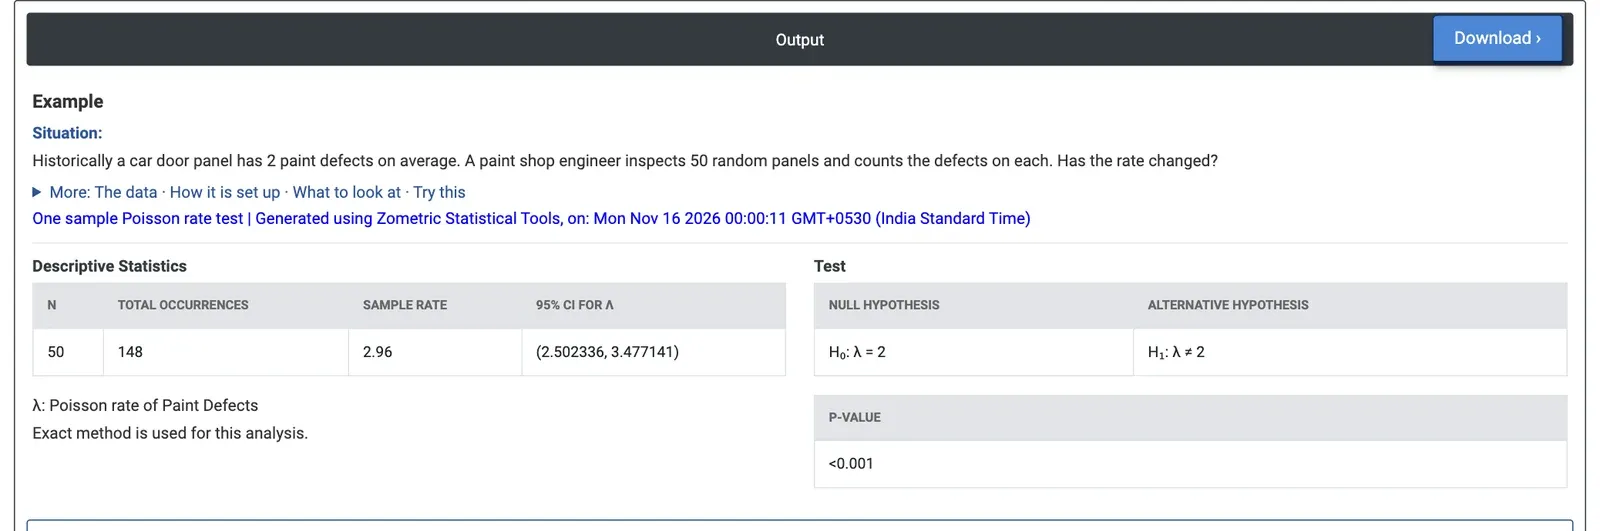
Figuur 2 — 148 defecten op 50 panelen: een frequentie van 2.96 per paneel, 95%-BI 2.502 tot 3.477, p < 0.001 ten opzichte van de historische frequentie van 2.
Uitgewerkt voorbeeld
Historisch gezien heeft een autodeurpaneel gemiddeld 2 verfdefecten. Een ingenieur in de spuiterij inspecteert 50 willekeurige panelen en telt de defecten op elk paneel. Is de frequentie veranderd? Data = Counts in a column, Sample = Paint Defects, Hypothesized rate = 2, Confidence level = 95, Alternative hypothesis = Rate ≠ hypothesized rate, Method = Exact, Length of observation = 1.
De 50 panelen hebben in totaal 148 defecten, een steekproeffrequentie van 2.96 defecten per paneel. Het 95%-betrouwbaarheidsinterval voor λ is 2.502 tot 3.477: het hele interval ligt boven 2. De exacte p-waarde is kleiner dan 0.001, dus de defectfrequentie is veranderd; ze is ongeveer anderhalf keer zo hoog als eerder. De aantallen lijken Poisson-verdeeld: hun variantie (2.37) ligt dicht bij hun gemiddelde, dus er is geen teken van clusters van defecten die de toets te optimistisch zouden maken.
De normale benadering geeft dezelfde conclusie (z = 4.8, p < 0.001, interval 2.483 tot 3.437). Als de vraag alleen is of de frequentie is gestegen, geeft Rate > hypothesized rate een 95%-ondergrens van 2.571 defecten per paneel: de defectfrequentie ligt minstens ongeveer 29% boven het historische niveau, en de ingenieur moet zoeken naar wat er in het verfproces is veranderd. Hetzelfde resultaat krijgt u met Data = Summarized data, Sample size = 50 en Total occurrences = 148.
Veelgestelde vragen
Wat is een 1-sample Poisson rate test?
Een 1-sample Poisson rate test schat de frequentie waarmee gebeurtenissen optreden, zoals defecten per paneel, storingen per maand of gesprekken per uur, en vergelijkt die met een streef- of historische frequentie. Hij geeft de frequentie met een betrouwbaarheidsinterval en kan toetsen of de frequentie afwijkt van, of hoger of lager is dan de veronderstelde waarde.
Wanneer gebruikt u een Poisson rate test in plaats van een 1 proportion test?
Gebruik de Poisson rate test voor aantallen gebeurtenissen in een vaste hoeveelheid blootstelling, zoals eenheden, oppervlakte of tijd, waarbij elke gebeurtenis onafhankelijk is en één eenheid meerdere gebeurtenissen kan hebben. Gebruik voor goed/afkeur-resultaten, waarbij elk item gewoon conform of niet conform is, in plaats daarvan de eénsteekproef-proportietoets.
Wat zijn de aannames van de Poisson rate test?
Zowel de exacte methode als de normale benadering veronderstellen dat gebeurtenissen onafhankelijk optreden met een constante frequentie, zodat de variantie van de aantallen gelijk is aan hun gemiddelde. Als de aantallen veel meer variëren dan het gemiddelde, bijvoorbeeld wanneer defecten in clusters optreden, is de p-waarde te klein.
Wat is het verschil tussen de exacte methode en de normale benadering?
De exacte methode gebruikt de Poisson-verdeling voor de p-waarde en het exacte Garwood-interval uit de chikwadraatverdeling. De normale benadering gebruikt een z-toets en het interval frequentie plus of min z maal de wortel van de frequentie gedeeld door de blootstelling. Ze ligt dicht bij de exacte methode wanneer het verwachte aantal groot is.