
Poisson-regressie
Poisson-regressie modelleert aantallen gebeurtenissen in een vaste hoeveelheid tijd, oppervlak of product tegen continue en categorische voorspellers. Gebruik ze in plaats van gewone regressie, omdat tellingen niet negatief kunnen zijn en hun spreiding met het gemiddelde toeneemt. De respons wordt verondersteld een Poisson-verdeling te volgen, met een log-, wortel- of identiteitslink. De uitvoer bevat coëfficiënten, deviantieanalyse, goodness-of-fit-toetsen en residuplots.
Laatst beoordeeld
Belangrijkste conclusie
Poisson-regressie is een gegeneraliseerd lineair model dat een telrespons, zoals defecten per ploegendienst of storingen per maand, relateert aan continue en categorische voorspellers, gefit met maximum likelihood.
Op deze pagina
Doel
Poisson-regressie relateert een telrespons, zoals defecten per ploegendienst, storingen per maand of gebreken per paneel, aan continue en categorische voorspellers. Gebruik ze in plaats van gewone regressie wanneer de respons een telling van gebeurtenissen in een vaste hoeveelheid tijd, oppervlak of product is: de tellingen kunnen niet negatief zijn en hun spreiding neemt toe met hun gemiddelde, waarmee de kleinste-kwadratenmethode geen rekening houdt.
Belangrijkste mogelijkheden
- Continue en categorische voorspellers, met interacties en kwadratische termen uit de termenlijst.
- Log- (standaard), wortel- of identiteitslink.
- Stapsgewijze selectie, voorwaartse selectie of achterwaartse eliminatie van termen, met termen die in elk model worden afgedwongen.
- Coëfficiënten met betrouwbaarheidsintervallen en VIF, regressievergelijkingen voor elk niveau van een categorische voorspeller, modeloverzicht en goodness-of-fit-toetsen.
- Deviantieanalyse met Wald- of likelihoodratiotoetsen (gecorrigeerd of sequentieel).
- Ongebruikelijke waarnemingen, residuplots, hoofdeffecten- en interactieplots, contour- en oppervlakteplots van gefitte tellingen.
- Voorspelling bij instellingen die u invoert en een responsoptimalisator.
Statistische methoden
De respons wordt verondersteld een Poisson-verdeling te volgen met gemiddelde μ dat via de link van de voorspellers afhangt: bij de loglink geldt ln μ = b₀ + b₁x₁ + … , dus elke coëfficiënt vermenigvuldigt de verwachte telling met exp(b) per eenheid van zijn voorspeller. Het model is een gegeneraliseerd lineair model dat met maximum likelihood wordt gefit (iteratief herwogen kleinste kwadraten). Categorische voorspellers gebruiken (1, 0)-codering tegen een referentieniveau, standaard het eerste niveau in sorteervolgorde. Rijen met een ontbrekende waarde worden weggelaten; een frequentiekolom herhaalt rijen en een gewichtenkolom geeft variantiegewichten.
De coëfficiëntentabel geeft Wald-z-waarden (Coef / SE Coef) en betrouwbaarheidsintervallen. De deviantieanalyse toetst elke term: standaard met een Wald-chikwadraat (z² voor een continue term, een gezamenlijke toets voor de dummykolommen van een categorische term); met de LR-toets via de verandering in deviantie wanneer de term uit het volledige model wordt weggelaten (gecorrigeerd, Type III) of in volgorde wordt toegevoegd (sequentieel, Type I). Deviantie-R-kwadraat = 1 − residuele deviantie / nuldeviantie.
Goodness-of-fit-toetsen vergelijken de deviantie en het Pearson-chikwadraat met een chikwadraatverdeling op de vrijheidsgraden van de fout. Een kleine p-waarde, of een Mean (deviantie / DF) die ruim boven 1 ligt, betekent dat de tellingen meer variëren dan een Poisson-model toestaat (overdispersie), en de p-waarden voor de termen zijn dan te klein. Waarnemingen met een gestandaardiseerd residu buiten ±2 worden gemarkeerd met R en die met een leverage boven 3p/n met X.
Invoervelden en opties
Veld | Beschrijving |
Response | Kolom met tellingen. Vereist. |
Continuous Predictors / Categorical Predictor | Numerieke en tekst- (of gecodeerde) voorspellerkolommen; minstens één. Ctrl of Command + klik om er meerdere te selecteren. |
Model terms (optional) | Termenlijst: vink termen aan, of gebruik Add all, Interactions en Powers tot de volgorde die in Terms through order (2 of 3) is gekozen. Haal het vinkje bij In model weg om een lineaire term te verwijderen en zijn interacties te behouden. |
Reference level (optional) | Voor categorische voorspellers “Predictor Level”, door komma's gescheiden. Standaard: eerste niveau in sorteervolgorde. |
Stepwise method | None (standaard), Stepwise, Forward selection of Backward elimination; met Alpha to enter en Alpha to remove (0.15), hiërarchieregels, Terms in every model (E), Initial model terms (I) en Model selection details. |
Frequency (optional) / Weights (optional) | Kolommen met rijfrequenties en met gewichten. |
Link function | Log (standaard), Square root of Identity. |
Confidence level / Type of confidence interval | Standaard 95, Two-sided; of Lower bound of Upper bound. |
Fits and diagnostics for all observations | Toont fit en residu voor elke rij, niet alleen voor ongebruikelijke. |
Test for ANOVA table / Type of deviance (LR test only) | Wald test (standaard) of LR test; voor LR, Adjusted (Type III, standaard) of Sequential (Type I). |
Residuals for diagnostics/plots | Deviance (standaard) of Pearson. |
Histogram of residuals / Normal probability plot of residuals / Residuals versus fits / Residuals versus order / Four in one / Residuals versus the variables | Residuplots. |
Main effects plot / Interaction plot | Gefitte telling tegen elke voorspeller, waarbij de overige op hun gemiddelde of referentieniveau worden gehouden. |
Contour plot / Surface plot / Overlaid contour plot of fitted values | Vereist X1- en X2-asvariabelen; de overlaid contour plot vereist ook Response low en Response high. |
Prediction / Response Optimizer | Voeg een paneel toe om de gemiddelde telling (met SE en betrouwbaarheidsinterval) te voorspellen bij instellingen die u invoert, of om instellingen te zoeken die aan een tellingdoel voldoen. |
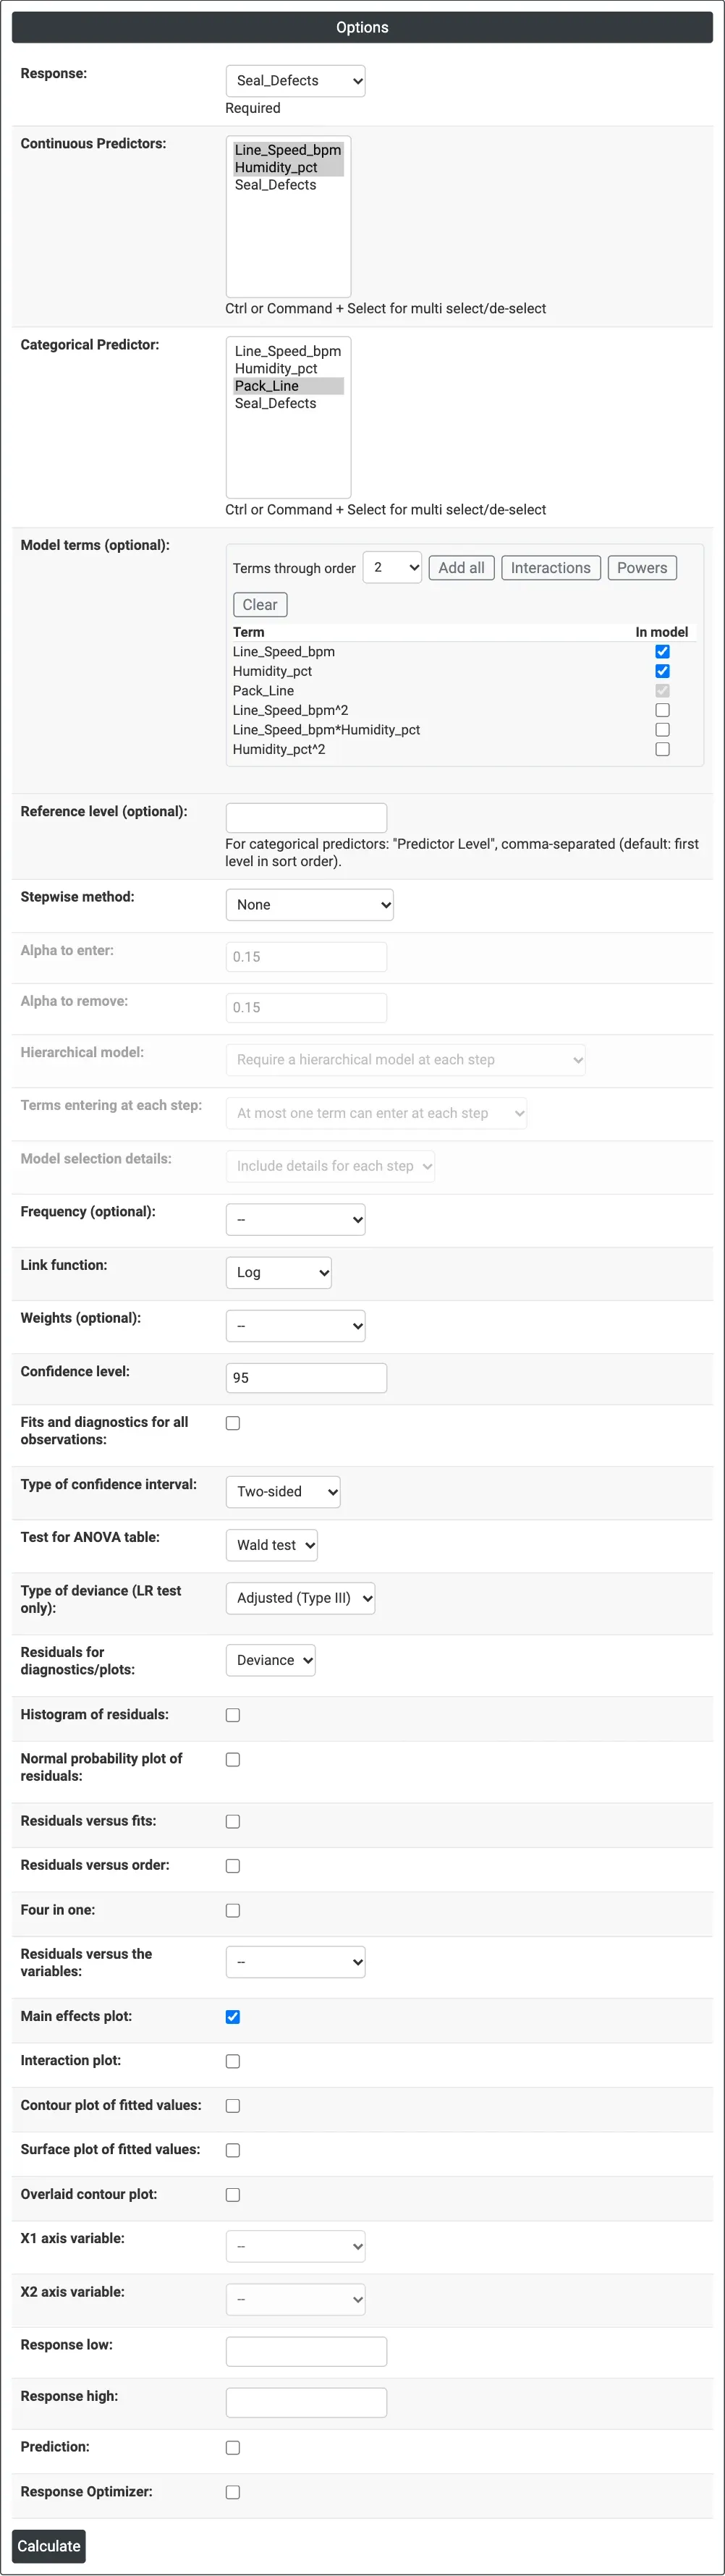
Figuur 1 — Opties voor het voorbeeld met zaklasnaden: Seal_Defects als respons, lijnsnelheid en vochtigheid als continue voorspellers, verpakkingslijn als categorische voorspeller, hoofdeffectenplot aangevinkt.
Beschrijving van de uitvoer
- Method — linkfunctie, categorische codering en gebruikte rijen.
- Response Information — N, gemiddelde, standaardafwijking, minimum en maximum van de tellingen.
- Coefficients — Coef, SE Coef, Z-Value, P-Value, betrouwbaarheidsgrenzen en VIF.
- Regression Equation — de lineaire voorspeller Y' (ln van de verwachte telling bij de loglink) voor elk niveau van de categorische voorspellers.
- Model Summary — deviantie-R-Sq, Adj R-Sq, AIC, AICc en BIC.
- Goodness-of-Fit Tests — deviantie- en Pearson-chikwadraattoetsen.
- Fits and Diagnostics for Unusual Observations.
- Analysis of Deviance — chikwadraat en p-waarde voor de regressie en elke term.
- Tabel met stapsgewijze selectie, residu-, factoriële, contour- en oppervlakteplots, voorspellings- en optimalisatiepanelen wanneer geselecteerd.
- PDF-export via Download.
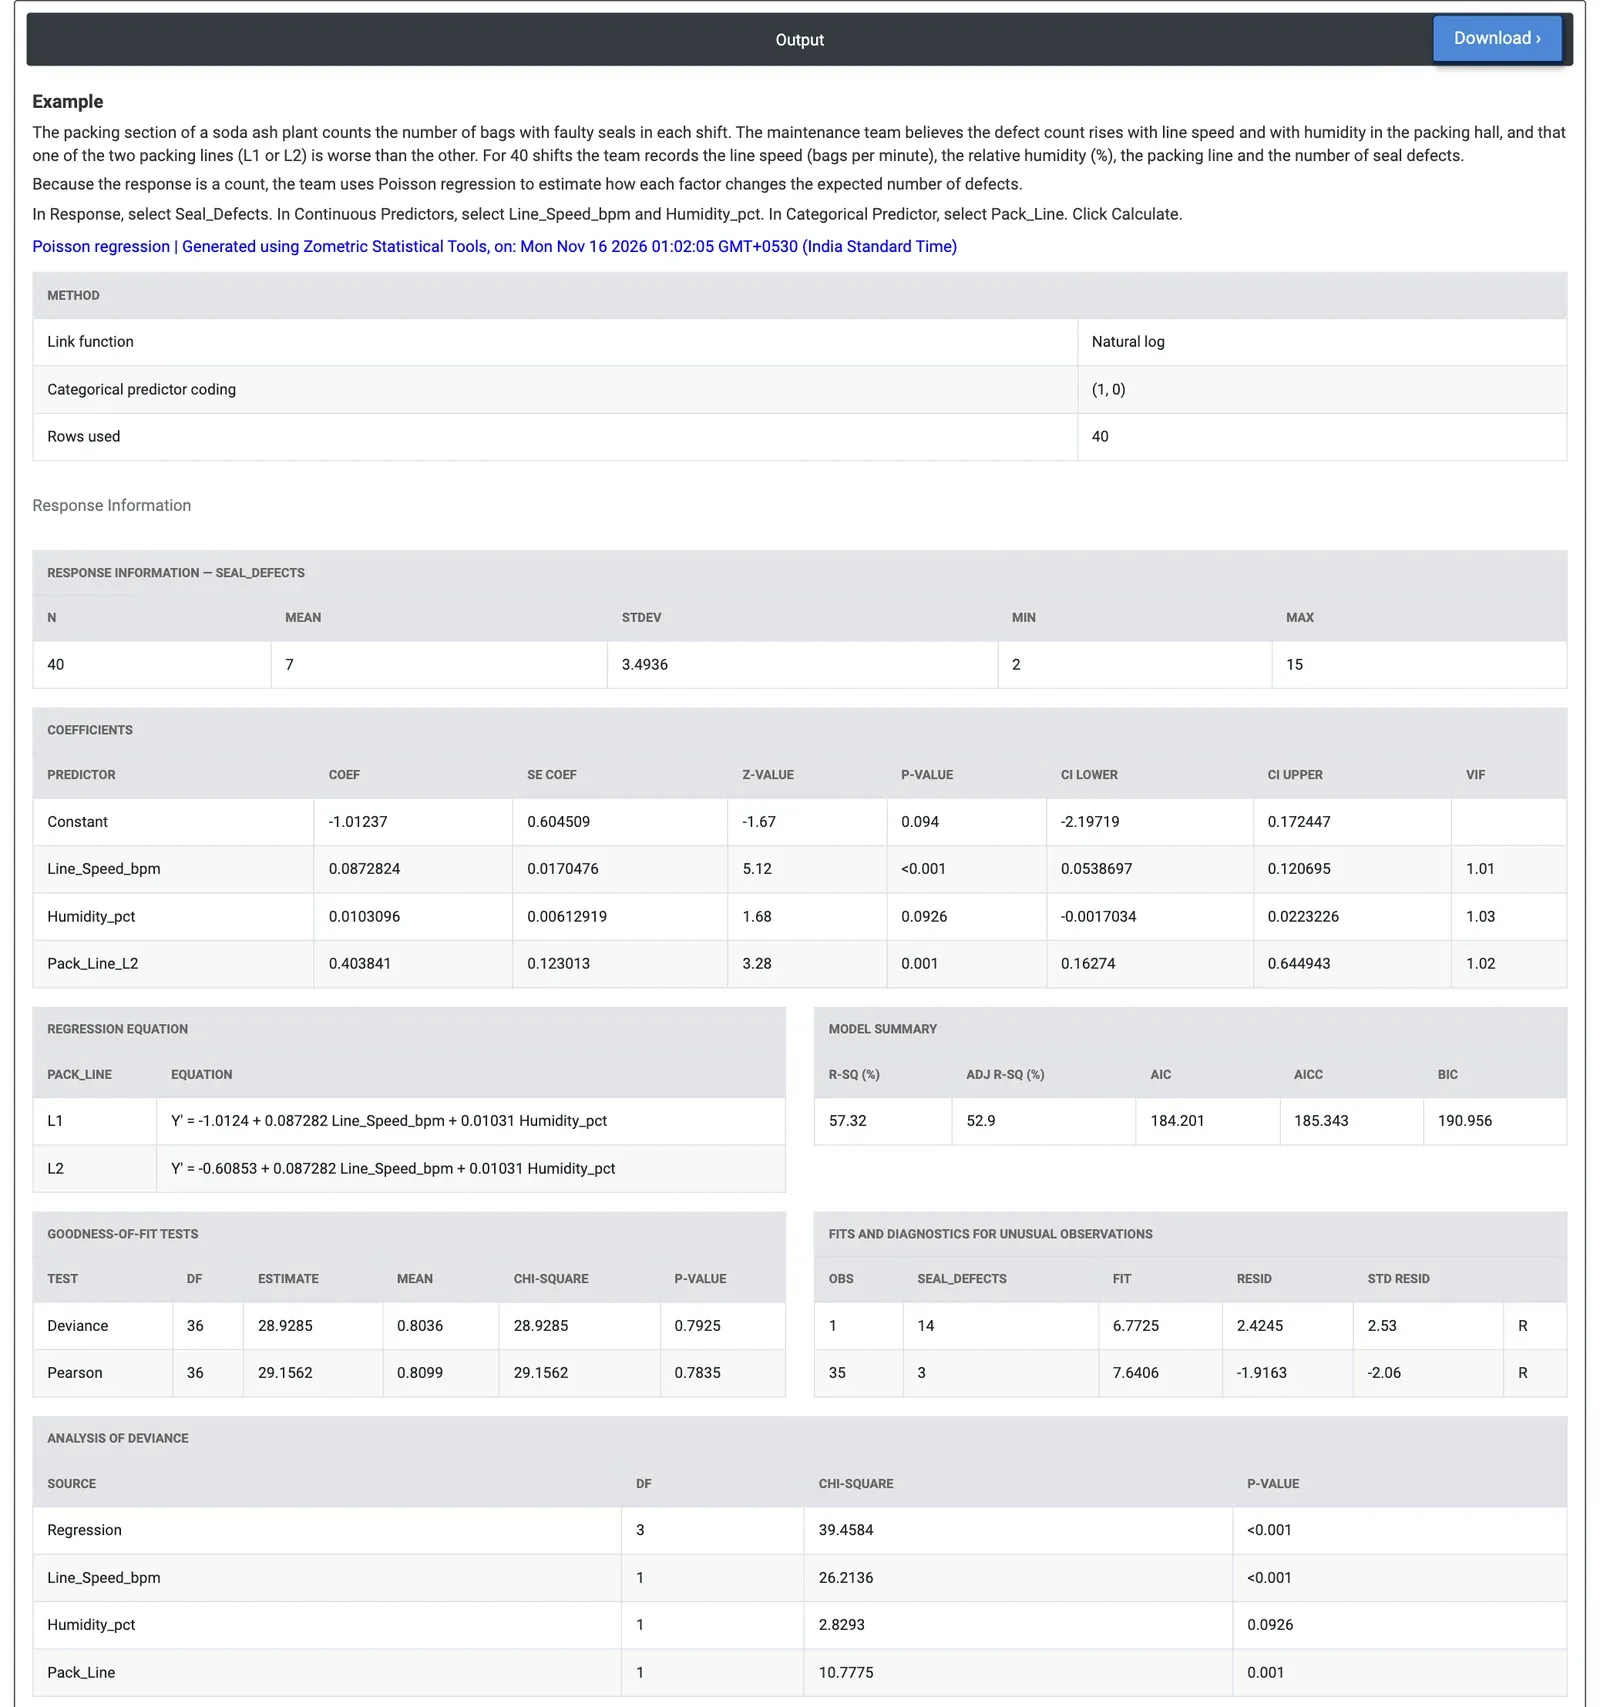
Figuur 2 — Poisson-regressie van zaldefecten per ploegendienst: lijnsnelheid (p < 0.001) en verpakkingslijn (p = 0.001) doen ertoe, vochtigheid niet op het 5%-niveau (p = 0.0926).
Uitgewerkt voorbeeld
De verpakkingsafdeling van een sodafabriek telt per ploegendienst de zakken met gebrekkige naden. Voor 40 ploegendiensten registreert het team de lijnsnelheid (zakken per minuut), de vochtigheid in de verpakkingshal (%), de verpakkingslijn (L1 of L2) en het aantal naaddefecten (2 tot 15, gemiddeld 7). Ze selecteren Seal_Defects als respons, lijnsnelheid en vochtigheid als continue voorspellers en Pack_Line als categorische voorspeller, en houden de loglink aan.
De lijnsnelheid heeft het sterkste effect (Wald-chikwadraat 26.21, p < 0.001): de coëfficiënt 0.0873 betekent dat elke extra zak per minuut de verwachte defecten vermenigvuldigt met exp(0.0873) = 1.09, en 5 zakken per minuut sneller met ongeveer 1.55. Lijn L2 heeft coëfficiënt 0.404 (p = 0.001), dus bij dezelfde snelheid en vochtigheid veroorzaakt ze ongeveer 1.50 keer zoveel naaddefecten als L1. Vochtigheid wijst dezelfde kant op (ongeveer 11% meer defecten per 10% RV), maar is niet significant op het 5%-niveau (p = 0.0926).
Het model past bij de tellingen: deviantie-chikwadraat 28.93 met 36 DF (p = 0.7925) en Pearson 29.16 (p = 0.7835), met Mean onder 1, dus er is geen teken van overdispersie. Twee ploegendiensten worden gemarkeerd: ploegendienst 1 met 14 defecten tegenover een fit van 6.8, en ploegendienst 35 met 3 tegenover 7.6. Het team kijkt eerst naar de afdichtbekken op L2 en naar het snelheidsinstelpunt, en blijft vochtigheidsgegevens verzamelen voordat het besluit over ontvochtiging.
Veelgestelde vragen
Wanneer gebruikt u Poisson-regressie in plaats van gewone regressie met kleinste kwadraten?
Gebruik Poisson-regressie wanneer de respons een telling van gebeurtenissen in een vaste hoeveelheid tijd, oppervlak of product is, zoals defecten per ploegendienst of storingen per maand. Tellingen kunnen niet negatief zijn en hun spreiding neemt toe met hun gemiddelde, waarmee regressie met kleinste kwadraten geen rekening houdt. Poisson-regressie lost dit op als gegeneraliseerd lineair model dat met maximum likelihood wordt gefit.
Hoe interpreteert u Poisson-regressiecoëfficiënten?
Met de standaard loglink is ln van de verwachte telling gelijk aan b0 + b1x1 + ..., dus elke coëfficiënt vermenigvuldigt de verwachte telling met exp(b) per eenheid toename van zijn voorspeller. Een coëfficiënt van 0.0873 voor de lijnsnelheid betekent bijvoorbeeld dat elke extra zak per minuut de verwachte defecten vermenigvuldigt met exp(0.0873) = 1.09. Categorische voorspellers worden vergeleken met een referentieniveau.
Hoe controleert u op overdispersie in Poisson-regressie?
De goodness-of-fit-toetsen vergelijken de deviantie en het Pearson-chikwadraat met een chikwadraatverdeling op de vrijheidsgraden van de fout. Een kleine p-waarde, of een Mean (deviantie gedeeld door DF) die ruim boven 1 ligt, betekent dat de tellingen meer variëren dan een Poisson-model toestaat. In dat geval zijn de p-waarden voor de modeltermen te klein en mogen ze niet worden vertrouwd.
Hoe worden ongebruikelijke waarnemingen gemarkeerd in Poisson-regressie?
Waarnemingen met een gestandaardiseerd residu buiten plus of min 2 worden gemarkeerd met R, en waarnemingen met een leverage boven 3p/n met X. Ze staan in de tabel Fits and Diagnostics for Unusual Observations, en residuplots zoals residuen tegen fits en een normale waarschijnlijkheidsplot van de residuen kunnen worden toegevoegd om ze verder te onderzoeken.