
Onderscheidend vermogen en steekproefomvang voor eenweg-ANOVA
Plant een eenweg-ANOVA die de gemiddelden van meerdere groepen vergelijkt. Voer het aantal niveaus, een gemeenschappelijke standaardafwijking en twee van de volgende drie in: steekproefomvang per niveau, maximaal verschil tussen gemiddelden en onderscheidend vermogen; de tool bepaalt de derde. Ze gaat uit van normale groepen met gelijke standaardafwijkingen en een gebalanceerde opzet en gebruikt de minst gunstige rangschikking van gemiddelden, dus de resultaten zijn conservatief.
Laatst beoordeeld
Belangrijkste conclusie
Berekent hoeveel eenheden elke groep nodig heeft om een gegeven maximaal verschil tussen drie of meer groepsgemiddelden te detecteren, het onderscheidend vermogen van een geplande opzet of het detecteerbare verschil.
Op deze pagina
Doel
Power and Sample Size for One-Way ANOVA plant een vergelijking van de gemiddelden van drie of meer groepen, zoals meerdere ovens, leveranciers, operators of receptuurvarianten. De grootte van het effect wordt ingevoerd als het maximale verschil tussen twee willekeurige groepsgemiddelden dat u wilt detecteren. Voer twee van de volgende drie in: steekproefomvang per niveau, maximaal verschil en onderscheidend vermogen; de tool bepaalt de derde: hoeveel eenheden elke groep nodig heeft, welk onderscheidend vermogen een geplande opzet geeft, of het grootste-tot-kleinste verschil dat een gegeven opzet kan detecteren. Gebruik ze vóór een eenweg-ANOVA.
Belangrijkste mogelijkheden
- Bepaalt steekproefomvang, onderscheidend vermogen of maximaal verschil: laat leeg wat u wilt bepalen.
- Meerdere waarden tegelijk, bijv. maximale verschillen “1.5 2” en vermogenswaarden “0.8 0.9”, geven één rij per combinatie.
- Elk aantal niveaus vanaf 2, met een gebalanceerde opzet (dezelfde steekproefomvang in elk niveau).
- Bij het bepalen van de steekproefomvang wordt het gehele getal per niveau gerapporteerd, met het werkelijke vermogen dat het geeft.
- Vermogenscurve van onderscheidend vermogen tegen steekproefomvang per niveau voor elk maximaal verschil, met de berekende punten gemarkeerd.
Statistische methoden
De berekening gaat uit van k onafhankelijke groepen uit normale populaties met een gemeenschappelijke standaardafwijking σ en n eenheden per niveau (N = n·k in totaal). Het significantieniveau is α = 1 − betrouwbaarheidsniveau / 100. Om het maximale verschil Δ om te zetten in een effectgrootte gebruikt de tool de rangschikking van gemiddelden die het minste onderscheidend vermogen voor dat Δ geeft, zoals Minitab: twee niveaus bij −Δ/2 en +Δ/2 en de andere k − 2 niveaus bij het algemeen gemiddelde. De effectgrootte is f = σₘ/σ, waarbij σₘ de standaardafwijking van die k gemiddelden is, dus σₘ² = Δ²/(2k).
Onderscheidend vermogen is de kans dat de F-toets van de ANOVA de hypothese van gelijke gemiddelden verwerpt. Het wordt berekend uit de niet-centrale F-verdeling met k − 1 en N − k vrijheidsgraden en niet-centraliteitsparameter λ = f²·N. Voor de steekproefomvang wordt het totaal N gevonden dat het gewenste vermogen geeft, gedeeld door k en per niveau naar boven afgerond, en het vermogen bij die omvang wordt gerapporteerd als werkelijk vermogen. Voor het maximale verschil wordt de effectgrootte gevonden die het gewenste vermogen bereikt en teruggerekend naar Δ.
Omdat dit de minst gunstige rangschikking is, is het antwoord conservatief: als de gemiddelden verder uit elkaar liggen, bijvoorbeeld twee niveaus bij elk uiterste, is het werkelijke vermogen hoger dan gerapporteerd en zouden minder eenheden volstaan (zie het uitgewerkte voorbeeld). Bij twee niveaus is er maar één rangschikking.
Invoervelden en opties
Veld | Beschrijving |
Sample sizes | Per niveau (gebalanceerde opzet). Gescheiden door spaties of komma's, bijv. “10 20 30”. Laat leeg om de steekproefomvang te bepalen. |
Maximum difference between means | Gescheiden door spaties of komma's, bijv. “1 2 3”. Het verschil tussen het grootste en het kleinste gemiddelde dat u wilt detecteren. Laat leeg om het verschil te bepalen. |
Power values | Gescheiden door spaties of komma's, bijv. “0.8 0.9”. Laat leeg om het onderscheidend vermogen te bepalen. |
Standard deviation | Vereist. Aangenomen of historische gemeenschappelijke standaardafwijking, gelijk voor elk niveau. |
Number of levels | Vereist, minstens 2. Aantal groepen dat wordt vergeleken. |
Confidence level | Standaard 95 (α = 0.05); 75 tot 100. |
Power curve | Standaard aangevinkt: tekent het onderscheidend vermogen tegen de steekproefomvang per niveau. |
Title | Titel die in de uitvoer en de vermogenscurve wordt getoond. |
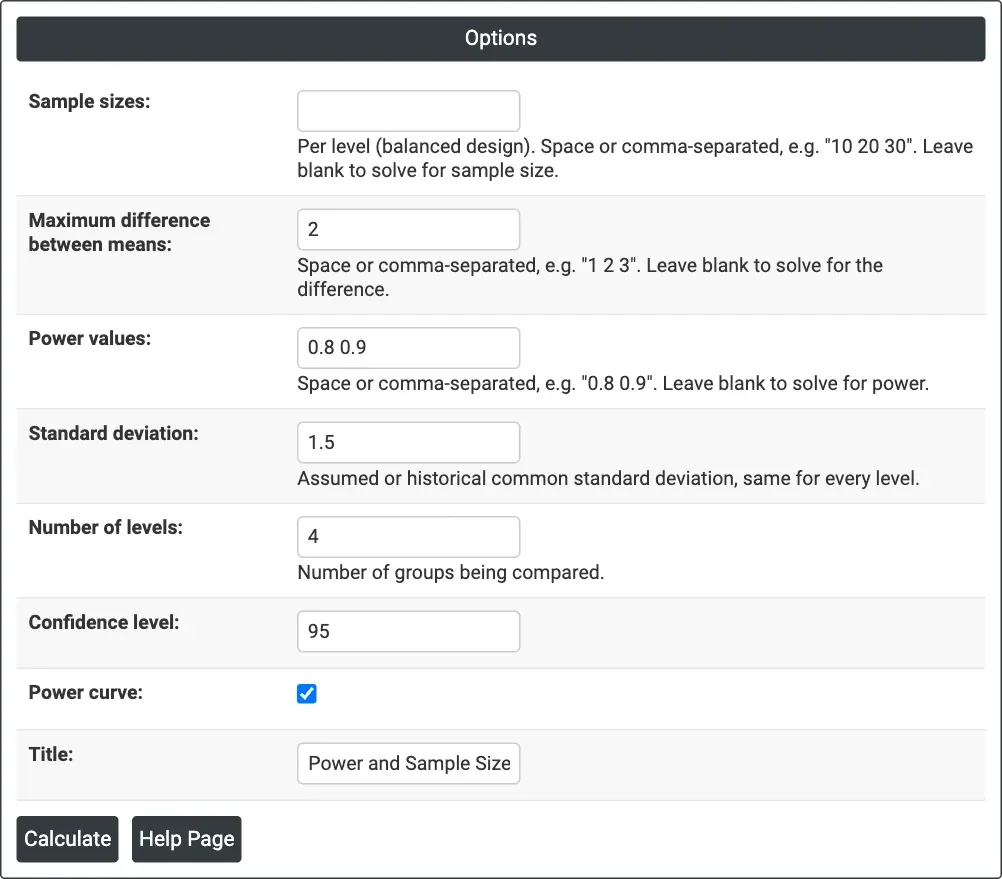
Figure 1 — Steekproefomvang bepalen: Maximum difference between means = 2, Power values = 0.8 0.9, Standard deviation = 1.5, Number of levels = 4, bij 95% betrouwbaarheid.
Beschrijving van de uitvoer
- Settings — wat is bepaald, het aantal niveaus, de standaardafwijking en het betrouwbaarheidsniveau.
- Results — één rij per combinatie: maximaal verschil, steekproefomvang per niveau, en gewenst en werkelijk vermogen bij het bepalen van de steekproefomvang, of vermogen bij het bepalen van het vermogen, of maximaal verschil bij het bepalen daarvan.
- Power Curve — onderscheidend vermogen tegen steekproefomvang per niveau voor elk maximaal verschil, met de berekende punten gemarkeerd.
- PDF-export via Download.
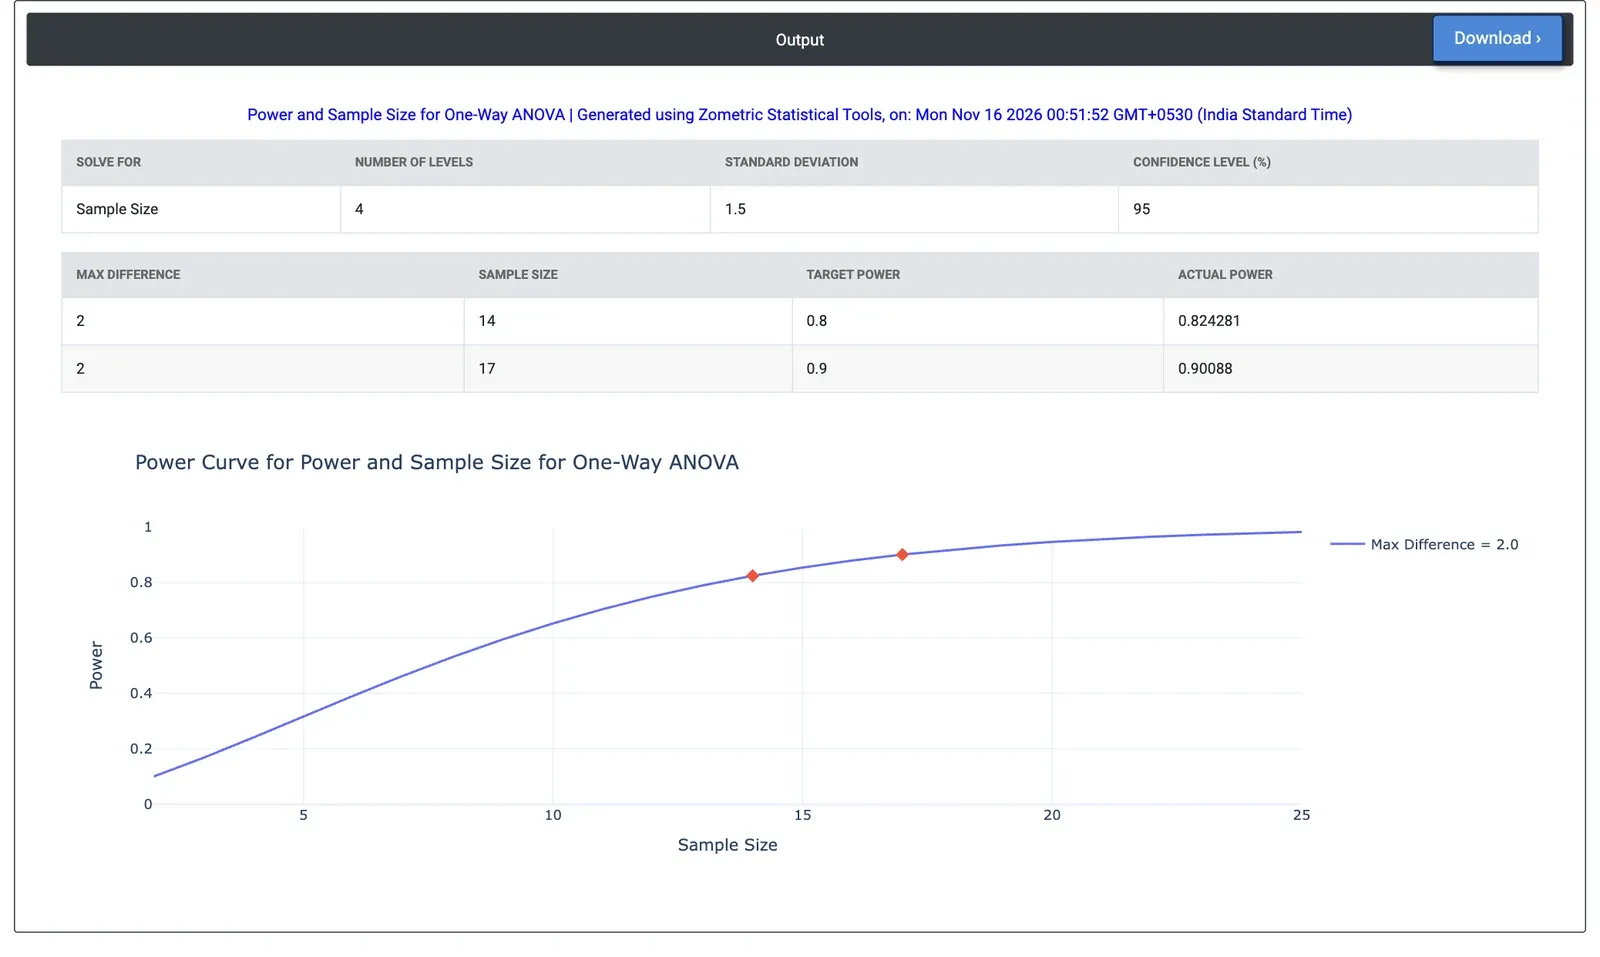
Figure 2 — Resultaten voor het voorbeeld: 14 onderdelen per oven voor 80% vermogen (werkelijk 0.824) en 17 voor 90% vermogen (werkelijk 0.901).
Uitgewerkt voorbeeld
Een warmtebehandelingsbedrijf heeft vier ovens en wil controleren of ze dezelfde gemiddelde oppervlaktehardheid geven. Een verschil van 2 HRC tussen de beste en de slechtste oven zou van belang zijn, en de standaardafwijking van de hardheid binnen een oven is ongeveer 1.5 HRC. De metallurg laat Sample sizes leeg en voert Maximum difference between means = 2, Power values = 0.8 0.9, Standard deviation = 1.5 en Number of levels = 4 in, bij 95% betrouwbaarheid.
De tool heeft 14 onderdelen per oven nodig voor 80% vermogen (werkelijk vermogen 0.824) en 17 per oven voor 90% vermogen (werkelijk vermogen 0.901), dus 56 en 68 onderdelen in totaal. Met 8 onderdelen per oven zou het vermogen slechts 0.532 zijn en met 5 onderdelen 0.317. Met 14 onderdelen per oven en 80% vermogen is het kleinste maximale verschil dat de studie kan detecteren 1.94 HRC. Deze cijfers gaan uit van het minst gunstige patroon: één oven hoog, één laag en de andere twee in het midden. Als in plaats daarvan twee ovens bij elk uiterste liggen, zouden 8 onderdelen per oven al een vermogen van 0.852 geven, dus het plan zit aan de veilige kant.
Veelgestelde vragen
Hoe wordt het onderscheidend vermogen voor een eenweg-ANOVA berekend?
Onderscheidend vermogen is de kans dat de F-toets van de ANOVA gelijke gemiddelden verwerpt. Het wordt berekend uit de niet-centrale F-verdeling met k - 1 en N - k vrijheidsgraden. Het maximale verschil wordt omgezet in een effectgrootte met de minst gunstige rangschikking van gemiddelden: twee niveaus bij min en plus de helft van het verschil en de overige niveaus bij het algemeen gemiddelde.
Waarom is de steekproefomvang voor eenweg-ANOVA conservatief?
De tool gaat uit van de rangschikking van groepsgemiddelden die het minste onderscheidend vermogen geeft voor het ingevoerde maximale verschil. Als de gemiddelden verder uit elkaar liggen, bijvoorbeeld twee niveaus bij elk uiterste, is het werkelijke vermogen hoger dan gerapporteerd en zouden minder eenheden volstaan. In het uitgewerkte voorbeeld zouden 8 onderdelen per oven bij dat gunstigere patroon een vermogen van 0.852 geven.
Hoeveel monsters per groep zijn nodig voor een eenweg-ANOVA?
In een uitgewerkt voorbeeld met vier ovens, een standaardafwijking van 1.5 HRC en een maximaal verschil van 2 HRC bij 95% betrouwbaarheid geven 14 onderdelen per oven 80% vermogen en 17 geven 90%, dus 56 en 68 onderdelen in totaal. Met 8 onderdelen per oven is het vermogen 0.532 en met 5 onderdelen 0.317.
Wat zijn de aannames van de vermogensberekening voor eenweg-ANOVA?
Ze gaat uit van k onafhankelijke groepen uit normale populaties met een gemeenschappelijke standaardafwijking en een gebalanceerde opzet, met dezelfde steekproefomvang in elk niveau. Het aantal niveaus moet minstens 2 zijn en de standaardafwijking is vereist, meestal uit historische gegevens. Bij twee niveaus is er maar één mogelijke rangschikking van de gemiddelden.