
Waarschijnlijkheidsplot (Probability Plot)
De Probability Plot toetst of gegevens bij een verdeling passen door geordende waarden uit te zetten op een schaal waarop de verdeling als rechte lijn verschijnt, met betrouwbaarheidsgrenzen. Ze ondersteunt negen verdelingen, waaronder Normal, Lognormal, Weibull en Exponential, en rapporteert voor elk de Anderson-Darling-statistiek en de p-waarde. Gebruik haar vóór capabiliteitsanalyse, regelgrenzen of t-toetsen die normaliteit veronderstellen, en om een betrouwbaarheidsverdeling te kiezen.
Laatst beoordeeld
Belangrijkste conclusie
Een waarschijnlijkheidsplot controleert of gegevens een gekozen verdeling volgen, meestal de normale, door geordende gegevens uit te zetten op een schaal waarop die verdeling een rechte lijn is, met Anderson-Darling-statistiek en p-waarde.
Op deze pagina
Doel
De Probability Plot controleert of gegevens een gekozen verdeling volgen, meestal de normale verdeling. De geordende gegevens worden uitgezet op een schaal waarop de gekozen verdeling als rechte lijn verschijnt: als de punten de lijn volgen, past de verdeling. Gebruik haar vóór capabiliteitsanalyse, regelgrenzen, tolerantie-intervallen of t-toetsen die normaliteit veronderstellen, en om een verdeling (Weibull, lognormaal, exponentieel) te kiezen voor betrouwbaarheidswerk of niet-normale capabiliteit.
Belangrijkste mogelijkheden
- Negen verdelingen: Normal, Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest Extreme Value, Largest Extreme Value, Logistic en Loglogistic.
- Aangepaste referentielijn met puntsgewijze betrouwbaarheidsgrenzen op een gekozen niveau (standaard 95%).
- Anderson-Darling-statistiek (AD) en bijbehorende p-waarde in de legenda voor elke verdeling, zodat de aanpassingen kunnen worden vergeleken.
- Meerdere variabelen over elkaar heen in één plot, of één variabele opgesplitst in groepen via een By-kolom, elk met een eigen aangepaste lijn.
- Logaritmische gegevensas voor Lognormal, Weibull en Loglogistic, zoals op standaard waarschijnlijkheidspapier.
Statistische methoden
Voor elke variabele of groep (ten minste 3 waarden) worden de gegevens gesorteerd, x₍₁₎ ≤ … ≤ x₍ₙ₎, en krijgt elke waarde de plotpositie pᵢ = (i − 0.3) / (n + 0.4), de mediane-rangbenadering van Benard. De verticale as is de inverse verdelingsfunctie van de gekozen verdeling, gelabeld in procenten, zodat een steekproef uit die verdeling dicht bij een rechte lijn valt. De referentielijn is de aangepaste verdelingsfunctie: voor Normal het steekproefgemiddelde en de standaardafwijking (deler n − 1); voor de andere verdelingen maximum likelihood, met de drempel vastgezet op 0 voor Lognormal, Weibull, Exponential en Loglogistic (die positieve waarden vereisen).
De betrouwbaarheidsgrenzen worden door elk punt getekend: bij niveau C is de ondergrens het α/2-kwantiel van een Beta(i, n − i + 1)-verdeling en de bovengrens het 1 − α/2-kwantiel van een Beta(i + 1, n − i)-verdeling, waarbij α = 1 − C/100. Punten die buiten de grenzen komen, zijn bewijs tegen de verdeling.
De Anderson-Darling-statistiek AD = −n − (1/n) Σ (2i − 1)[ln F(x₍ᵢ₎) + ln(1 − F(x₍ₙ₊₁₋ᵢ₎))] meet hoe ver de punten van de aangepaste verdelingsfunctie F liggen, met extra gewicht in de staarten; kleiner is beter. De legenda toont deze ongecorrigeerde AD voor elke verdeling, zoals Minitab dat doet. De p-waarde komt uit een aangepaste statistiek, zoals bij D'Agostino en Stephens: voor Normal en Lognormal (op de logaritmen) AD·(1 + 0.75/n + 2.25/n²), omgezet met de benadering van Stephens; voor Weibull en de twee extremewaardeverdelingen AD·(1 + 0.2/√n); voor Exponential AD·(1 + 0.6/n); voor Logistic en Loglogistic AD·(1 + 0.25/n). De laatste drie worden opgezocht in de tabellen met kritieke waarden van Stephens en geïnterpoleerd, zodat een p-waarde buiten de tabel als grens wordt getoond, zoals >0.250 of <0.010. Voor 2-Parameter Exponential worden de n − 1 verschillen x₍ᵢ₎ − x₍₁₎ als exponentieel getoetst. Een p-waarde onder 0.05 is bewijs dat de gegevens de verdeling niet volgen; tussen verdelingen betekent de grotere p-waarde doorgaans de betere aanpassing.
Invoervelden en opties
Veld | Beschrijving |
Variables | Vereist. Eén numerieke kolom, of meerdere om over elkaar heen te leggen (een “Multiple” waarschijnlijkheidsplot). |
By (grouping) column | Optioneel. Eén aangepaste lijn per groep. Alleen gebruikt wanneer één variabele is geselecteerd. |
Distribution | Normal (standaard), Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest Extreme Value, Largest Extreme Value, Logistic of Loglogistic. |
Confidence level (%) | Standaard 95; 1 tot 99.99. Niveau van de betrouwbaarheidsgrenzen. |
Display confidence interval bounds | Standaard aangevinkt. Tekent de grenzen als stippellijnen. |
Title | Titel van de plot. Standaard “Probability Plot”. |
Data Options: Subset (optional) | Exclude matching rows (standaard) of Include only matching rows; Row numbers (bijv. 3,7,12-15) en/of een Condition (bijv. Tensile_Strength_MPa > 205) selecteren de rijen. |
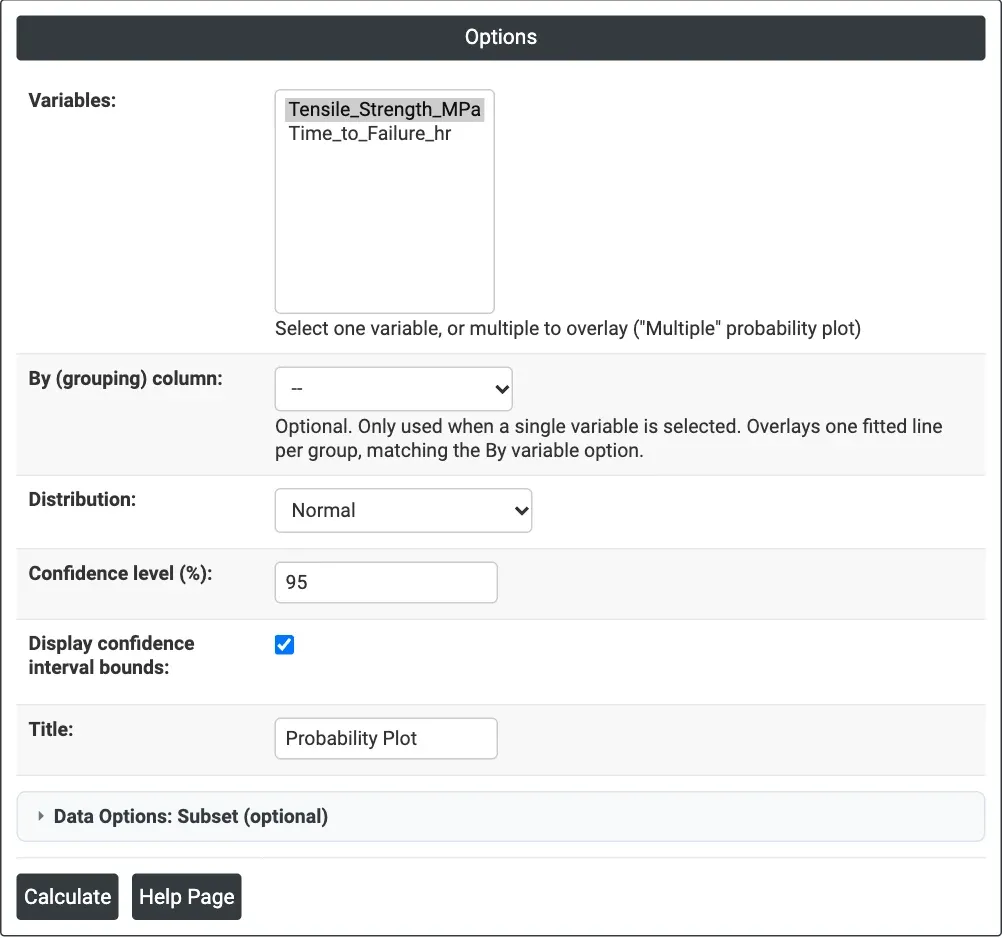
Figuur 1 — Opties voor het voorbeeld: Tensile_Strength_MPa op een Normal-waarschijnlijkheidsplot met 95%-grenzen.
Beschrijving van de uitvoer
- Probability Plot — de gegevens (horizontale as) tegen procenten op de waarschijnlijkheidsschaal van de verdeling, met de aangepaste lijn en de gestippelde betrouwbaarheidsgrenzen. De legenda geeft van elke reeks de AD-statistiek en de p-waarde.
- PDF-export via Download.
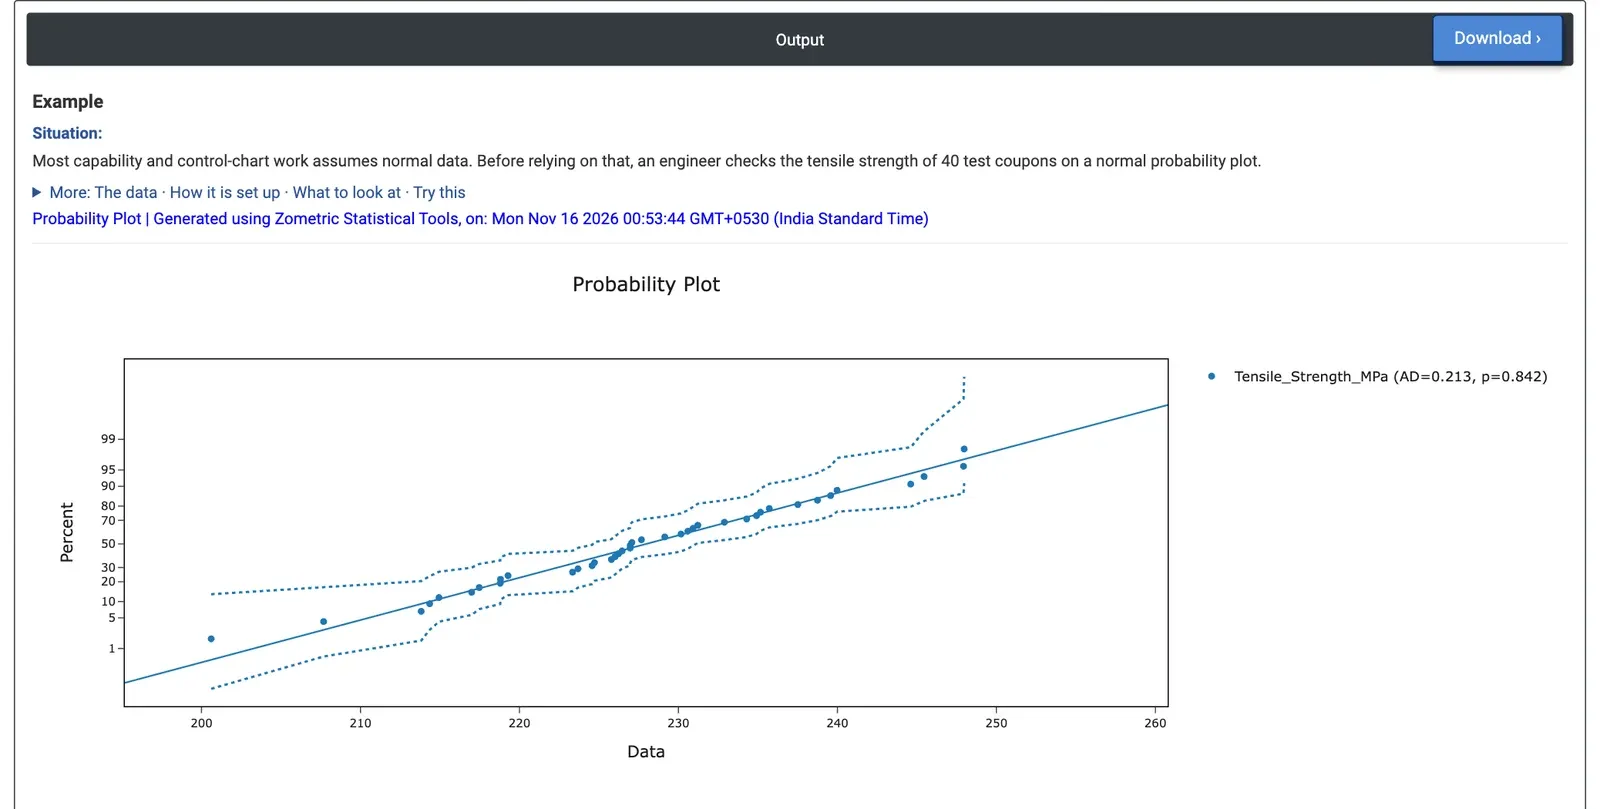
Figuur 2 — Normale waarschijnlijkheidsplot van de treksterkte van 40 proefstaven: AD = 0.213, p = 0.842.
Uitgewerkt voorbeeld
Voordat een ingenieur regelgrenzen instelt en de capabiliteit berekent, controleert hij of de treksterkte van 40 proefstaven als normaal kan worden behandeld. Variables = Tensile_Strength_MPa, Distribution = Normal, Confidence level 95, grenzen weergegeven.
De punten volgen de rechte lijn en blijven over het hele bereik, van 200.61 tot 247.97 MPa, binnen de gestippelde grenzen. De legenda toont AD = 0.213 met p = 0.842, ver boven 0.05: er is geen bewijs tegen normaliteit. De aangepaste lijn heeft gemiddelde 227.97 MPa en standaardafwijking 10.61 MPa, dus methoden voor capabiliteit en regelkaarten op basis van de normale verdeling zijn bruikbaar. Punten die aan een van beide uiteinden van de lijn afbuigen, zouden op een scheve verdeling of een verdeling met zware staarten hebben gewezen.
Hetzelfde werkblad bevat 40 tijden tot uitval (uren). Het uitzetten van Time_to_Failure_hr tegen meerdere verdelingen geeft AD = 0.210 met p > 0.250 voor Weibull (vorm 3.23, schaal 192.96 uur), AD = 0.158 met p = 0.947 voor Normal, AD = 1.228 met p < 0.005 voor Lognormal en AD = 7.628 met p < 0.010 voor Exponential. De Exponential, die een constante faalfrequentie veronderstelt, past duidelijk niet, en de Lognormal evenmin. De Weibull en de Normal passen beide goed; voor uitvaltijden is de Weibull de gebruikelijke keuze, omdat een vorm boven 1 slijtage beschrijft en ze geen negatieve levensduren kan voorspellen.
Veelgestelde vragen
Hoe interpreteert u een waarschijnlijkheidsplot?
Als de punten de aangepaste rechte lijn volgen en binnen de betrouwbaarheidsgrenzen blijven, past de verdeling. Punten die buiten de grenzen komen, zijn bewijs ertegen, en punten die aan een van beide uiteinden van de lijn afbuigen, wijzen op een scheve verdeling of een verdeling met zware staarten. De legenda geeft de Anderson-Darling-statistiek en de p-waarde; een p-waarde onder 0.05 is bewijs dat de gegevens de verdeling niet volgen.
Wanneer gebruikt u een waarschijnlijkheidsplot?
Gebruik haar om normaliteit te controleren vóór capabiliteitsanalyse, regelgrenzen, tolerantie-intervallen of t-toetsen die normale gegevens veronderstellen. Ze wordt ook gebruikt om een verdeling, zoals Weibull, lognormaal of exponentieel, te kiezen voor betrouwbaarheidswerk of niet-normale capabiliteit. Elke variabele of groep heeft ten minste 3 waarden nodig, en meerdere variabelen of groepen kunnen over elkaar heen worden gelegd.
Hoe vergelijkt u verdelingen op een waarschijnlijkheidsplot?
Zet dezelfde gegevens uit tegen meerdere verdelingen en vergelijk de Anderson-Darling-statistieken en p-waarden; een kleinere AD en een grotere p-waarde betekenen doorgaans een betere aanpassing. In een uitgewerkt voorbeeld met 40 uitvaltijden passen de Weibull (p > 0.250) en de Normal (p = 0.947) goed, terwijl de Lognormal en de Exponential (p < 0.010) niet passen.
Welke verdelingen kan een waarschijnlijkheidsplot toetsen?
Negen: Normal, Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest Extreme Value, Largest Extreme Value, Logistic en Loglogistic. Lognormal, Weibull, Exponential en Loglogistic vereisen positieve waarden, en Lognormal, Weibull en Loglogistic gebruiken een logaritmische gegevensas, zoals op standaard waarschijnlijkheidspapier.