
Willekeurige gegevens genereren (Random Data)
Random Data trekt 10 tot 10,000 rijen in maximaal 10 onafhankelijke kolommen uit een van 26 verdelingen, waaronder Normal, Lognormal, Weibull, Triangular, Binomial, Poisson en Multivariate Normal. De waarden worden getrokken zonder vaste seed, dus elke run geeft nieuwe getallen. Optionele afronding en een grafische samenvatting met histogram, Anderson-Darling-normaliteitstoets, betrouwbaarheidsintervallen en waarschijnlijkheidsplot beschrijven de gegenereerde gegevens.
Laatst beoordeeld
Belangrijkste conclusie
Random Data genereert willekeurige getallen uit een van 26 continue, discrete of multivariate normale verdelingen in de Data Pane, voor trainingsgegevens, simulatie, wat-als-studies en om te zien hoeveel steekproeven variëren.
Op deze pagina
Doel
Random Data genereert willekeurige getallen uit een van 26 verdelingen en zet ze in de Data Pane, klaar om te kopiëren of in andere tools te gebruiken. Gebruik het om oefengegevens voor training te maken, om te zien hoeveel een steekproef uit een bekend proces varieert (een histogram van 30 waarden uit een perfect normaal proces is zelden klokvormig), om een analyse uit te proberen voordat de echte gegevens beschikbaar zijn, of om een proces te simuleren voor een wat-als-studie, bijvoorbeeld cyclustijden uit een driehoeksschatting of faaltijden uit een Weibull-model. Een optionele grafische samenvatting beschrijft de getallen die u hebt gegenereerd.
Belangrijkste mogelijkheden
- 26 verdelingen in één lijst Distribution: continu (Normal, Lognormal, Weibull, Exponential, Gamma, Uniform, Triangular en andere), discreet (Binomial, Poisson, Geometric, Hypergeometric, Integer, Discrete en andere) en Multivariate Normal.
- Alleen de parametervelden van de gekozen verdeling worden getoond.
- 10 tot 10,000 rijen en 1 tot 10 onafhankelijke kolommen (data_1, data_2, …).
- Optionele afronding op een bepaald aantal decimalen.
- Optionele grafische samenvatting van alle gegenereerde waarden: histogram, samenvattende statistieken, Anderson-Darling-normaliteitstoets, betrouwbaarheidsintervallen en waarschijnlijkheidsplot.
- Multivariate Normal: gecorreleerde kolommen uit een vector van gemiddelden en een covariantiematrix, met de steekproefcorrelatie- en covariantiematrices ter controle.
Statistische methoden
Waarden worden onafhankelijk getrokken met de generatoren voor willekeurige getallen van NumPy en SciPy, zonder vaste seed, zodat elke Calculate nieuwe getallen geeft. Elke kolom is een afzonderlijke steekproef van de gekozen omvang uit dezelfde verdeling. Parameters volgen de gebruikelijke definities: bijvoorbeeld Normal (gemiddelde μ, standaardafwijking σ), Weibull (vorm β, schaal η, optionele drempel die bij elke waarde wordt opgeteld), Exponential (schaal = gemiddelde, optionele drempel), Integer (gehele getallen van Minimum tot Maximum, beide inbegrepen), Geometric (aantal pogingen tot en met de eerste gebeurtenis) en Negative Binomial (aantal niet-gebeurtenissen vóór het vereiste aantal gebeurtenissen). Voor Lognormal voert u het gemiddelde en de standaardafwijking van de gegevens zelf in: de tool zet ze om naar de parameters op logschaal σ = √ln(1 + (s/m)²) en μ = ln(m) − σ²/2. Bij Discrete worden de kansen herschaald zodat ze optellen tot 1.
Als Graphical Summary is aangevinkt, worden alle kolommen samengevoegd tot één steekproef en beschreven: gemiddelde, standaardafwijking, variantie, scheefheid, kurtosis, N, minimum, kwartielen, mediaan, maximum en variatiecoëfficiënt (%); de Anderson-Darling-toets op normaliteit (A-kwadraat en p-waarde); 95%-betrouwbaarheidsintervallen voor het gemiddelde (t), de mediaan (Hettmansperger-Sheather) en de standaardafwijking (chi-kwadraat). Als Exclude outliers is aangevinkt, worden waarden buiten Q1 − 1.5×IQR of Q3 + 1.5×IQR alleen uit de samenvatting weggelaten; de gegenereerde gegevens behouden ze. Bij Multivariate Normal moet de covariantiematrix vierkant, symmetrisch en positief semi-definiet zijn en overeenkomen met het aantal gemiddelden.
Invoervelden en opties
Veld | Beschrijving |
Distribution | Verplicht. Een van 26 verdelingen; de parametervelden hieronder veranderen mee. |
Number of rows of data to generate | Verplicht, 10 tot 10,000. |
Number of columns | Standaard 1, maximaal 10. Elke kolom is een onafhankelijke steekproef. Niet gebruikt voor Multivariate Normal (één kolom per gemiddelde). |
Graphical Summary | Standaard niet aangevinkt. Voegt de grafische samenvatting van de gegenereerde waarden toe aan de uitvoer. |
Exclude outliers (1.5×IQR rule) | Optioneel. Heeft geen effect tenzij Graphical Summary is aangevinkt; verwijdert dan uitschieters alleen uit de samenvatting. |
Decimals | Optioneel, 0 tot 10. Rondt de gegenereerde waarden af voor de continue verdelingen (Normal, Lognormal, Weibull, Exponential, T, F, Beta, Cauchy, Chi-Square, Gamma, Laplace, de extreme-waardeverdelingen, Logistic, Loglogistic, Triangular en Uniform). Bij Normal blijven ten minste zoveel decimalen behouden dat de standaardafwijking zichtbaar is. Niet getoond voor de verdelingen die gehele getallen of opgesomde waarden geven (Binomial, Poisson, Bernoulli, Discrete, Geometric, Hypergeometric, Integer en Negative Binomial) of voor Multivariate Normal. |
Mean / Standard Deviation | Normal; Lognormal (gemiddelde en standaardafwijking van de gegevens); Poisson gebruikt alleen Mean. |
Number of trials / Event probability | Binomial. Alleen Event probability: Bernoulli en Geometric; met Number of events (vereiste successen): Negative Binomial. |
Shape parameter / Scale parameter / Threshold parameter | Weibull (drempel optioneel); Gamma en Loglogistic gebruiken vorm en schaal. |
Scale parameter / Threshold parameter | Exponential (drempel optioneel). |
Location parameter / Scale parameter | Cauchy, Laplace, Largest Extreme Value, Smallest Extreme Value en Logistic. |
Degrees of freedom / Numerator and Denominator degrees of freedom | T en Chi-Square; F. |
First shape parameter / Second shape parameter | Beta. |
Values / Probabilities | Discrete. Gescheiden door komma of spatie, hetzelfde aantal, bijvoorbeeld “1 2 3” en “0.2 0.3 0.5” (opnieuw genormaliseerd als ze niet optellen tot 1). |
Population size (N) / Event count in population / Sample size (n) | Hypergeometric. Het aantal gebeurtenissen en de steekproefomvang mogen de populatieomvang niet overschrijden. |
Minimum / Maximum / Mode (most likely value) | Integer (minimum en maximum); Triangular (alle drie, de modus ligt ertussen). |
Lower endpoint / Upper endpoint | Uniform. |
Means / Covariance matrix | Multivariate Normal. Means: één per variabele, bijvoorbeeld “10 20 30”; covariantierijen gescheiden door puntkomma's, bijvoorbeeld “4,2,0; 2,9,1; 0,1,1”. |
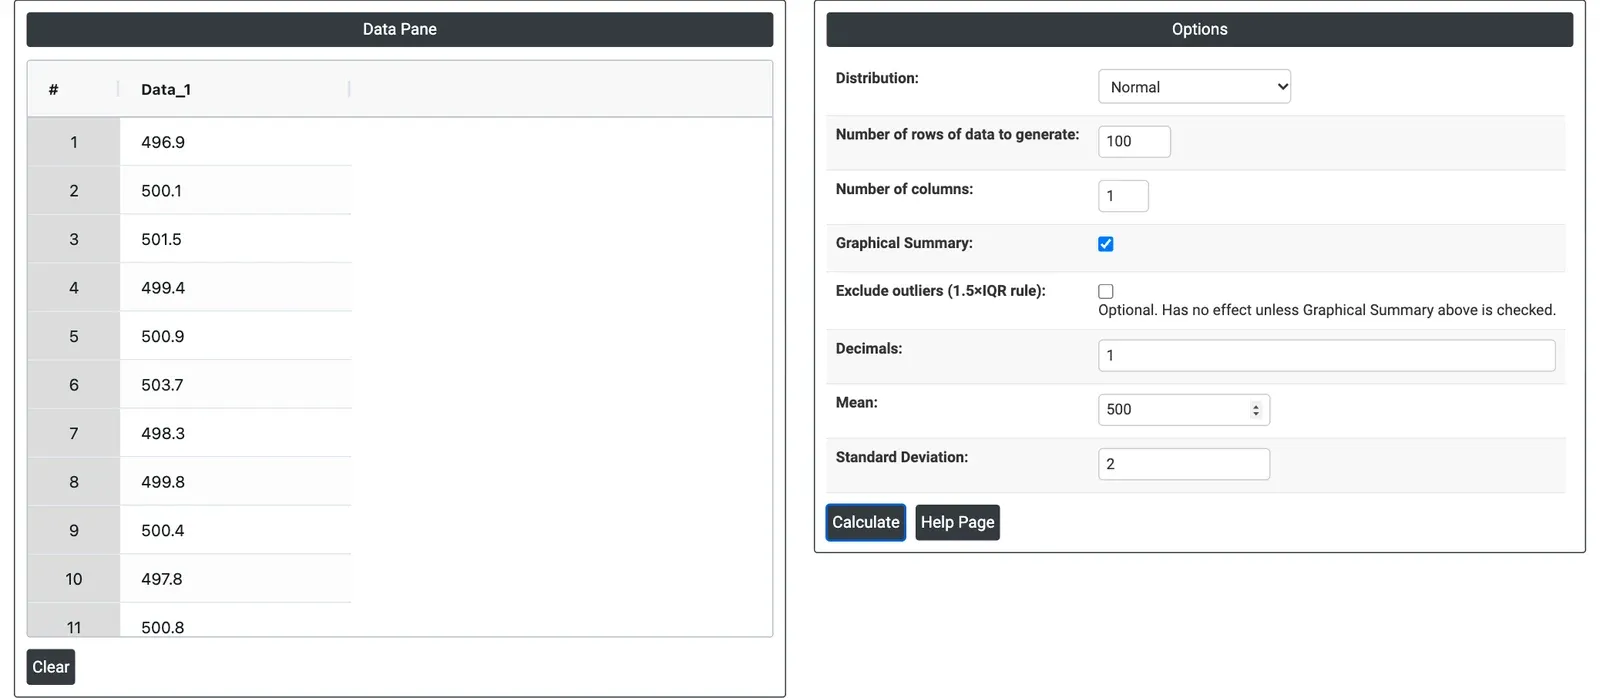
Figuur 1 — 100 waarden uit een Normal-verdeling met gemiddelde 500 en standaardafwijking 2, afgerond op 1 decimaal, in de Data Pane (links) met de Options (rechts).
Beschrijving van de uitvoer
- Data Pane — de gegenereerde waarden, één kolom per steekproef (data_1, data_2, …), ter vervanging van wat er stond.
- Graphical summary (when ticked) — histogram met gefitte normale curve en boxplot; samenvattingstabel met A-Squared, p-value, Mean, StDev, Variance, Skewness, Kurtosis, N, Minimum, 1st Quartile, Median, 3rd Quartile, Maximum en Coeff Var; plot van 95% Confidence Intervals voor het gemiddelde en de mediaan; Probability Plot met het Anderson-Darling-resultaat; en een tabel met onder- en bovengrenzen van 95% voor het gemiddelde, de mediaan en de standaardafwijking, met de halve breedte van elk interval.
- Multivariate Normal — steekproefcorrelatie- en covariantiematrices van de gegenereerde kolommen.
- PDF-export via Download as PDF.
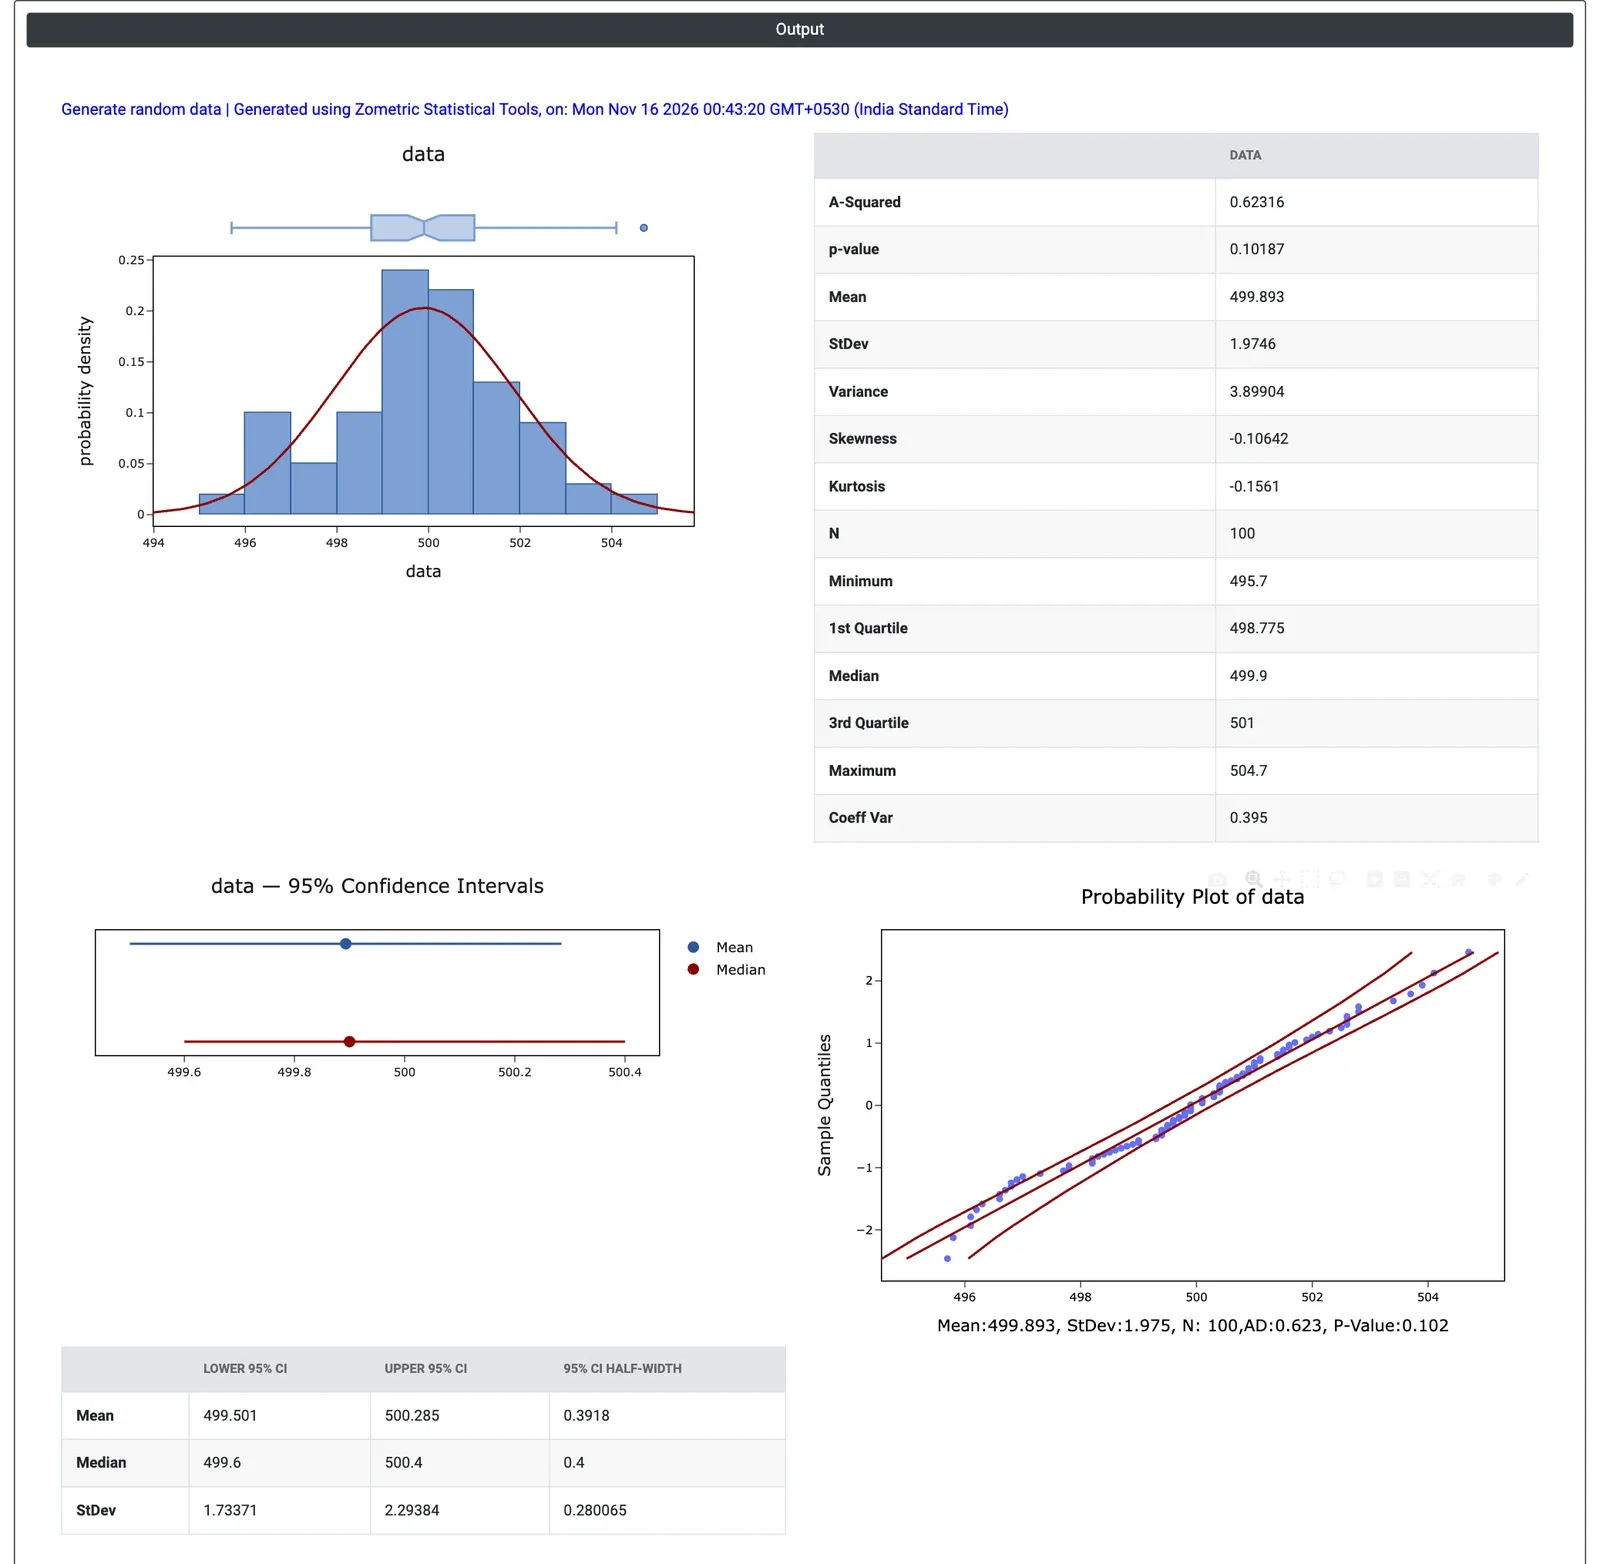
Figuur 2 — Grafische samenvatting van de 100 gegenereerde waarden: gemiddelde 499.89, StDev 1.97, Anderson-Darling-p-waarde 0.102.
Uitgewerkt voorbeeld
Een kwaliteitstrainer bereidt een sessie over procesvariatie voor voor operators van een vullijn. De lijn vult flessen van 500 g met een standaardafwijking van ongeveer 2 g. Om te laten zien hoe normale variatie er op zichzelf uitziet, kiest de trainer Distribution = Normal, Number of rows = 100, Number of columns = 1, Mean = 500, Standard Deviation = 2 en Decimals = 1, en vinkt Graphical Summary aan.
De 100 gesimuleerde vulgewichten lopen van 495.7 tot 504.7 g, met een gemiddelde van 499.89 g en een standaardafwijking van 1.97 g: niet precies 500 en 2, hoewel het proces exact zo was ingesteld. Het histogram is hobbelig in plaats van een zuivere klokvorm, maar de Anderson-Darling-toets geeft p = 0.102, dus er is geen bewijs tegen normaliteit. Het 95%-betrouwbaarheidsinterval voor het gemiddelde, 499.50 tot 500.29 g (halve breedte 0.39 g), bevat de ware 500, en het interval voor de standaardafwijking, 1.73 tot 2.29 g, bevat de ware 2.
Het punt voor de operators: een stabiel, gecentreerd proces geeft nog steeds afzonderlijke flessen die 4 g van de streefwaarde afliggen en steekproefstatistieken die van de ware waarden afwijken. Elke Calculate trekt een nieuwe steekproef met iets andere getallen, die de trainer kan gebruiken om de variatie van steekproef tot steekproef te tonen. Door 5 kolommen van 20 rijen te genereren krijgt u vijf kleine steekproeven om te vergelijken, of kunt u de gegevens ter oefening naar een capabiliteits- of regelkaarttool kopiëren.
Veelgestelde vragen
Waarvoor worden willekeurige gegevens in kwaliteitswerk gebruikt?
Ze worden gebruikt om oefengegevens voor training te maken, om te zien hoeveel steekproeven uit een bekend proces variëren, om een analyse uit te proberen voordat echte gegevens beschikbaar zijn, en om een proces te simuleren voor wat-als-studies, zoals cyclustijden uit een driehoeksschatting of faaltijden uit een Weibull-model. Gegenereerde gegevens kunnen worden gekopieerd naar andere tools, zoals capabiliteitsanalyse of regelkaarten.
Uit welke verdelingen kunnen willekeurige gegevens worden gegenereerd?
Er zijn er 26: continue verdelingen zoals Normal, Lognormal, Weibull, Exponential, Gamma, Uniform en Triangular; discrete verdelingen zoals Binomial, Poisson, Geometric, Hypergeometric, Integer en Discrete; en Multivariate Normal, die gecorreleerde kolommen oplevert uit een vector van gemiddelden en een covariantiematrix. Alleen de parametervelden van de gekozen verdeling worden getoond.
Waarom komt een willekeurige steekproef niet precies overeen met het populatiegemiddelde en de standaardafwijking?
Elke steekproef varieert door toeval. In een uitgewerkt voorbeeld hadden 100 waarden uit een normaal proces met gemiddelde 500 en standaardafwijking 2 een steekproefgemiddelde van 499.89 en een standaardafwijking van 1.97, en het histogram was hobbelig in plaats van klokvormig, maar de Anderson-Darling-toets gaf p = 0.102, wat geen bewijs tegen normaliteit toont.
Hoe voert u lognormale parameters in bij het genereren van willekeurige gegevens?
Voor de Lognormal-verdeling voert u het gemiddelde en de standaardafwijking van de gegevens zelf in, niet van de logaritmen. De tool zet ze om naar parameters op logschaal: sigma is gelijk aan de wortel uit ln(1 + (s/m) in het kwadraat) en mu is gelijk aan ln(m) min sigma in het kwadraat gedeeld door 2.