
Willekeurige exponentiële gegevens (Random Exponential Data)
Random Exponential Data simuleert wachttijden tussen onafhankelijke gebeurtenissen, zoals machinestoringen of klantaankomsten, bij een constante faalfrequentie (de geheugenloze eigenschap). U stelt het aantal rijen en kolommen in, de schaal, dat is de gemiddelde tijd tussen gebeurtenissen (1/frequentie), en een optionele drempel die waarden omhoog verschuift. Verandert de faalfrequentie in de tijd, gebruik dan Random Weibull Data.
Laatst beoordeeld
Belangrijkste conclusie
Random Exponential Data genereert strikt positieve waarden uit de exponentiële verdeling, bij een gegeven gemiddelde tijd tussen gebeurtenissen, om tijden tussen storingen, aankomsten of bedieningen met constante frequentie te simuleren.
Op deze pagina
Wat zijn willekeurige exponentiële gegevens?
Random Exponential Data genereert waarden uit de exponentiële verdeling, die de tijd tussen opeenvolgende onafhankelijke gebeurtenissen modelleert, zoals de tijd tussen machinestoringen, klantaankomsten of voltooide bedieningen. U geeft het gemiddelde op (de gemiddelde tijd tussen gebeurtenissen) en de tool genereert willekeurige tijdsduren tussen gebeurtenissen.
Eenvoudige definitie: Genereert willekeurige wachttijden tussen gebeurtenissen, veel gebruikt in betrouwbaarheidstechniek en wachtrij-analyse om te simuleren hoe lang het duurt tot de volgende storing of aankomst.
Wanneer gebruikt u Random Exponential Data?
- Gebruik het om de tijd tussen storingen, aankomsten of voltooide bedieningente simuleren.
- Gebruik het om betrouwbaarheidsanalyses te testen die uitgaan van een constante faalfrequentie (exponentieel faalmodel).
Richtlijnen voor correct gebruik van Random Exponential Data
- De exponentiële verdeling veronderstelt een constante faalfrequentie (geheugenloze eigenschap) : als de faalfrequentie in de tijd verandert, gebruik dan Weibull.
- Alle gegenereerde waarden zijn strikt positief.
- Stel het gemiddelde in op de bekende gemiddelde tijd tussen gebeurtenissen uit historische gegevens.
Alternatieven: wanneer u Random Exponential Data niet gebruikt
- Als de faalfrequentie in de tijd verandert, gebruik dan Random Weibull Data
- Voor scheve positieve continue metingen (niet tijdgebonden) gebruikt u Random Lognormal Data
Voorbeeld van Random Exponential Data
De volgende stappen om Random Exponential Data te genereren:
- Vul om Random Exponential Data te genereren de vereiste opties in.
- Analyseer nu de gegevens in Zometric Statistical Software op https://statsai.zometric.com/.
- Kies voor Random Exponential Data Statistical module> Random Data > Random Exponential Data
4. Na gebruik van bovenstaande tool haalt u de uitvoer als volgt op:
Zo gebruikt u Random Exponential Data
De handleiding is als volgt:
- Log in op Zometric Statistical Software op https://statsai.zometric.com/
- Kies op de startpagina Statistical Tool> Random Data>Random Exponential Data.
- Vul vervolgens de vereiste opties in.
- Klik ten slotte onderaan de pagina op Calculate en u krijgt de gewenste resultaten.
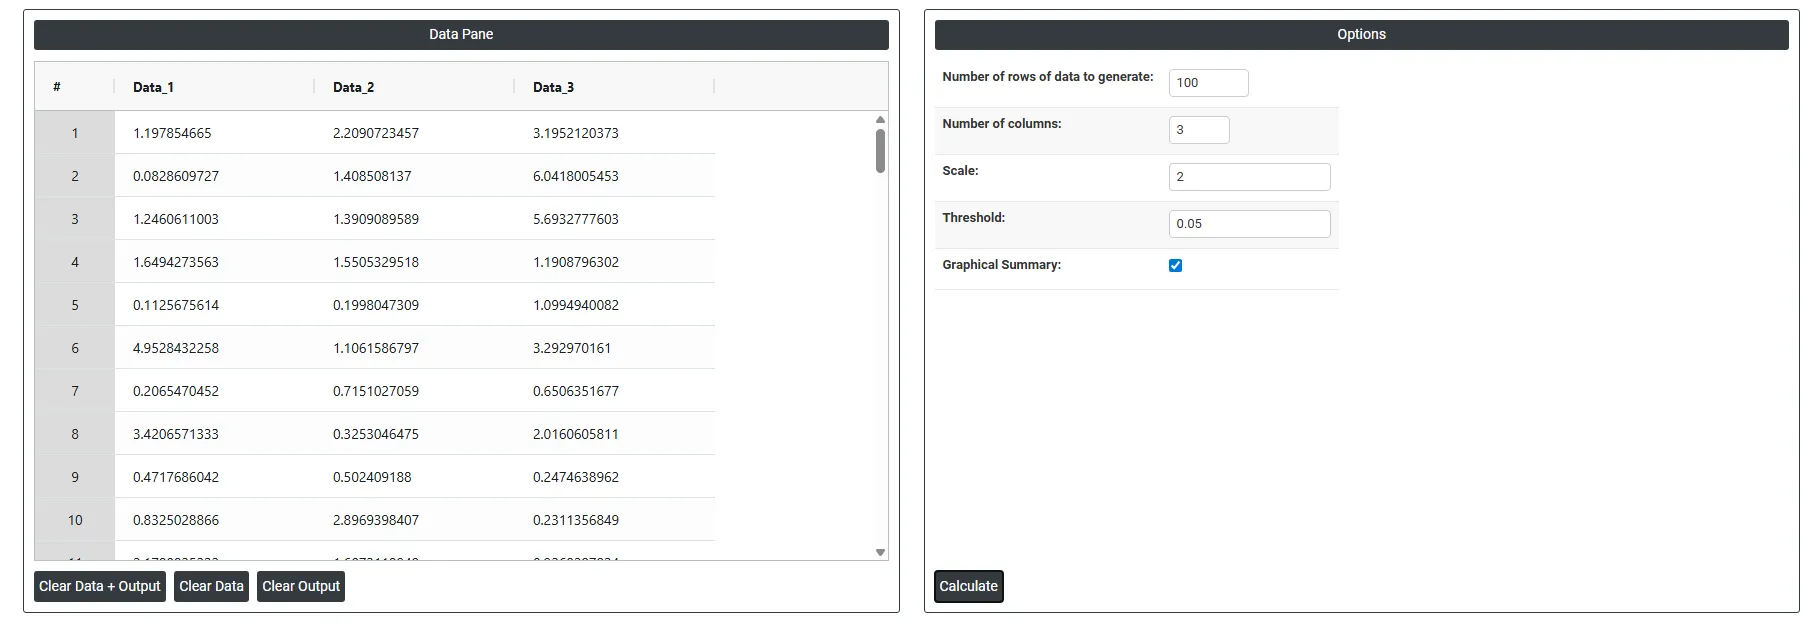
Op het dashboard van Random Exponential Data is het venster in twee delen verdeeld.
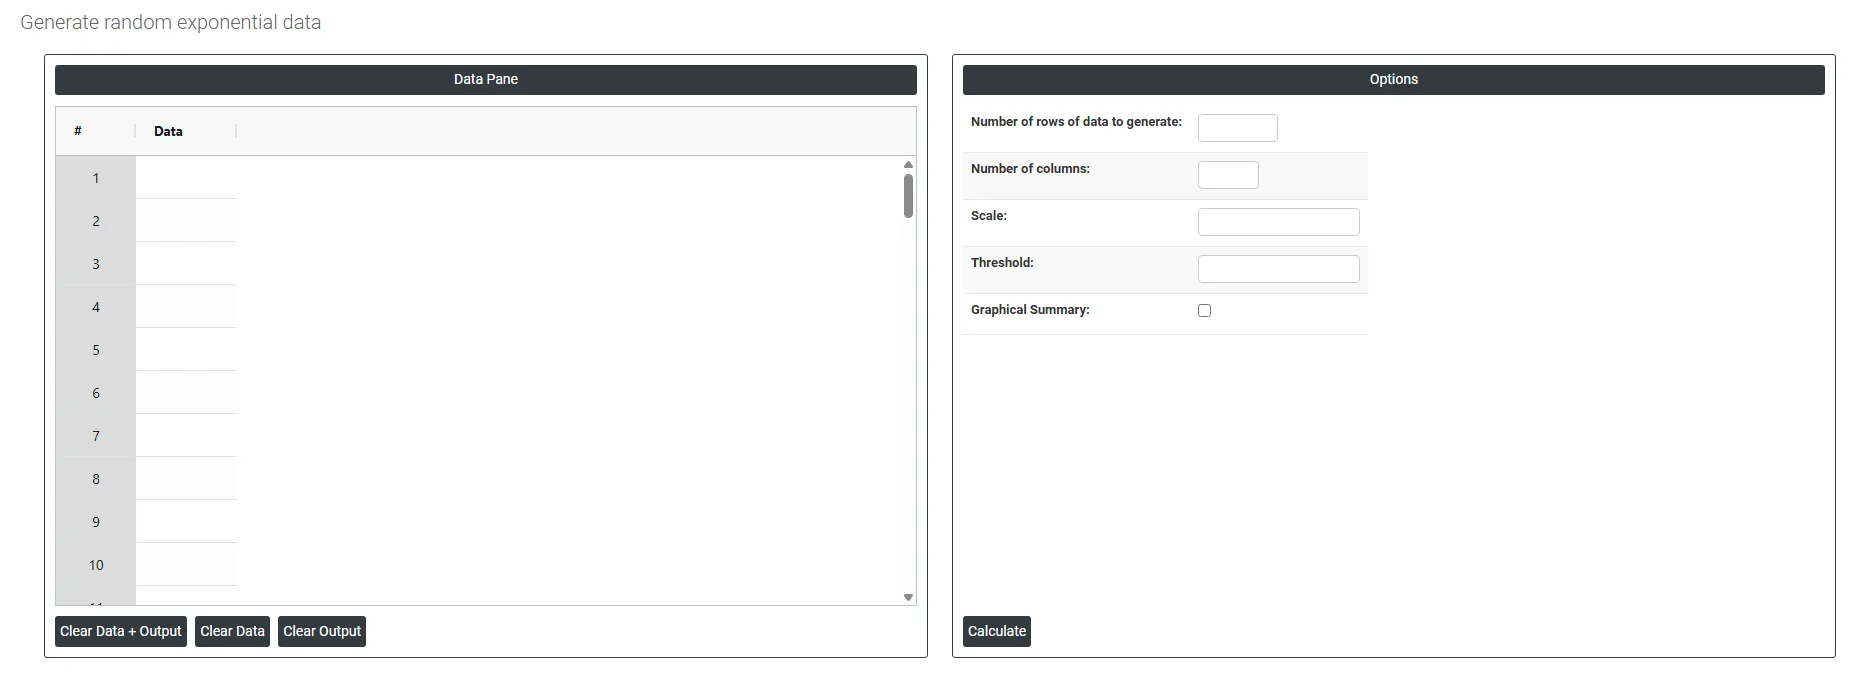
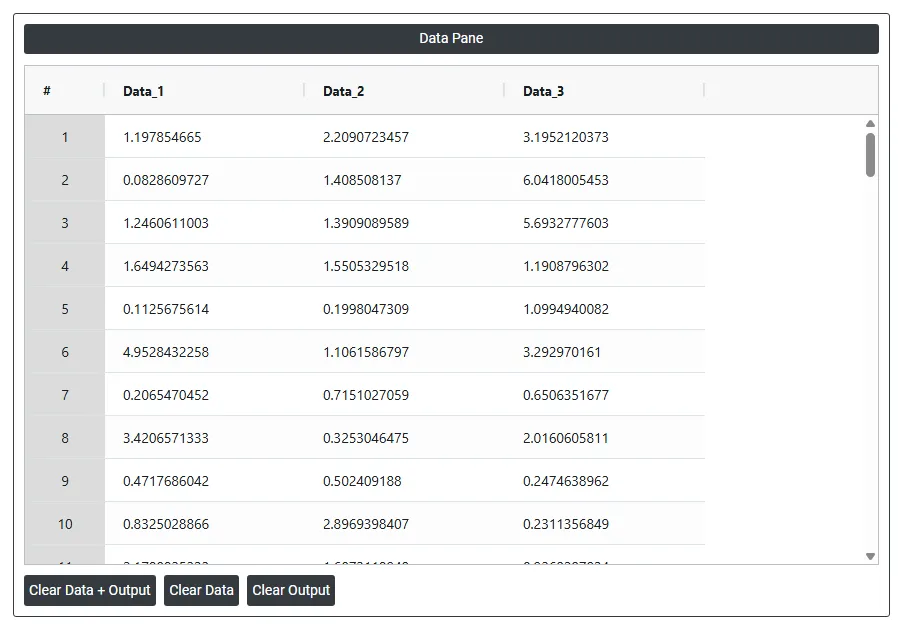
Aan de linkerkant staat de Data Pane. In de Data Pane vormt elke rij gegenereerde willekeurige gegevens. De gegevens worden gegenereerd nadat de vereiste opties zijn ingevuld.
Aan de rechterkant staan veel opties, als volgt:
- Number of rows of data to generate: Geeft aan hoeveel willekeurige datapunten worden gegenereerd. Als u bijvoorbeeld 10 invoert, ontstaan precies 10 rijen met willekeurige waarden, allemaal zichtbaar in de Data Pane.
- Number of columns: Geeft aan hoeveel variabelen (kolommen) elke rij heeft. Als u bijvoorbeeld 3 invoert, ontstaan 3 kolommen met willekeurig gegenereerde gegevens naast elkaar in de Data Pane.
- Scale: Het gemiddelde van de exponentiële verdeling, dat wil zeggen de gemiddelde tijd tussen gebeurtenissen (gelijk aan 1/frequentie). Een grotere schaalwaarde geeft grotere, meer gespreide getallen; een kleinere schaalwaarde geeft waarden die dichter bij nul clusteren. Alle gegenereerde datapunten in de Data Pane weerspiegelen deze spreiding.
- Threshold: Stelt een minimaal beginpunt voor de gegenereerde gegevens in. In plaats van bij nul te beginnen, worden de gegenereerde getallen met dit bedrag omhoog verschoven. Bij een drempel van 10 beginnen alle gegenereerde waarden bijvoorbeeld bij 10 en lopen omhoog, in plaats van vanaf 0.
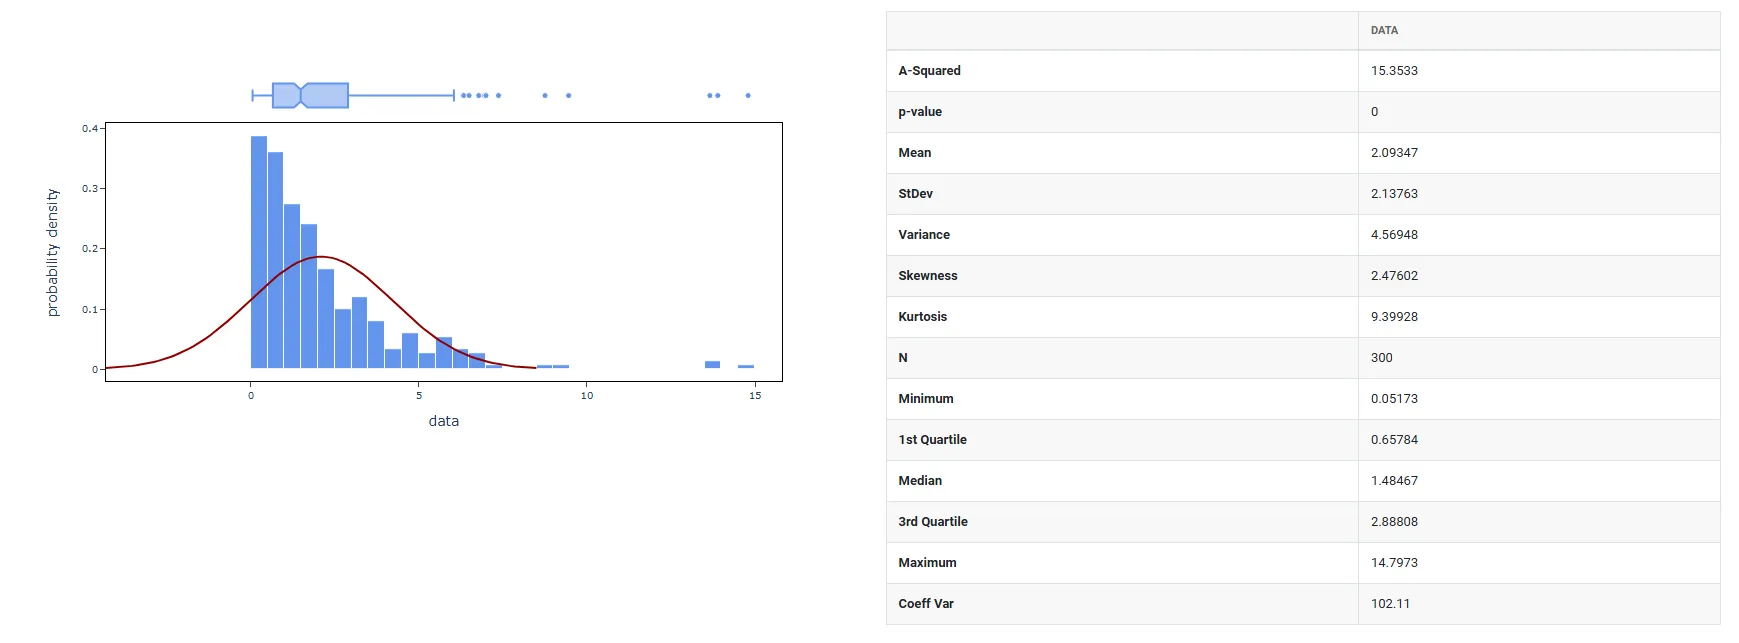
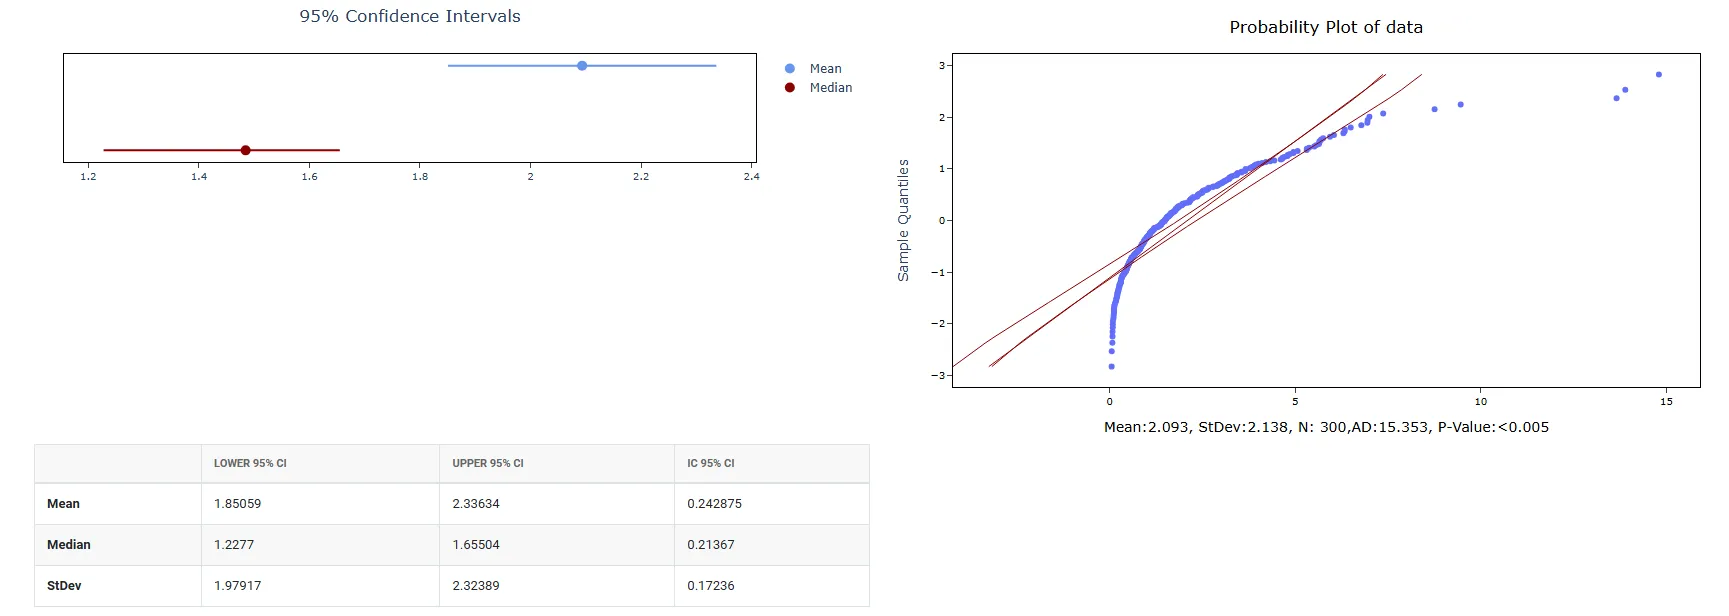
- Graphical summary: Indien geselecteerd worden alle gegenereerde waarden samengevoegd en samengevat: een histogram met een gefitte normale curve en boxplot, samenvattende statistieken, een Anderson-Darling-normaliteitstoets, een waarschijnlijkheidsplot en 95%-betrouwbaarheidsintervallen voor het gemiddelde, de mediaan en de standaardafwijking. Het is een visueel resultaat op basis van de zojuist gemaakte gegevens.
Veelgestelde vragen
Wat simuleren willekeurige exponentiële gegevens?
Willekeurige exponentiële gegevens simuleren de tijd tussen opeenvolgende onafhankelijke gebeurtenissen, zoals de tijd tussen machinestoringen, klantaankomsten of voltooide bedieningen. Ze worden veel gebruikt in betrouwbaarheidstechniek en wachtrij-analyse om te modelleren hoe lang het duurt tot de volgende storing of aankomst, en om betrouwbaarheidsanalyses te testen die uitgaan van een constante faalfrequentie.
Wanneer gebruikt u de Weibull- in plaats van de exponentiële verdeling?
De exponentiële verdeling veronderstelt een constante faalfrequentie, de geheugenloze eigenschap. Als de faalfrequentie in de tijd verandert, stijgend of dalend, gebruik dan Random Weibull Data. Voor scheve positieve metingen die niet tijdgebonden zijn, is Random Lognormal Data de betere keuze.
Wat doen de instellingen schaal en drempel bij willekeurige exponentiële gegevens?
De schaal is het gemiddelde van de exponentiële verdeling, de gemiddelde tijd tussen gebeurtenissen, gelijk aan 1/frequentie. Een grotere schaal geeft grotere, meer gespreide getallen en een kleinere schaal geeft waarden die dichter bij nul clusteren; stel haar in op de bekende gemiddelde tijd tussen gebeurtenissen uit historische gegevens. De drempel verschuift alle waarden omhoog, dus bij een drempel van 10 beginnen waarden bij 10 in plaats van bij 0.