
Willekeurige lognormale gegevens
Random Lognormal Data simuleert altijd-positieve, rechtsscheve continue metingen. U stelt het aantal rijen en kolommen in, het gemiddelde en de standaardafwijking van de gegevens zelf (niet van hun logaritme) en een optionele drempel die de waarden omhoog verschuift. De tool rekent het gemiddelde en de standaardafwijking om naar parameters op logaritmische schaal. Er wordt geen vaste seed gebruikt, dus kopieer de gegevens om ze opnieuw te gebruiken. Een optionele grafische samenvatting toont de verdeling.
Laatst beoordeeld
Belangrijkste conclusie
Random Lognormal Data genereert strikt positieve, rechtsscheve waarden waarvan de natuurlijke logaritme een normale verdeling volgt, om metingen zoals deeltjesgroottes, responstijden of concentraties te simuleren.
Op deze pagina
Wat zijn willekeurige lognormale gegevens?
Random Lognormal Data genereert waarden uit de lognormale verdeling, een rechtsscheve verdeling waarbij de natuurlijke logaritme van de gegevens een normale verdeling volgt. Het resultaat is een set altijd-positieve waarden die naar rechts scheef zijn, zoals gebruikelijk bij metingen als deeltjesgroottes, inkomensverdelingen en biologische concentraties.
Eenvoudige definitie: Genereert willekeurige positieve waarden met een rechtsscheve verdeling, natuurlijk voor metingen zoals deeltjesgroottes, responstijden en materiaalconcentraties die niet nul of negatief kunnen zijn.
Wanneer gebruikt u Random Lognormal Data?
- Gebruik het om rechtsscheve continue metingen te simuleren die altijd positief zijn.
- Gebruik het wanneer logtransformatie van uw gegevens ze bij benadering normaal maakten u realistische ruwe waarden voor een simulatie wilt genereren.
- Gebruik het bij milieu-, farmaceutische en financiële simulaties.
Richtlijnen voor correct gebruik van Random Lognormal Data
- Parameters worden op de gegevensschaal ingevoerd: het gemiddelde en de standaardafwijking zijn die van x zelf, niet van log(x); de tool rekent ze om naar de parameters op logaritmische schaal.
- Alle gegenereerde waarden zijn strikt positief.
- Er wordt geen vaste seed gebruikt, dus elke Calculate geeft nieuwe waarden; kopieer de gegenereerde gegevens als u dezelfde dataset opnieuw wilt gebruiken.
Alternatieven: wanneer u Random Lognormal Data niet gebruikt
- Als de gegevens symmetrisch en klokvormig zijn, gebruik dan Willekeurige normale gegevens
- Voor tijd tot uitval met een veranderende hazardrategebruikt u Willekeurige Weibull-gegevens
Voorbeeld van Random Lognormal Data
De volgende stappen om Random Lognormal Data te genereren:
- Om Random Lognormal Data te genereren, vult u de vereiste opties in.
- Analyseer nu de gegevens in Zometric Statistical Software op https://statsai.zometric.com/.
- Om Random Lognormal Data te vinden, kiest u Statistical module> Random Data > Random Lognormal Data
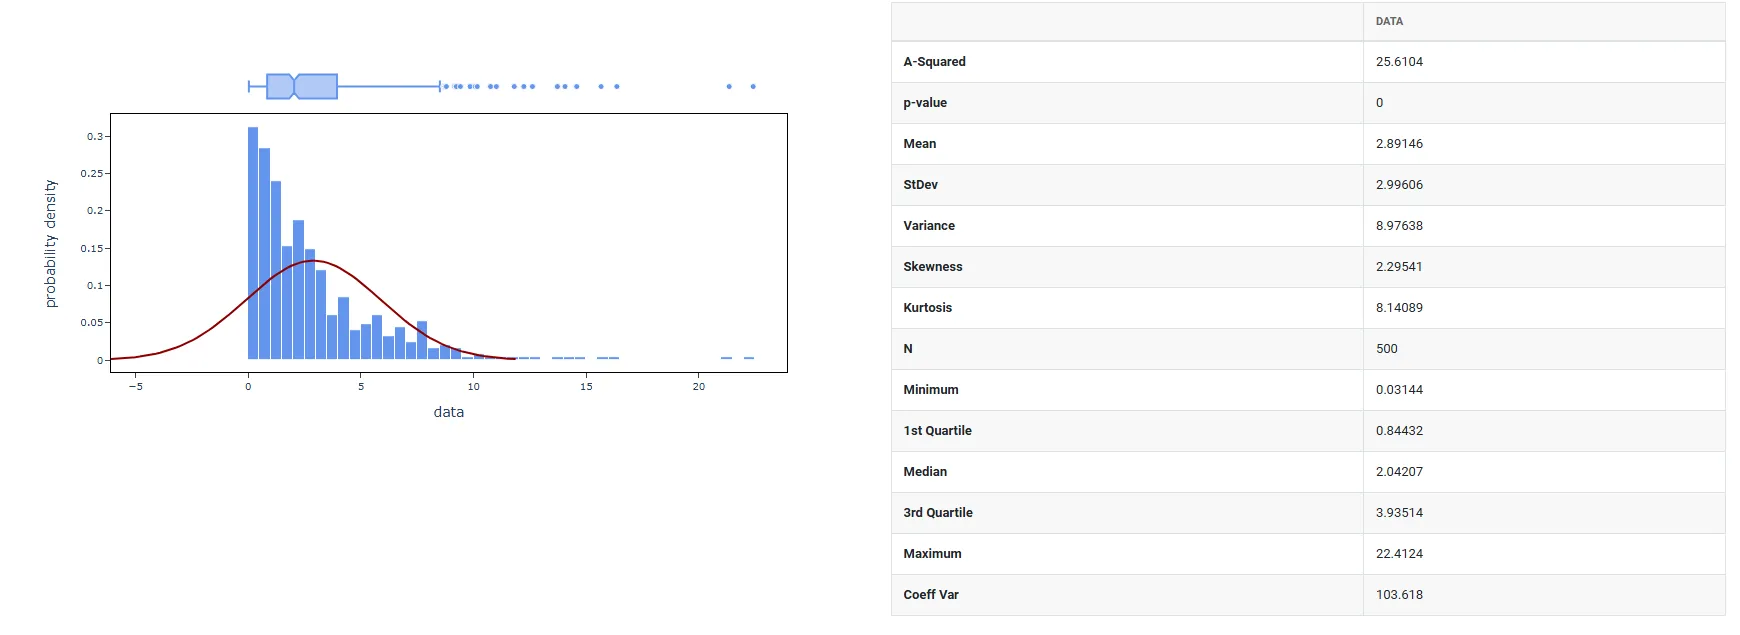
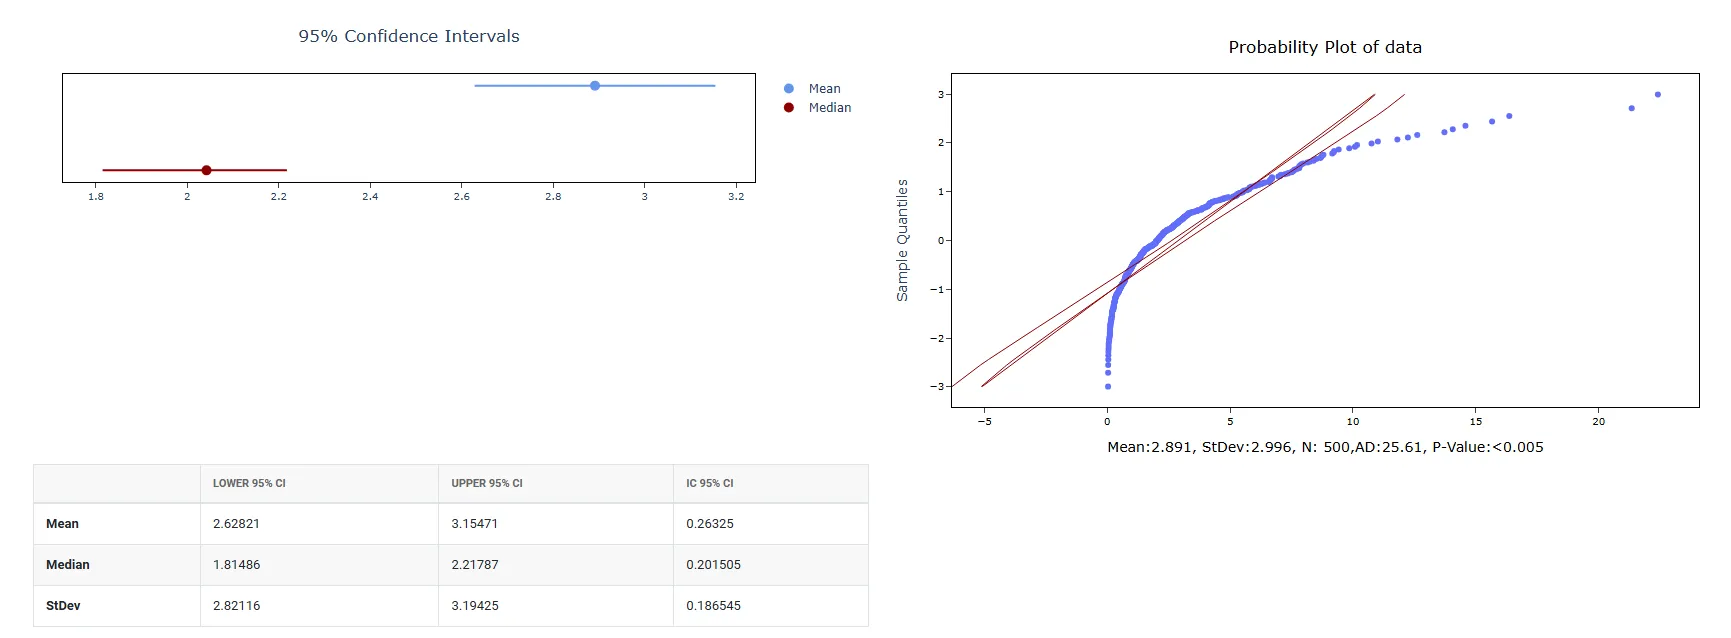
4. Na gebruik van de bovenstaande tool verschijnt de uitvoer als volgt:
Zo voert u Random Lognormal Data uit
De handleiding is als volgt:
- Log in bij Zometric Statistical Software op https://statsai.zometric.com/
- Kies op de startpagina Statistical Tool> Random Data>Random Lognormal Data.
- Vul vervolgens de vereiste opties in.
- Klik ten slotte onderaan de pagina op Calculate en u krijgt de gewenste resultaten.
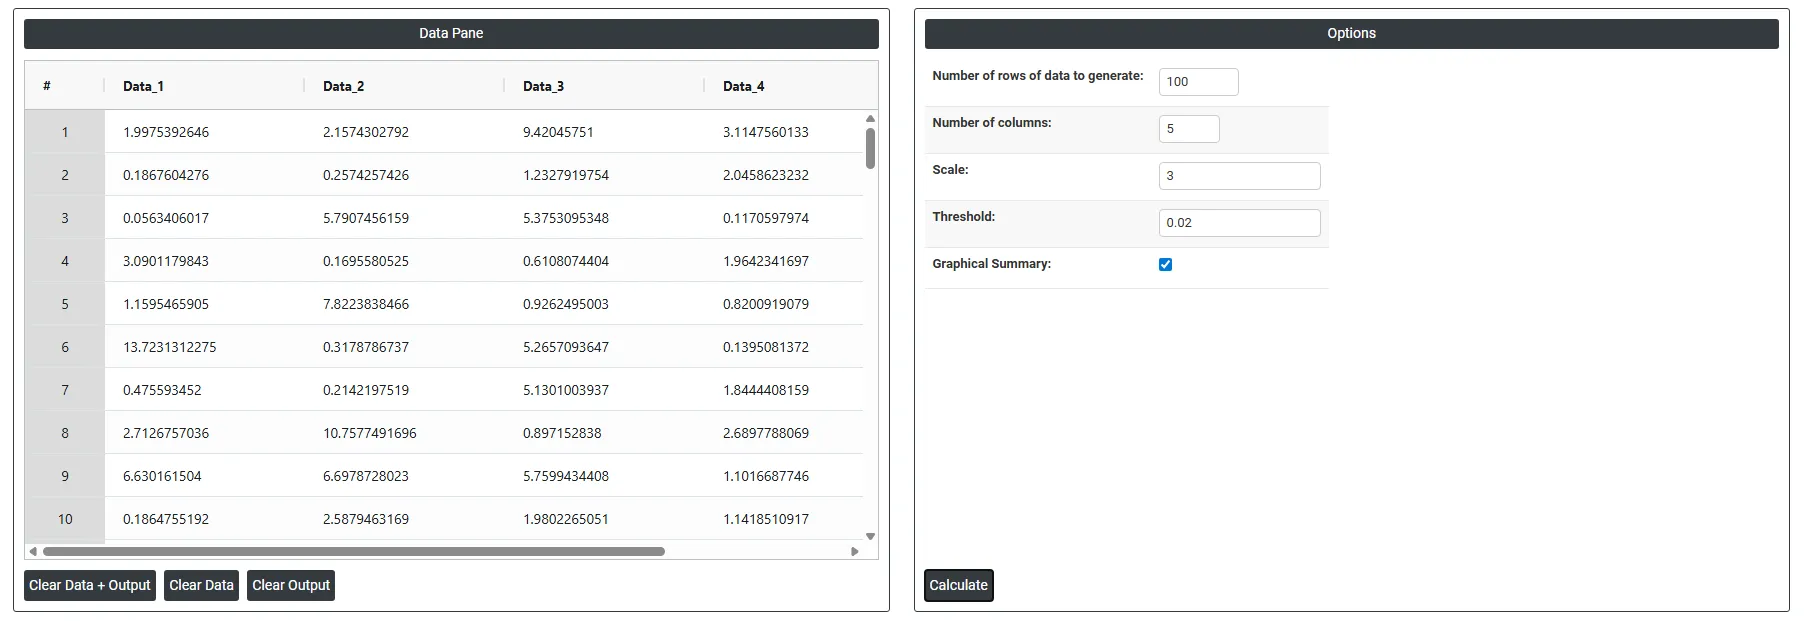
In het dashboard van Random Lognormal Data is het venster in twee delen verdeeld.
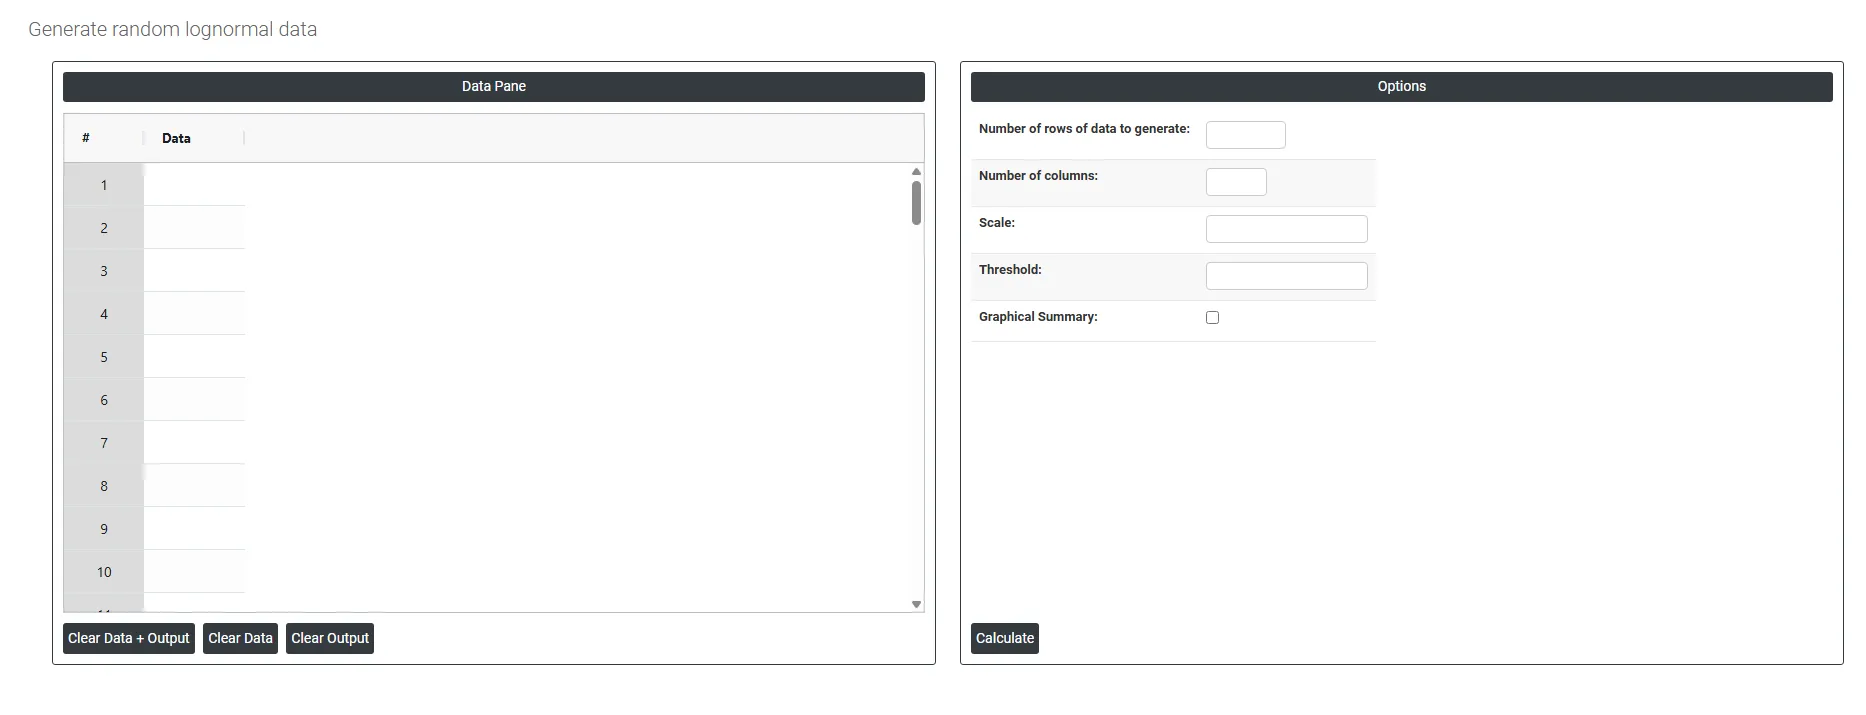
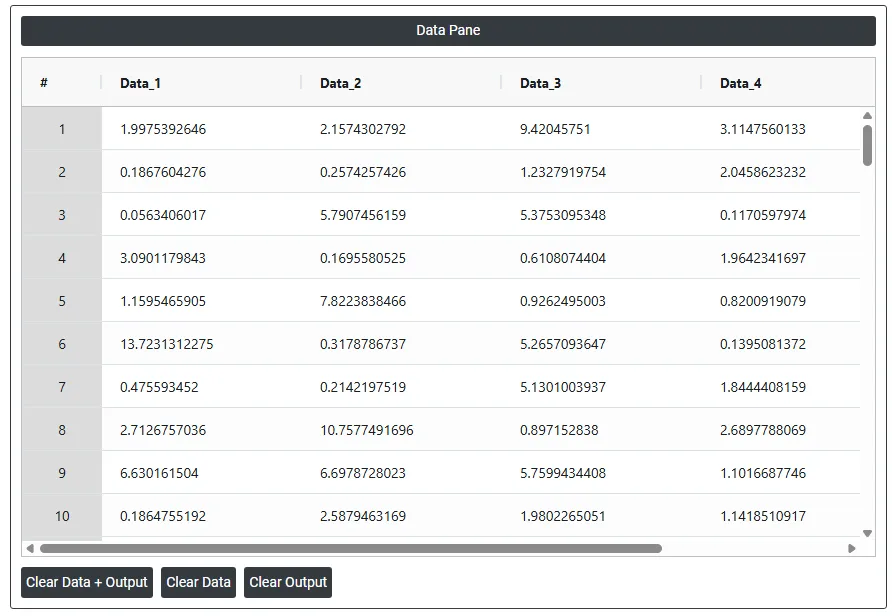
In het linkerdeel staat de Data Pane. In de Data Pane levert elke rij willekeurige gegevens op. De gegevens worden gegenereerd nadat de vereiste opties zijn ingevuld.
In het rechterdeel zijn veel opties beschikbaar, als volgt:
- Number of rows of data to generate: Bepaalt hoeveel willekeurige datapunten worden gegenereerd. Als u bijvoorbeeld 100 invoert, ontstaan precies 100 rijen met willekeurige waarden, allemaal zichtbaar in de Data Pane.
- Number of columns: Bepaalt hoeveel variabelen (kolommen) elke rij heeft. Als u bijvoorbeeld 5 invoert, ontstaan 5 kolommen met willekeurig gegenereerde gegevens naast elkaar in de Data Pane.
- Mean and Standard Deviation: Het gemiddelde en de standaardafwijking van de gegenereerde gegevens zelf (niet van hun logaritmen). De tool rekent ze om naar de parameters op logaritmische schaal σ = √ln(1 + (s/m)²) en μ = ln(m) − σ²/2. Een grotere standaardafwijking ten opzichte van het gemiddelde levert sterker rechtsscheve waarden op.
- Threshold: Stelt een minimaal beginpunt voor de gegenereerde gegevens in. In plaats van bij nul te beginnen, worden de gegenereerde getallen met dit bedrag omhoog verschoven. Bij een drempel van 10 beginnen alle gegenereerde waarden bijvoorbeeld bij 10 en lopen ze omhoog, in plaats van bij 0.
- Graphical summary: Nadat de willekeurige gegevens zijn gegenereerd met het opgegeven gemiddelde en de opgegeven standaardafwijking, levert deze optie een grafische analyse van die gegevens op, zoals een histogram dat toont hoe de gegenereerde waarden verdeeld zijn. Het is een visueel resultaat op basis van de zojuist gemaakte gegevens.
Veelgestelde vragen
Wat is een lognormale verdeling?
Een lognormale verdeling is een rechtsscheve verdeling waarin de natuurlijke logaritme van de gegevens een normale verdeling volgt. De waarden zijn altijd positief, wat past bij metingen zoals deeltjesgroottes, responstijden, inkomen en biologische of materiaalconcentraties die niet nul of negatief kunnen zijn.
Wanneer genereert u willekeurige lognormale gegevens?
Gebruik het om rechtsscheve continue metingen te simuleren die altijd positief zijn, of wanneer logtransformatie van uw gegevens ze bij benadering normaal maakt en u realistische ruwe waarden voor een simulatie wilt. Het is gebruikelijk bij milieu-, farmaceutische en financiële simulaties. Zijn de gegevens symmetrisch en klokvormig, gebruik dan Random Normal Data; voor tijd tot uitval met een veranderende hazardrate gebruikt u Random Weibull Data.
Worden het lognormale gemiddelde en de standaardafwijking op logaritmische schaal ingevoerd?
Nee. In deze tool zijn het gemiddelde en de standaardafwijking die van de gegenereerde gegevens zelf, niet van hun logaritmen. De tool rekent ze om naar de parameters op logaritmische schaal σ = √ln(1 + (s/m)²) en μ = ln(m) − σ²/2. Een grotere standaardafwijking ten opzichte van het gemiddelde levert sterker rechtsscheve waarden op, en een optionele drempel verschuift alle waarden omhoog.
Kunt u dezelfde willekeurige lognormale dataset opnieuw genereren?
Er wordt geen vaste seed gebruikt, dus elke Calculate levert nieuwe willekeurige waarden op. Als u dezelfde dataset opnieuw wilt gebruiken, bijvoorbeeld om een analyse te herhalen of met collega's te delen, kopieert u de gegenereerde gegevens uit de Data Pane voordat u opnieuw rekent. Alle gegenereerde waarden zijn strikt positief.