
Enkelvoudige exponentiële afvlakking
Enkelvoudige exponentiële afvlakking (Single Exponential Smoothing) effent een tijdreeks met St = alpha·yt + (1 - alpha)·St-1 en voorspelt het laatste afgevlakte niveau voor elke toekomstige periode. Gebruik haar voor reeksen die rond een vaste waarde schommelen zonder trend of seizoen. De reeks mag geen hiaten hebben en moet minstens 4 waarden bevatten. De uitvoer bestaat uit fits, voorspellingen met voorspellingsgrenzen en MAPE, MAD en MSD.
Laatst beoordeeld
Belangrijkste conclusie
Enkelvoudige exponentiële afvlakking effent een tijdreeks met één niveau dat elke periode wordt bijgewerkt met een aandeel (alpha) van de laatste fout en voorspelt dat niveau; geschikt voor reeksen zonder trend of seizoen.
Op deze pagina
Doel
Enkelvoudige exponentiële afvlakking (Single Exponential Smoothing) effent een tijdreeks met één lopend niveau dat elke periode wordt bijgewerkt met een aandeel van de laatste fout en voorspelt dat niveau voor elke toekomstige periode. Ze past bij een reeks die rond een tamelijk vaste waarde schommelt zonder duidelijke trend of seizoen, zoals de wekelijkse vraag naar een volwassen reserveonderdeel, een dagelijks uitvalpercentage of het vulgewicht van een stabiele lijn. Gebruik voor gegevens met een trend dubbele exponentiële afvlakking; gebruik voor gegevens met een seizoen de Winters-methode of decompositie.
Belangrijkste mogelijkheden
- Afvlakkingsgewicht (alpha) dat u opgeeft, of het optimale gewicht uit een ARIMA(0,1,1)-fit wanneer het leeg blijft.
- Startwaarde uit de gegevens of een waarde die u zelf invoert.
- Voorspellingen met voorspellingsgrenzen op het betrouwbaarheidsniveau dat u kiest, vanaf het einde van de reeks of vanaf een eerdere rij om de methode te testen tegen bekende gegevens.
- Nauwkeurigheidsmaten MAPE, MAD en MSD, en een plot van de gegevens, fits en voorspellingen.
- Optionele resultatentabel (afgevlakte waarde, voorspelling en fout voor elke periode) en residuplots vier-in-één.
Statistische methoden
De afgevlakte waarde is Sₜ = α·yₜ + (1 − α)·Sₜ₋₁. De fit (voorspelling één stap vooruit) voor periode t is Sₜ₋₁, de afgevlakte waarde aan het einde van de voorgaande periode, en de fout is yₜ min die fit. Een kleine α (bijv. 0.1–0.3) geeft een gladde lijn die langzaam reageert; een grote α volgt de laatste waarden nauwgezet.
Bij een opgegeven gewicht is de startwaarde S₀ het gemiddelde van de eerste K waarnemingen (standaard K = 6). Wanneer het gewicht leeg blijft, fit de tool een ARIMA(0,1,1)-model op de eerste verschillen met kleinste kwadraten en stelt α = 1 − θ, waarbij θ de MA-coëfficiënt is; de startwaarde komt dan uit die fit. Deze optimale α kan boven 1 uitkomen, wat betekent dat het niveau overreageert op elke nieuwe waarde; beschouw dat als teken dat de reeks een trend heeft. Met Starting values = User-specified wordt het door u ingevoerde Initial level als S₀ gebruikt.
Alle voorspellingen zijn gelijk aan de laatste afgevlakte waarde bij de voorspellingsoorsprong. De voorspellingsgrenzen zijn voorspelling ± z × 1.25 × MAD, waarbij z het normale kwantiel voor het betrouwbaarheidsniveau is en MAD de gemiddelde absolute fout van de fits; ze hebben voor elke periode vooruit dezelfde breedte. Nauwkeurigheid: MAPE = gemiddelde |fout / gegeven| × 100, MAD = gemiddelde |fout|, MSD = gemiddelde fout². De reeks mag geen hiaten hebben en moet minstens 4 waarden bevatten.
Invoervelden en opties
Veld | Beschrijving |
Variable (Y) | Vereist. De numerieke reeks, in tijdsvolgorde. |
Weight to use in smoothing (alpha) | 0.0001 tot 1. Laat leeg om het optimale ARIMA(0,1,1)-gewicht te gebruiken. |
Starting values | From the data (standaard): het optimale gewicht start vanuit de ARIMA-fit; een opgegeven gewicht vanuit het gemiddelde van de eerste K waarnemingen. Of User-specified. |
Initial level | Gebruikt wanneer Starting values op User-specified staat (dan vereist). |
Initial smoothed value: average of first K observations, K = | Standaard 6. Actief wanneer een gewicht is ingevoerd. |
Number of forecasts | Standaard 0 (geen), tot 1000. |
Confidence level (%) for forecast interval | Standaard 95. Actief wanneer voorspellingen worden gevraagd. |
Forecast origin (row) | Optioneel, actief wanneer voorspellingen worden gevraagd. Voorspellingen beginnen na deze rij, met de gegevens tot en met die rij; leeg = einde van de reeks. |
Results to display | Summary table (standaard) of Summary table and results table. |
Residual plots (four in one) | Standaard niet aangevinkt. Normale waarschijnlijkheidsplot, residuen tegen fits, histogram en residuen tegen volgorde. |
Title | Titel van de uitvoer. Standaard Single Exponential Smoothing. |
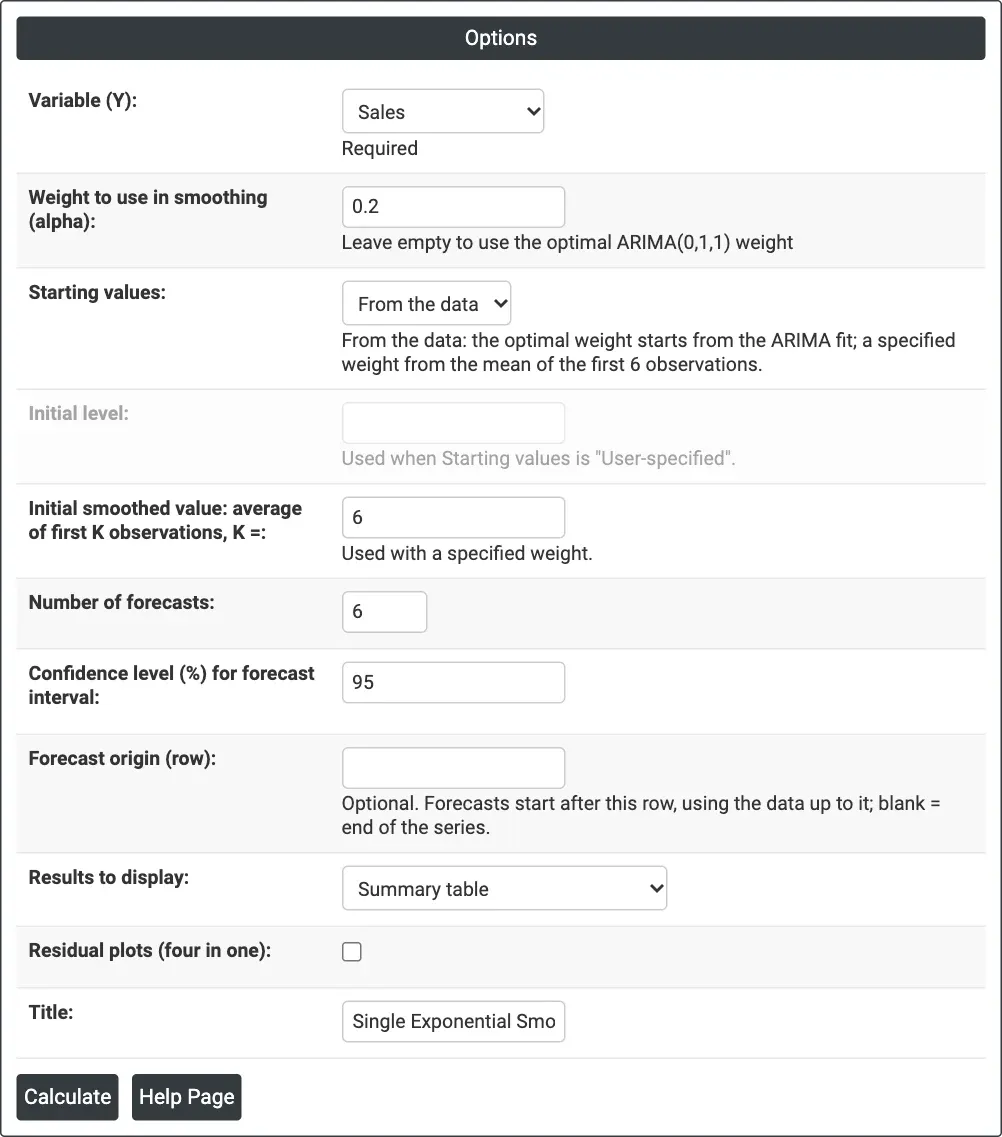
Figure 1 — Monthly Sales afgevlakt met alpha = 0.2 en zes voorspellingen.
Beschrijving van de uitvoer
- Single Exponential Smoothing (graph) — werkelijke gegevens, fits, voorspellingen en de voorspellingsband, met MAPE, MAD en MSD in de titel en het gebruikte gewicht boven de plot.
- Method — gegevenskolom, lengte en of het gewicht is opgegeven of optimaal is (plus de voorspellingsoorsprong wanneer die is ingesteld).
- Smoothing Constants — de gebruikte waarde van α.
- Accuracy Measures — MAPE, MAD en MSD.
- Forecasts — periode, voorspelling, onderste en bovenste grens.
- Results — wanneer gekozen: Period, data, Smooth, Predict en Error voor elke periode.
- Residual Plots — wanneer aangevinkt.
- PDF-export via Download.
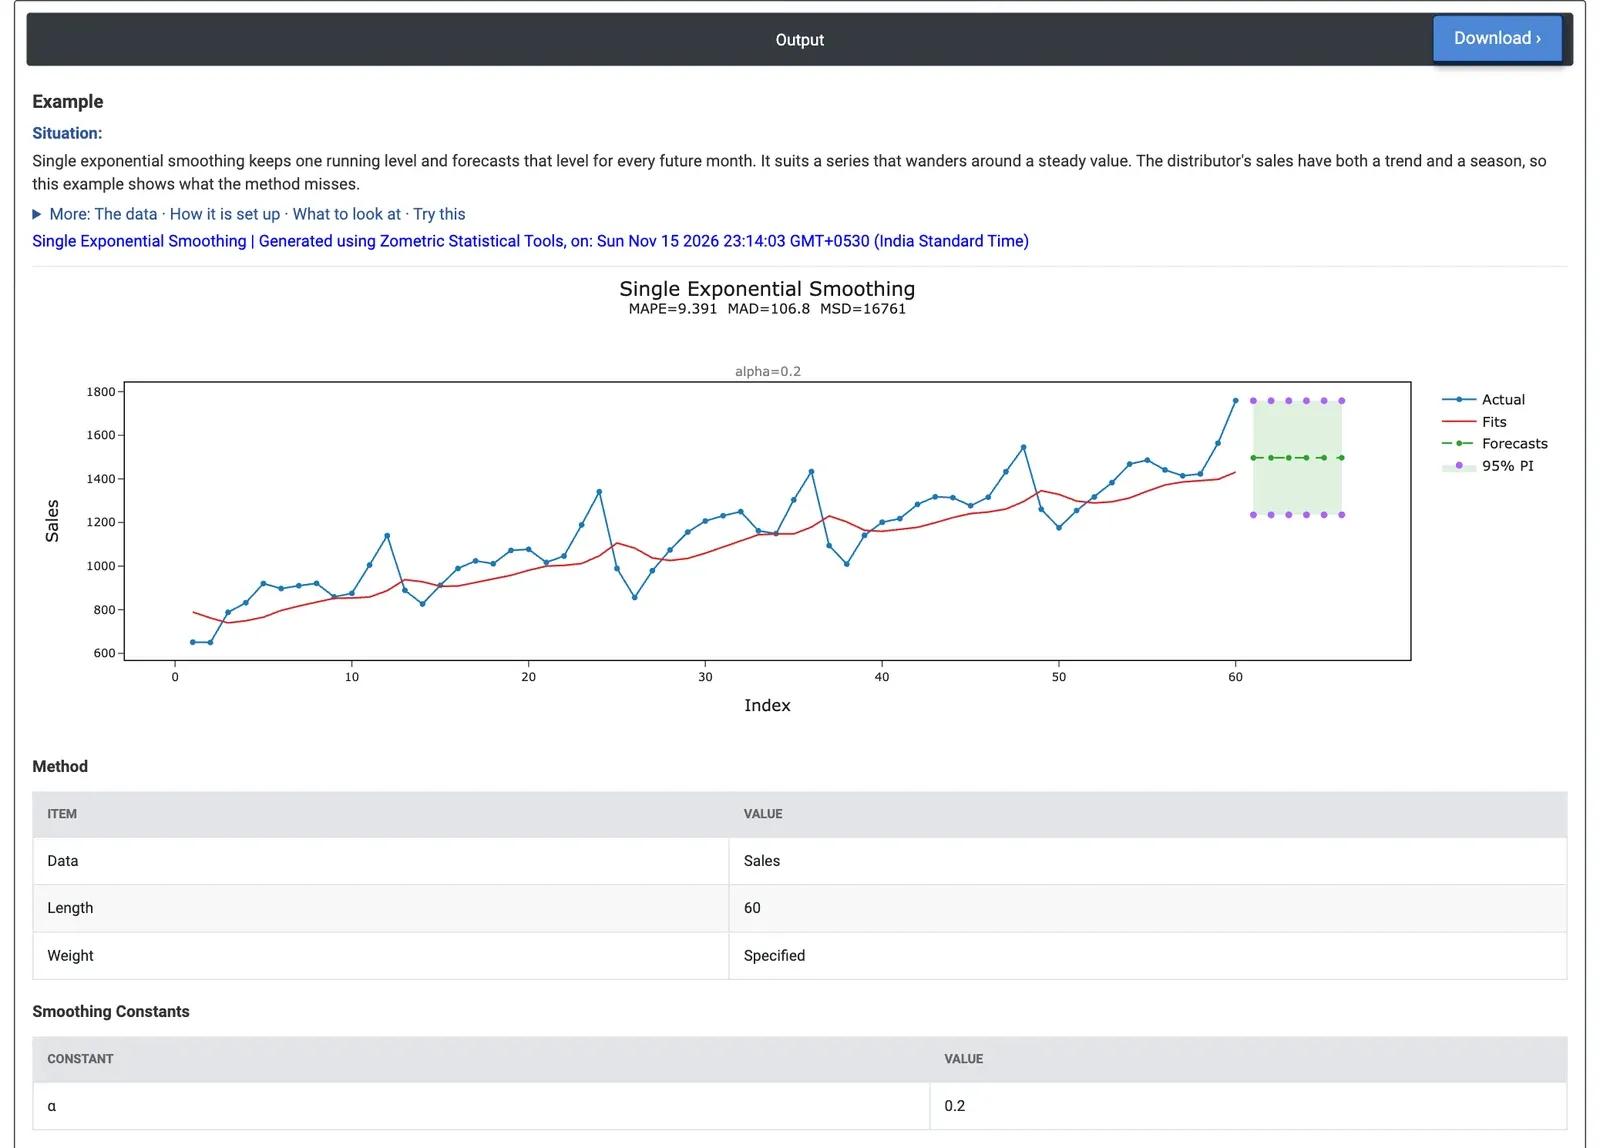
Figure 2 — De afgevlakte lijn blijft achter bij de groeiende verkopen en alle zes voorspellingen zijn gelijk, 1,496.7.
Uitgewerkt voorbeeld
Een distributeur van consumentenelektronica heeft de verkochte eenheden over 60 maanden (januari 2020 tot en met december 2024). De verkoopanalist probeert eerst de eenvoudigste voorspelmethode om te zien wat die mist. De analist selecteert Variable (Y) = Sales, voert Weight to use in smoothing (alpha) = 0.2 in, behoudt Starting values = From the data en K = 6, en stelt Number of forecasts = 6 in voor januari tot en met juni 2025.
Alle zes voorspellingen zijn gelijk: 1,496.7 eenheden, met een 95%-interval van 1,234.9 tot 1,758.4. De methode heeft geen trend of seizoen, dus ze ziet niet dat de verkopen groeien en dat januari en februari altijd zwak zijn. In de plot blijft de afgevlakte lijn achter bij de stijgende gegevens en snijdt ze door de pieken en dalen. MAPE is 9.4% (MAD 106.8 eenheden), de zwakste fit van de voorspelmethoden voor deze gegevens: de Winters-methode haalt 4.2% en decompositie 2.2%.
Wanneer alpha leeg blijft, is het optimale ARIMA-gewicht 1.43, boven 1: het niveau overreageert op elke maand in een poging de groei bij te benen. MAPE daalt naar 6.7%, maar elke maand van 2025 wordt dan voorspeld op 1,817, het niveau dat de decemberpiek achterlaat. Beide resultaten zeggen voor de beslissing hetzelfde: deze reeks heeft een methode met trend en seizoen nodig. Enkelvoudige afvlakking is alleen het juiste hulpmiddel wanneer de gegevens geen van beide hebben.
Veelgestelde vragen
Wanneer gebruikt u enkelvoudige exponentiële afvlakking?
Gebruik enkelvoudige exponentiële afvlakking voor een reeks die rond een tamelijk vaste waarde schommelt zonder duidelijke trend of seizoen, zoals de wekelijkse vraag naar een volwassen reserveonderdeel, een dagelijks uitvalpercentage of het vulgewicht van een stabiele lijn. Gebruik voor gegevens met een trend dubbele exponentiële afvlakking; gebruik voor gegevens met een seizoen de Winters-methode of decompositie.
Hoe kiest u het afvlakkingsgewicht alpha?
Een kleine alpha, zoals 0.1 tot 0.3, geeft een gladde lijn die langzaam reageert, terwijl een grote alpha de laatste waarden nauwgezet volgt. Als alpha leeg blijft, komt het optimale gewicht uit een ARIMA(0,1,1)-fit, met alpha = 1 min de MA-coëfficiënt. Een optimale alpha boven 1 is een teken dat de reeks een trend heeft.
Waarom zijn alle voorspellingen van enkelvoudige exponentiële afvlakking gelijk?
Alle voorspellingen zijn gelijk aan de laatste afgevlakte waarde bij de voorspellingsoorsprong, omdat de methode alleen een niveau heeft en geen trend- of seizoenscomponent. De voorspellingsgrenzen zijn de voorspelling plus of min z maal 1.25 maal MAD, dus ook die hebben voor elke periode vooruit dezelfde breedte.
Hoe wordt de nauwkeurigheid van voorspellingen gemeten?
De nauwkeurigheid wordt gerapporteerd met drie maten, gebaseerd op de fouten tussen de gegevens en de fits één stap vooruit: MAPE, de gemiddelde absolute procentuele fout; MAD, de gemiddelde absolute fout; en MSD, de gemiddelde kwadratische fout. Lagere waarden wijzen op een betere fit en ze kunnen worden gebruikt om voorspelmethoden op dezelfde gegevens te vergelijken.