
3D-oppervlakteplot (3D Surface Plot)
De 3D Surface Plot tekent een respons Z over twee numerieke variabelen X en Y, bijvoorbeeld opbrengst over temperatuur en tijd. Gebruik haar om proefopzetten of procesonderzoeken met twee instellingen te verkennen en bedrijfsvensters te kiezen. Het oppervlak interpoleert de gegevens in plaats van een model te fitten, met Akima-interpolatie voor rastergegevens en de methoden Distance of Akima voor verspreide punten.
Laatst beoordeeld
Belangrijkste conclusie
Een 3D-oppervlakteplot tekent een respons Z als oppervlak over twee variabelen X en Y en toont waar de respons piekt of daalt en of het beste gebied een scherp punt of een breed plateau is.
Op deze pagina
Doel
De 3D Surface Plot tekent een respons Z als oppervlak over twee variabelen X en Y, bijvoorbeeld opbrengst over temperatuur en reactietijd. Ze toont waar de respons piekt of daalt, hoe steil ze verandert en of het beste gebied een scherp punt of een breed plateau is. Gebruik haar om resultaten van een proefopzet of een procesonderzoek met twee instellingen te verkennen en om bedrijfsvensters te kiezen. De plot kan met de muis worden gedraaid en ingezoomd.
Belangrijkste mogelijkheden
- Oppervlak uit rastergegevens (elke X/Y-combinatie aanwezig) of uit verspreide X/Y-punten.
- Twee interpolatiemethoden voor verspreide gegevens: Distance (gewichten met inverse afstand) of de polynoommethode van Akima.
- Automatische of door de gebruiker ingestelde maaswijdte.
- Weergave-elementen die u kunt combineren: oppervlak, draadmodel, datapunten (symbolen), projectielijnen van elk punt naar de basis en contourlijnen geprojecteerd op het oppervlak.
- Keuze uit een kleurenschaal, met een kleurenbalk voor Z.
Statistische methoden
Het oppervlak is een interpolatie van de gegevens, geen gefit model. Wanneer elke X/Y-combinatie aanwezig is (rastergegevens, gelijke of ongelijke tussenruimte; herhalingen gemiddeld), wordt de lokale kubische interpolatie van Akima toegepast door het raster langs Y en daarna langs X op een fijne maas (tot 201 punten per as). Het oppervlak loopt door elk gemeten punt; de interpolatiemethode, de afstandsmacht en de maasinstellingen hebben geen effect op rastergegevens.
Voor verspreide gegevens wordt de respons geschat op een X × Y-maas (standaard 15 × 15) die het bereik van de gegevens beslaat. De methode Distance gebruikt het inverse-afstandsgewicht van Shepard, ẑ = Σ(zᵢ / dᵢᵖ) / Σ(1 / dᵢᵖ), waarbij dᵢ de afstand is van het maasknooppunt tot datapunt i en p de Distance Power (standaard 2): hogere machten geven nabije punten meer gewicht. Schattingen blijven altijd binnen het bereik van de gegevens. Met Standardize X and Y aangevinkt worden X en Y eerst geschaald naar −1 tot 1, zodat een variabele met een groot numeriek bereik de afstanden niet domineert. De methode van Akima fit gladde lokale polynomen over een triangulatie van de punten; ze geeft een gladder oppervlak maar kan de gegevens over- of onderschrijden, vooral buiten de buitenste punten, waar de Boundary z-value (of de laagste geschatte Z) wordt gebruikt.
Omdat het oppervlak alleen interpoleert, kunnen kleine bulten uit meetspreiding komen. Om met vertrouwen een optimum te schatten, fit u een responsoppervlakmodel (DOE-responsoppervlak of regressie) en gebruikt u het gefitte oppervlak daarvan.
Invoervelden en opties
Veld | Beschrijving |
X Variable / Y Variable | Vereist. Numerieke kolommen voor de twee horizontale assen. |
Z Variable (Response) | Vereist. Numerieke respons die als hoogte en kleur wordt getekend. |
Interpolation Method | Distance Method (standaard) of Akima's Polynomial Method. Genegeerd voor rastergegevens. |
Distance Power | Standaard 2.0. Alleen voor de methode Distance; hogere machten geven nabije punten meer gewicht. |
Standardize X and Y data | Standaard aangevinkt. Alleen voor de methode Distance. |
Boundary z-value | Optioneel. Alleen voor de methode van Akima: Z die buiten de buitenste datapunten wordt gebruikt; leeg gebruikt de laagste geschatte Z. |
Automatic Mesh / X mesh size (columns) / Y mesh size (rows) | Automatic Mesh standaard aangevinkt (15 × 15). Haal het vinkje weg om de maaswijdten in te stellen (2 tot 500). Genegeerd voor rastergegevens. |
Surface / Wireframe / Symbols (data points) / Project lines / Project contours on surface | Weergave-elementen. Surface en Project contours on surface zijn standaard aangevinkt; minstens een van Surface, Wireframe, Symbols of Project lines moet zijn aangevinkt. |
Color scale | Kleurenschaal van het oppervlak. Standaard Viridis. |
Title | Optioneel. Indien leeg gelaten (de standaard) heeft de plot de titel “Surface Plot of Z vs Y, X” met de kolomnamen; anders de ingevoerde tekst. |
Data Options: Subset (optional) | Exclude matching rows (standaard) of Include only matching rows; Row numbers (bijv. 3,7,12-15) en/of een Condition (bijv. Temperature_C <= 200) selecteren de rijen. |
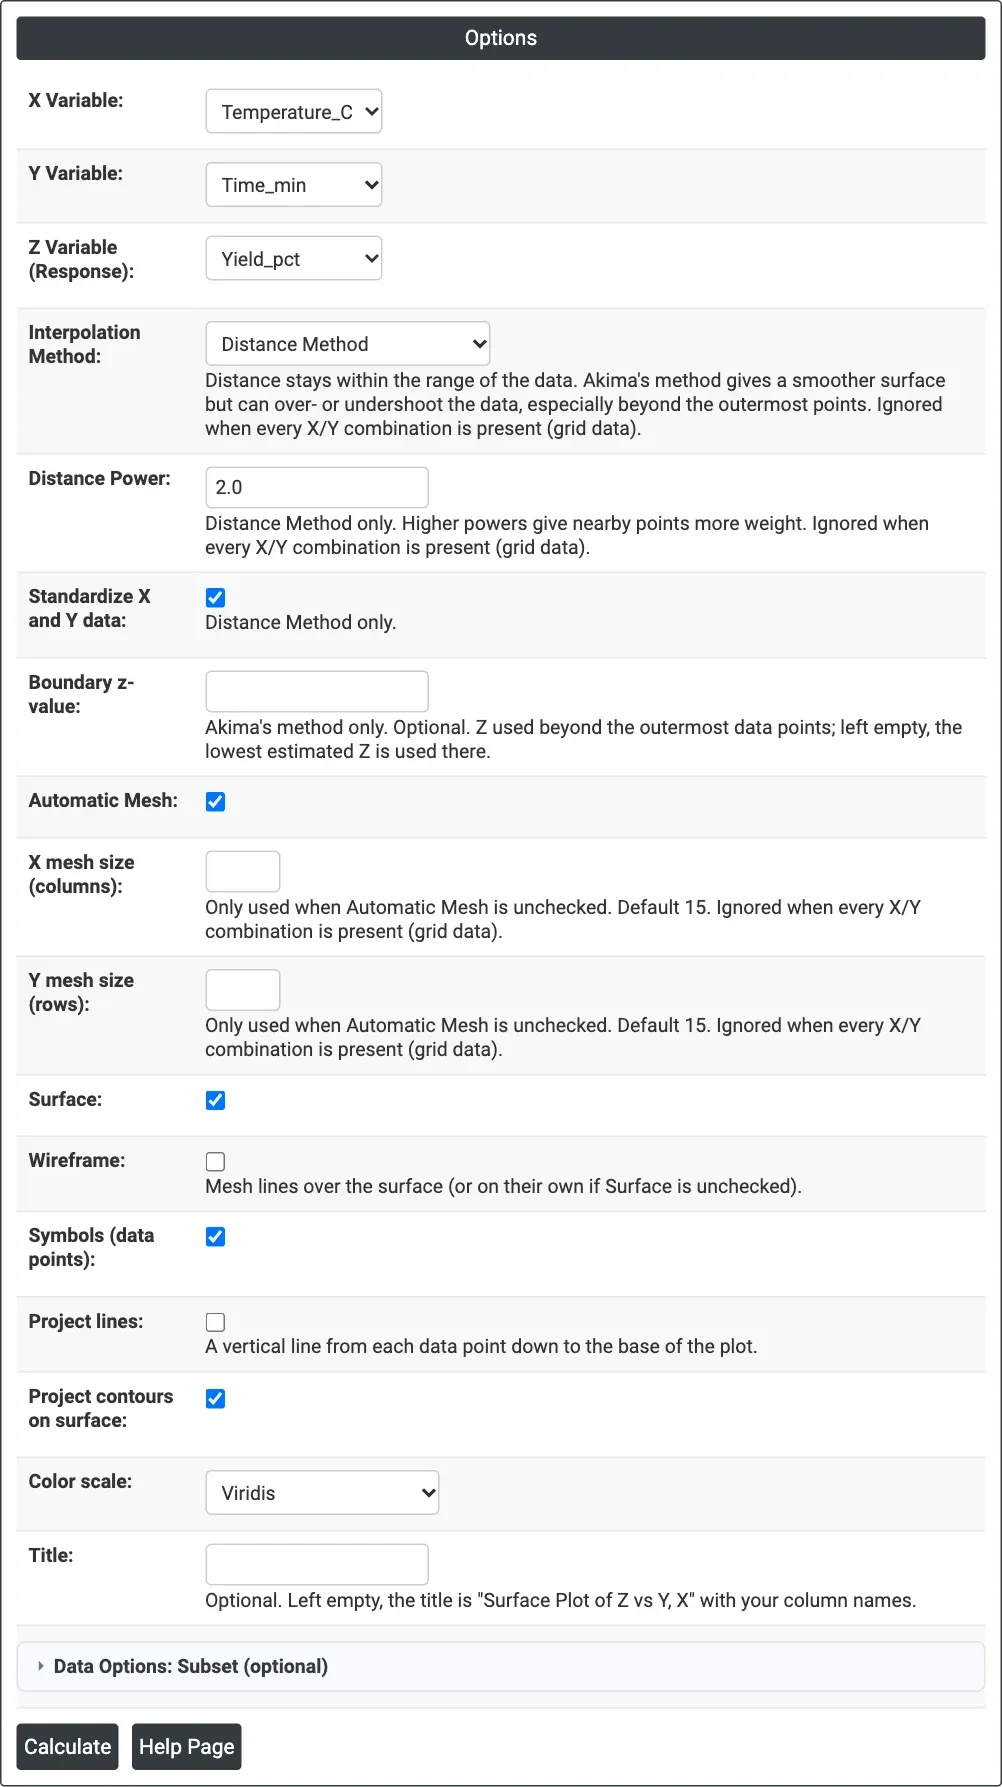
Figuur 1 — Opties voor het voorbeeld: Yield_pct over Temperature_C en Time_min, met het oppervlak, datapunten en geprojecteerde contouren.
Beschrijving van de uitvoer
- Surface Plot of <Z> vs <Y>, <X> — het 3D-oppervlak met een kleurenbalk voor Z, plus het draadmodel, de datapunten, projectielijnen en contouren die zijn aangevinkt; sleep om te draaien, scroll om te zoomen, beweeg de muis eroverheen om waarden af te lezen.
- PDF-export via Download.
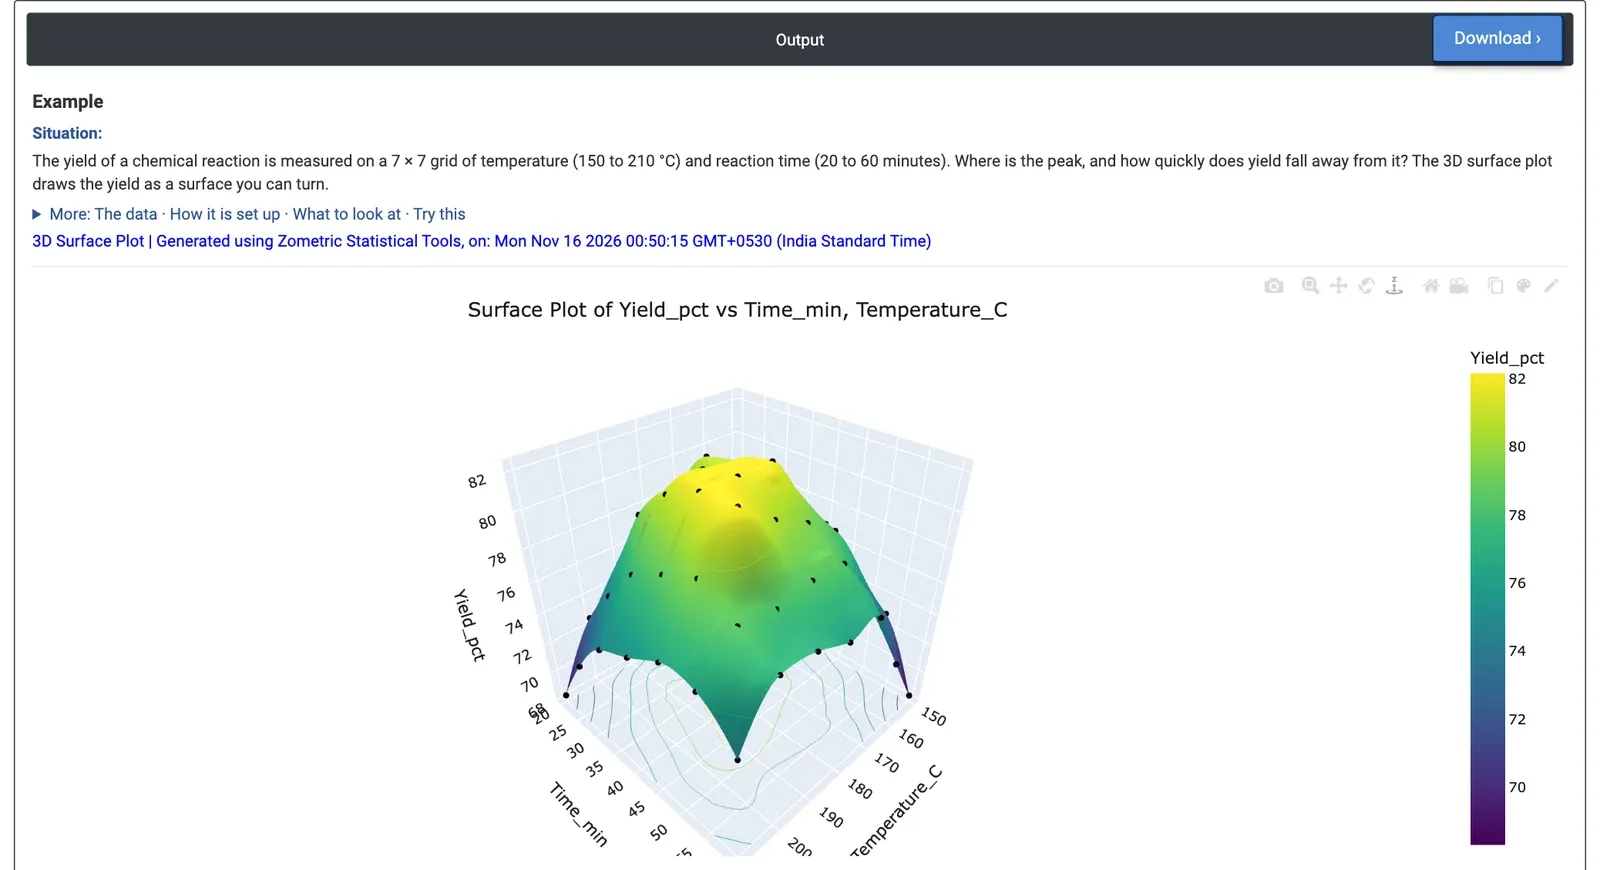
Figuur 2 — Opbrengst van een reactie over een 7 × 7-raster van temperatuur en tijd: een koepel met een brede vlakke top, datapunten weergegeven als stippen.
Uitgewerkt voorbeeld
Een procesingenieur meet de opbrengst van een chemische reactie op een 7 × 7-raster: temperaturen van 150 tot 210 °C in stappen van 10 graden en reactietijden van 20 tot 60 minuten, in totaal 49 runs. De vragen zijn waar de opbrengst piekt en hoe snel ze afneemt. X Variable = Temperature_C, Y Variable = Time_min, Z Variable = Yield_pct, met Surface, Symbols en Project contours on surface aangevinkt.
Het oppervlak is een koepel: de opbrengst is het hoogst in het midden van het raster en neemt af naar elke rand. De top is vlak. Vijf instellingen tussen 170 en 190 °C en 33.3 tot 46.7 minuten geven allemaal 81.4% tot 82.0%, waarbij de hoogst gemeten waarde 81.99% is bij 190 °C en 46.7 minuten; het geïnterpoleerde oppervlak piekt op ongeveer 82.2% rond 188 °C en 42 minuten. De laagste opbrengsten liggen in twee tegenoverliggende hoeken: 68.30% bij 150 °C en 60 minuten, en 68.32% bij 210 °C en 20 minuten. Omdat de gegevens een volledig raster vormen, loopt het oppervlak door elk gemeten punt, en de kleine bulten op de top weerspiegelen meetspreiding en geen afzonderlijke pieken.
Voor de productie betekent dit dat er een breed bedrijfsvenster is rond 170 tot 190 °C en 35 tot 45 minuten, zodat het team daarbinnen de goedkoopste of snelste instelling kan kiezen zonder opbrengst te verliezen. Verder daarbuiten kost meer opbrengst in de hoeken waar hoge temperatuur samenkomt met korte tijd, of lage temperatuur met lange tijd. De Contourplot op dezelfde kolommen toont hetzelfde venster als een vlakke kaart.
Veelgestelde vragen
Wanneer gebruikt u een 3D-oppervlakteplot?
Gebruik een 3D-oppervlakteplot om resultaten van een proefopzet of een procesonderzoek met twee instellingen, zoals temperatuur en reactietijd, te verkennen. Ze toont waar de respons piekt of daalt, hoe steil ze verandert en of het beste gebied een scherp punt of een breed plateau is, wat helpt bij het kiezen van bedrijfsvensters.
Is een oppervlakteplot hetzelfde als een gefit model?
Nee. Het oppervlak is een interpolatie van de gegevens, geen gefit model, dus kleine bulten kunnen uit meetspreiding komen. Om met vertrouwen een optimum te schatten, fit u een responsoppervlakmodel, via een DOE-responsoppervlak of regressie, en gebruikt u het gefitte oppervlak daarvan.
Wat is het verschil tussen de interpolatiemethoden Distance en Akima?
Voor verspreide gegevens gebruikt de methode Distance inverse-afstandsgewichten, waarbij een hogere Distance Power nabije punten meer gewicht geeft, en schattingen blijven altijd binnen het bereik van de gegevens. De methode van Akima fit gladde lokale polynomen over een triangulatie van de punten, wat een gladder oppervlak geeft dat de gegevens kan over- of onderschrijden. Geen van beide instellingen beïnvloedt rastergegevens.
Wat is het verschil tussen rastergegevens en verspreide gegevens?
Rastergegevens bevatten elke X/Y-combinatie, met gelijke of ongelijke tussenruimte en gemiddelde herhalingen; het oppervlak loopt dan door elk gemeten punt met de lokale kubische interpolatie van Akima. Verspreide gegevens worden geschat op een X-bij-Y-maas, standaard 15 bij 15, met de gekozen interpolatiemethode.