
Individuele variabelen turven (Tally Individual Variables)
Tally Individual Variables maakt een frequentietabel voor elke geselecteerde kolom, voor categorische gegevens zoals defecttypen, ploegen of leveranciers, of voor discrete aantallen. Het rapporteert aantallen, percentages, cumulatieve aantallen en cumulatieve percentages in elke combinatie en laat lege cellen weg. Rijen worden gesorteerd op waarde, niet op frequentie, en elke kolom wordt onafhankelijk geturfd.
Laatst beoordeeld
Belangrijkste conclusie
Tally Individual Variables telt hoe vaak elke afzonderlijke waarde in een of meer kolommen voorkomt en toont per kolom een frequentietabel, met aantallen, percentages en cumulatieve aantallen of percentages.
Op deze pagina
Doel
Tally Individual Variables telt hoe vaak elke afzonderlijke waarde in een of meer kolommen voorkomt en toont het resultaat als frequentietabel voor elke kolom. Gebruik de tool voor categorische gegevens zoals defecttypen, ploegen, lijnen, leveranciers of goed/fout-resultaten, en voor discrete aantallen, om te zien welke categorieën het vaakst voorkomen en welk aandeel elk heeft, voordat u een paretodiagram tekent of twee variabelen kruist in een kruistabel.
Belangrijkste mogelijkheden
- Eén tabel per geselecteerde kolom; elke kolom wordt afzonderlijk geturfd.
- Aantallen, percentages, cumulatieve aantallen en cumulatieve percentages, in elke combinatie.
- Werkt op tekstcategorieën en op getallen (elke afzonderlijke waarde is een categorie).
- Lege cellen worden buiten de aantallen gelaten.
Statistische methoden
Voor elke geselecteerde kolom worden de niet-lege waarden gegroepeerd op hun afzonderlijke waarde, en het aantal rijen met elke waarde is het aantal nⱼ. Het totaal N = Σnⱼ is het aantal niet-lege cellen in die kolom, dus verschillende kolommen kunnen verschillende totalen hebben. De rijen van de tabel worden gesorteerd op waarde: alfabetisch voor tekst, in oplopende volgorde voor getallen.
Percentage = 100 × nⱼ / N, afgerond op twee decimalen. Het cumulatieve aantal is het lopende totaal van de aantallen langs de tabel naar beneden en het cumulatieve percentage is 100 × (lopend totaal) / N, dat op de laatste rij 100 bereikt. Omdat de rijen op waarde en niet op frequentie zijn gesorteerd, zijn de cumulatieve kolommen het nuttigst voor geordende waarden (bijvoorbeeld een aantal defecten per eenheid, of beoordelingen 1 tot 5): ze geven dan het aandeel op of onder elke waarde. Om categorieën op frequentie te rangschikken en het aandeel van de top af te lezen, gebruikt u het paretodiagram.
Elke kolom wordt onafhankelijk geturfd, dus de tabellen tonen niet hoe de variabelen zich tot elkaar verhouden (bijvoorbeeld welke lijn welk defect maakt). Gebruik daarvoor Kruistabel en chi-kwadraat.
Invoervelden en opties
Veld | Beschrijving |
Variables | Verplicht. Een of meer kolommen (Ctrl of Cmd om er meerdere te selecteren). Voor elke kolom wordt een aparte tabel gegenereerd. |
Counts | Standaard aangevinkt. Aantal rijen met elke waarde. |
Percents | Standaard uit. Het aandeel van elke waarde in de niet-lege rijen van de kolom. |
Cumulative counts | Standaard uit. Lopend totaal van de aantallen, in tabelvolgorde. |
Cumulative percents | Standaard uit. Lopend totaal als percentage, in tabelvolgorde. Ten minste één van de vier statistieken moet zijn aangevinkt. |
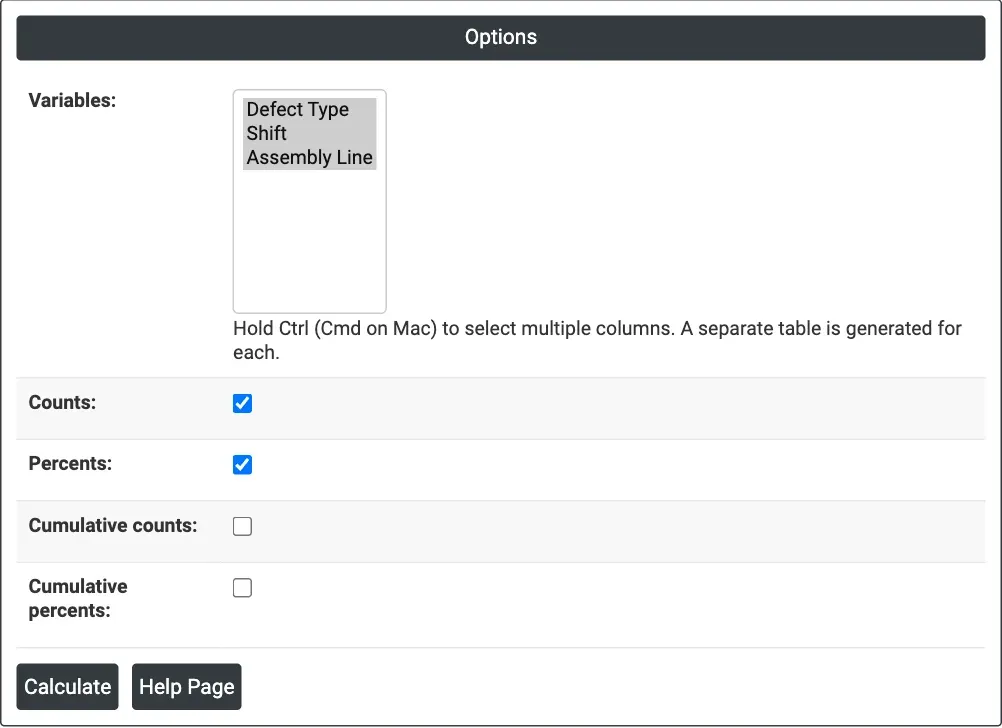
Figuur 1 — Opties voor het voorbeeld: Defect Type, Shift en Assembly Line, met Counts en Percents.
Beschrijving van de uitvoer
- Tally for <column> — één tabel per geselecteerde kolom, met de afzonderlijke waarden en de gekozen kolommen: Count, Percent, CumCount en CumPercent.
- PDF-export via Download.
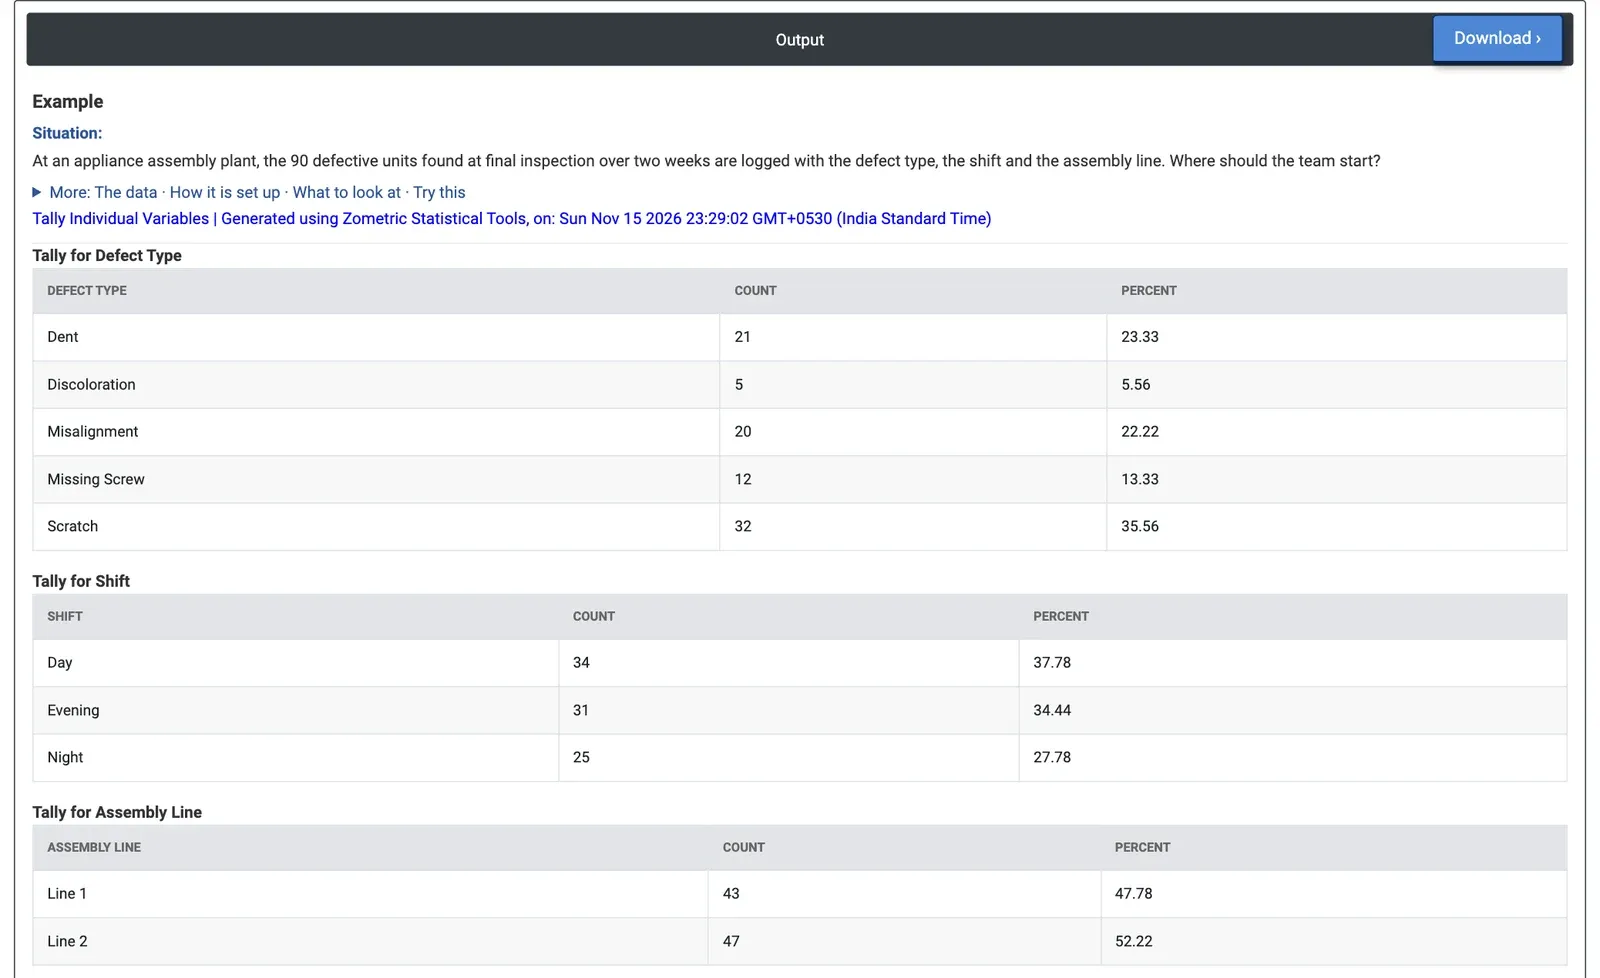
Figuur 2 — Aantallen en percentages van 90 defecte eenheden per defecttype, ploeg en assemblagelijn.
Uitgewerkt voorbeeld
In een assemblagefabriek voor huishoudelijke apparaten worden de 90 defecte eenheden die in twee weken bij de eindinspectie zijn gevonden, vastgelegd met het defecttype, de ploeg en de assemblagelijn. Het kwaliteitsteam wil een snelle samenvatting om te bepalen waar het moet beginnen. Variables = Defect Type, Shift en Assembly Line, met Counts en Percents aangevinkt.
Scratch is het meest voorkomende defect (32 eenheden, 35.56%), gevolgd door Dent (21, 23.33%) en Misalignment (20, 22.22%); samen vertegenwoordigen deze drie 73 van de 90 defecten, ongeveer 81%. Missing Screw (12) en Discoloration (5) zijn kleiner. Per ploeg zijn de defecten vrij gelijkmatig verdeeld: Day 34, Evening 31 en Night 25. Per lijn zijn ze ongeveer gelijk: Line 1 heeft er 43 en Line 2 47.
Het team moet beginnen met krassen, daarna deuken en slechte uitlijning. Omdat noch de ploeg noch de lijn op zichzelf opvalt, is de volgende stap de combinaties te bekijken: een kruistabel van Defect Type per Assembly Line toont dat Line 2 21 van de 32 krassen maakt, terwijl Line 1 14 van de 20 uitlijningsfouten maakt, dus de twee lijnen hebben verschillende problemen ook al zijn hun totalen vergelijkbaar. Door hier Cumulative percents aan te vinken, komt er een lopend totaal in alfabetische volgorde bij (Dent, Discoloration, Misalignment enzovoort), wat geen rangschikking is; een paretodiagram van Defect Type geeft het gerangschikte beeld.
Veelgestelde vragen
Wat doet Tally Individual Variables?
Het telt hoe vaak elke afzonderlijke waarde in een of meer kolommen voorkomt en geeft voor elke kolom een aparte frequentietabel. Het werkt op tekstcategorieën en getallen, laat lege cellen weg en kan aantallen, percentages, cumulatieve aantallen en cumulatieve percentages tonen. Het percentage is het aandeel van elke waarde in de niet-lege rijen van de kolom.
Wanneer gebruikt u een paretodiagram in plaats van een turftabel?
De turftabel sorteert rijen op waarde, alfabetisch voor tekst of in oplopende volgorde voor getallen, niet op frequentie. Om categorieën op frequentie te rangschikken en het aandeel van de top af te lezen, gebruikt u een paretodiagram. Cumulatieve percentages in een turftabel zijn het nuttigst voor geordende waarden, zoals beoordelingen of defecten per eenheid.
Kan een turftabel tonen hoe twee variabelen zich tot elkaar verhouden?
Nee. Elke kolom wordt onafhankelijk geturfd, dus de tabellen tonen niet hoe de variabelen zich tot elkaar verhouden, bijvoorbeeld welke lijn welk defect maakt. Gebruik daarvoor Kruistabel en chi-kwadraat, dat de combinaties van twee variabelen telt.