
Capacidades adicionales del bioensayo logístico de 4 parámetros
Este complemento del método logístico de cuatro parámetros añade el ajuste ANOVA / CI error term. Sequential (predeterminado) asigna a cada prueba F el residuo de su modelo anidado; Pure Error usa el residuo del modelo saturado en las tres pruebas F de validez (Regression, Non-parallelism, Lack of Fit) y en el IC de la potencia, como el software conforme a EP 5.3. Pure Error requiere cierta replicación. Los parámetros de la curva y la estimación de la potencia no cambian.
Última revisión:
Idea clave
La opción de término de error del bioensayo logístico de cuatro parámetros define si las pruebas F de validez y el intervalo de confianza de la potencia usan residuos anidados secuenciales o un único error puro, como en EP 5.3.
En esta página
Bioensayo: método logístico de cuatro parámetros
Capacidad añadida: término de error opcional del ANOVA / intervalo de confianza (“Sequential” frente a “Pure Error”)
Qué se ha añadido
El método logístico de cuatro parámetros incorpora el mismo tipo de convención opcional de término de error que ya se añadió a los métodos de líneas paralelas y de razón de pendientes, adaptada a la estructura de modelo propia de este método. Controla qué estimación de la varianza alimenta a la vez las tres pruebas F de validez y el intervalo de confianza de la potencia (y no solo el intervalo de confianza, como en los dos métodos lineales), lo que refleja cómo está estructurado el ANOVA de este método. Los parámetros de la curva ajustada y la estimación puntual de la potencia no se ven afectados en ningún caso.
Marco regulatorio y estadístico
Un ensayo logístico de cuatro parámetros (4PL) ajusta una curva sigmoidea, determinada por una asíntota superior, una asíntota inferior, un factor de pendiente y un punto de inflexión, a la respuesta de cada preparación frente al logaritmo de la dosis. Para construir las pruebas de validez se comparan tres modelos anidados: un modelo nulo (línea plana), un modelo en el que todas las preparaciones comparten una misma forma de curva (solo puede diferir el punto de inflexión, lo que genera la estimación de la potencia) y una curva totalmente independiente ajustada a cada preparación.
Como en los demás métodos de bioensayo, el software comercial conforme a la Farmacopea Europea (Ph. Eur.), capítulo 5.3, “Statistical Analysis of Results of Biological Assays and Tests”, construye por convención las tres pruebas F de validez y el intervalo de confianza de la potencia a partir de un único término de varianza de error compartido: su convención de “ANOVA de error puro” (Pure-error ANOVA). El valor predeterminado actual de esta herramienta asigna, en cambio, a cada prueba F su propio término de error, más adecuado localmente.
Las matemáticas
Convención A: “Sequential” (el valor predeterminado actual de esta herramienta). Cada una de las tres pruebas F se construye con el par concreto de modelos anidados que compara, y usa como denominador la varianza residual de esa comparación:
F(Regression) = MS(explicada por la curva compartida frente a la plana) / MS(residual del ajuste de la curva compartida)
F(Non-parallelism) = MS(explicada por las curvas separadas frente a la curva compartida) / MS(residual del ajuste de las curvas separadas)
F(Lack of Fit) = MS(explicada por el ajuste saturado frente a las curvas separadas) / MS(residual del ajuste saturado, es decir, el error puro)
y el intervalo de confianza de la potencia usa igualmente el residuo propio del modelo de curva compartida, que incorpora cualquier cantidad pequeña y no significativa de no paralelismo.
Convención B: “Pure Error” (la nueva opción; el “ANOVA de error puro” de EP 5.3). Las tres pruebas F y el intervalo de confianza de la potencia comparten, en cambio, un único denominador: el residuo del ajuste totalmente saturado, con una curva por preparación y grupo de dosis:
F(cualquier prueba) = MS(explicada por la comparación de esa prueba) / MS(error puro, del ajuste saturado): siempre el mismo denominador
Razonamiento: por qué dos convenciones y cuándo usar cada una
Las dos convenciones responden a preguntas ligeramente distintas, igual que en los dos métodos lineales: la convención secuencial permite juzgar la significancia de cada prueba frente a la variabilidad concreta relevante para esa comparación, mientras que la convención de error puro plantea a todas las pruebas la misma pregunta de fondo (“¿cómo se compara esta desviación con el ruido puro entre réplicas, sin combinar nada más?”) y además vincula el intervalo de confianza de la potencia a esa misma estimación de error, la más estrecha posible.
En un ensayo válido y bien ajustado, la diferencia entre ambas suele ser pequeña. Se hace más notoria cuando existe una cantidad modesta y no significativa de no paralelismo o de falta de ajuste, ya que la convención secuencial incorpora esa variabilidad adicional al término de error de la prueba correspondiente (y del intervalo de la potencia), mientras que la convención de error puro la excluye deliberadamente en todos los casos.
Como en los demás métodos, seleccionar “Pure Error” está pensado sobre todo para conciliar resultados con software comercial conforme a EP 5.3 o con un método heredado validado que se basa en su convención de ANOVA de error puro. El valor secuencial predeterminado de la herramienta sigue siendo una opción totalmente válida cuando no se requiere ninguna comparación externa de este tipo.
Qué cambia en la salida y qué no
Afectado:
- El valor F y el valor p de las tres pruebas de validez (Regression, Non-parallelism, Lack of Fit)
- Una nueva columna “Error Term” en la tabla ANOVA que identifica la convención y los grados de libertad utilizados
- Lower CL y Upper CL del intervalo de confianza de la potencia, y una nueva columna “CI Error Term”
No afectado:
- Los parámetros de la curva ajustada (asíntota superior/inferior, factor de pendiente, punto de inflexión) de cada preparación
- La razón de potencia relativa estimada
- La ecuación del modelo ajustado que se muestra para cada preparación
Dónde encontrar esta capacidad
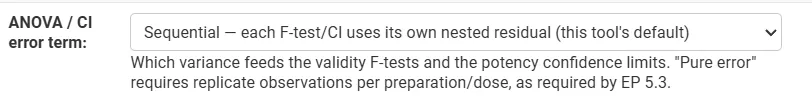
En el formulario de entrada de la herramienta del método logístico de cuatro parámetros, un campo denominado “ANOVA / CI error term” ofrece elegir entre “Sequential — each F-test/CI uses its own nested residual (this tool's default)” y “Pure error — single saturated-model residual for all F-tests and the CI (EP 5.3 default)”. La opción de error puro requiere que el modelo saturado (un ajuste por preparación y grupo de dosis) tenga al menos un grado de libertad residual, es decir, cierta replicación en los datos.
Verificación con datos de referencia publicados
Esta opción se comprobó con un ensayo serológico publicado de antitoxina tetánica, que compara un estándar y una preparación de suero de prueba a lo largo de diez pasos de dilución al doble, con dos réplicas por dosis.
Fuente: Farmacopea Europea, 5.ª edición (2005), capítulo 5.3, ejemplo resuelto 5.4.1.a, tal como se reproduce en el informe de ejemplo publicado de PLA 3.0 de Stegmann Systems (Document-3567, “PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf”)
Métrica | Publicado (PLA/EP 5.3) | Calculado (opción Pure Error) |
F de Regression (gl=3) | 9785.4821 | 9788.5262 |
F de Non-parallelism (gl=3) | 0.48912 | 0.4884 |
F de Lack of Fit (gl=12) | 0.62266 | 0.6216 |
Razón de potencia | 1.45886 | 1.45880 (redondeado: 1.4588) |
Potencia estimada de la muestra (UI/ml) | 0.58354 | 0.5835 |
IC del 95 % (potencia de la muestra, UI/ml) | 0.55511 – 0.61343 | 0.5544 – 0.6127 |
Los parámetros de forma de la curva (asíntota superior/inferior, factor de pendiente, puntos de inflexión) y la estimación puntual de la potencia coincidieron casi exactamente con el informe publicado en ambas convenciones, lo que confirma que el ajuste en sí no se ve afectado por esta opción, tal como se pretendía. Los valores F y el intervalo de confianza calculados con la opción de error puro se acercan a las cifras publicadas, con una pequeña diferencia residual (visible sobre todo en el intervalo de confianza) atribuible a que el informe publicado redondea sus valores intermedios a tres decimales antes del cálculo final. El valor secuencial predeterminado de la herramienta, como era de esperar, no estaba pensado para coincidir con este informe de “ANOVA de error puro” y se verificó por separado que se mantiene internamente coherente.
Referencias
- Farmacopea Europea (Ph. Eur.), capítulo 5.3, “Statistical Analysis of Results of Biological Assays and Tests” (5.ª edición, 2005, y ediciones posteriores).
- United States Pharmacopeia, capítulo general <111>, “Design and Analysis of Biological Assays”.
- Stegmann Systems GmbH, ejemplo resuelto publicado de PLA 3.0: “PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf” — https://www.bioassay.de/fileadmin/user_upload/Webseiten-Landingpages/Bioassay.de/Analytical_methodes/Experiments/Parallel_logistic_potency_assays__3PL__4PL__5PL_/PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf
Preguntas frecuentes
¿Qué es un bioensayo logístico de cuatro parámetros (4PL)?
Un ensayo 4PL ajusta una curva sigmoidea, definida por una asíntota superior, una asíntota inferior, un factor de pendiente y un punto de inflexión, a la respuesta de cada preparación frente al logaritmo de la dosis. Las pruebas de validez comparan un modelo de línea plana, un modelo de forma compartida en el que solo difiere el punto de inflexión, que da la estimación de la potencia, y curvas totalmente independientes para cada preparación.
¿Cuál es la diferencia entre el ANOVA secuencial y el de error puro en un ensayo 4PL?
En la convención secuencial, cada prueba F usa el residuo de los modelos anidados concretos que compara, y el intervalo de la potencia usa el residuo de la curva compartida. En la convención de error puro, las tres pruebas F y el intervalo de la potencia comparten un único denominador: el residuo del ajuste totalmente saturado. La curva ajustada y la estimación de la potencia son las mismas en ambas.
¿Cuándo debe usarse la opción de error puro en un ensayo 4PL?
Use el error puro sobre todo para conciliar resultados con software conforme a EP 5.3 o con un método heredado validado que se basa en su convención de ANOVA de error puro. En un ensayo válido y bien ajustado, las dos convenciones suelen diferir poco. La diferencia crece cuando hay una cantidad modesta y no significativa de no paralelismo o de falta de ajuste. En los demás casos, el valor secuencial predeterminado sigue siendo válido.
¿Cómo se selecciona el término de error en Zometric Statistical Software?
En el formulario de entrada del método logístico de cuatro parámetros, use el campo ANOVA / CI error term para elegir Sequential (el valor predeterminado) o Pure error. La opción de error puro requiere que el modelo saturado tenga al menos un grado de libertad residual, es decir, que haya cierta replicación en los datos.