
Capacidades adicionales para el bioensayo de razón de pendientes
Un ensayo de razón de pendientes ajusta rectas en la escala de dosis con una única ordenada al origen común para todas las preparaciones. Este complemento añade el ajuste Potency CI error term: Regression residual (por defecto) o Pure error, la varianza de réplicas dentro de cada celda que usa el software conforme con EP 5.3. Solo cambian los límites de confianza, la g de Fieller y una columna CI Error Term. Pure error requiere celdas de preparación/dosis con réplicas.
Última revisión:
Idea clave
La opción de término de error del IC de potencia del método de razón de pendientes permite que el intervalo de Fieller use el residuo de regresión de intersección común o la varianza de error puro de las réplicas, como el software EP 5.3.
En esta página
Bioensayo — método de razón de pendientes
Capacidad añadida: término de error opcional para el intervalo de confianza de la potencia ("Regression Residual" frente a "Pure Error")
Qué se añadió
El método de razón de pendientes incorpora la misma convención opcional de intervalo de confianza que ya se añadió al método de rectas paralelas: la elección de qué estimación de varianza alimenta el intervalo de confianza de la potencia. Como en rectas paralelas, es opcional, no cambia nada por defecto y nunca afecta a la potencia estimada, solo a la amplitud de su intervalo de confianza.
Contexto regulatorio y estadístico
Un ensayo de razón de pendientes ajusta una recta, en la propia escala de dosis (no en log-dosis), a la respuesta de cada preparación, con la restricción de que todas las preparaciones comparten una única ordenada al origen común. Antes de confiar en una estimación de potencia, el ensayo debe superar comprobaciones de validez que confirmen que la relación dosis-respuesta es significativa, que las preparaciones comparten realmente una ordenada común y que la relación de cada preparación es lineal en el rango probado.
Como en el método de rectas paralelas, tanto la Farmacopea Europea (Ph. Eur.), capítulo 5.3 — "Statistical Analysis of Results of Biological Assays and Tests", como la United States Pharmacopeia, capítulo general <111> — "Design and Analysis of Biological Assays", usan el teorema de Fieller para construir el intervalo de confianza de la potencia, y las dos convenciones solo divergen en la estimación de varianza que se suministra a ese teorema.
Las matemáticas
Convención A — "Regression Residual" (valor por defecto actual de esta herramienta). La varianza que queda tras ajustar el modelo de ordenada común, incluyendo cualquier falta (esperablemente despreciable) de ordenada común entre las preparaciones y cualquier no linealidad (también esperablemente despreciable):
MS(residuo de regresión) = SS(residuo tras el ajuste de ordenada común) / gl(residuo tras el ajuste de ordenada común)
Convención B — "Pure Error" (la opción nueva). La varianza entre lecturas replicadas exactamente en la misma preparación y dosis únicamente; es el mismo "Residual (pure) error" que ya se usa como denominador de las pruebas F de validez del ensayo:
MS(error puro) = SS(error puro) / gl(error puro), sumados sobre la dispersión de réplicas de cada celda preparación x dosis
El cuadrado medio elegido y sus grados de libertad alimentan el mismo cálculo, sin cambios, del intervalo de confianza de Fieller que se usa para cada razón de potencia relativa en este método.
Razonamiento: por qué dos convenciones y cuándo usar cada una
Aquí se aplica el mismo razonamiento que en el método de rectas paralelas: en un ensayo realmente válido, ambas convenciones deben dar resultados similares, ya que un ensayo válido tiene, por definición, poca variación por falta de ordenada común o por no linealidad que la convención de error puro pueda excluir. Seleccionar "Pure Error" resulta útil sobre todo para conciliar resultados con software comercial conforme con EP 5.3 o con un método heredado validado construido sobre esa convención.
Qué cambia en la salida y qué no
Afectado:
- Lower CL y Upper CL (límites de confianza de la potencia) de cada preparación de prueba
- El estadístico g de Fieller
- Una nueva columna "CI Error Term" que muestra qué convención y qué grados de libertad se usaron
No afectado:
- La potencia relativa estimada de cada preparación de prueba
- Las tablas de coeficientes de la regresión separada y de la regresión de ordenada común, y la tabla ANOVA completa
- Los resultados de las pruebas de validez (Significance of Regression, Intercept/Common-Blank-Response, Linearity)
Dónde encontrar esta capacidad
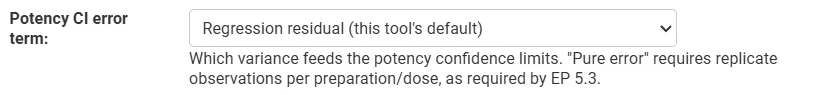
En el formulario de entrada de la herramienta de razón de pendientes, un campo denominado "Potency CI error term" ofrece las mismas dos opciones que rectas paralelas: "Regression residual (this tool's default)" y "Pure error — within-cell replicate variance only (EP 5.3 default)". La opción de error puro requiere al menos una combinación de preparación y dosis con observaciones replicadas.
Verificación con datos de referencia publicados
Esta opción se verificó con un ejemplo resuelto publicado distinto: un ensayo de razón de pendientes de diseño (0,4,4,4) completamente aleatorizado sobre la potencia de una vacuna antigripal, que compara un estándar con dos preparaciones de prueba, con cuatro niveles de dosis comunes y dos réplicas cada uno (24 observaciones en total, sin blanco de dosis cero en este diseño concreto).
Fuente: Farmacopea Europea, 5.ª edición (2005), capítulo 5.3, ejemplo resuelto 5.2.2, tal como se reproduce en el informe de ejemplo publicado de PLA 3.0 de Stegmann Systems (Document-3580, "PLA_3.0.7_Example_Slope-Ratio_Quantitative_Response_Assay_Standard_Report.pdf")
Preparación | Métrica | Publicado (PLA/EP 5.3) | Calculado (opción Pure Error) |
T | Razón de potencia (%) | 95.280 | 95.2801 |
T | IC del 95% | 89.121 – 101.807 | 89.1207 – 101.8072 |
U | Razón de potencia (%) | 64.863 | 64.8632 |
U | IC del 95% | 59.028 – 70.725 | 59.0277 – 70.7252 |
La descomposición completa del ANOVA también coincidió exactamente, incluido un detalle específico de este método: esta herramienta divide la única fila "Regression (df=3)" del informe publicado en dos filas más detalladas, "Regression" (el efecto de dosis combinado, gl=1) y "Preparations (Slope Differences)" (gl=2), que sumadas igualan exactamente la suma de cuadrados de la fila Regression publicada (1087.6652 en ambos casos). La fila "Intercept" coincide exactamente con la fila publicada "non-Similarity", y la fila "Non-linearity", junto con su desglose opcional por preparación, coincide exactamente con la fila publicada "non-Linearity (LoF)" y su desglose por preparación. Ambos modelos de regresión (separado por preparación y de ordenada común) también coincidieron hasta el decimal.
Referencias
- European Pharmacopoeia (Ph. Eur.), capítulo 5.3 — "Statistical Analysis of Results of Biological Assays and Tests" (5.ª edición, 2005, y ediciones sucesivas).
- United States Pharmacopeia, capítulo general <111> — "Design and Analysis of Biological Assays".
- Fieller, E.C. (1944). "A fundamental formula in the statistics of biological assay, and some applications." Quarterly Journal of Pharmacy and Pharmacology, 17, 117–123.
- Stegmann Systems GmbH, ejemplo resuelto publicado de PLA 3.0: "PLA_3.0.7_Example_Slope-Ratio_Quantitative_Response_Assay_Standard_Report.pdf" — https://www.bioassay.de/fileadmin/user_upload/Webseiten-Landingpages/Bioassay.de/Analytical_methodes/Experiments/Slope_ratio_potency_assays/PLA_3.0.7_Example_Slope-Ratio_Quantitative_Response_Assay_Standard_Report.pdf
Preguntas frecuentes
¿Qué es un bioensayo de razón de pendientes?
Un ensayo de razón de pendientes ajusta, para cada preparación, una recta de la respuesta frente a la dosis (no la log-dosis), con la restricción de que todas las preparaciones comparten una única ordenada al origen común. Antes de confiar en la potencia, las comprobaciones de validez confirman una relación dosis-respuesta significativa, una ordenada realmente común y linealidad en cada preparación dentro del rango probado.
¿Cuál es la diferencia entre residuo de regresión y error puro en un ensayo de razón de pendientes?
El residuo de regresión es la varianza que queda tras ajustar el modelo de ordenada común, e incluye cualquier pequeña falta de ordenada común y cualquier no linealidad. El error puro es la varianza entre lecturas replicadas en la misma preparación y dosis únicamente. Cualquiera de los dos cuadrados medios, con sus grados de libertad, alimenta el mismo cálculo del intervalo de confianza de Fieller.
¿Cuándo conviene elegir error puro en un ensayo de razón de pendientes?
Elija error puro sobre todo para conciliar resultados con software conforme con EP 5.3 o con un método heredado validado construido sobre esa convención. En un ensayo realmente válido, ambas convenciones deben dar intervalos similares, porque hay poca variación por falta de ordenada común o por no linealidad que excluir. La potencia estimada es la misma en ambos casos.
¿Cómo se configura esta opción en Zometric Statistical Software?
En el formulario de entrada del método de razón de pendientes, el campo Potency CI error term ofrece Regression residual (el valor por defecto) y Pure error, solo varianza de réplicas dentro de cada celda. La opción de error puro requiere al menos una combinación de preparación y dosis con observaciones replicadas.