
Capacidad de proceso automatizada
La capacidad de proceso automatizada elimina la verificación manual de normalidad. Aplica la prueba de Anderson-Darling: si el valor p alcanza el umbral (0.1 por defecto), calcula Pp, Ppl, Ppu y Ppk normales; si es menor, ajusta distribuciones no normales por máxima verosimilitud, elige la mejor y usa el método del puntaje z. La salida muestra la ruta, un histograma ajustado, los índices y los PPM esperados y observados.
Última revisión:
Idea clave
La capacidad de proceso automatizada evalúa la normalidad con Anderson-Darling y calcula Pp y Ppk con el modelo normal o con la mejor distribución no normal, documentando la ruta seguida.
En esta página
Propósito
La capacidad de proceso automatizada elimina el paso manual de comprobar primero la normalidad y elegir después, por separado, entre un modelo de capacidad normal o no normal. La herramienta ejecuta ella misma la prueba de normalidad de Anderson-Darling y dirige automáticamente el cálculo a los índices de capacidad normales estándar cuando los datos la superan, o a una distribución no normal de mejor ajuste (seleccionada de la biblioteca de distribuciones candidatas de la aplicación) cuando no la superan, y genera un único informe con la decisión de enrutamiento documentada al principio.
Funciones principales
- Ejecuta automáticamente la prueba de normalidad de Anderson-Darling, sin necesidad de un paso separado de verificación de normalidad.
- Selecciona automáticamente la distribución no normal candidata de mejor ajuste cuando se rechaza el supuesto de normalidad, usando la misma biblioteca de ajuste de distribuciones que las demás herramientas de capacidad no normal de la aplicación.
- Umbral configurable del valor p de normalidad, para que el usuario ajuste con qué rigor la herramienta adopta por defecto la ruta normal.
- Informa directamente en la salida qué ruta se siguió (normal o no normal, y qué distribución), de modo que la decisión de enrutamiento sea transparente y auditable.
- Admite una columna Factor opcional y un modo “Compare selected columns as separate groups”, de forma coherente con las demás herramientas de capacidad de la aplicación.
Métodos estadísticos
La normalidad se evalúa con la prueba de Anderson-Darling (anderson() de scipy frente a una referencia normal), con la corrección estándar para muestras pequeñas AD = A²·(1 + 0.75/n + 2.25/n²) y el valor p obtenido de las aproximaciones empíricas por tramos de D'Agostino–Stephens para el estadístico AD corregido.
Regla de enrutamiento: si el valor p de Anderson-Darling es mayor o igual que el umbral del valor p de normalidad (0.1 por defecto), la herramienta trata los datos como normales: estima σ_overall mediante el método del rango móvil (MRbar/d2, o una variante con la mediana del rango móvil) y con ella calcula los índices de desempeño estándar basados en z: Pp, Ppl, Ppu y Ppk. Si el valor p queda por debajo del umbral, la herramienta ajusta por máxima verosimilitud cada distribución no normal candidata que admite la aplicación (Weibull, Weibull de 3 parámetros, exponencial, exponencial de 2 parámetros, gamma, logística, loglogística, lognormal y las distribuciones de valor extremo mínimo y máximo), las clasifica según la bondad de ajuste y selecciona automáticamente la de mejor ajuste.
En la ruta no normal, la función de distribución acumulada (CDF) de la distribución seleccionada se evalúa en LSL y USL para obtener las probabilidades de cola p_lsl y p_usl, que luego se convierten en puntajes z normales estándar equivalentes mediante la inversa de la CDF normal (norm.ppf): el “método del puntaje z”. La capacidad se informa entonces en la escala habitual de Cpk usando esos puntajes z: Pp = (z_usl − z_lsl) / 6, PPL = −norm.ppf(p_lsl) / 3, PPU = norm.ppf(p_usl) / 3, Ppk = min(PPL, PPU). Así se captura el riesgo real en las colas de una distribución asimétrica antes de expresarlo en las mismas unidades tipo Cpk que se usan en toda la aplicación, en lugar de aplicar indebidamente un puntaje Z normal sin más a datos no normales.
Las cifras de PPM (partes por millón) se informan de dos maneras: PPM “esperado”, a partir de las probabilidades de cola de la distribución ajustada más allá de cada límite de especificación, y PPM “observado”, obtenido simplemente contando la fracción de la muestra original que realmente queda fuera de los límites de especificación.
Campos de entrada y opciones
Campo | Descripción |
Choose columns | La o las columnas de respuesta que se van a analizar. |
Factor | Opcional. Compara la capacidad entre grupos cuando los datos son una sola columna Response más una columna Factor. |
Compare selected columns as separate groups | Cuando se seleccionan 2 o más columnas, calcula la capacidad por separado para cada una y las compara lado a lado. |
LSL / USL | Límites inferior y superior de especificación, aplicados a cada columna seleccionada. |
Normality p-value threshold | Valor predeterminado 0.1. Si el valor p de Anderson-Darling es igual o superior a este umbral, la capacidad se calcula suponiendo normalidad; si es inferior, se selecciona automáticamente la distribución no normal de mejor ajuste y se usa en su lugar. |
Download as Excel | Opcional. Exporta el informe a un libro de Excel. |
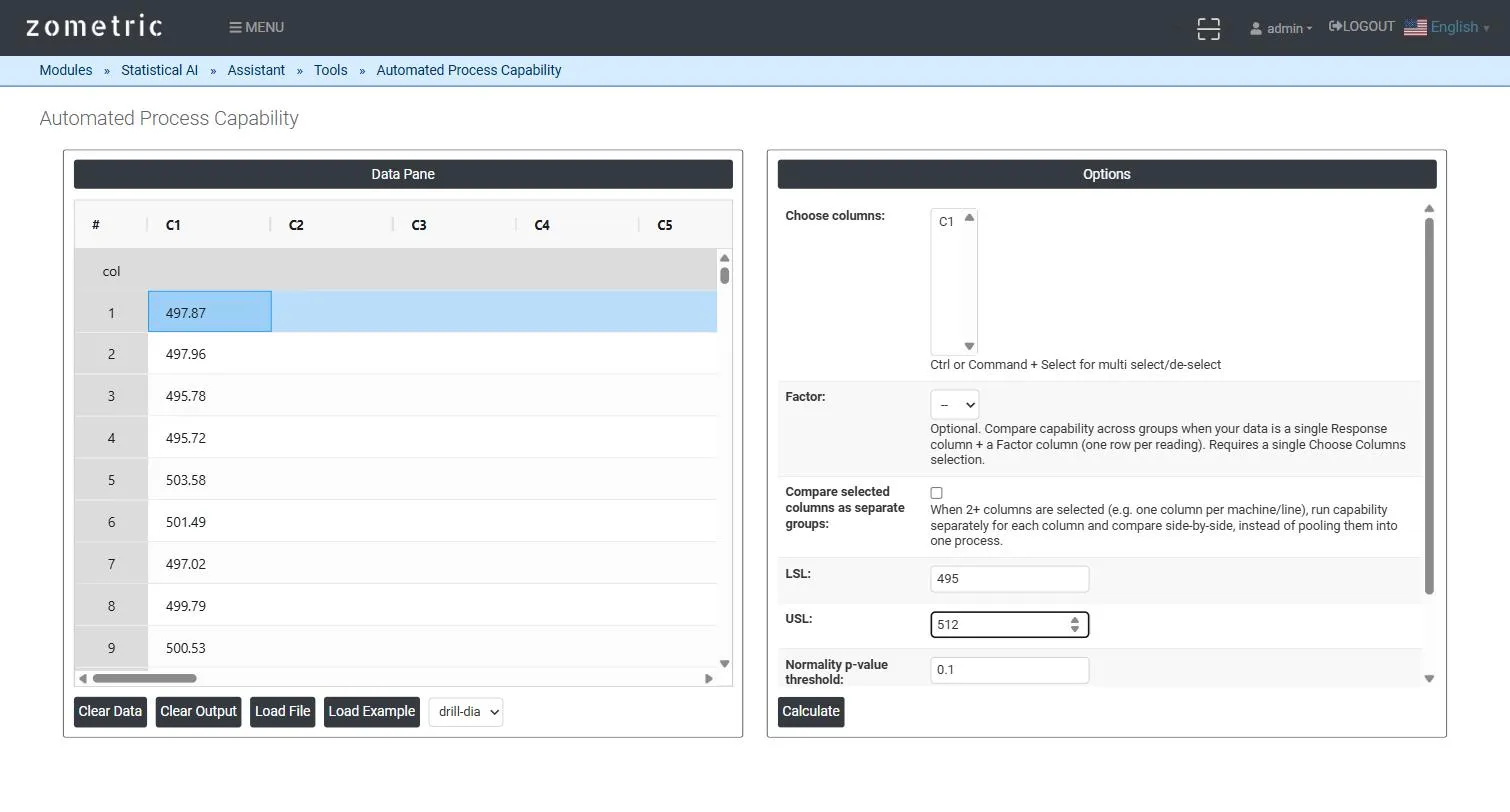
Figura 1: panel de datos (Data Pane) con 60 lecturas de peso de llenado pegadas en C1, y panel Options con LSL/USL y Normality p-value threshold completados.
Descripción de la salida
- Resultado de la prueba de normalidad: el estadístico y el valor p de Anderson-Darling, y la ruta seguida (normal, o la distribución no normal concreta seleccionada automáticamente).
- Histograma de la distribución ajustada: histograma de la muestra con la curva de densidad ajustada y las líneas de referencia LSL/USL superpuestas.
- Tabla de parámetros de la distribución: LSL, USL, media muestral, tamaño de muestra y los parámetros de forma/escala (o equivalentes) de la distribución ajustada.
- Índices de capacidad: Pp, Ppl, Ppu y Ppk calculados con la distribución que se haya seleccionado.
- Tablas de PPM: PPM esperado (a partir de las colas de la distribución ajustada) y PPM observado (a partir de la muestra original), cada uno dividido en PPM < LSL, PPM > USL y PPM Total.
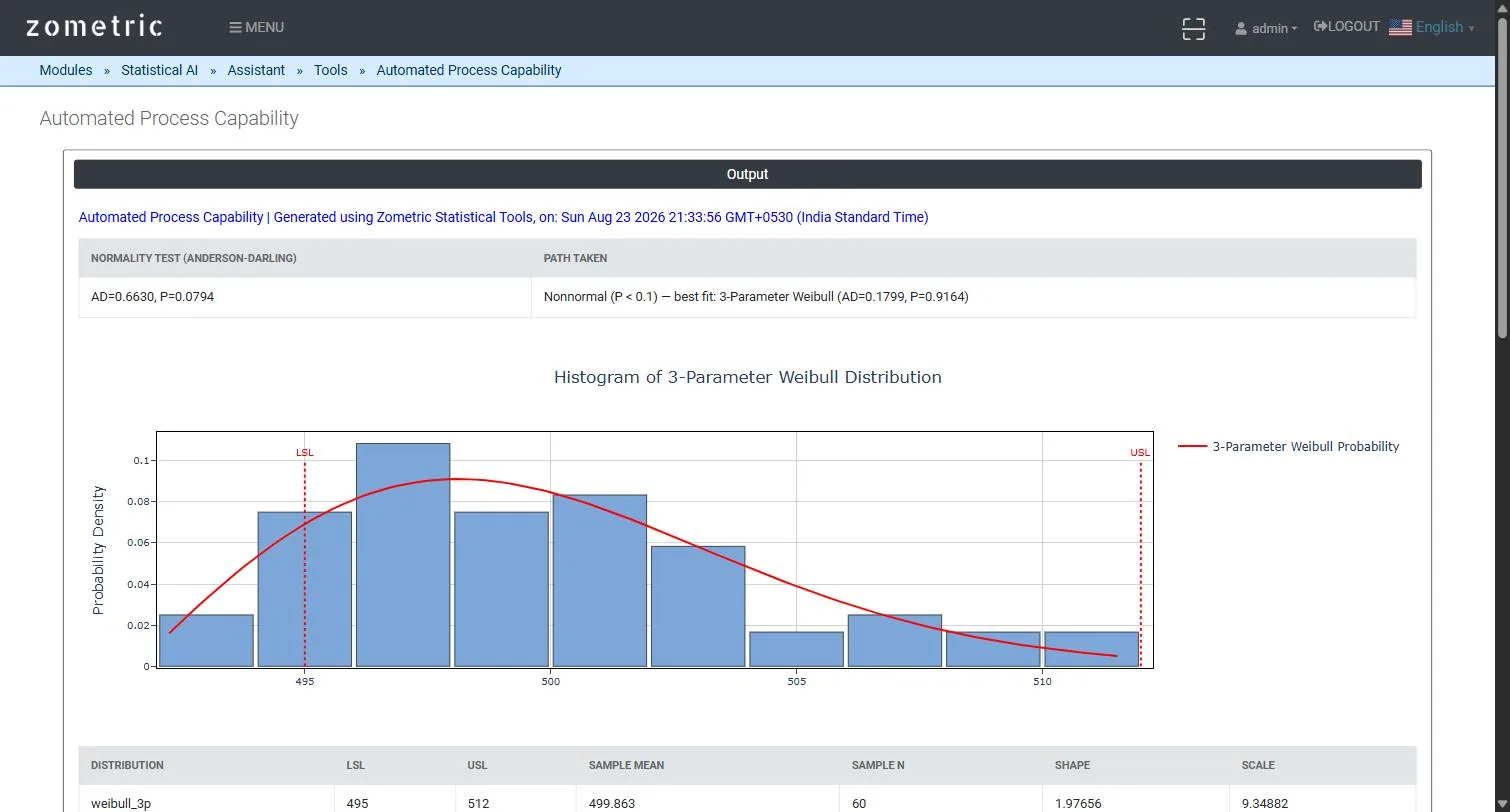
Figura 2: parámetros de la distribución y los índices Pp/Ppl/Ppu/Ppk resultantes, con las tablas de PPM esperado y observado.
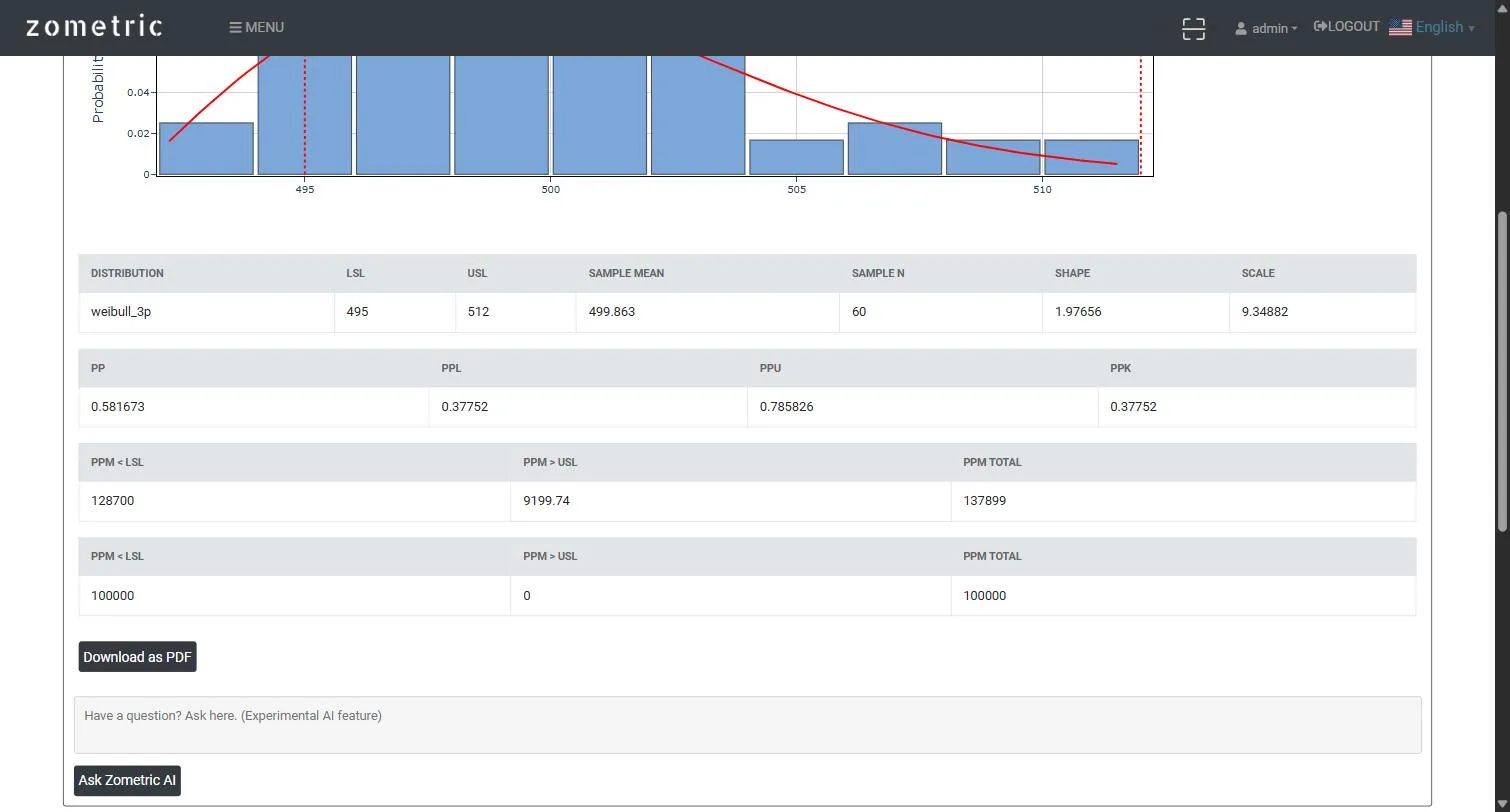
Figura 3: decisión de enrutamiento automatizada (resultado de Anderson-Darling y ruta seguida) con el histograma de la distribución ajustada.
Ejemplo
Una línea de llenado envasa botellas de un líquido de limpieza viscoso; se mide el peso de llenado (g) de 60 botellas tomadas a lo largo de un turno (columna C1), con LSL = 495 g y USL = 512 g. Con el umbral predeterminado de 0.1, la prueba de Anderson-Darling devuelve AD = 0.6630, P = 0.0794, por debajo del umbral, de modo que la herramienta dirige automáticamente el cálculo a la ruta no normal y selecciona un ajuste Weibull de 3 parámetros (AD = 0.1799, P = 0.9164) como la distribución de mejor ajuste, e informa Ppk = 0.378 a partir de las probabilidades de cola de la Weibull ajustada, en lugar de a partir de un supuesto de distribución normal (engañoso).
Preguntas frecuentes
¿Qué hace la capacidad de proceso automatizada?
Ejecuta la prueba de normalidad de Anderson-Darling sobre los datos y dirige automáticamente el cálculo de capacidad: a los índices de capacidad normales estándar si los datos la superan, o a la distribución no normal de mejor ajuste si no. Un único informe muestra el resultado de normalidad, la ruta seguida y la distribución usada, de modo que la decisión de enrutamiento es transparente y auditable.
¿Cómo decide la herramienta entre capacidad normal y no normal?
Si el valor p de Anderson-Darling es mayor o igual que el umbral del valor p de normalidad, que por defecto es 0.1, los datos se tratan como normales. Si es menor que el umbral, la herramienta ajusta por máxima verosimilitud distribuciones candidatas como Weibull, Weibull de 3 parámetros, gamma, lognormal y otras, las clasifica según la bondad de ajuste y selecciona la mejor.
¿Cómo se calcula Ppk para datos no normales?
La CDF de la distribución seleccionada da las probabilidades de cola más allá de LSL y USL, que se convierten en puntajes z normales estándar equivalentes. Después, PPL = -z(p_lsl)/3, PPU = z(p_usl)/3 y Ppk = min(PPL, PPU). Así se captura el riesgo real en las colas de una distribución asimétrica y los resultados se mantienen en la escala habitual tipo Cpk.
¿Cómo se ejecuta la capacidad automatizada en Zometric Statistical Software?
Pegue los datos, elija la o las columnas de respuesta y, opcionalmente, un Factor o la opción de comparar columnas como grupos separados, e introduzca LSL y USL. Defina el Normality p-value threshold (0.1 por defecto). El informe muestra la decisión de enrutamiento, el histograma ajustado, los parámetros de la distribución, los índices de capacidad y las tablas de PPM, y puede exportarse a Excel.