
Regresión de mejores subconjuntos
La regresión de mejores subconjuntos (Best Subsets Regression) ajusta modelos de mínimos cuadrados ordinarios para cada subconjunto de predictores libres, con la opción de forzar algunos en todos los modelos, y muestra de uno a cinco mejores modelos de cada tamaño. Cada fila reporta R-Sq, R-Sq(adj), R-Sq(pred), Cp de Mallows y S, con PRESS, AICc, BIC y VIF opcionales. Úsela al principio para preseleccionar predictores y después ajuste el modelo elegido con Fit Regression Model.
Última revisión:
Idea clave
La regresión de mejores subconjuntos ajusta una regresión lineal para cada combinación de predictores candidatos y enumera los mejores modelos de cada tamaño, para hallar el conjunto más pequeño que explica la mayor parte de la variación.
En esta página
Finalidad
Best Subsets Regression ajusta una regresión lineal para cada combinación de los predictores candidatos y enumera lado a lado los mejores modelos de cada tamaño. Úsela al principio de un estudio, cuando tenga varios ajustes posibles del proceso y quiera el conjunto más pequeño que explique la mayor parte de la variación de la respuesta, antes de ajustar con detalle el modelo elegido con Fit Regression Model.
Capacidades principales
- Ajusta cada subconjunto de los predictores libres, desde el mínimo hasta el máximo número que usted defina.
- Muestra de uno a cinco mejores modelos de cada tamaño, ordenados por R-Sq.
- Reporta R-Sq, R-Sq(adj), R-Sq(pred), Cp de Mallows y S para cada modelo, con PRESS, AICc y BIC a petición.
- Predictors in all models: fuerce en todos los subconjuntos las variables que sabe que importan.
- Las tablas ampliadas (Enhanced) añaden el factor de inflación de la varianza (VIF) de cada predictor en cada modelo, para detectar predictores correlacionados.
- Modelo con o sin intersección.
Métodos estadísticos
Se descartan las filas con un valor faltante o no numérico en la respuesta o en cualquiera de los predictores seleccionados. Para cada tamaño de subconjunto, desde el mínimo hasta el máximo, la herramienta ajusta un modelo de mínimos cuadrados ordinarios para cada combinación de ese número de predictores libres (más los predictores forzados, si los hay), los ordena por R-Sq y conserva los mejores modelos de cada tamaño. Con p predictores libres hay 2ᵖ − 1 subconjuntos, por lo que cada candidato añadido duplica el número de ajustes.
Para un modelo con k coeficientes (incluida la constante) ajustado a n filas: S = √MSE; R-Sq(adj) corrige R-Sq según el número de términos; PRESS = Σ (eᵢ / (1 − hᵢ))², la suma de los cuadrados de los errores de predicción dejando uno fuera, usando las palancas hᵢ; R-Sq(pred) = 1 − PRESS / SS Total. Cp de Mallows = SSE / MSE(completo) − (n − 2k), donde MSE(completo) es el cuadrado medio del error del modelo con todos los predictores; un modelo con poco sesgo tiene un Cp cercano a k, y el modelo completo siempre tiene Cp = k. AICc = −2 log L + 2(k+1) + 2(k+1)(k+2)/(n − k − 2) y BIC = −2 log L + (k+1) ln n, contando σ como un parámetro; cuanto menor, mejor para PRESS, AICc y BIC.
Busque el modelo en el que R-Sq(adj) y R-Sq(pred) dejan de aumentar, Cp está cerca del número de coeficientes y S es pequeña. Una diferencia grande entre R-Sq y R-Sq(pred) advierte de sobreajuste. Best Subsets solo compara ajustes: compruebe los residuos y los coeficientes del modelo elegido en Fit Regression Model.
Campos y opciones de entrada
Campo | Descripción |
Response (Y) | Columna numérica que se desea explicar. Obligatorio. |
Free predictors | Predictores candidatos numéricos; se prueban todas las combinaciones. Obligatorio. Ctrl o Command + clic para seleccionar varios. |
Predictors in all models (optional) | Predictores numéricos incluidos en todos los modelos. No deben ser también predictores libres. |
Models of each size to display | Cuántos de los mejores modelos de cada tamaño se enumeran, de 1 a 5. Valor predeterminado 2. |
Display PRESS / Display AICc / Display BIC | Añaden estas columnas a la tabla. Desactivadas por defecto. |
Free Predictors: Minimum / Maximum | Menor y mayor número de predictores libres en un modelo. Valor predeterminado: de 1 a todos. |
Fit intercept | Marcada por defecto. Desmárquela para ajustar modelos que pasan por el origen (R-Sq deja entonces de estar centrado). |
Display of results | Simple tables (opción predeterminada) o Enhanced tables, que añaden una columna VIF para cada predictor. |
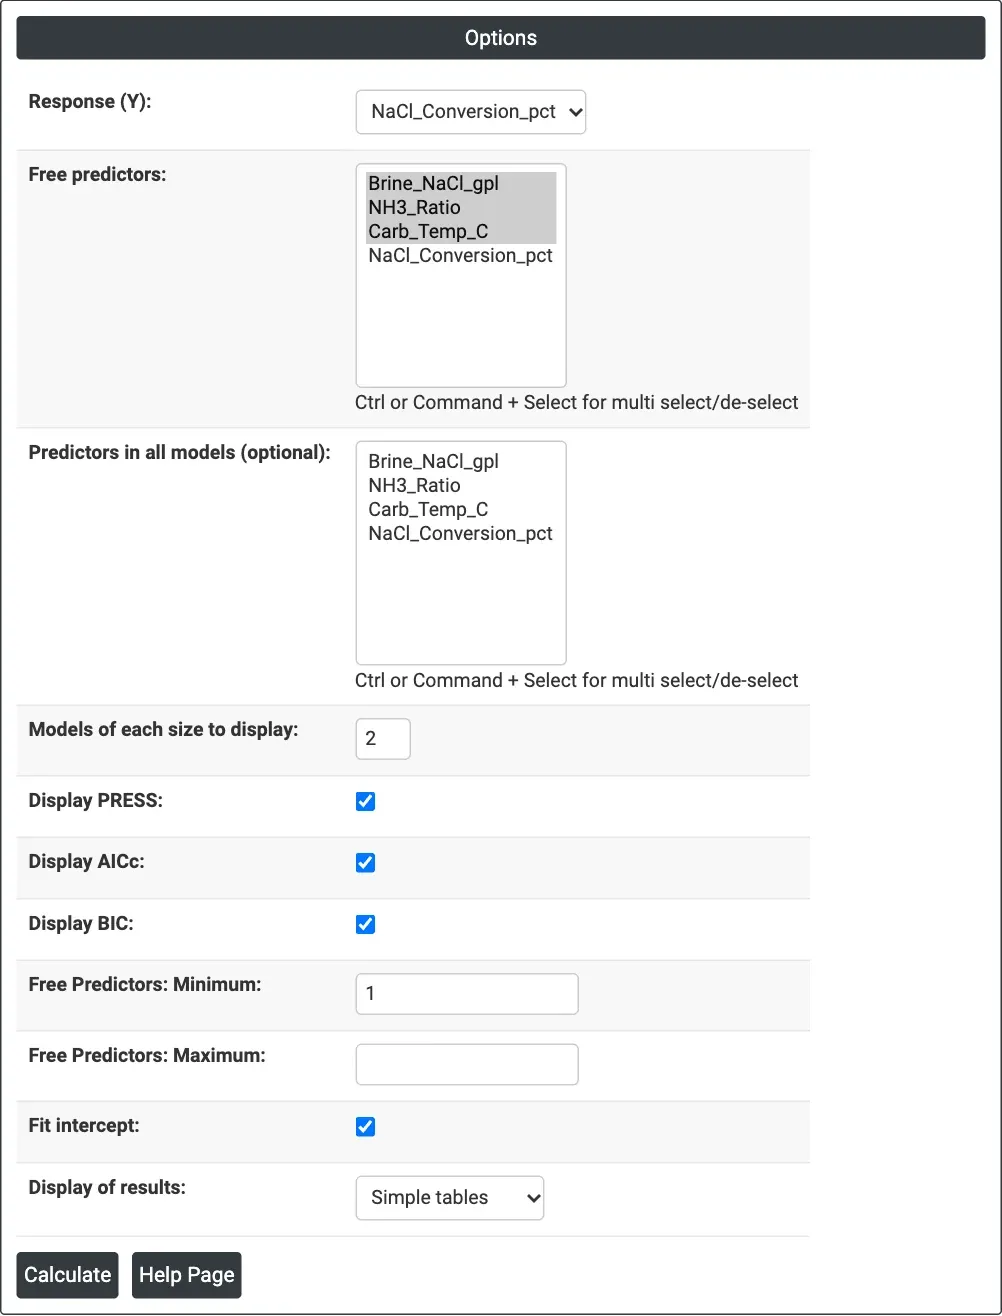
Figura 1: opciones del ejemplo de carbonato de sodio: NaCl_Conversion_pct como respuesta, los tres ajustes del proceso como predictores libres, con PRESS, AICc y BIC mostrados.
Descripción de la salida
- Línea Response: nombra la respuesta y los predictores forzados en todos los modelos, si los hay.
- Tabla Best Subsets Results: una fila por modelo: Vars (número de predictores libres), R-Sq, R-Sq(adj), R-Sq(pred), Mallows' Cp, S, PRESS, AICc y BIC opcionales, y una X bajo cada predictor incluido en el modelo; con las tablas Enhanced, el VIF de cada predictor del modelo.
- Exportación a PDF mediante Download.
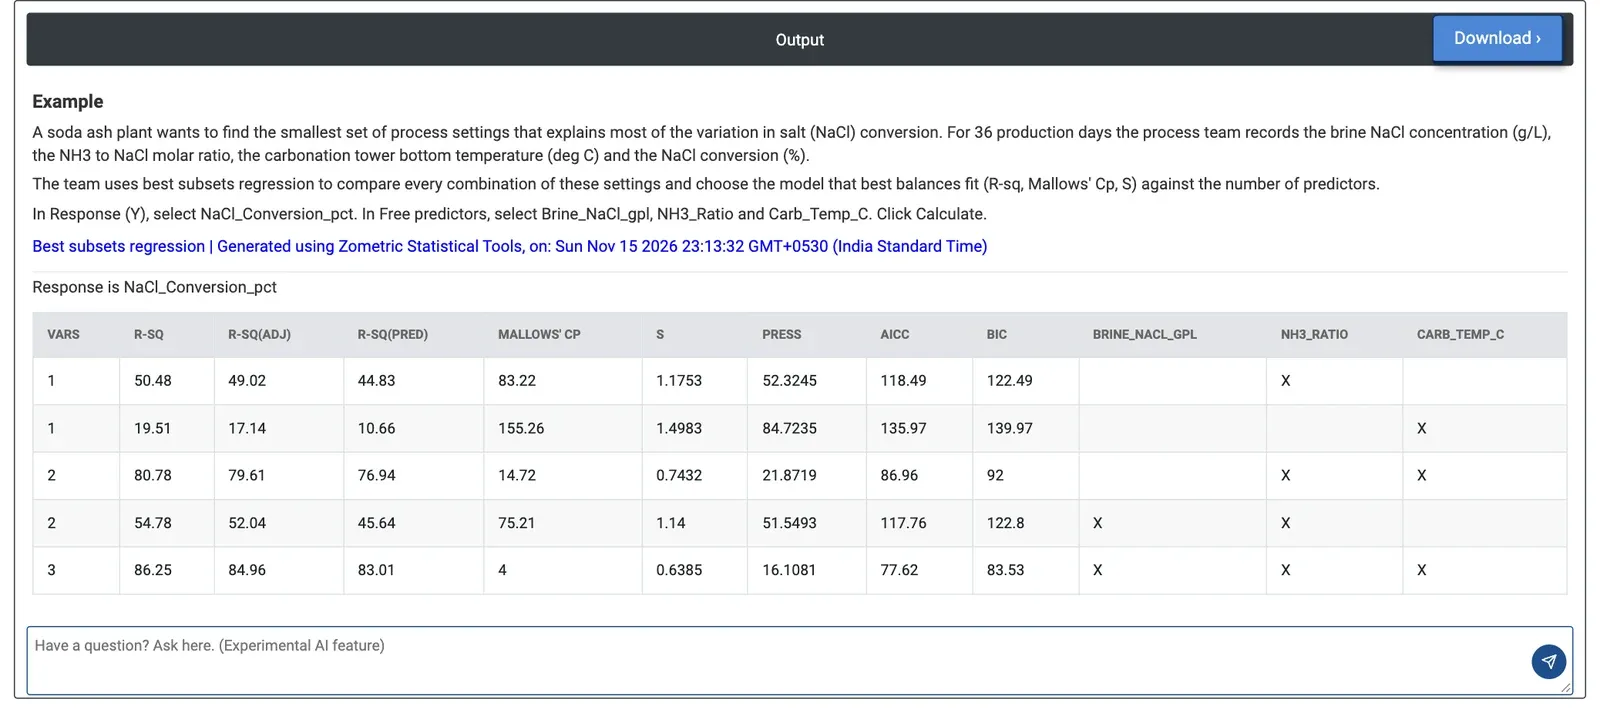
Figura 2: resultados de los mejores subconjuntos para la conversión de NaCl: el modelo de tres predictores tiene R-Sq 86.25%, R-Sq(pred) 83.01%, Cp 4 y S 0.6385.
Ejemplo
Una planta de carbonato de sodio quiere saber qué ajustes del proceso explican la conversión diaria de NaCl (%). Durante 36 días de producción, el equipo registra la concentración de NaCl en la salmuera (Brine_NaCl_gpl), la relación molar NH3 a NaCl (NH3_Ratio) y la temperatura del fondo de la torre de carbonatación (Carb_Temp_C). Selecciona NaCl_Conversion_pct como respuesta, los tres ajustes como predictores libres, conserva dos modelos de cada tamaño y marca Display PRESS, AICc y BIC.
Por sí sola, la relación de NH3 es el mejor predictor individual, pero explica solo el 50.48% de la variación (Cp 83.22). Al añadir la temperatura de carbonatación, R-Sq sube a 80.78% y S baja de 1.1753 a 0.7432 puntos porcentuales, pero Cp sigue siendo 14.72, muy por encima de los 3 coeficientes de ese modelo, por lo que falta algo. Con los tres ajustes, R-Sq es 86.25%, R-Sq(pred) 83.01%, S 0.6385 y PRESS, AICc y BIC son los más bajos de la tabla (16.1081, 77.62 y 83.53). La pequeña diferencia entre R-Sq y R-Sq(pred) muestra que el modelo no está sobreajustado.
El equipo conserva los tres ajustes y los ajusta con Fit Regression Model. Al marcar Enhanced tables se obtienen VIF de 1.01 a 1.03, por lo que los tres ajustes no se modificaron a la vez y el efecto de cada uno puede leerse por separado.
Preguntas frecuentes
¿Qué es la regresión de mejores subconjuntos?
La regresión de mejores subconjuntos ajusta una regresión lineal para cada combinación de los predictores candidatos y enumera lado a lado los mejores modelos de cada tamaño, ordenados por R-Sq. Se usa al principio de un estudio para encontrar el conjunto más pequeño de predictores, como los ajustes del proceso, que explica la mayor parte de la variación de la respuesta.
¿Cómo se elige el mejor modelo a partir de la salida de mejores subconjuntos?
Busque el modelo en el que R-Sq(adj) y R-Sq(pred) dejan de aumentar, el Cp de Mallows está cerca del número de coeficientes y S es pequeña. Cuanto menores sean PRESS, AICc y BIC, mejor. Una diferencia grande entre R-Sq y R-Sq(pred) advierte de sobreajuste. Después, compruebe los residuos y los coeficientes del modelo elegido en Fit Regression Model.
¿Qué significa el Cp de Mallows en la regresión de mejores subconjuntos?
El Cp de Mallows compara el error de un modelo con el del modelo completo con todos los predictores. Un modelo con poco sesgo tiene un Cp cercano a k, su número de coeficientes incluida la constante, y el modelo completo siempre tiene un Cp igual a k. Un Cp muy superior a k, como 14.72 para un modelo de 3 coeficientes en el ejemplo, sugiere que falta un predictor importante.
¿Cuántos modelos ajusta la regresión de mejores subconjuntos?
Con p predictores libres hay 2 elevado a p menos 1 subconjuntos, por lo que cada predictor candidato añadido duplica el número de ajustes. Puede limitar el número mínimo y máximo de predictores libres por modelo, forzar predictores conocidos en todos los modelos y elegir cuántos de los mejores modelos de cada tamaño se muestran, de 1 a 5.