
Regresión logística binaria
La regresión logística binaria predice la probabilidad de uno de dos resultados, como aprobado/rechazado o sí/no, a partir de predictores continuos, categóricos o ambos. Úsela cuando la respuesta tenga exactamente dos categorías; las respuestas continuas requieren Ajustar modelo de regresión. Reúna datos suficientes en ambas categorías, evite la separación perfecta y valide con estadísticos de bondad de ajuste y diagnósticos de residuos. Los resultados incluyen intervalos de confianza, del 95% por defecto.
Última revisión:
Idea clave
La regresión logística binaria modela la relación entre uno o más predictores y una respuesta con exactamente dos resultados, como aprobado/rechazado o defectuoso/no defectuoso, y predice la probabilidad de cada resultado.
En esta página
¿Qué es la regresión logística binaria?
La regresión logística binaria es una herramienta estadística que se usa para analizar la relación entre una o más variables predictoras y una variable de respuesta categórica con exactamente dos resultados — como aprobado/rechazado, sí/no o defectuoso/no defectuoso. Predice la probabilidad de que ocurra un resultado frente al otro a partir de los valores de los predictores.
¿Cuándo usar la regresión logística binaria?
Variables predictoras
- Los predictores pueden ser continuos, categóricos o una combinación de ambos
- Las variables discretas pueden tratarse como continuas o categóricas según el número de niveles y el objetivo del análisis
- Solo un predictor continuo con una respuesta continua → use Gráfica de línea ajustada
- Varios predictores con una respuesta continua → use Ajustar modelo de regresión
Variable de respuesta
- La respuesta debe tener exactamente dos categorías (p. ej., aprobado/rechazado, sí/no, bueno/malo)
- Si la respuesta es continua → use Ajustar modelo de regresión
- Si la respuesta tiene tres o más categorías sin orden → use Regresión logística nominal
- Si la respuesta tiene tres o más categorías ordenadas → use Regresión logística ordinal
Pautas para el uso correcto de la regresión logística binaria
- La variable de respuesta debe tener exactamente dos categorías; si tiene más, use en su lugar la regresión logística ordinal o nominal.
- Los predictores pueden ser continuos o categóricos; asegúrese de clasificar correctamente cada variable antes de ejecutar el análisis.
- Asegúrese de que los datos representen con exactitud a la población objetivo; los datos sesgados o incompletos producen predicciones poco fiables.
- Reúna suficientes puntos de datos en ambas categorías — tener muy pocas observaciones en una categoría hace que el modelo sea inestable y que las predicciones no sean fiables.
- Mida todas las variables con la mayor exactitud posible; los errores en los datos de entrada reducen directamente la exactitud de las probabilidades predichas.
- Registre los datos en el orden en que se recopilan para ayudar a identificar patrones temporales que podrían afectar a los resultados.
- Tras el ajuste, valide el modelo con estadísticos de bondad de ajuste y diagnósticos de residuos; un modelo con mal ajuste produce predicciones engañosas.
- Evite la separación perfecta — en la que un predictor separa por completo las dos categorías — ya que causa problemas de estimación en el modelo.
Alternativas: cuándo no usar la regresión logística binaria
- Si la variable de respuesta es continua, use en su lugar Ajustar modelo de regresión .
- Si tiene un solo predictor continuo con una respuesta continua, use en su lugar Gráfica de línea ajustada .
- Si la respuesta tiene tres o más categorías sin orden, use en su lugar Regresión logística nominal .
- Si la respuesta tiene tres o más categorías ordenadas, use en su lugar Regresión logística ordinal .
- Si tiene un predictor categórico con una respuesta continua, use en su lugar ANOVA de un factor .
Cómo realizar una regresión logística binaria
La guía es la siguiente:
- Inicie sesión en Zometric Statistical Software en https://statsai.zometric.com/
- En la página de inicio, elija Statistical Tool>Regression >Binary Logistic Regression .
- Haga clic en Binary Logistic Regression para acceder al tablero.
- A continuación, introduzca los datos manualmente o copie todos los datos (Ctrl+C) de una hoja de Excel y péguelos (Ctrl+V).
- Rellene las opciones necesarias que aparecen en el lado izquierdo.
- Por último, haga clic en calculate en la parte inferior de la página para obtener los resultados deseados.
En el tablero de Binary Logistic Regression, la ventana está dividida en dos partes.
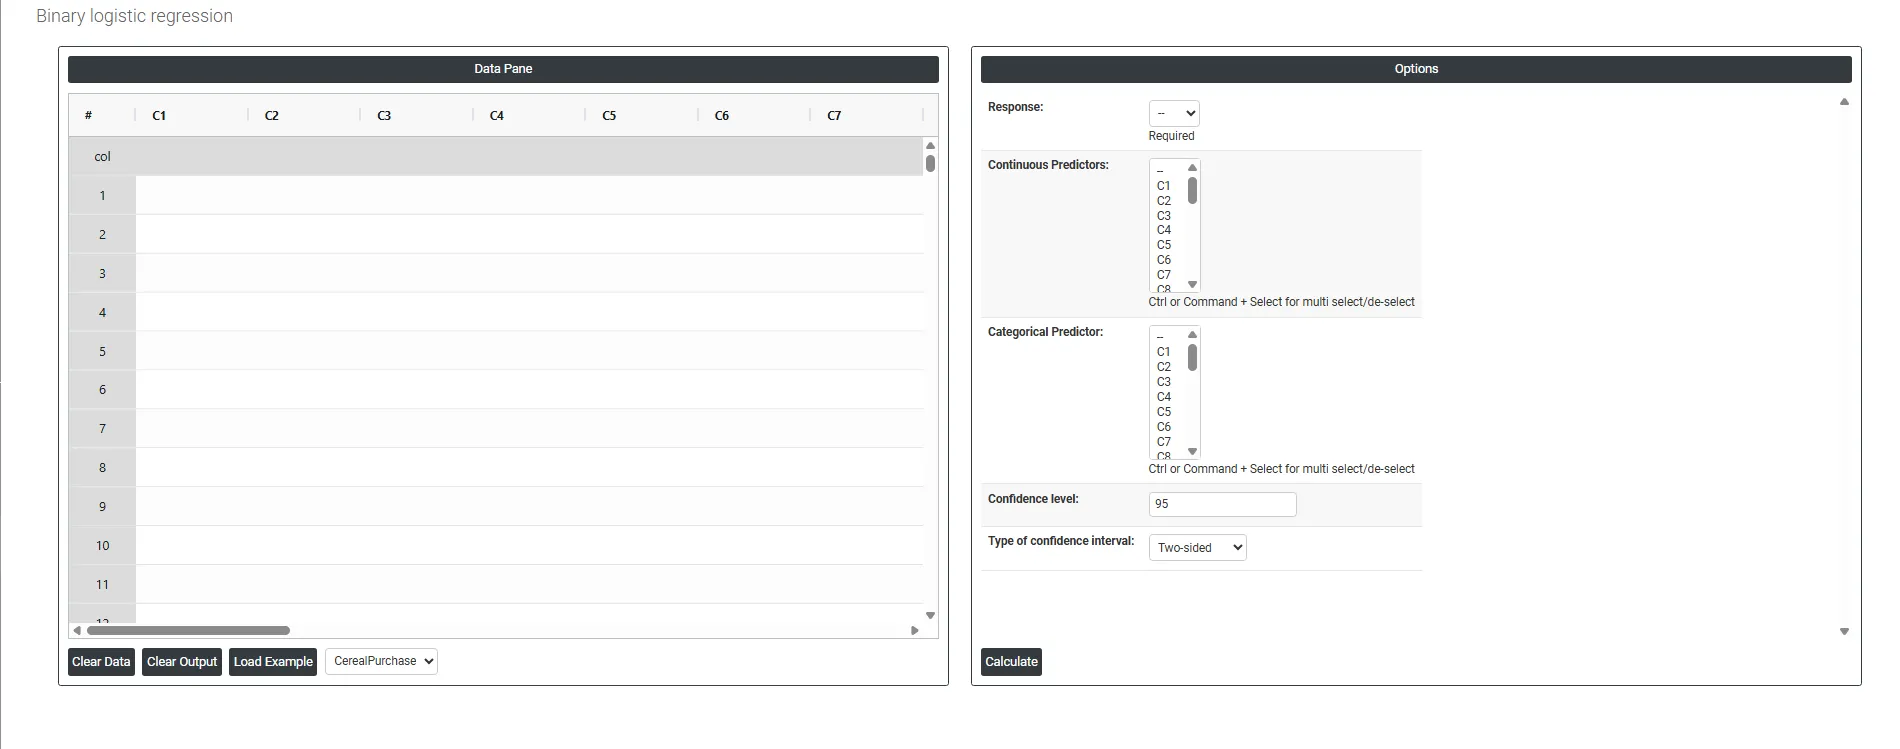
En la parte izquierda se encuentra el panel de datos (Data Pane). En el Data Pane, cada fila forma un subgrupo. Los datos pueden introducirse manualmente o copiarse por completo (Ctrl+C) de una hoja de Excel y pegarse (Ctrl+V) aquí.
Load example: Se cargarán los datos de ejemplo.
Load File: Se usa para cargar directamente los datos de Excel.
En la parte derecha hay varias opciones, como las siguientes:
- Response La variable de resultado que desea predecir; debe contener exactamente dos categorías, como aprobado/rechazado, sí/no o defectuoso/no defectuoso. El modelo calcula la probabilidad de que ocurra una categoría frente a la otra según los valores de los predictores introducidos.
- Categorical Predictor Una variable predictora que contiene un conjunto fijo de grupos o etiquetas distintos, como el turno, el tipo de máquina o el proveedor. El modelo estima cómo cambia la pertenencia a cada grupo la probabilidad de que la respuesta caiga en una categoría frente a la otra.
- Continuous Predictor Una variable predictora que contiene valores numéricos medibles, como la temperatura, la velocidad o el peso. El modelo estima cómo un aumento de una unidad en esta variable aumenta o disminuye la probabilidad de que ocurra el resultado de la respuesta.
- Confidence Interval Un intervalo de valores dentro del cual es probable que se encuentre el resultado verdadero. El valor por defecto es 95%, lo que significa que usted tiene una confianza del 95% de que la probabilidad o el coeficiente verdadero se encuentra dentro de ese intervalo. Se fija en el 95% por defecto por ser el estándar más aceptado, que equilibra la fiabilidad estadística con la utilidad práctica: lo bastante estrecho para ser útil y lo bastante amplio para tener en cuenta la incertidumbre.
- Type of Confidence Interval
- Two-Sided — proporciona un límite inferior y uno superior, y muestra el intervalo donde es probable que se encuentre el valor verdadero en ambos extremos. Úselo cuando desee detectar cualquier diferencia, por encima o por debajo. Es la opción por defecto y la más utilizada.
- Upper Bound — proporciona solo el límite máximo, y muestra el valor más alto que es probable que alcance el resultado verdadero. Úselo cuando solo le interese saber si el valor supera un determinado umbral.
- Lower Bound — proporciona solo el límite mínimo, y muestra el valor más bajo que es probable que tenga el resultado verdadero. Úselo cuando solo le interese saber si el valor queda por debajo de un determinado umbral.
Preguntas frecuentes
¿Qué es la regresión logística binaria?
La regresión logística binaria analiza la relación entre una o más variables predictoras y una respuesta categórica con exactamente dos resultados, como aprobado/rechazado, sí/no o defectuoso/no defectuoso. Predice la probabilidad de que ocurra un resultado frente al otro a partir de los valores de los predictores. Los predictores pueden ser continuos, categóricos o una combinación de ambos.
¿Cuándo debe usar la regresión logística binaria en lugar de otros métodos de regresión?
Úsela cuando la respuesta tenga exactamente dos categorías. Si la respuesta es continua, use Ajustar modelo de regresión, o Gráfica de línea ajustada si hay un solo predictor continuo. Si la respuesta tiene tres o más categorías sin orden, use Regresión logística nominal; para tres o más categorías ordenadas, use Regresión logística ordinal.
¿Cuáles son los requisitos para una regresión logística binaria fiable?
Reúna suficientes puntos de datos en ambas categorías de la respuesta, ya que muy pocas observaciones en una categoría hacen que el modelo sea inestable. Clasifique correctamente cada predictor como continuo o categórico, use datos representativos y medidos con exactitud, y evite la separación perfecta, en la que un predictor separa por completo las dos categorías, porque causa problemas de estimación. Valide el modelo con estadísticos de bondad de ajuste y diagnósticos de residuos.
¿Cómo se ejecuta la regresión logística binaria en Zometric Statistical Software?
Elija Statistical Tool > Regression > Binary Logistic Regression y luego introduzca, pegue o cargue los datos. Seleccione la Response de dos categorías, las columnas de Categorical Predictor y Continuous Predictor que correspondan, establezca el nivel del intervalo de confianza (95% por defecto) y el tipo de intervalo de confianza (bilateral, límite superior o límite inferior), y haga clic en Calculate.