
Diagrama de dispersión agrupado (Binned Scatterplot)
Un diagrama de dispersión agrupado (Binned Scatterplot) es un histograma bidimensional de dos columnas numéricas: cada celda se colorea según cuántos puntos contiene, con una barra de color para los recuentos. Úselo con conjuntos de datos grandes en los que los diagramas de dispersión ordinarios se superponen. Los intervalos por eje se pueden fijar o elegir automáticamente; se requieren al menos dos filas completas. No prueba la correlación.
Última revisión:
Idea clave
Un diagrama de dispersión agrupado divide el plano X-Y en una cuadrícula de rectángulos, cuenta los puntos de cada uno y los colorea según el recuento, mostrando dónde se concentran los datos cuando un diagrama de dispersión se satura.
En esta página
Propósito
Un diagrama de dispersión agrupado (Binned Scatterplot) divide el plano X–Y en una cuadrícula de rectángulos (intervalos o bins), cuenta los puntos de cada uno y colorea el rectángulo según el recuento. Muestra dónde se concentra la mayoría de los datos y cómo varían conjuntamente dos variables, incluso cuando un diagrama de dispersión normal es una mancha de puntos superpuestos. Úselo con conjuntos de datos grandes procedentes de mediciones en línea o de bancos de pruebas, o para ver de un vistazo qué combinaciones de dos propiedades son comunes y cuáles son raras.
Funciones principales
- Histograma bidimensional de dos columnas numéricas cualesquiera.
- Número de intervalos en cada eje definido por usted o elegido automáticamente.
- Barra de color que muestra el recuento correspondiente a cada color, con varias escalas de color a elegir.
- Data Options para excluir filas, o conservar solo ciertas filas, por número de fila o por una condición.
- Gráfica interactivo: al pasar el cursor sobre una celda se ven su rango en X, su rango en Y y su recuento; permite ampliar y descargar como imagen.
Métodos estadísticos
Ambas columnas se convierten en números y se descartan las filas en las que alguno de los valores falta o no es numérico; se requieren al menos dos filas completas. La gráfica es un histograma bidimensional dibujado con Plotly: cada punto se cuenta en el rectángulo que lo contiene, y el color del rectángulo muestra el recuento. X axis bins y Y axis bins indican el mayor número de intervalos deseado en cada eje; la gráfica redondea entonces el ancho del intervalo a un valor limpio (por ejemplo 20, 50 o 200), por lo que el número de intervalos mostrados puede ser menor que el introducido. Si se deja en blanco, los tamaños de intervalo se eligen automáticamente a partir de los datos.
Lectura de la gráfica: una banda de celdas rellenas que va de abajo a la izquierda hacia arriba a la derecha significa que las dos variables aumentan conjuntamente; de arriba a la izquierda hacia abajo a la derecha, que una disminuye cuando la otra aumenta. Las celdas más brillantes muestran la combinación más frecuente. Las celdas aisladas lejos de la banda son puntos inusuales que conviene revisar. La imagen depende del tamaño de los intervalos: con muy pocos se oculta la estructura, y con demasiados la mayoría de las celdas quedan con 0 o 1 punto. Los recuentos no son una prueba de correlación; use Correlation o Regression para cuantificar la relación.
Campos de entrada y opciones
Campo | Descripción |
X-axis column | Obligatorio. Columna numérica para el eje horizontal. |
Y-axis column | Obligatorio. Columna numérica para el eje vertical. |
X axis bins / Y axis bins | Opcional, de 2 a 200. El mayor número de intervalos en ese eje; se calcula automáticamente si se deja en blanco. |
Title | Título que se muestra en la gráfica. Valor predeterminado Binned Scatterplot. |
Color scale | Escala de color para los recuentos. Valor predeterminado Viridis (oscuro para recuentos bajos, amarillo para altos). |
Data Options: Subset (optional) | Exclude matching rows (predeterminado) o Include only matching rows, según Row numbers (p. ej., 3,7,12-15, usando los números de fila originales de la cuadrícula) y/o una Condition (p. ej., Batch_Type == "Standard"). No tiene efecto a menos que se complete Row numbers o Condition. |
Figura 1: dureza en el eje X y resistencia a la tracción en el eje Y, con hasta 6 intervalos en cada eje.
Descripción de la salida
- Binned Scatterplot: una cuadrícula de rectángulos coloreados sobre los rangos de X e Y, con una barra de color Count.
- Exportación a PDF mediante Download.
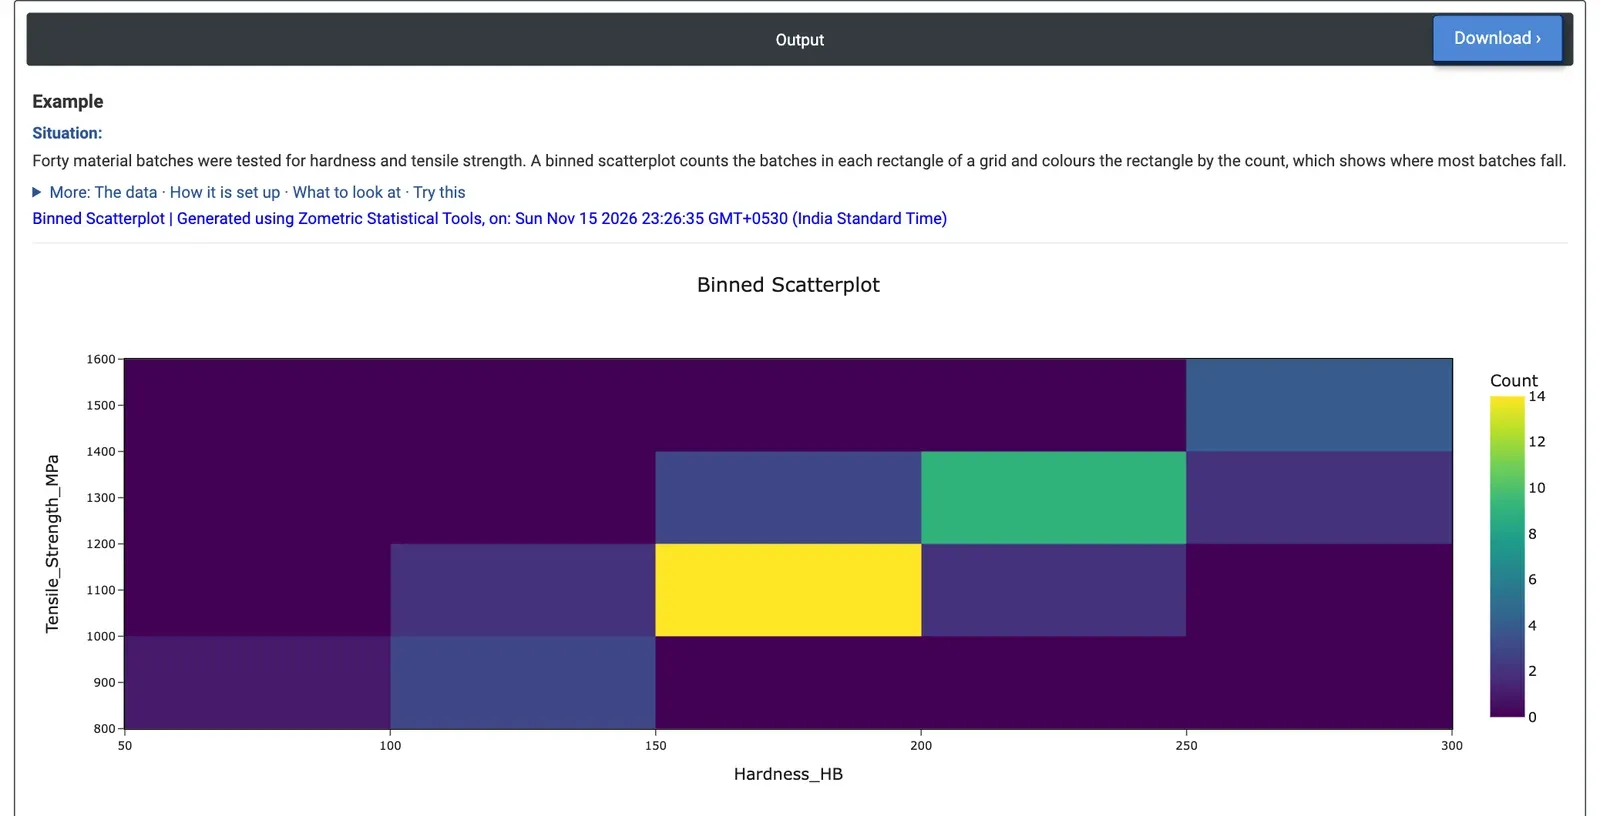
Figura 2: recuentos de 40 lotes de material según dureza y resistencia a la tracción; la celda con más lotes contiene 14.
Ejemplo
Un laboratorio de materiales ha ensayado 40 lotes de material para determinar su dureza Brinell y su resistencia a la tracción. El metalurgista quiere ver dónde se sitúa la mayoría de los lotes y si la dureza puede sustituir al ensayo de tracción, más lento. El metalurgista selecciona X-axis column = Hardness_HB y Y-axis column = Tensile_Strength_MPa, e introduce 6 tanto en X axis bins como en Y axis bins. La gráfica redondea estos valores a intervalos de 50 HB de ancho (de 50 a 300 HB) y 200 MPa de alto (de 800 a 1,600 MPa).
Las celdas rellenas forman una banda de abajo a la izquierda hacia arriba a la derecha: los lotes más duros son más resistentes (la correlación de las dos columnas es 0.99). La celda con más lotes, de 150 a 200 HB con 1,000 a 1,200 MPa, contiene 14 de los 40 lotes. Siguen la de 200 a 250 HB con 1,200 a 1,400 MPa (9 lotes) y la de 250 a 300 HB con 1,400 a 1,600 MPa (4 lotes). Un lote queda solo entre 50 y 100 HB y por debajo de 1,000 MPa: el lote más blando, con 80.1 HB y 822.6 MPa, un lote que conviene revisar.
Para la decisión, esto significa que la dureza sigue de cerca la resistencia en todo el rango, por lo que puede servir como prueba rápida de cribado, reservando los ensayos de tracción para la confirmación. Con 12 intervalos en cada eje, la gráfica usa intervalos de 20 HB y 100 MPa; la banda se divide en celdas más pequeñas y el recuento máximo baja a 7, lo que muestra con más detalle la dispersión dentro de la banda.
Preguntas frecuentes
¿Qué es un diagrama de dispersión agrupado?
Un diagrama de dispersión agrupado es un histograma bidimensional: divide el plano X-Y en una cuadrícula de rectángulos, cuenta los puntos de cada uno y colorea cada rectángulo según su recuento. Muestra dónde se concentra la mayoría de los datos y cómo varían conjuntamente dos variables, incluso cuando un diagrama de dispersión ordinario es una mancha de puntos superpuestos.
¿Cuándo conviene usar un diagrama de dispersión agrupado en lugar de un diagrama de dispersión?
Úselo con conjuntos de datos grandes, como los procedentes de mediciones en línea o de bancos de pruebas, en los que los puntos se superponen tanto que un diagrama de dispersión normal oculta dónde se concentran los datos. También muestra de un vistazo qué combinaciones de dos propiedades son comunes y cuáles son raras.
¿Cómo se lee un diagrama de dispersión agrupado?
Una banda de celdas rellenas de abajo a la izquierda hacia arriba a la derecha significa que las dos variables aumentan conjuntamente; de arriba a la izquierda hacia abajo a la derecha, que una disminuye cuando la otra aumenta. Las celdas más brillantes son las combinaciones más frecuentes, y las celdas aisladas lejos de la banda son puntos inusuales que conviene revisar. Los recuentos no son una prueba de correlación; para eso use Correlation o Regression.
¿Cuántos intervalos debe usar un diagrama de dispersión agrupado?
La imagen depende del tamaño de los intervalos: con muy pocos se oculta la estructura, y con demasiados la mayoría de las celdas quedan con 0 o 1 punto. Puede introducir de 2 a 200 intervalos por eje o dejarlos en blanco para el dimensionamiento automático. La gráfica redondea los anchos de intervalo a valores limpios, por lo que pueden mostrarse menos intervalos de los introducidos.