
Gráfica de caja (boxplot)
Una gráfica de caja, o gráfica de caja y bigotes, es una representación gráfica que muestra la distribución de un conjunto de datos. Consiste en una caja que va del primer cuartil (Q1) al tercer cuartil (Q3), con una línea horizontal que indica la mediana de la muestra.
Última revisión:
Idea clave
Una gráfica de caja, o gráfica de caja y bigotes, es una representación gráfica que muestra la distribución de un conjunto de datos.
En esta página
¿Qué es una gráfica de caja?
Una gráfica de caja, o gráfica de caja y bigotes, es una representación gráfica que muestra la distribución de un conjunto de datos. Consiste en una caja que va del primer cuartil (Q1) al tercer cuartil (Q3), con una línea horizontal que indica la mediana de la muestra. El rango intercuartílico (IQR) es la diferencia entre Q1 y Q3. Los bigotes se extienden desde la caja hasta los puntos de datos más externos dentro del intervalo de Q1 - 1.5IQR a Q3 + 1.5IQR, mientras que los puntos fuera de este intervalo se consideran valores atípicos y se representan individualmente. Las gráficas de caja son no paramétricos: ilustran la variación de la muestra sin suponer ninguna distribución estadística específica, y funcionan mejor con tamaños de muestra de al menos 20.
¿Cuándo usar una gráfica de caja?
Las gráficas de caja se usan habitualmente en el análisis y la visualización de datos con varios fines. Estas son algunas situaciones en las que resultan especialmente útiles:
- Para mostrar distribuciones de valores de datos numéricos, sobre todo cuando se desea compararlas entre varios grupos.
- Comparación de distribuciones: Cuando necesita comparar la distribución de un conjunto de datos entre distintos grupos o categorías, las gráficas de caja ofrecen una comparación visual clara de medianas, variabilidad y valores atípicos.
- Identificación de valores atípicos: Las gráficas de caja son eficaces para detectar valores atípicos en los datos. Los puntos representados más allá de los bigotes indican posibles valores atípicos que pueden requerir una investigación adicional.
- Resumen de conjuntos de datos grandes: En conjuntos de datos grandes, las gráficas de caja ofrecen un resumen conciso de la tendencia central, la variabilidad y la distribución general, sin la saturación que producen los puntos de datos individuales.
- Evaluación de la simetría y la asimetría: La posición de la línea de la mediana dentro de la caja y la longitud de los bigotes permiten evaluar rápidamente si los datos son simétricos o asimétricos.
- Comparación de varios conjuntos de datos: Cuando tiene varios conjuntos de datos y desea comparar sus distribuciones lado a lado, las gráficas de caja ofrecen una forma estandarizada de presentar esta información de manera clara y eficiente.
- Datos no paramétricos: Las gráficas de caja son útiles cuando no desea hacer suposiciones sobre la distribución estadística subyacente de los datos, ya que son no paramétricos.
- Análisis exploratorio de datos (EDA): En las etapas iniciales del análisis de datos, las gráficas de caja ayudan a comprender las características generales de los datos, como la dispersión, la tendencia central y la presencia de valores atípicos.
Pautas para el uso correcto de la gráfica de caja
- Si el tamaño de muestra es demasiado pequeño, la gráfica de caja puede no mostrar cuartiles ni valores atípicos significativos.
- Para tamaños de muestra menores de 20, considere usar una gráfica de valores individuales.
- Los datos de la muestra deben seleccionarse aleatoriamente y usarse para hacer inferencias sobre una población.
- Una recopilación de datos no aleatoria puede dar resultados que no representen a la población.
Alternativas: cuándo no usar una gráfica de caja
- Histogramas: Los histogramas son más adecuados que las gráficas de caja cuando necesita una visión más detallada de la distribución, desea analizar intervalos o rangos específicos, detectar patrones multimodales, trabajar con conjuntos de datos grandes o comprender la asimetría de la distribución.
- Diagrama de dispersión: Los diagramas de dispersión son más adecuados que las gráficas de caja cuando necesita analizar la relación entre dos variables continuas, detectar valores atípicos, identificar relaciones no lineales, revelar heterocedasticidad o detectar patrones de agrupamiento en los datos.
- Gráficas de barras: Las gráficas de barras son más adecuadas que las gráficas de caja cuando necesita mostrar datos categóricos o datos ordinales en los que los intervalos entre categorías no tienen significado. Simplifican la visualización para públicos no especializados en estadística.
Ejemplo de gráfica de caja
El objetivo de un fabricante de fertilizantes para plantas es desarrollar una fórmula que maximice el crecimiento en altura de las plantas. Para probar distintas fórmulas de fertilizante, una científica prepara tres grupos de 50 plántulas idénticas. Estos grupos incluyen un grupo de control sin fertilizante, un grupo tratado con el fertilizante del fabricante, llamado GrowFast, y un grupo tratado con el fertilizante de un competidor, llamado SuperPlant. Tras permanecer tres meses en un invernadero de ambiente controlado, la científica mide la altura de las plantas.
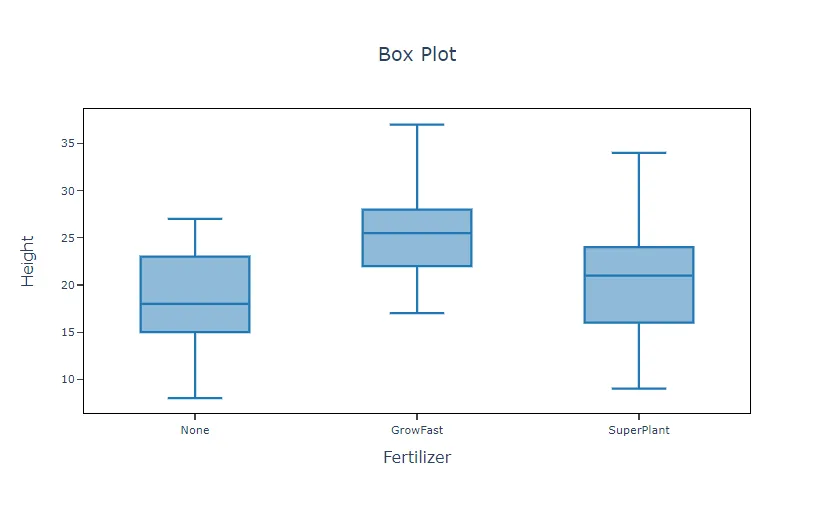
Como parte de la investigación inicial, la científica construye una gráfica de caja que representa la altura de las plantas de los tres grupos. Esta gráfica de caja se usa para evaluar las variaciones del crecimiento de las plantas entre el grupo sin fertilizante, el grupo tratado con el fertilizante del fabricante y el grupo tratado con el fertilizante del competidor. Los pasos fueron los siguientes:
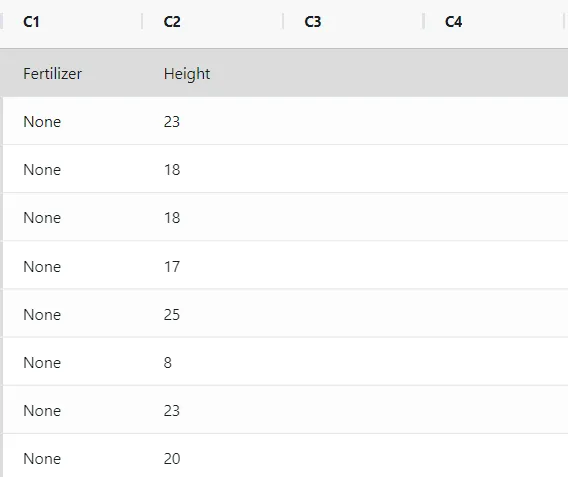
- Recopiló los datos necesarios.
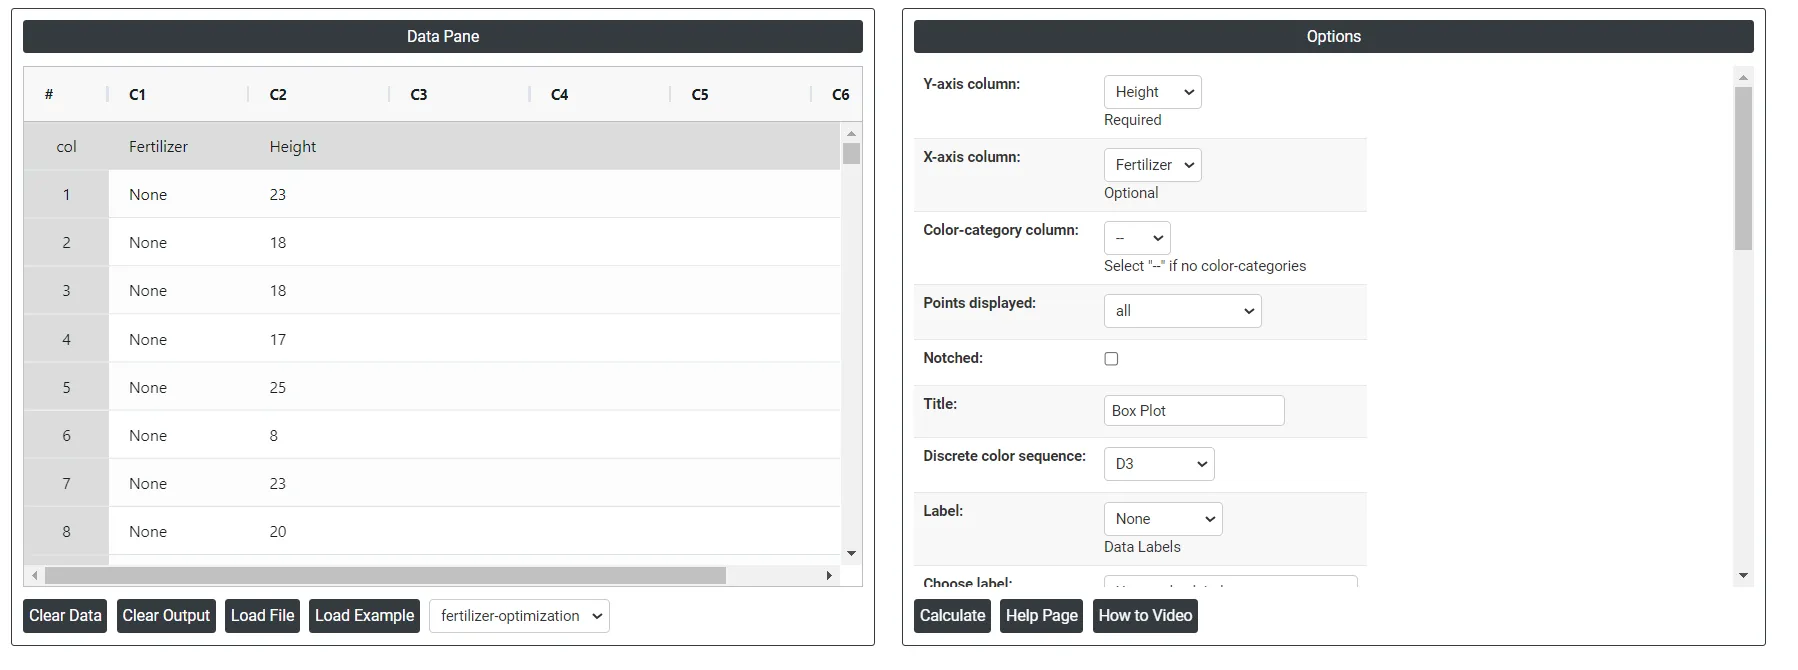
- Ahora analice los datos en Zometric Statistical Software en https://statsai.zometric.com/.
- Para encontrar la gráfica de caja, elija Statistical module> Graphical analysis> Boxplot Chart.
- Dentro de la herramienta, introduzca los datos junto con las demás entradas como se indica a continuación:
- Después de usar la herramienta mencionada, se obtiene la siguiente salida:
Cómo crear una gráfica de caja
La guía es la siguiente:
- Inicie sesión en Zometric Statistical Software en https://statsai.zometric.com/
- En la página de inicio, elija Statistical Tool> Graphical analysis >Boxplot Chart.
- A continuación, introduzca los datos manualmente o copie todos los datos (Ctrl+C) de una hoja de Excel y péguelos (Ctrl+V). También existe la opción Load Example, que carga los datos de ejemplo.
- A continuación, debe asignar las columnas a los parámetros.
- Por último, haga clic en calculate en la parte inferior de la página para obtener los resultados deseados.
En el tablero de la gráfica de caja, la ventana está dividida en dos partes.
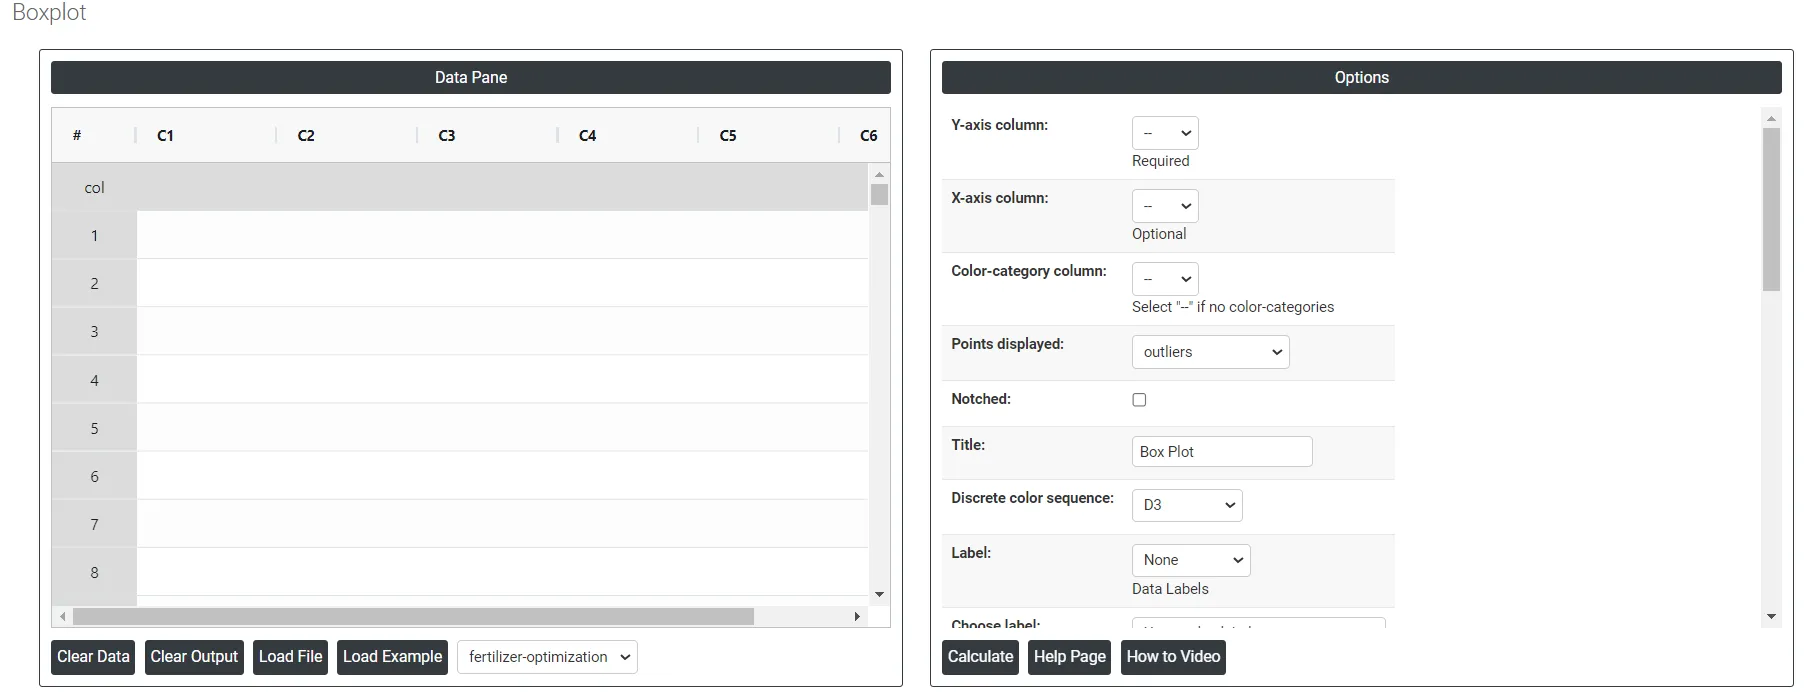
En la parte izquierda se encuentra el panel de datos (Data Pane). En el Data Pane, cada fila forma un subgrupo. Los datos pueden introducirse manualmente, o bien copiarse por completo (Ctrl+C) desde una hoja de Excel y pegarse (Ctrl+V) aquí.
Load example: Se cargarán los datos de ejemplo.
Load File: Se usa para cargar directamente los datos de Excel.
En la parte derecha hay numerosas opciones, como las siguientes:
Y-axis column: Representa una variable numérica. Esta variable numérica suele ser una medición o un conteo que se desea analizar o comparar entre distintas categorías o grupos.
X-axis column: Representa variables categóricas o grupos. Estas categorías no suelen ser numéricas y representan distintos grupos o niveles dentro de los datos que se desea comparar.
Color-category column: Las categorías se muestran diferenciadas por colores.
Points displayed: Muestra los puntos de los valores atípicos, de los posibles valores atípicos o de ambos a la vez.
Notched: Indica qué tan densa es la parte central de los datos.
Discrete color sequence: Sirve para diferenciar varios grupos o categorías y facilitar la comparación de sus distribuciones. Mejora la claridad y la legibilidad al distinguir visualmente cada grupo. La codificación por colores también puede resaltar puntos de datos o subgrupos específicos y aportar información adicional. Este enfoque mejora el atractivo visual de la gráfica y facilita interpretaciones más rápidas y precisas.
Label: Genera las etiquetas de datos y contiene tres opciones:
- Outlier: Valores de datos muy alejados de los demás, que pueden afectar considerablemente a los resultados.
- All quartiles: Los cuartiles son valores que dividen una muestra de datos en cuatro partes iguales. Permiten evaluar rápidamente la dispersión y la tendencia central de un conjunto de datos.
- Mean: La media en una gráfica de caja aporta información adicional sobre la tendencia central de los datos.
Choose label: Contiene dos opciones:
- Use Y value labels: Etiqueta el valor Y en la gráfica de caja.
- Use labels from selected column: Etiqueta la gráfica de caja con la columna seleccionada.
Interquartile range box: La caja del rango intercuartílico representa el 50% central de los datos. Muestra la distancia entre el primer y el tercer cuartil (Q3-Q1).
Range box: Se extiende desde el valor mínimo hasta el valor máximo. También se conoce como caja del rango intercuartílico (IQR).
Median Line: Las líneas de la mediana se etiquetan con las medianas (valores y).
Mean Line: Proporciona puntos de referencia en la gráfica.
Mean Symbol: Representa la media de los datos.
Median Symbol: Representa la mediana de los datos.
X-axis line(low): La línea del eje X (inferior) en una gráfica de caja, o bigote inferior, indica el valor más bajo dentro de 1.5 veces el rango intercuartílico (IQR) por debajo del primer cuartil (Q1) y ayuda a identificar valores atípicos por debajo de este umbral. Ofrece información sobre la cola inferior de la distribución y facilita el análisis comparativo de la dispersión de los datos entre grupos.
X-axis line (low & high): La línea del eje X (inferior y superior) en una gráfica de caja representa lo siguiente:
- Low Value: Es el valor mínimo del conjunto de datos, sin contar los valores atípicos.
- High Value: Es el valor máximo del conjunto de datos, sin contar los valores atípicos.
Y-axis line(low): Representa el valor mínimo del conjunto de datos, sin contar los valores atípicos. Ayuda a visualizar el punto más bajo dentro del rango normal de los datos.
Y-axis line (low & high): Las líneas del eje Y (inferior y superior) representan el rango de los datos e indican los valores mínimo y máximo (sin contar los valores atípicos). Ayudan a visualizar la dispersión y la variabilidad del conjunto de datos y ofrecen un resumen rápido de su distribución.
X-axis tick(low): Etiqueta el extremo inferior del eje X. Aporta contexto sobre la distribución de los puntos de datos en el rango inferior.
Y-axis tick(low): Muestra el valor mínimo del conjunto de datos. Ayuda a identificar posibles valores atípicos al mostrar el punto de datos más bajo dentro del bigote.
X-axis tick labels(low): Se usan para indicar las categorías o grupos que se comparan. Garantizan una identificación clara de cada categoría cuando el espacio es limitado y mejoran la legibilidad.
Y-axis tick labels(low): Se usan para marcar y mostrar los valores mínimos de los conjuntos de datos representados. Ayudan a identificar los puntos de datos más bajos de cada categoría o grupo y ofrecen una comprensión clara de la distribución de los datos y de los valores atípicos.
Gridlines on X-axis ticks: Muestra las líneas de referencia en los valores de X.
Gridlines on Y-axis ticks: Muestra las líneas de referencia en los valores de Y.
Download as Excel: Muestra el resultado en formato Excel, que puede editarse fácilmente y volver a cargarse para los cálculos mediante la opción load file.
Preguntas frecuentes
¿Qué es una gráfica de caja?
Una gráfica de caja, o gráfica de caja y bigotes, muestra la distribución de un conjunto de datos. La caja va del primer cuartil (Q1) al tercer cuartil (Q3), con una línea en la mediana. Los bigotes se extienden hasta los puntos más externos dentro de Q1 - 1.5 IQR y Q3 + 1.5 IQR, donde IQR es Q3 - Q1, y los puntos situados más allá se representan individualmente como valores atípicos.
¿Cómo se interpreta una gráfica de caja?
La caja contiene el 50% central de los datos y la línea que hay dentro es la mediana. Cajas y bigotes más largos indican mayor dispersión. La posición de la mediana dentro de la caja y la longitud de los bigotes muestran si los datos son simétricos o asimétricos. Los puntos situados más allá de los bigotes son posibles valores atípicos que conviene investigar.
¿Cuántos datos se necesitan para una gráfica de caja?
Las gráficas de caja funcionan mejor con tamaños de muestra de al menos 20. Con muy pocos puntos, los cuartiles y los valores atípicos pueden no ser significativos; para muestras menores de 20, considere en su lugar una gráfica de valores individuales. Los datos deben seleccionarse aleatoriamente para que la gráfica represente a la población.
¿Cuándo conviene usar un histograma en lugar de una gráfica de caja?
Use un histograma cuando necesite una visión más detallada de la distribución, quiera examinar intervalos específicos o necesite detectar patrones multimodales. Use un diagrama de dispersión para estudiar la relación entre dos variables continuas. Las gráficas de caja son la mejor opción para comparar medianas, dispersión y valores atípicos de varios grupos lado a lado.