
Prueba de independencia chi-cuadrado (tabulación cruzada)
La prueba de independencia chi-cuadrado contrasta si dos variables categóricas están asociadas, a partir de una tabla de conteos de doble entrada resumida o de registros sin procesar. Compara los conteos observados con los esperados bajo independencia usando chi-cuadrado de Pearson y de razón de verosimilitud con (r − 1)(c − 1) grados de libertad. Las contribuciones y los residuos ajustados muestran qué celdas originan el resultado. Los conteos esperados no deben ser demasiado pequeños.
Última revisión:
Idea clave
La prueba de independencia chi-cuadrado comprueba si dos variables categóricas están relacionadas, por ejemplo si la mezcla de tipos de defecto depende del turno, el proveedor o la línea, y muestra qué celdas originan la asociación.
En esta página
Finalidad
La prueba de independencia chi-cuadrado comprueba si dos variables categóricas están relacionadas, por ejemplo si la mezcla de tipos de defecto depende del turno, del proveedor o de la línea. Introduzca una tabla de conteos ya resumida, o los registros sin procesar con una fila por unidad, y la herramienta prueba la asociación y muestra qué celdas la originan.
Capacidades principales
- Tabla de doble entrada resumida (una columna por categoría de columna, una fila por categoría de fila) o datos categóricos sin procesar con frecuencias opcionales.
- Pruebas chi-cuadrado de Pearson y de razón de verosimilitud.
- Tablas opcionales de conteos esperados, contribuciones al chi-cuadrado, residuos sin procesar, estandarizados y ajustados, y porcentajes por fila, por columna y del total.
- Interpretación guiada opcional: informe resumen con perfiles porcentuales y gráficas de % de diferencia, informe de diagnóstico y tarjeta de informe.
- Data Options: seleccione un subconjunto de filas antes del análisis.
Métodos estadísticos
Para una tabla de r × c con conteos observados O, totales de fila Rᵢ, totales de columna Cⱼ y total general N, el conteo esperado bajo independencia es Eᵢⱼ = Rᵢ·Cⱼ / N. El estadístico de Pearson es χ² = Σ (O − E)² / E, y el estadístico de razón de verosimilitud es G² = 2 Σ O·ln(O / E). Ambos se comparan con una distribución chi-cuadrado con (r − 1)(c − 1) grados de libertad. Un valor p pequeño significa que las variables de fila y de columna están asociadas: la mezcla de columnas no es la misma en todas las filas.
La contribución de cada celda (O − E)² / E muestra de dónde procede la asociación. El residuo sin procesar es O − E, el residuo estandarizado es (O − E) / √E y el residuo ajustado es (O − E) / √(E(1 − Rᵢ/N)(1 − Cⱼ/N)), que es aproximadamente normal estándar: los valores más allá de aproximadamente ±2 señalan celdas que difieren claramente de la independencia. Con datos sin procesar, la herramienta tabula primero de forma cruzada las dos columnas, sumando la columna de frecuencias si se indica una; las celdas en blanco se omiten. Debe eliminarse toda fila o columna con total cero. El valor p es fiable cuando los conteos esperados no son demasiado pequeños; la interpretación guiada lo comprueba.
Campos de entrada y opciones
Campo | Descripción |
Data | Summarized data in a two-way table (predeterminado) o Raw data (categorical variables). |
Columns (one per column-category) | Disposición de tabla: dos o más columnas numéricas, cada una con los conteos de una categoría de la variable de columna, una fila por categoría de fila. Obligatorio. |
Row labels | Disposición de tabla, opcional: una columna que nombra cada categoría de fila; en blanco da Row 1, Row 2, … |
Rows / Columns / Frequencies (optional) | Disposición sin procesar: las dos columnas categóricas y una columna opcional de conteos para cada registro. |
Statistics | Expected cell counts y Each cell's contribution to chi-square (marcadas por defecto); Raw residuals, Standardized residuals, Adjusted residuals, Row percents, Column percents, Total percents. |
Data Options: Subset (optional) | Exclude matching rows (predeterminado) o Include only matching rows, por números de fila y/o una condición. |
Show guided interpretation | Añade un Summary, un Diagnostic y un Report Card en lenguaje sencillo; Difference between the % defectives with practical value es una entrada opcional para ello. |
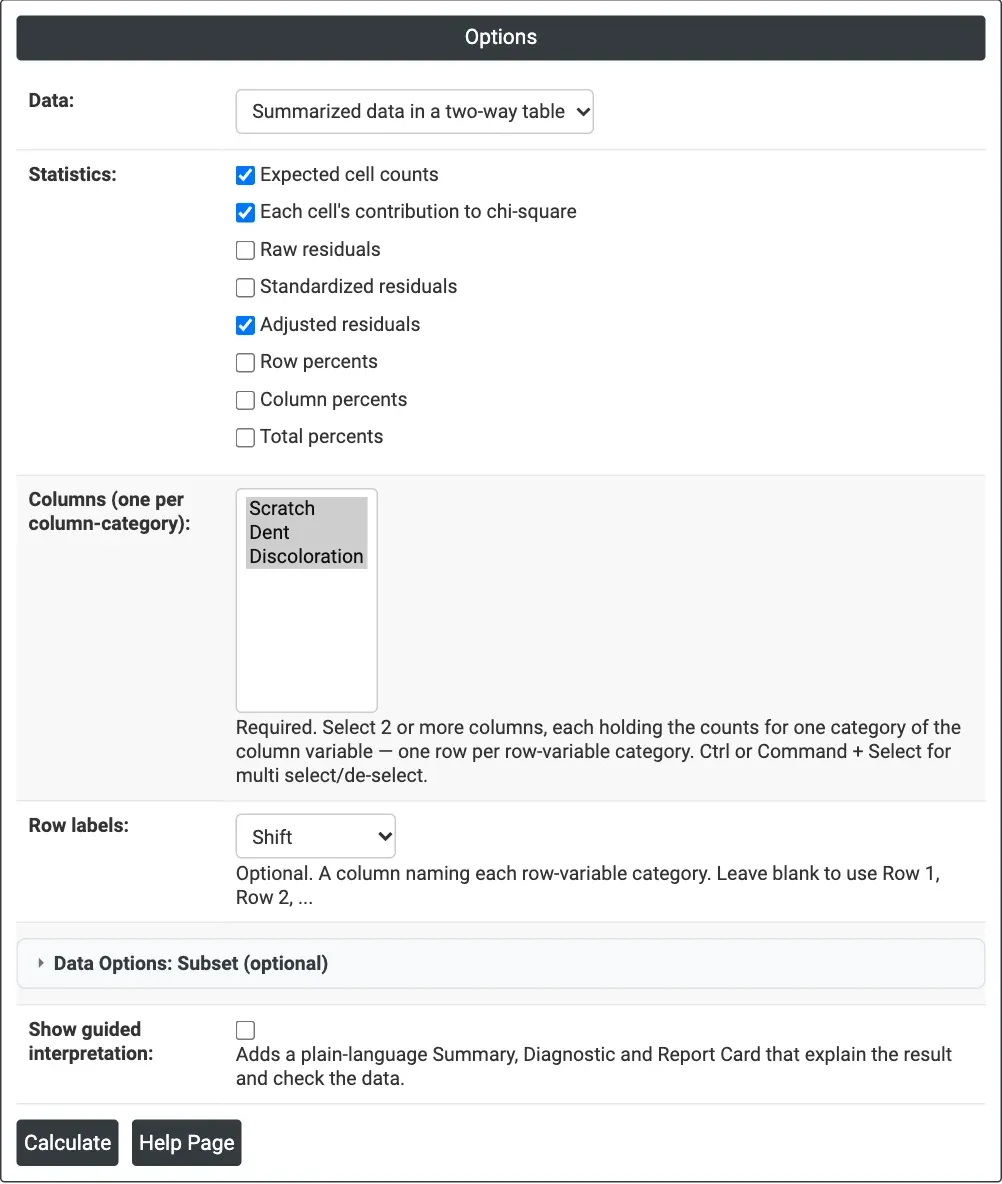
Figura 1 — Opciones del ejemplo de tipos de defecto: una tabla resumida con los conteos de Scratch, Dent y Discoloration como columnas y Shift como etiquetas de fila, con Adjusted residuals marcado.
Descripción de la salida
- Observed Counts — la tabla con los totales de fila y de columna (All).
- Expected Counts y Contribution to Chi-Square — cuando están marcadas.
- Chi-Square Tests — Chi-Sq, DF y P-Value de las pruebas de Pearson y de razón de verosimilitud.
- Raw Residuals, Standardized Residuals, Adjusted Residuals, Row Percents, Column Percents y Total Percents — cuando están marcadas.
- Summary Report, Diagnostic Report y Report Card — con la interpretación guiada.
- Exportación a PDF mediante Download.
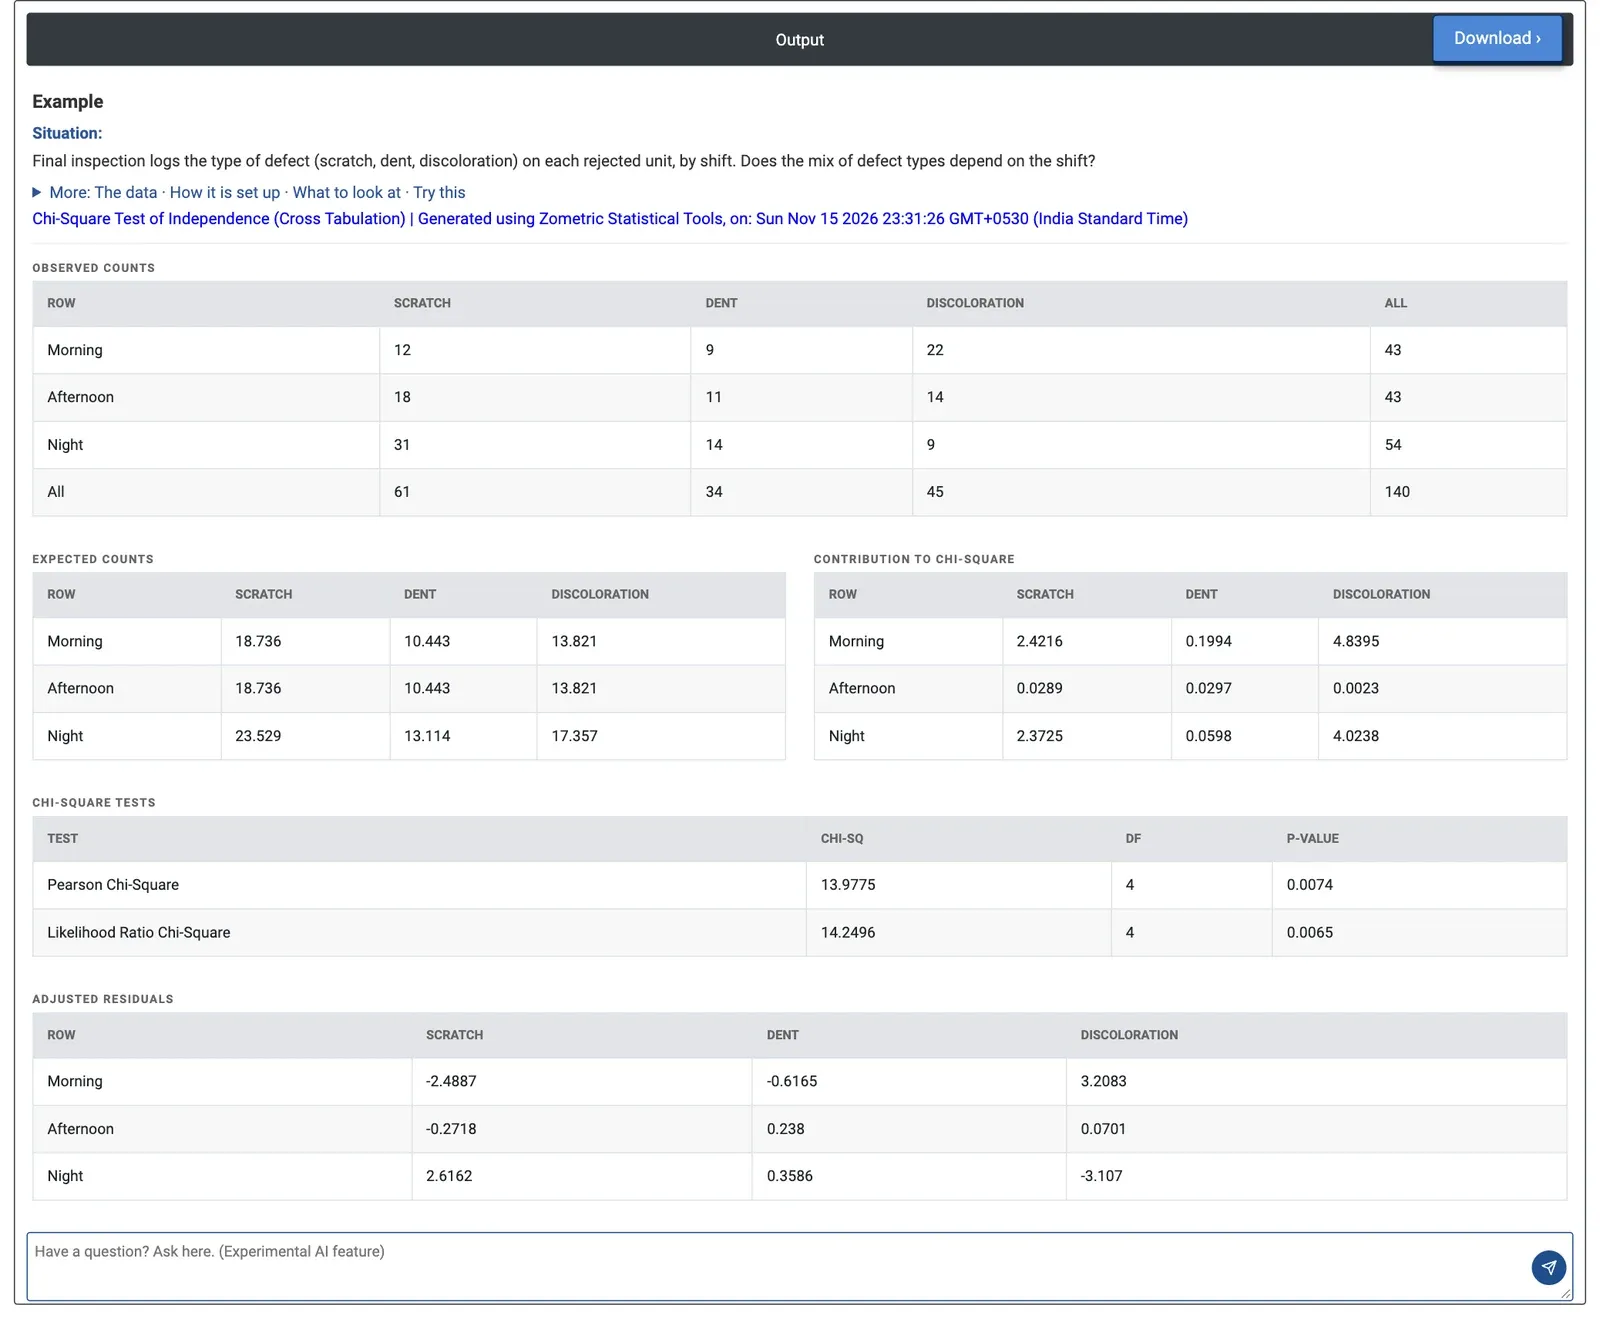
Figura 2 — Tipo de defecto por turno: chi-cuadrado de Pearson 13.98 con 4 DF, p = 0.0074; los residuos ajustados señalan la decoloración en el turno de la mañana y los rayones en el turno de la noche.
Ejemplo
La inspección final registra el tipo de defecto de cada unidad rechazada, por turno: 140 rechazos en total. El equipo de calidad quiere saber si la mezcla de tipos de defecto depende del turno. Introducen los conteos como una tabla con una columna por tipo de defecto (Scratch, Dent, Discoloration) y Shift como etiquetas de fila, y marcan Adjusted residuals además de los estadísticos por defecto.
La mezcla de defectos sí depende del turno: chi-cuadrado de Pearson 13.98 con 4 DF, p = 0.0074 (razón de verosimilitud 14.25, p = 0.0065). Las contribuciones muestran dónde: la decoloración en el turno de la mañana (4.84; 22 observados frente a 13.8 esperados) y en el turno de la noche (4.02; 9 frente a 17.4), y luego los rayones en los turnos de la mañana (2.42; 12 frente a 18.7) y de la noche (2.37; 31 frente a 23.5). El turno de la tarde coincide con la mezcla global, y las abolladuras se reparten de forma uniforme.
Los residuos ajustados lo confirman: 3.21 para la decoloración de la mañana y 2.62 para los rayones de la noche superan con creces el valor 2. El equipo investiga qué cambia al comienzo del día (por ejemplo, el calentamiento o un lote de pintura distinto) en el caso de la decoloración, y la manipulación y la iluminación del turno de la noche en el caso de los rayones. Todos los conteos esperados son superiores a 10, por lo que el valor p es fiable.
Preguntas frecuentes
¿Cómo se calcula el conteo esperado en una prueba de independencia chi-cuadrado?
Bajo independencia, el conteo esperado de una celda es su total de fila multiplicado por su total de columna y dividido entre el total general, E = R x C / N. El estadístico de Pearson suma (O − E)² / E en todas las celdas y se compara con una distribución chi-cuadrado con (r − 1)(c − 1) grados de libertad, donde r y c son los números de filas y de columnas.
¿Cómo se interpreta una prueba de independencia chi-cuadrado?
Un valor p pequeño significa que las variables de fila y de columna están asociadas: la mezcla de columnas no es la misma en todas las filas. Para ver de dónde procede la asociación, observe la contribución de cada celda (O − E)² / E y los residuos ajustados, que son aproximadamente normales estándar; los valores más allá de aproximadamente ±2 señalan celdas que difieren claramente de la independencia.
¿Qué formato de datos necesita la prueba?
En Zometric Statistical Software puede introducir una tabla de doble entrada resumida, con una columna numérica por categoría de columna y una fila por categoría de fila, o datos sin procesar con dos columnas categóricas y una columna de frecuencias opcional. Con datos sin procesar, la herramienta tabula primero de forma cruzada las dos columnas. Debe eliminarse toda fila o columna con total cero.
¿Cuándo es fiable el valor p de la prueba chi-cuadrado?
El valor p es fiable cuando los conteos esperados no son demasiado pequeños, y la interpretación guiada opcional lo comprueba. En el ejemplo de tipo de defecto por turno, todos los conteos esperados eran superiores a 10, por lo que el valor p de Pearson de 0.0074 con 4 grados de libertad era fiable.