
Conglomerado de K medias (K-Means)
El conglomerado de K medias agrupa observaciones de dos o más variables numéricas en K conglomerados que usted define, mediante el método de Lloyd con centros iniciales k-means++ y varios inicios aleatorios. Estandarice las variables medidas en unidades distintas. Úselo cuando espere un número conocido de grupos. La salida incluye la partición final, los centroides, el conglomerado y la distancia de cada observación, y el porcentaje de variación explicada.
Última revisión:
Idea clave
El conglomerado de K medias divide las observaciones en un número fijo de grupos (K) de modo que las de cada grupo sean lo más parecidas posible en las variables elegidas, por ejemplo para clasificar lotes, piezas o proveedores en tipos.
En esta página
Propósito
El conglomerado de K medias divide las observaciones en un número fijo de grupos (K) de modo que las observaciones de cada grupo sean lo más parecidas posible en las variables que usted elija. Úselo cuando espere un número conocido de grupos, por ejemplo para clasificar lotes de material, piezas o proveedores en tipos a partir de varias propiedades medidas, o para comprobar si una etiqueta que ya utiliza (grado, línea, turno) se refleja en absoluto en las mediciones.
Funciones principales
- Agrupa observaciones de dos o más variables numéricas en K conglomerados que usted define.
- Estandarización opcional, para que una variable medida en unidades grandes no domine la agrupación.
- Varios puntos de partida aleatorios; se conserva la mejor solución (menor dispersión dentro de los conglomerados), y los mismos datos siempre dan el mismo resultado.
- Informa la partición final (tamaño, suma de cuadrados dentro del conglomerado, distancia promedio y máxima al centroide), el centroide de cada conglomerado en las unidades originales, el conglomerado de cada observación y el porcentaje de la variación total explicada por los conglomerados.
- Diagrama de dispersión de las dos primeras variables seleccionadas, coloreado por conglomerado.
Métodos estadísticos
Se descartan las filas con un valor ausente o no numérico en cualquiera de las variables seleccionadas. Cuando Standardize variables está marcada, cada variable se convierte a z = (x − media) / s, usando la desviación estándar muestral s, de modo que todas las variables tengan media 0 y desviación estándar 1 antes de formar los conglomerados.
El algoritmo de K medias (método de Lloyd) asigna cada observación al centro de conglomerado más cercano según la distancia euclidiana, recalcula cada centro como la media de sus miembros y se repite hasta que las asignaciones dejan de cambiar. Los centros iniciales se eligen con la regla k-means++. Como el resultado puede depender del inicio, el algoritmo se ejecuta tantas veces como indique Number of random starts y se conserva la ejecución con la menor suma de cuadrados dentro de los conglomerados. Se usa una semilla aleatoria fija, por lo que los resultados se repiten exactamente.
El porcentaje de variación explicada por los conglomerados es (SC total − SC dentro de los conglomerados) / SC total × 100, donde la SC total es la suma de los cuadrados de las distancias de todas las observaciones a la media general y la SC dentro de los conglomerados es la suma de los cuadrados de las distancias de cada observación al centro de su propio conglomerado. Ambas se miden sobre los datos tal como se agruparon (estandarizados cuando esa opción está marcada). Una cifra mayor significa grupos más distintos y compactos, pero siempre aumenta al crecer K, por lo que debe compararse entre valores de K con cuidado. Los centroides se convierten de nuevo a las unidades originales para el informe. La partición final da, para cada conglomerado, el número de observaciones, la suma de cuadrados dentro del conglomerado y la distancia promedio y máxima de sus miembros al centroide; estas distancias, y la distancia de cada observación en la tabla de pertenencia, son distancias euclidianas en las unidades con que se agrupó (estandarizadas cuando esa opción está marcada), como en Minitab.
Campos de entrada y opciones
Campo | Descripción |
Variables | Dos o más columnas numéricas para formar los conglomerados. Ctrl o Command + clic para seleccionar varias. |
Number of clusters (K) | Cuántos grupos formar. Por defecto 3; mínimo 2. Se necesitan al menos K observaciones completas. |
Standardize variables | Marcada por defecto. Pone todas las variables en la misma escala (media 0, desviación estándar 1) antes de agrupar. Desmárquela solo cuando todas las variables compartan las mismas unidades y desee que las de mayor dispersión tengan más peso. |
Number of random starts | Cuántos puntos de partida probar; se conserva el mejor resultado. Por defecto 10, de 1 a 100. |
Title | Título que se muestra en la gráfica y en la salida. Por defecto Cluster K-Means. |
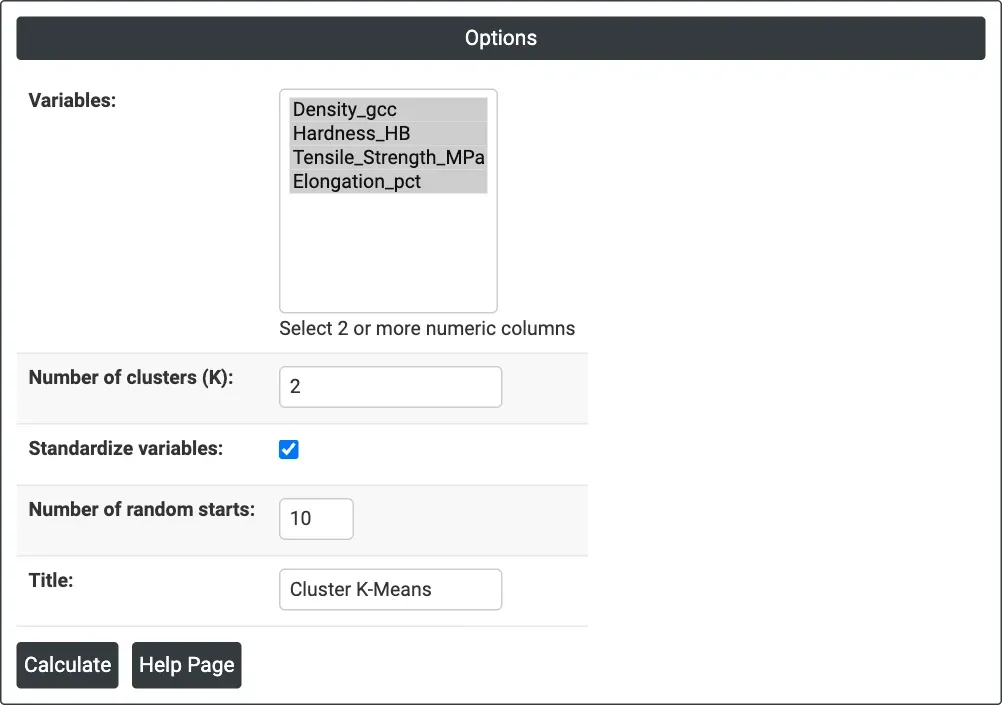
Figura 1: opciones del ejemplo: las cuatro columnas de propiedades, K = 2, estandarizadas, 10 inicios aleatorios.
Descripción de la salida
- Cluster K-Means plot — diagrama de dispersión de la primera variable seleccionada (x) frente a la segunda (y), con cada punto coloreado según su conglomerado.
- % variation explained by clusters — la proporción de la variación total que se encuentra entre los conglomerados y no dentro de ellos.
- Final Partition — para cada conglomerado: Number of observations, Within cluster sum of squares, Average distance from centroid y Maximum distance from centroid.
- Cluster Centroids — para cada conglomerado, su número N de observaciones y la media de cada variable en las unidades originales.
- Cluster Membership — cada observación (por fila de la hoja de cálculo), su conglomerado y su distancia al centroide de ese conglomerado.
- Exportación a PDF mediante Download.
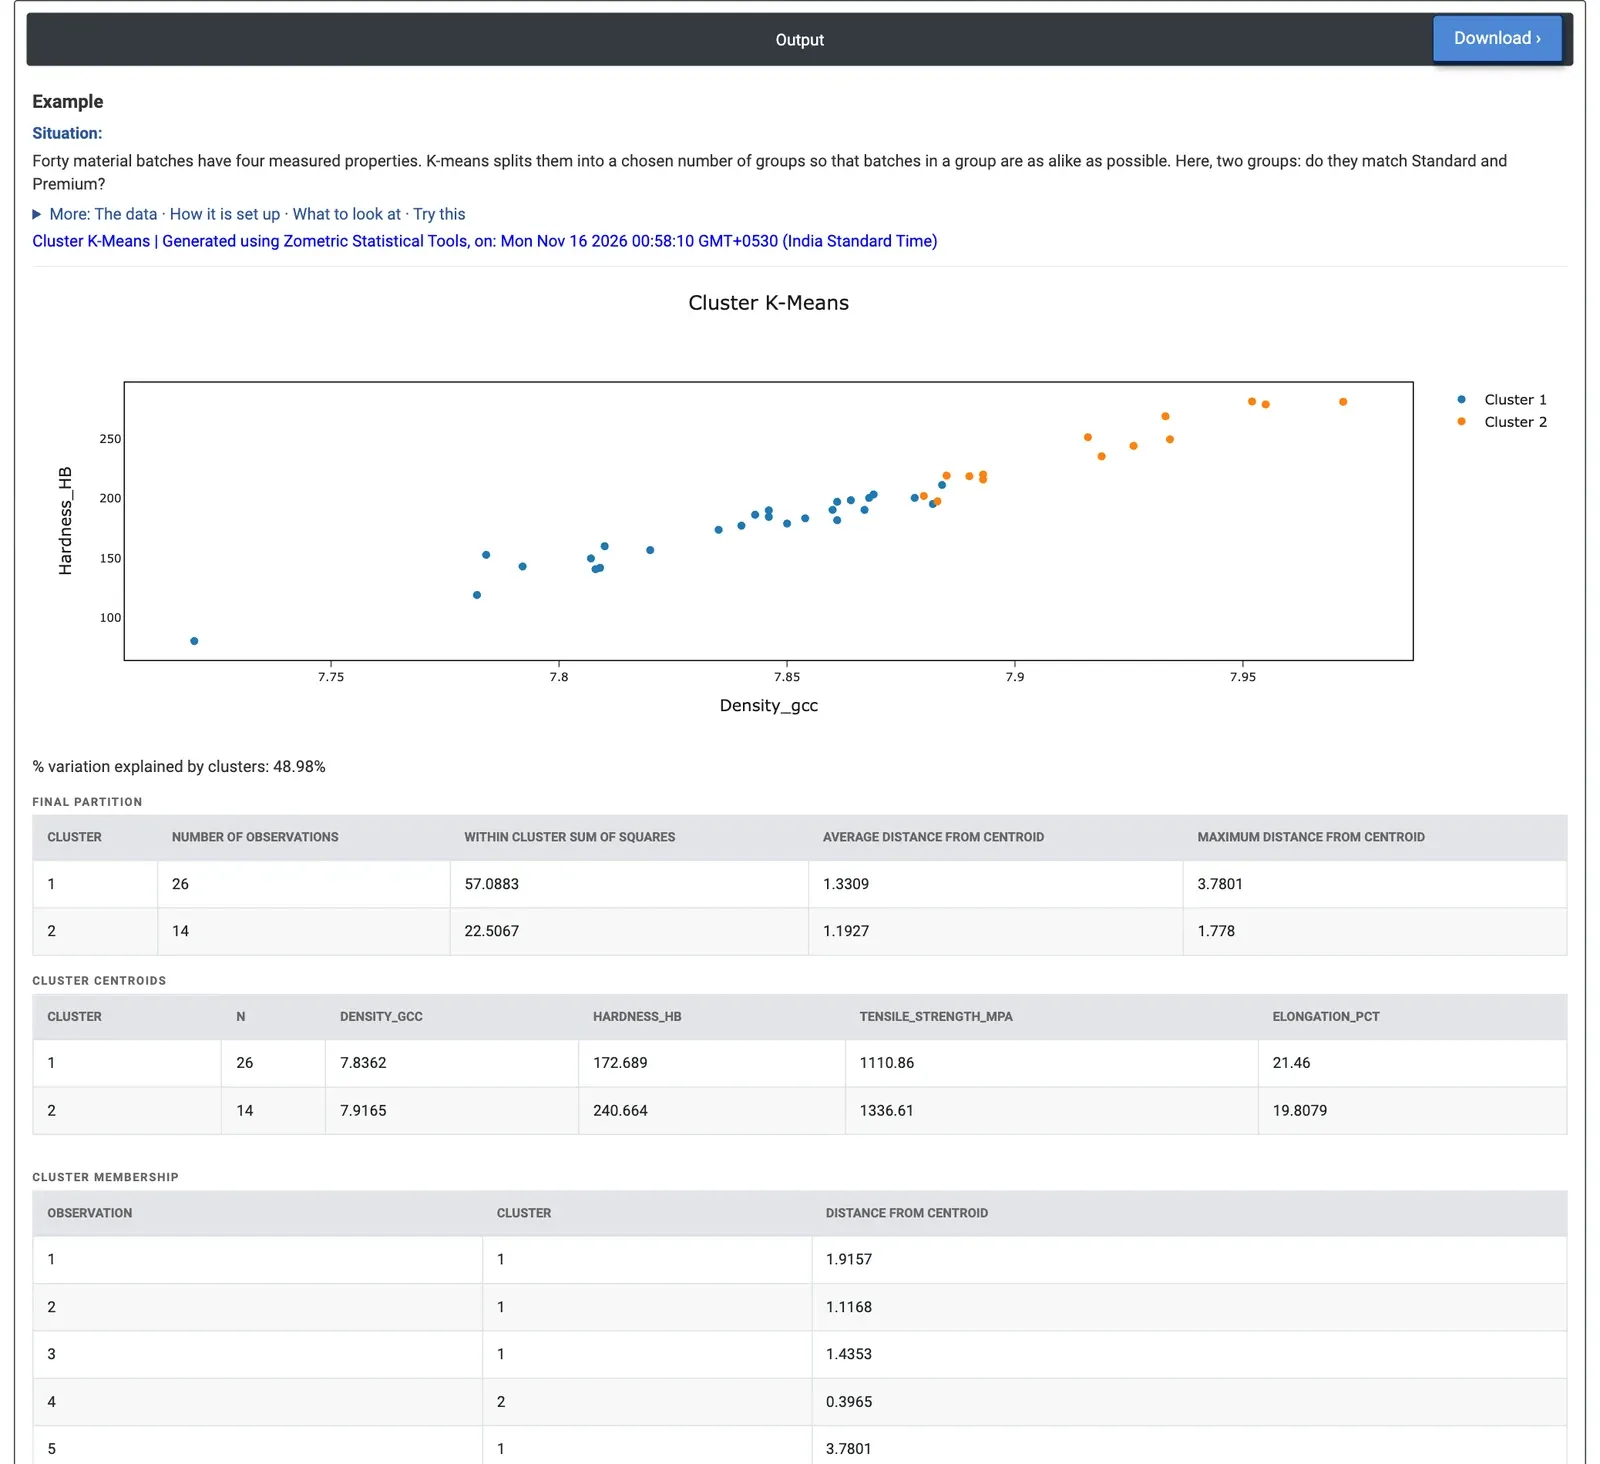
Figura 2: dos conglomerados de 40 lotes de material: el Conglomerado 2 (14 lotes) es más duro y más resistente; los conglomerados explican el 48.98 % de la variación. La partición final, los centroides y el inicio de la tabla de pertenencia siguen a la gráfica.
Ejemplo práctico
Un laboratorio de materiales tiene 40 lotes, cada uno medido en densidad (g/cc), dureza (HB), resistencia a la tracción (MPa) y alargamiento (%). Los lotes se venden como Standard o Premium, 20 de cada tipo. El laboratorio quiere saber si las mediciones por sí solas forman dos grupos naturales y si esos grupos coinciden con el tipo de lote. Selecciona las cuatro columnas de propiedades, establece Number of clusters (K) = 2, mantiene marcada Standardize variables (la resistencia a la tracción, en cientos, dominaría en caso contrario) y mantiene 10 inicios aleatorios.
Los conglomerados explican el 48.98 % de la variación. El Conglomerado 2 contiene 14 lotes más duros y resistentes (media de 240.7 HB y 1,336.6 MPa) y algo menos dúctiles (19.8 % de alargamiento); el Conglomerado 1 contiene 26 lotes con medias de 172.7 HB, 1,110.9 MPa y 21.5 % de alargamiento. Los centroides de densidad difieren solo un poco (7.92 frente a 7.84 g/cc). En la partición final, el Conglomerado 2 es el grupo más compacto (distancia promedio al centroide de 1.19 frente a 1.33 unidades estandarizadas); el miembro más alejado del Conglomerado 1, la fila 5, está a 3.78 unidades de su centroide, un lote inusual que conviene revisar. Al compararlo con la columna del tipo de lote, el Conglomerado 2 contiene 11 lotes Premium y 3 Standard, y el Conglomerado 1 contiene 17 Standard y 9 Premium, de modo que 28 de los 40 lotes caen en el conglomerado que corresponde a su tipo.
Para el laboratorio, esto significa que los lotes más resistentes forman un grupo claro, pero muchos lotes Premium no son más duros ni más resistentes que los Standard: las propiedades no respaldan por completo la etiqueta. Con K = 3, la variación explicada sube al 69.66 % y un grupo blando y débil de 9 lotes (138.2 HB, 995.9 MPa) se separa de un grupo intermedio de 23 y un grupo superior de 8. Al desmarcar Standardize variables, la división cambia a 19 y 21 lotes, porque entonces la resistencia a la tracción tiene la mayor parte del peso. Para construir una regla que use los tipos conocidos, ejecute Discriminant Analysis con los mismos datos.
Preguntas frecuentes
¿Cuándo debe usarse el clustering K-Means?
Úselo cuando espere un número conocido de grupos y quiera clasificar observaciones, como lotes de material, piezas o proveedores, en tipos a partir de varias propiedades medidas. También resulta útil para comprobar si una etiqueta que ya utiliza, como el grado, la línea o el turno, se refleja en absoluto en las mediciones.
¿Deben estandarizarse las variables antes de aplicar K-Means?
La estandarización convierte cada variable a media 0 y desviación estándar 1, de modo que una variable medida en unidades grandes no domine la agrupación. Está marcada por defecto. Desmárquela solo cuando todas las variables compartan las mismas unidades y desee que las de mayor dispersión tengan más peso; en el ejemplo, al desmarcarla cambió la división porque entonces la resistencia a la tracción tenía la mayor parte del peso.
¿Cómo se elige el número de conglomerados K?
La salida informa el porcentaje de la variación total explicada por los conglomerados; una cifra mayor significa grupos más distintos y compactos. Siempre aumenta al crecer K, por lo que debe compararse entre valores de K con cuidado. En el ejemplo, dos conglomerados explicaron el 48.98 % de la variación y tres conglomerados el 69.66 %, con la separación de un grupo blando y débil de 9 lotes.
¿Cuál es la diferencia entre K-Means y el análisis discriminante?
K-Means encuentra grupos solo a partir de las mediciones, sin usar etiquetas conocidas. En el ejemplo, los dos conglomerados coincidieron con la etiqueta Standard o Premium en solo 28 de los 40 lotes. Para construir una regla que use los tipos conocidos para separar los grupos, ejecute Discriminant Analysis con los mismos datos.