
Conglomerado de observaciones
Cluster Observations une paso a paso las observaciones más similares en dos o más variables numéricas y dibuja el resultado como un dendrograma. Elija uno de siete métodos de enlace y una de cinco medidas de distancia, y estandarice las variables que estén en unidades distintas. Ward, Centroid y Median requieren distancia Euclidean o Squared Euclidean. Al introducir un número de conglomerados, se corta el árbol y se etiqueta cada observación.
Última revisión:
Idea clave
Cluster Observations es un conglomerado jerárquico que agrupa filas parecidas en varias variables numéricas sin conocer de antemano el número de grupos, y dibuja un dendrograma que muestra los grupos naturales y las filas atípicas.
En esta página
Propósito
Cluster Observations agrupa observaciones (filas) parecidas en varias variables numéricas, sin necesidad de conocer de antemano el número de grupos. Une paso a paso las observaciones más similares y dibuja el resultado como un dendrograma (árbol), para que pueda ver cuántos grupos naturales hay y qué observaciones van juntas. Úselo para buscar familias naturales de lotes, piezas, proveedores o series de producción, o para detectar una observación que no encaja en ningún grupo.
Capacidades principales
- Conglomerado jerárquico (aglomerativo) de observaciones en dos o más variables numéricas.
- Siete métodos de enlace: Single, Complete, Average, Centroid, Median, McQuitty y Ward.
- Cinco medidas de distancia: Euclidean, Squared Euclidean, Manhattan (City Block), Cosine y Correlation.
- Estandarización opcional para que las variables en unidades distintas cuenten por igual.
- Dendrograma de toda la secuencia de uniones y, opcionalmente, la asignación de conglomerado de cada observación cuando se indica un número de conglomerados.
Métodos estadísticos
Se eliminan las filas con un valor faltante o no numérico en cualquiera de las variables seleccionadas; se necesitan al menos 3 observaciones. Cuando Standardize variables está marcada, cada variable se convierte a z = (x − media) / s con la desviación estándar muestral s. Luego se calcula la distancia entre cada par de observaciones con la medida elegida: Euclidean √Σ(xᵢ − yᵢ)², Squared Euclidean Σ(xᵢ − yᵢ)², Manhattan Σ|xᵢ − yᵢ|, Cosine 1 − cos(ángulo entre las dos filas) o Correlation 1 − r entre las dos filas.
El conglomerado empieza con cada observación como su propio conglomerado y fusiona repetidamente los dos conglomerados más cercanos hasta que queda uno solo. El método de enlace define cómo se mide la distancia entre dos conglomerados: Single usa el par de miembros más cercano, Complete el par más lejano, Average la media de todas las distancias por pares, McQuitty un promedio ponderado, Centroid la distancia entre los centros de los conglomerados, Median la distancia entre centros no ponderados, y Ward fusiona el par de conglomerados que produce el menor aumento de la suma de cuadrados dentro de los conglomerados. Ward, Centroid y Median requieren una distancia Euclidean o Squared Euclidean; la herramienta rechaza otras combinaciones.
La altura a la que se unen dos ramas en el dendrograma es la distancia entre ellas en el momento de la fusión, por lo que las ramas verticales largas indican grupos bien separados. Cuando se introduce Number of clusters, el árbol se corta en el nivel que da ese número de conglomerados y cada observación se etiqueta con su número de conglomerado.
Campos y opciones de entrada
Campo | Descripción |
Variables | Dos o más columnas numéricas que describen cada observación. Ctrl o Command + clic para seleccionar varias. |
Linkage method | Cómo se mide la distancia entre conglomerados: Single, Complete, Average (predeterminado), Centroid, Median, McQuitty o Ward. |
Distance measure | Cómo se mide la distancia entre dos observaciones: Euclidean (predeterminada), Squared Euclidean, Manhattan (City Block), Cosine o Correlation. |
Standardize variables | Marcada de forma predeterminada. Primero escala cada variable a media 0 y desviación estándar 1, para que una variable en unidades grandes no domine. |
Number of clusters | Opcional, 2 o más. Corta el árbol en ese número de conglomerados y añade la tabla Cluster Assignments. Déjelo vacío para mostrar solo el dendrograma. |
Title | Título que se muestra en el dendrograma. Predeterminado: Cluster Observations. |
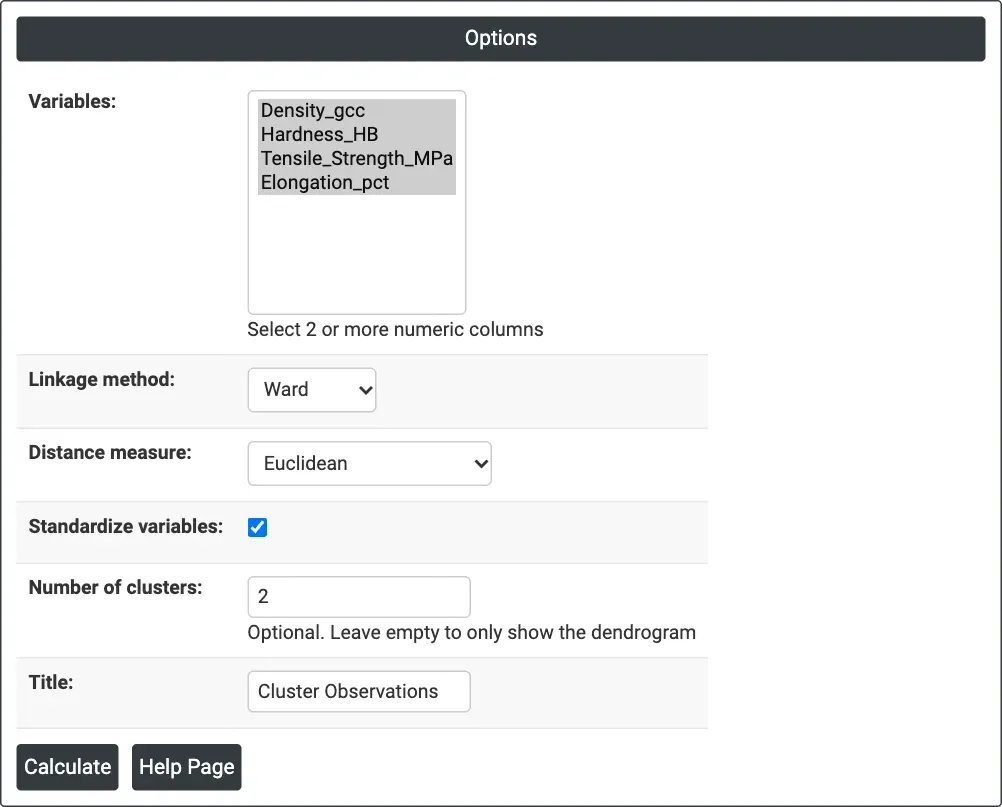
Figura 1 — Opciones del ejemplo: cuatro columnas de propiedades, enlace Ward, distancia Euclidean, estandarizadas, 2 conglomerados.
Descripción de la salida
- Dendrogram — la secuencia de uniones. Las observaciones (números de fila) están en el eje x en el orden del árbol; el eje y (Distance) muestra el nivel al que se unen las ramas.
- Cluster Assignments — se muestra cuando se introduce Number of clusters: el número de fila de cada observación y su número de conglomerado.
- Exportación a PDF mediante Download.
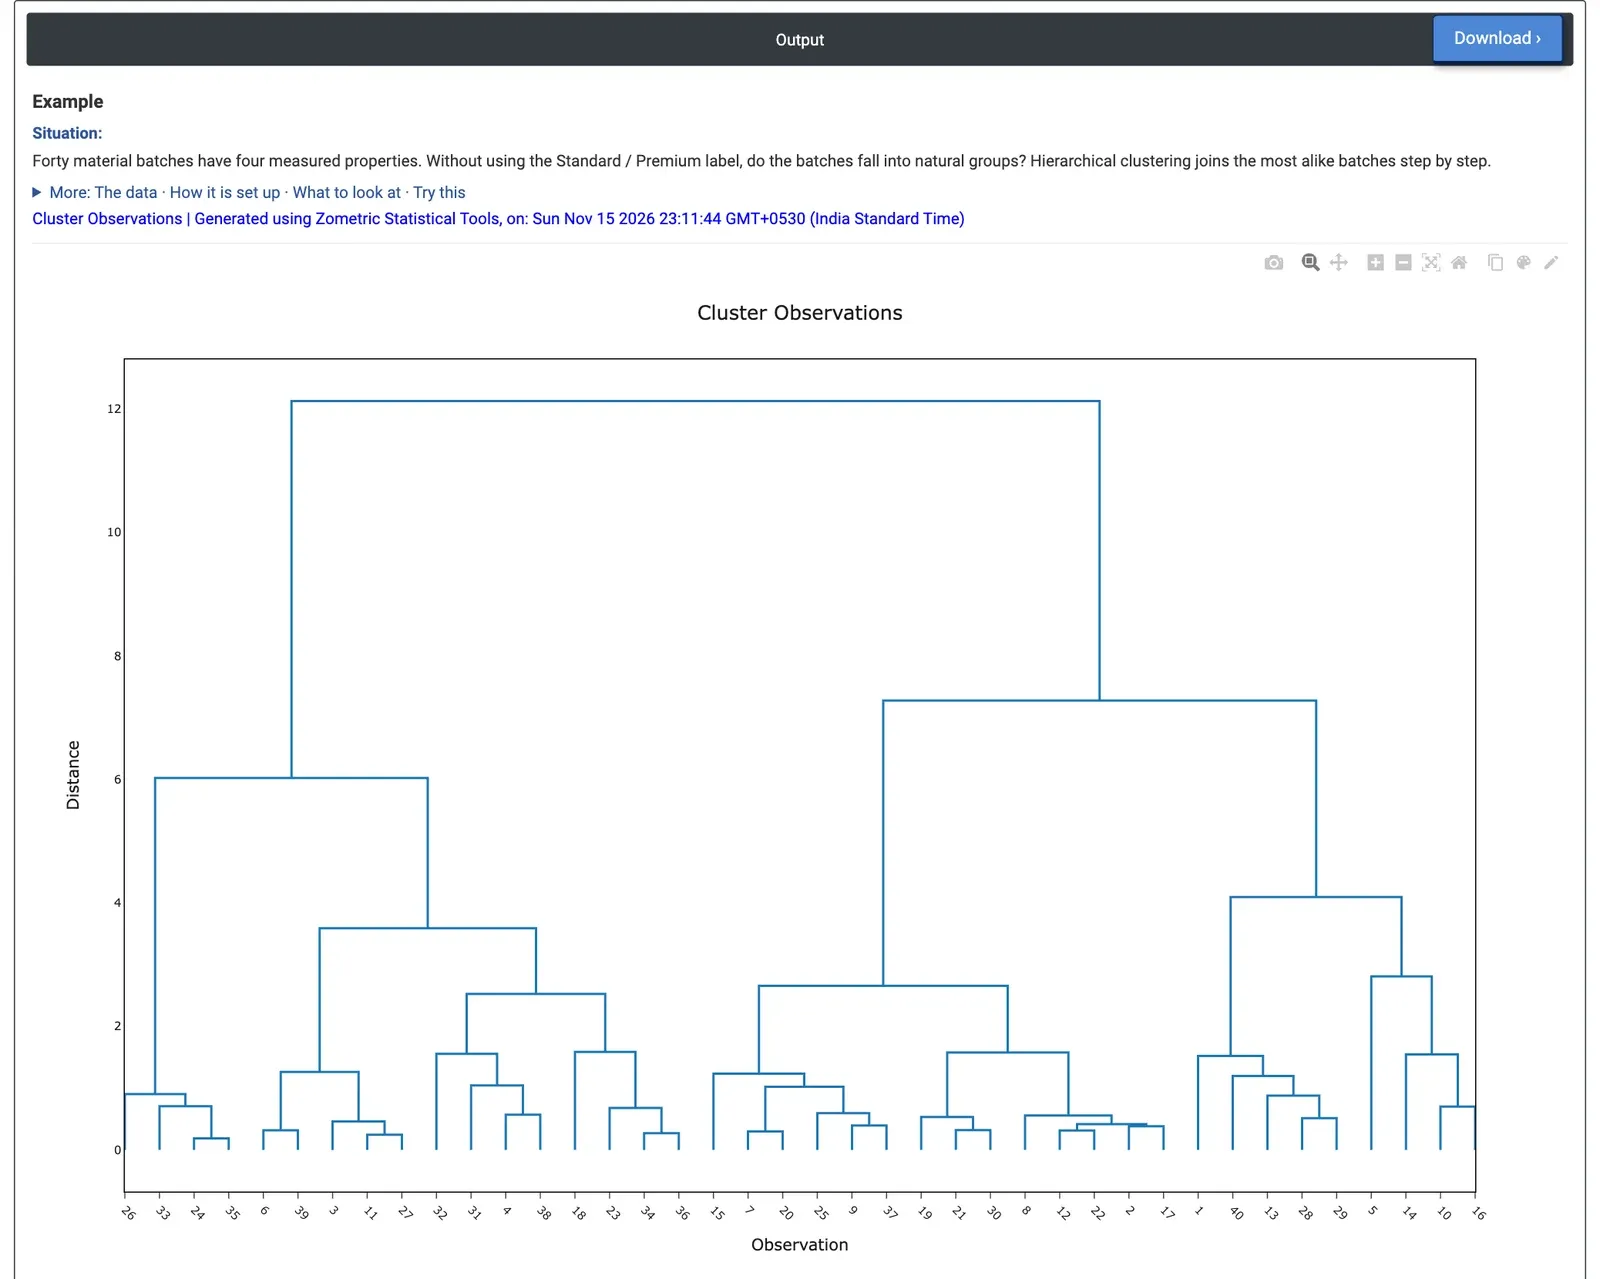
Figura 2 — Dendrograma de 40 lotes de material con enlace Ward: dos ramas principales se unen a una distancia de aproximadamente 12.1.
Ejemplo
Un laboratorio de materiales tiene 40 lotes medidos en densidad (g/cc), dureza (HB), resistencia a la tracción (MPa) y elongación (%). Sin usar la etiqueta Standard o Premium, el laboratorio quiere saber si los lotes se agrupan de forma natural. Selecciona las cuatro columnas de propiedades, elige Linkage method = Ward y Distance measure = Euclidean, mantiene marcada Standardize variables (la densidad en g/cc y la resistencia en MPa no serían comparables de otro modo) e introduce Number of clusters = 2.
El dendrograma muestra dos ramas principales que se unen a una distancia de 12.1, muy por encima de las siguientes uniones (7.3 y 6.0), por lo que dos grupos es un corte natural. El conglomerado 1 tiene 17 lotes más duros y resistentes (media de 231.6 HB y 1,308 MPa, 19.8% de elongación); el conglomerado 2 tiene 23 lotes más blandos y dúctiles (170.5 HB, 1,103 MPa, 21.7% de elongación). Frente al tipo de lote, el conglomerado 1 contiene 12 lotes Premium y 5 Standard, y el conglomerado 2 contiene 15 Standard y 8 Premium: los conglomerados siguen el tipo solo en 27 de los 40 lotes.
Para el laboratorio, las propiedades se solapan mucho entre los dos tipos, y una buena parte de los lotes Standard son tan resistentes como los Premium. La elección del enlace importa: con enlace Average, el corte en dos conglomerados aparta un único lote (fila 5, 80.1 HB y 822.6 MPa, mucho más blando que el resto) y agrupa los otros 39, lo que es una forma útil de hallar un valor atípico en lugar de grupos. Al cortar el árbol Ward en 3 conglomerados se separa un grupo blando de 9 lotes (138.2 HB, 995.9 MPa).
Preguntas frecuentes
¿Qué es el conglomerado jerárquico de observaciones?
Empieza con cada observación como su propio conglomerado y fusiona repetidamente los dos conglomerados más cercanos hasta que queda uno solo. El resultado se dibuja como un dendrograma, de modo que puede ver cuántos grupos naturales hay y qué observaciones van juntas, sin conocer de antemano el número de grupos. También puede revelar una observación que no encaja en ningún grupo.
¿Cómo se lee un dendrograma?
Las observaciones están en el eje x en el orden del árbol, y el eje y muestra la distancia a la que se unen las ramas. Las ramas verticales largas indican grupos bien separados. En el ejemplo, dos ramas principales se unieron a una distancia de 12.1, muy por encima de las siguientes uniones, de 7.3 y 6.0, por lo que dos grupos fue un corte natural.
¿Qué método de enlace conviene usar?
La herramienta ofrece Single, Complete, Average, Centroid, Median, McQuitty y Ward. Ward fusiona el par de conglomerados que da el menor aumento de la suma de cuadrados dentro de los conglomerados y, como Centroid y Median, requiere distancia Euclidean o Squared Euclidean. La elección importa: en el ejemplo, el enlace Average apartó un único lote atípico, mientras que Ward halló dos grupos.
¿Conviene estandarizar las variables antes de formar conglomerados de observaciones?
Standardize variables está marcada de forma predeterminada y primero escala cada variable a media 0 y desviación estándar 1, para que una variable en unidades grandes no domine. En el ejemplo, la densidad en g/cc y la resistencia en MPa no habrían sido comparables de otro modo. Se eliminan las filas con un valor faltante o no numérico, y se necesitan al menos 3 observaciones.