
Agrupamiento de variables (Cluster Variables)
Cluster Variables aplica agrupamiento jerárquico a tres o más variables numéricas, usando la correlación, la correlación absoluta o la distancia euclidiana y uno de siete métodos de enlace. Las variables que se mueven juntas se unen primero, como muestra un dendrograma. Sirve para acortar una lista larga de mediciones o de ítems de encuesta. Se necesitan al menos 3 filas completas. Si se indica un número de grupos, se etiqueta cada variable.
Última revisión:
Idea clave
Cluster Variables agrupa variables (columnas) que aportan información similar, uniendo las que suben y bajan juntas, de modo que una lista larga de mediciones o de ítems de encuesta se reduzca a una por grupo.
En esta página
Propósito
Cluster Variables agrupa variables (columnas) que aportan información similar. Las variables que suben y bajan juntas a lo largo de las observaciones se unen primero, y el resultado se dibuja como un dendrograma. Úselo para reducir una lista larga de mediciones o de ítems de encuesta: cuando varias variables caen en el mismo grupo, puede seguir una de ellas, o una puntuación combinada, en lugar de todas.
Funciones principales
- Agrupamiento jerárquico de tres o más variables numéricas.
- Distancia basada en la correlación, la correlación absoluta o la distancia euclidiana.
- Siete métodos de enlace: Single, Complete, Average, Centroid, Median, McQuitty y Ward.
- Dendrograma que muestra el orden y el nivel en que se unen las variables.
- Asignación opcional de cada variable a un grupo cuando se indica un número de grupos.
Métodos estadísticos
Se descartan las filas con un valor faltante o no numérico en cualquier variable seleccionada; se necesitan al menos 3 variables y 3 filas completas. Cada variable se trata como un punto cuyas coordenadas son sus valores en las filas, y la distancia entre cada par de variables se calcula con la medida elegida. La distancia por correlación es 1 − r, donde r es la correlación de Pearson entre las dos variables: 0 para una correlación positiva perfecta y 2 para una negativa perfecta. La distancia por correlación absoluta es 1 − |r|, que trata una relación negativa fuerte como igual de cercana que una positiva fuerte. La distancia euclidiana es √Σ(xᵢ − yᵢ)² sobre los valores originales, por lo que depende de las unidades de cada variable.
El agrupamiento comienza con cada variable por separado y fusiona repetidamente los dos grupos más cercanos. El método de enlace define la distancia entre grupos: Single usa el par más cercano, Complete el par más lejano, Average la media de todas las distancias entre pares, McQuitty una media ponderada, Centroid y Median la distancia entre los centros de los grupos, y Ward el menor aumento de la suma de cuadrados dentro de los grupos. Ward, Centroid y Median requieren la distancia euclidiana; la herramienta rechaza otras combinaciones.
Con la distancia por correlación, una unión a la altura h significa que las variables de las dos ramas tienen una correlación promedio de aproximadamente 1 − h. Cuando se introduce Number of clusters, el árbol se corta para obtener ese número de grupos y cada variable se etiqueta con su grupo.
Campos de entrada y opciones
Campo | Descripción |
Variables | Tres o más columnas numéricas que se van a agrupar. Ctrl o Command + clic para seleccionar varias. |
Linkage method | Cómo se mide la distancia entre grupos: Single, Complete, Average (predeterminado), Centroid, Median, McQuitty o Ward. |
Distance measure | Correlation (predeterminado), Absolute Correlation o Euclidean. |
Number of clusters | Opcional, 2 o más. Corta el árbol en ese número de grupos y agrega la tabla Cluster Assignments. Déjelo vacío para mostrar solo el dendrograma. |
Title | Título que se muestra en el dendrograma. Valor predeterminado Cluster Variables. |
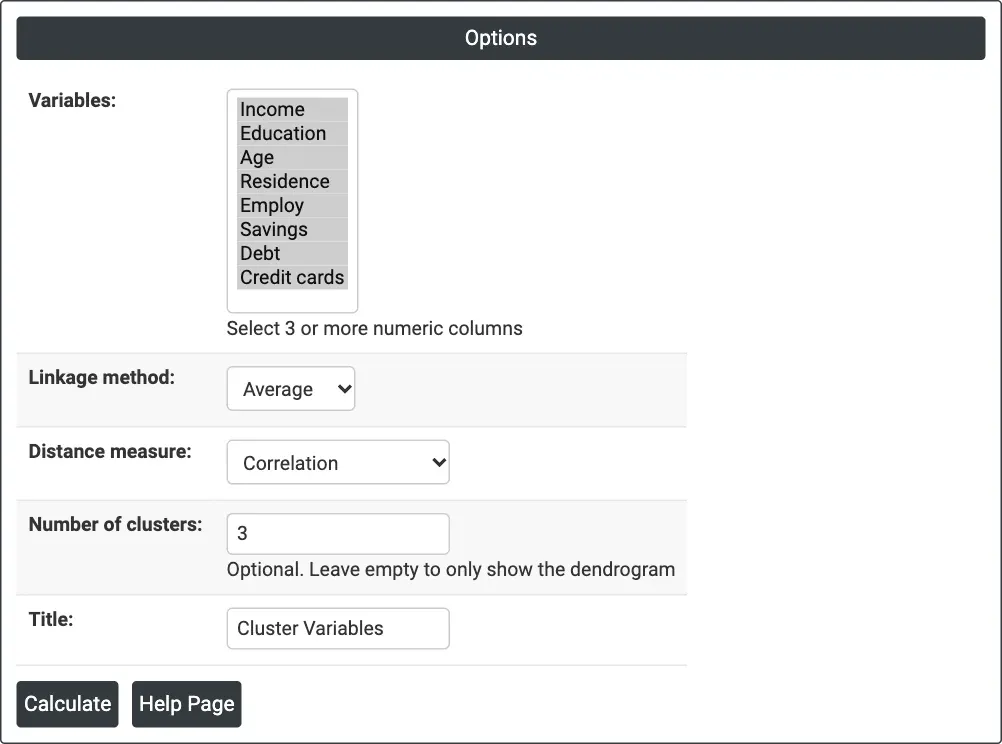
Figura 1: opciones del ejemplo: ocho variables de solicitantes de préstamos, enlace Average, distancia Correlation, 3 grupos.
Descripción de la salida
- Dendrograma: las variables a lo largo del eje x en el orden del árbol; el eje y (Distance) muestra el nivel en que se unen las ramas. Cuanto más baja es la unión, más parecidas son las variables.
- Cluster Assignments: se muestra cuando se introduce Number of clusters; indica cada variable y su número de grupo.
- Exportación a PDF mediante Download.
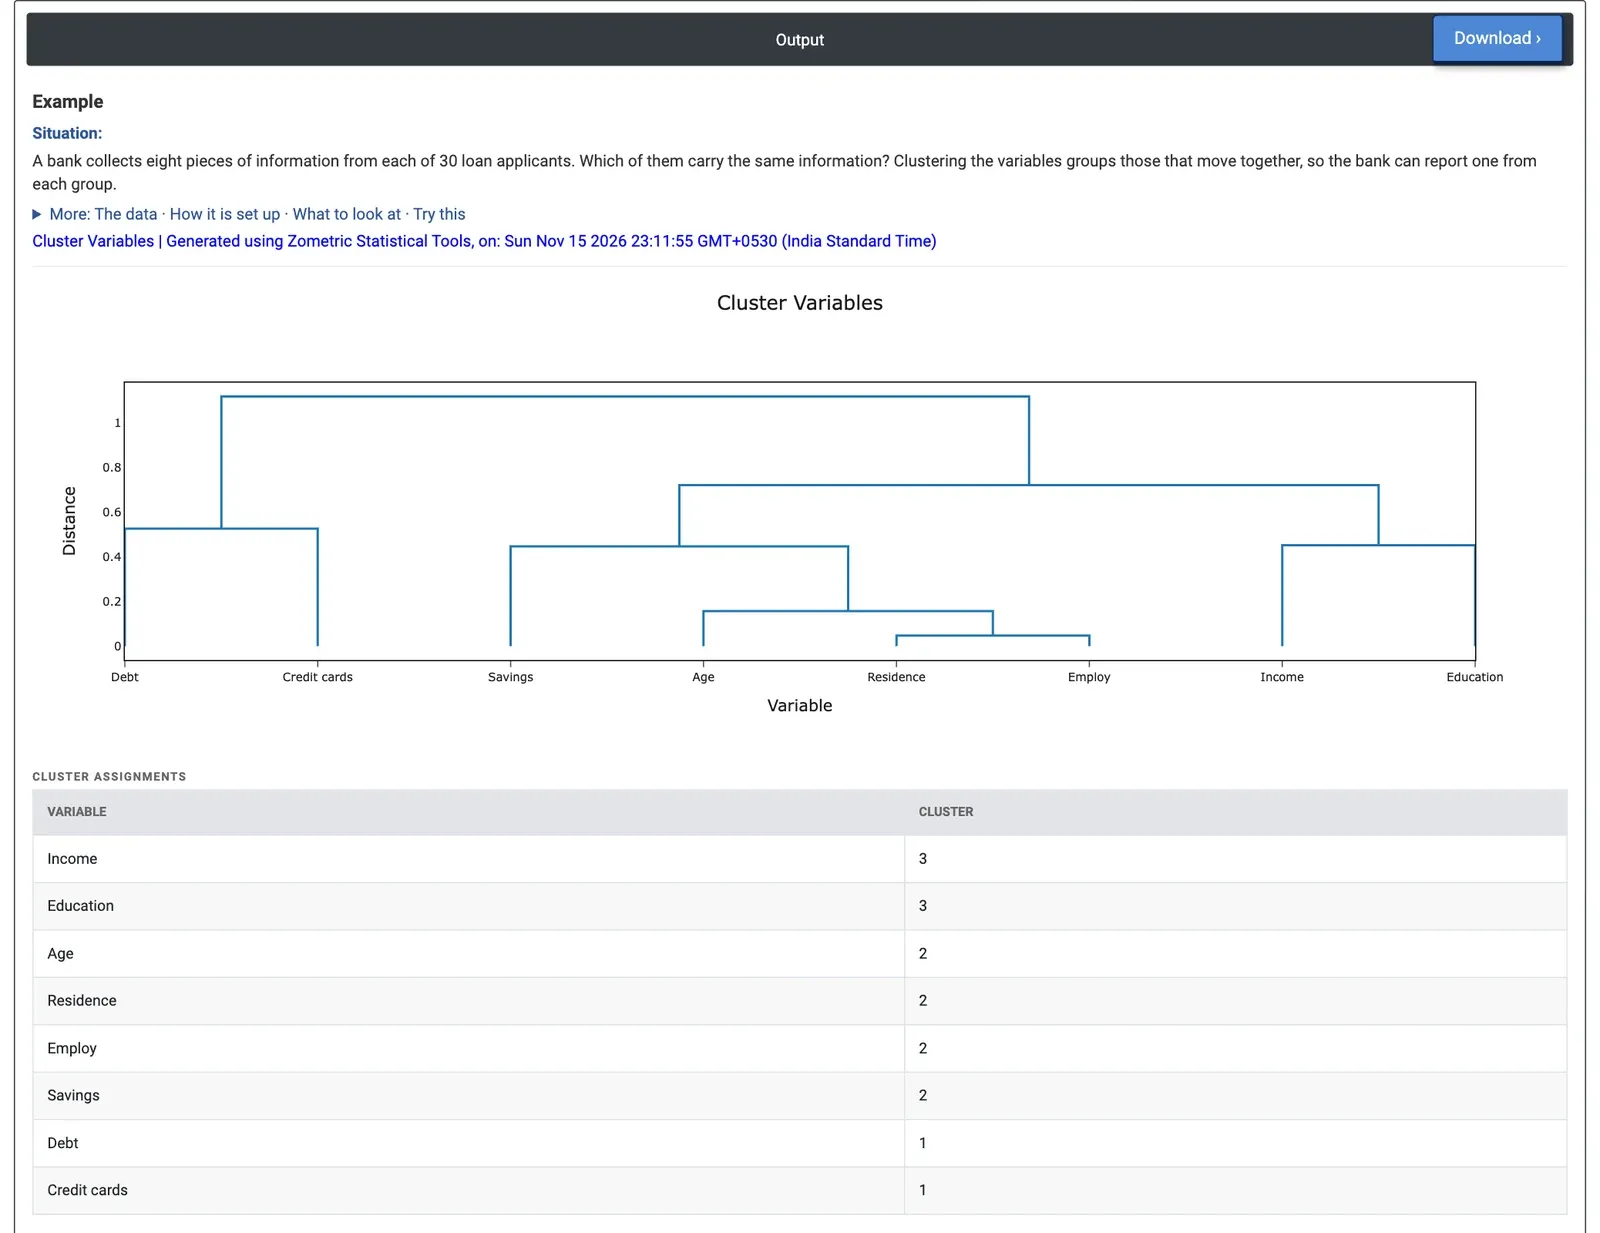
Figura 2: dendrograma y asignación de grupos de las ocho variables de los solicitantes de préstamos: grupos de estabilidad, de ingresos y de endeudamiento.
Ejemplo
Un banco registra ocho datos de cada solicitante de préstamo: ingresos, años de educación, edad, años en el domicilio actual (Residence), años con el empleador actual (Employ), ahorros, deuda y número de tarjetas de crédito. Un analista de crédito quiere saber cuáles de ellos aportan la misma información, para que un informe breve pueda mostrar uno de cada grupo. Con 30 solicitantes, el analista selecciona las ocho columnas, mantiene Linkage method = Average y Distance measure = Correlation, e introduce Number of clusters = 3.
Residence y Employ se unen primero, a una distancia de 0.048 (correlación 0.95), y Age se les une a 0.157. Savings se une a este grupo a 0.446. Income y Education se unen a 0.451, y Debt y Credit cards a 0.526. Con tres grupos, el grupo 2 contiene Age, Residence, Employ y Savings, que describen la estabilidad del solicitante; el grupo 3 contiene Income y Education; y el grupo 1 contiene Debt y Credit cards, el endeudamiento. Las dos últimas uniones se producen a 0.72 y 1.117, muy por encima de las demás, lo que respalda tres grupos.
Para el analista, una variable de cada grupo, por ejemplo Employ, Income y Debt, cubriría la mayor parte de lo que dicen las ocho variables. Con Number of clusters = 2 se fusionan los grupos de estabilidad y de ingresos y Debt y Credit cards quedan solas; con 4 grupos, Debt y Credit cards se separan. Factor Analysis sobre las mismas ocho columnas da una agrupación similar, con cargas que muestran con qué intensidad pertenece cada variable a su grupo.
Preguntas frecuentes
¿Para qué se usa Cluster Variables?
Se usa para reducir una lista larga de mediciones o de ítems de encuesta. Las variables que suben y bajan juntas a lo largo de las observaciones se unen primero, y el resultado se dibuja como un dendrograma. Cuando varias variables caen en el mismo grupo, puede seguir una de ellas, o una puntuación combinada, en lugar de todas.
¿Qué es la distancia por correlación?
La distancia por correlación es 1 − r, donde r es la correlación de Pearson entre dos variables: 0 para una correlación positiva perfecta y 2 para una negativa perfecta. La distancia por correlación absoluta, 1 − |r|, trata una relación negativa fuerte como igual de cercana que una positiva fuerte. La distancia euclidiana usa los valores originales, por lo que depende de las unidades de cada variable.
¿Cómo se lee el dendrograma de variables?
Las variables están a lo largo del eje x en el orden del árbol y el eje y muestra la distancia a la que se unen las ramas; cuanto más baja es la unión, más parecidas son las variables. Con la distancia por correlación, una unión a la altura h significa que las variables de las dos ramas tienen una correlación promedio de aproximadamente 1 − h.
¿Cómo se elige el número de grupos de variables?
Busque uniones que se produzcan muy por encima de las demás. En el ejemplo de los solicitantes de préstamos, las dos últimas uniones se produjeron a 0.72 y 1.117, muy por encima del resto, lo que respaldó tres grupos: estabilidad, ingresos y endeudamiento. Una variable de cada grupo, como Employ, Income y Debt, cubriría entonces la mayor parte de lo que dicen las ocho variables.