
Análisis de correspondencias simple
El análisis de correspondencias simple toma datos categóricos sin procesar o una tabla de contingencia y representa las categorías de filas y columnas en un mapa. Informa una prueba de chi-cuadrado de asociación, una tabla de inercia que muestra cuánto explica cada componente y tablas de contribución de filas y columnas. Cada variable necesita al menos 2 categorías. Úselo para leer el patrón de una tabla cruzada grande, como tipos de defecto por máquina.
Última revisión:
Idea clave
El análisis de correspondencias simple convierte una tabla de conteos de dos entradas en un mapa en el que las categorías de filas y columnas que coinciden más de lo esperable por azar quedan próximas entre sí.
En esta página
Propósito
El análisis de correspondencias simple convierte una tabla de conteos de dos entradas en un mapa. Las categorías de filas y de columnas se dibujan como puntos, y las categorías que coinciden más de lo esperable por azar quedan próximas entre sí. Úselo para ver de un vistazo el patrón de una tabla cruzada grande: qué tipos de defecto se asocian con qué máquinas, qué categorías de reclamaciones se asocian con qué productos o qué atributos relacionan los clientes con qué marcas.
Capacidades principales
- Acepta datos sin procesar (una fila por elemento con dos columnas categóricas) o una tabla de contingencia ya resumida como conteos.
- Prueba de chi-cuadrado de asociación entre las variables de fila y de columna.
- Tabla de inercia que muestra qué parte de la asociación explica cada componente (eje del mapa).
- Tablas de contribución de filas y columnas: calidad, masa, inercia, coordenadas, correlaciones al cuadrado y contribuciones para el número de componentes que elija.
- Cinco gráficas: gráfica simétrica de filas y columnas, solo filas, solo columnas y gráficas asimétricas de filas o de columnas.
Métodos estadísticos
Con la entrada Categorical variables, la herramienta tabula de forma cruzada la variable de fila contra la variable de columna, ignorando las filas con un valor faltante. Con la entrada Columns of a contingency table, cada columna seleccionada contiene los conteos de una categoría de columna y cada fila es una categoría de fila; se descartan las filas o columnas cuyo total es cero. Cada variable necesita al menos 2 categorías.
Los conteos se dividen entre el total general n para obtener las proporciones P, con las masas de fila r (totales de fila de P) y las masas de columna c (totales de columna). La matriz de residuos estandarizados S = Dr^−½ (P − r cᵀ) Dc^−½ se descompone mediante descomposición en valores singulares. Cada valor singular d da un componente con inercia d², y el número de componentes es el menor de (filas − 1) y (columnas − 1). La inercia total es igual al estadístico de chi-cuadrado dividido entre n, y la herramienta informa chi-cuadrado = n × inercia total con (filas − 1)(columnas − 1) grados de libertad y su valor p. Un valor p pequeño significa que las filas y las columnas están asociadas, por lo que el mapa muestra un patrón real.
Las coordenadas principales de las filas son Dr^−½ U D y las de las columnas Dc^−½ V D. En las tablas de contribución, Mass es la parte de la categoría en el conteo total, Inert su parte en la inercia total, Corr el coseno al cuadrado (qué tan bien un componente representa el punto), Qual la suma de Corr sobre los componentes informados y Contr la parte de la inercia de un componente que explica el punto. Las gráficas simétricas usan coordenadas principales para ambos conjuntos de puntos; una gráfica asimétrica de filas muestra las filas en coordenadas principales y las columnas en coordenadas estándar (principales divididas entre d), y una gráfica asimétrica de columnas hace lo contrario.
Campos de entrada y opciones
Campo | Descripción |
Input data | Categorical variables (predeterminado): una fila por elemento. Columns of a contingency table: conteos ya resumidos. Los campos siguientes cambian según esta elección. |
Row variable / Column variable | Para la entrada Categorical variables: las dos columnas categóricas que se tabulan de forma cruzada. Ambas son obligatorias y deben ser distintas. |
Contingency table columns | Para la entrada de tabla de contingencia: dos o más columnas, cada una con los conteos de una categoría de columna, una fila por categoría de fila. |
Row names | Para la entrada de tabla de contingencia, opcional: una columna que da nombre a cada fila de la tabla. En blanco, se usa Row 1, Row 2, etc. |
Column names | Para la entrada de tabla de contingencia, opcional: una columna que enumera un nombre por cada columna de tabla seleccionada, en el mismo orden. En blanco, se usan los encabezados de columna. |
Number of components | Para cuántos componentes se informan Coord, Corr y Contr en las tablas de contribución. Predeterminado 2; de 1 a 20, limitado al número de componentes disponibles. |
Symmetric plot showing rows and columns | Marcada por defecto. Filas y columnas en un solo mapa, ambas en coordenadas principales. |
Symmetric plot showing rows only / columns only | Sin marcar por defecto. El mismo mapa con un solo conjunto de puntos. |
Asymmetric row plot / Asymmetric column plot | Sin marcar por defecto. Filas en coordenadas principales y columnas en coordenadas estándar, o al revés. |
Title | Título que se muestra en las gráficas. Valor predeterminado: Simple Correspondence Analysis. |
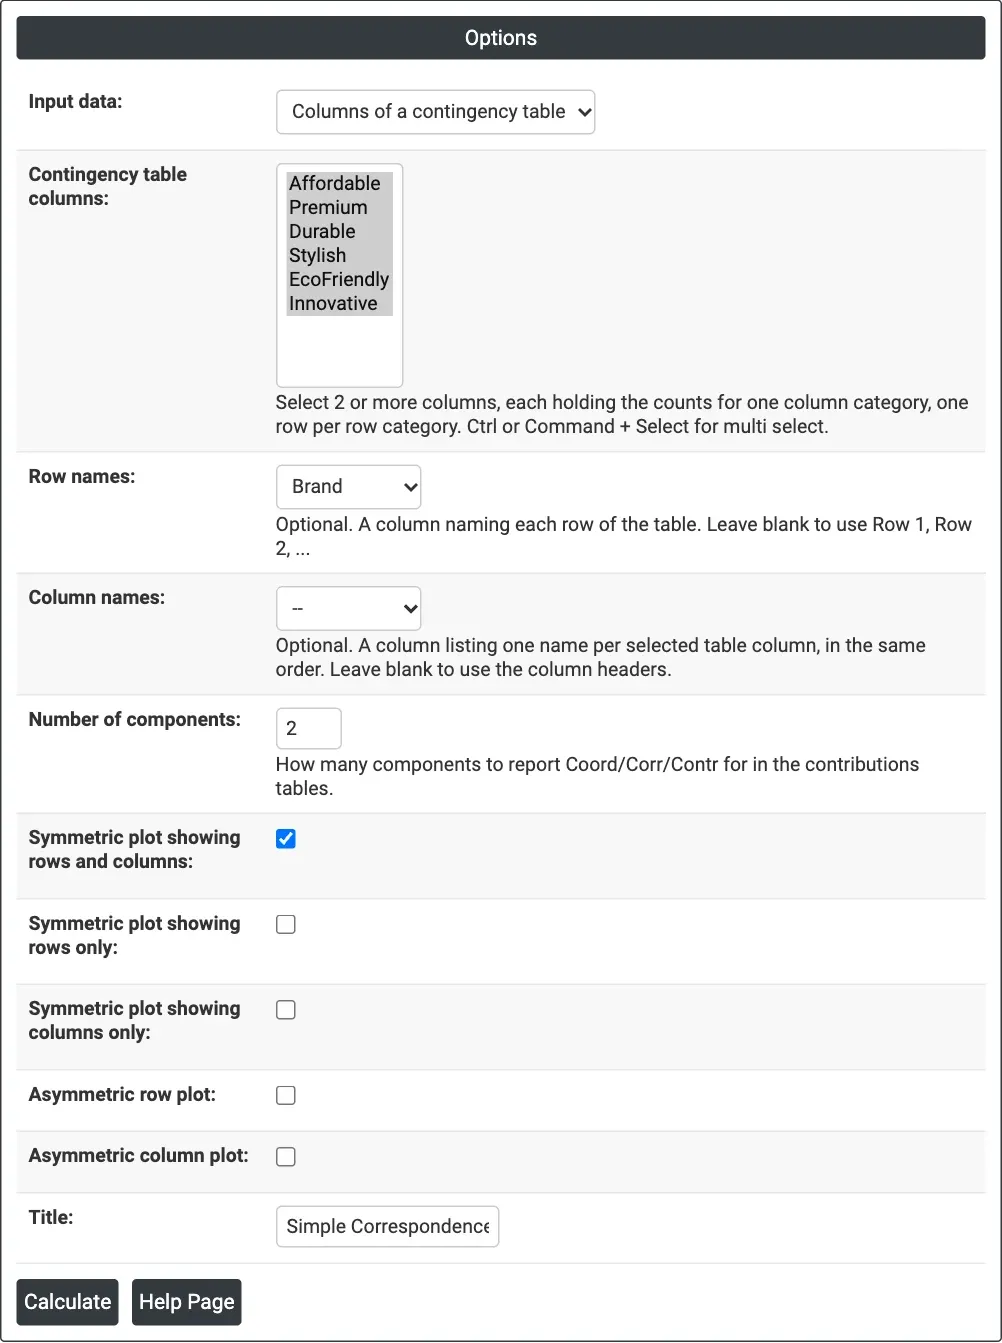
Figura 1 — Opciones del ejemplo de percepción de marcas: entrada de tabla de contingencia con seis columnas de atributos y Brand como nombres de fila.
Descripción de la salida
- Symmetric Plot, Row Plot, Column Plot, Asymmetric Row Plot, Asymmetric Column Plot — las gráficas marcadas, con Component 1 y Component 2 como ejes y el porcentaje de inercia que explica cada uno en los títulos de los ejes.
- Contingency Table — se muestra para la entrada de tabla de contingencia: la tabla tal como se analizó.
- Chi-square, DF y P-value — la prueba de asociación entre filas y columnas.
- Analysis of Contingency Table — inercia, proporción y proporción acumulada de cada eje, con un histograma de texto, y la inercia total.
- Row Contributions y Column Contributions — ID, Name, Qual, Mass, Inert, y Coord, Corr y Contr de cada componente informado.
- Exportación a PDF mediante Download.
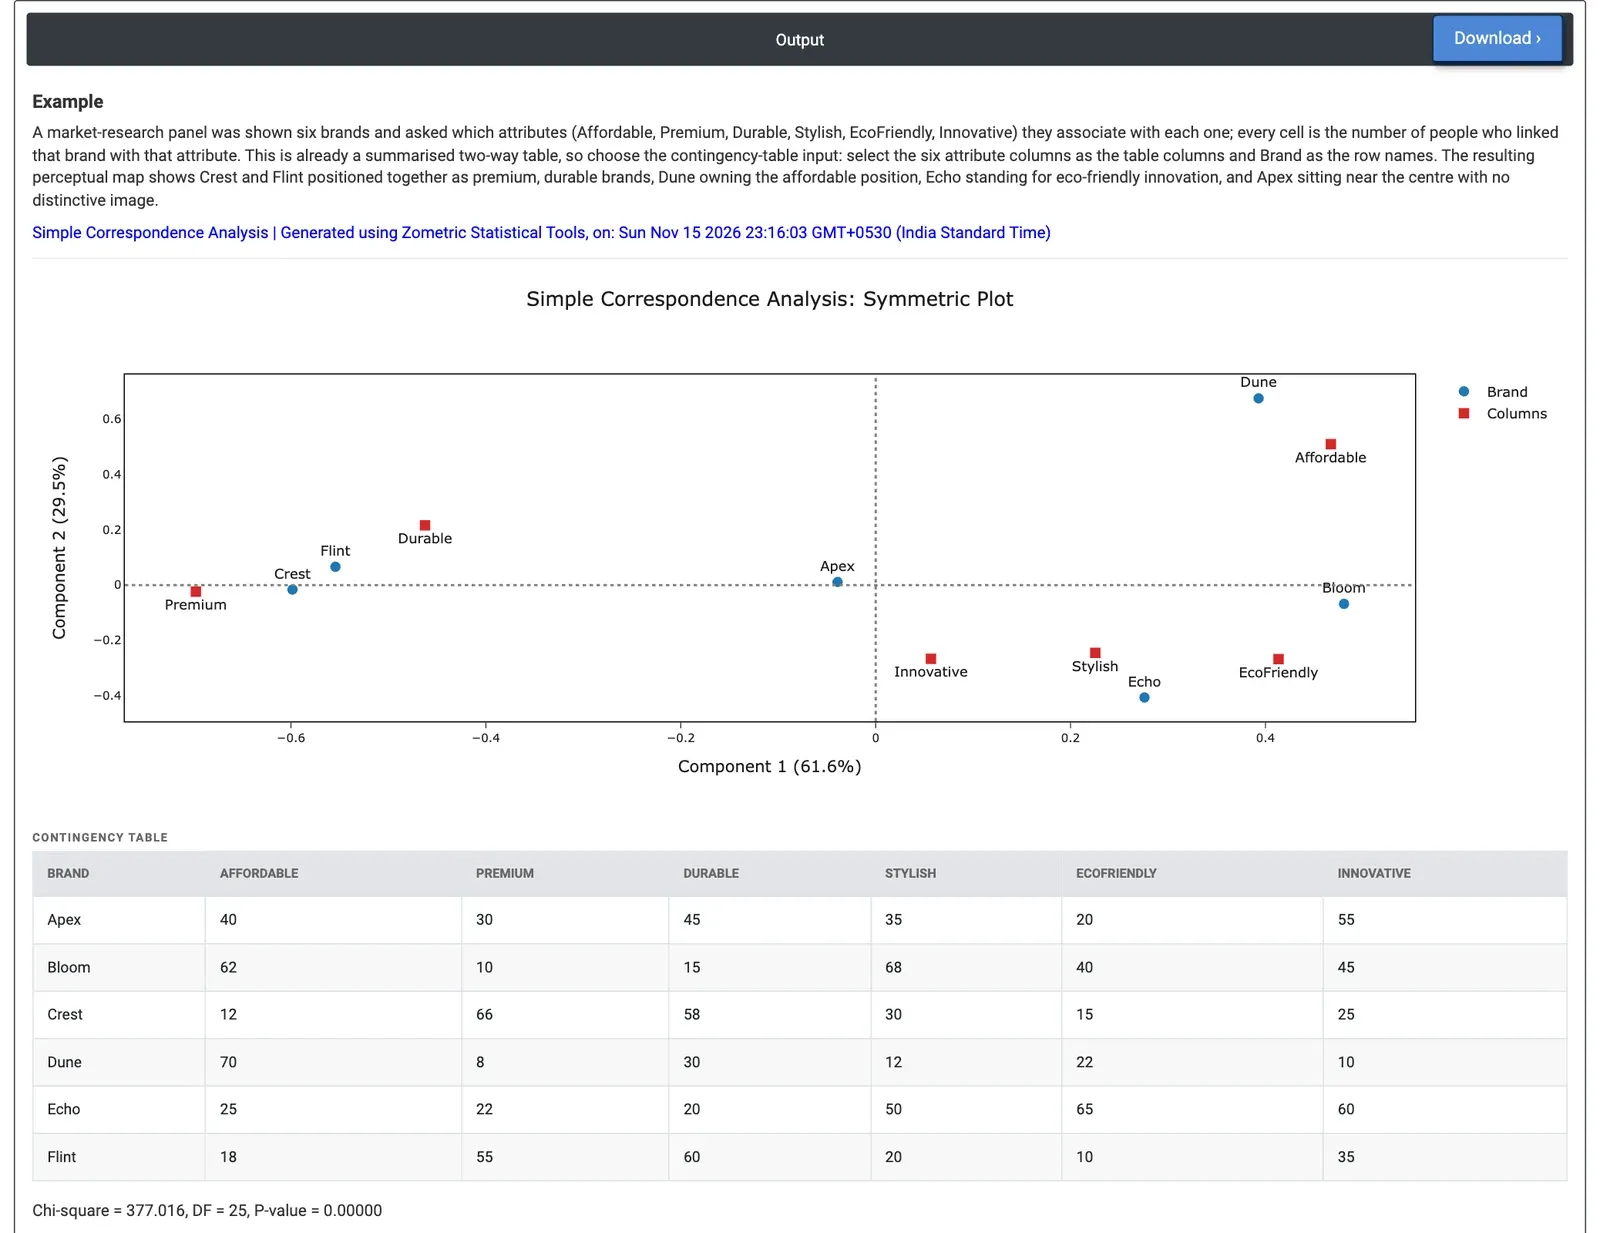
Figura 2 — Gráfica simétrico de seis marcas y seis atributos: Crest y Flint se sitúan con Premium y Durable, Dune con Affordable, Echo cerca de EcoFriendly; chi-cuadrado 377.0 con 25 DF.
Ejemplo
A un panel de investigación de mercado se le mostraron seis marcas (Apex, Bloom, Crest, Dune, Echo y Flint) y se le pidió indicar cuáles de seis atributos relaciona con cada una: Affordable, Premium, Durable, Stylish, EcoFriendly e Innovative. Cada celda contiene el número de personas que relacionaron esa marca con ese atributo. El equipo de marketing quiere ver la posición de cada marca. Como los datos ya son una tabla de conteos, establecen Input data = Columns of a contingency table, seleccionan las seis columnas de atributos como Contingency table columns y eligen Brand como Row names, manteniendo la gráfica simétrica de filas y columnas.
El chi-cuadrado es 377.016 con 25 grados de libertad (p < 0.00001), por lo que la imagen de marca difiere claramente entre las marcas. El Component 1 aporta el 61.6% de la inercia y el Component 2 el 29.5%, de modo que el mapa bidimensional muestra el 91.1% del patrón. El Component 1 va de Premium (−0.698) y Durable (−0.462) a la izquierda hasta Affordable (0.467) y EcoFriendly (0.414) a la derecha. Crest (−0.599) y Flint (−0.554) se sitúan en el lado premium y durable y quedan representadas casi perfectamente en este eje (Corr 0.94 y 0.98). Dune se sitúa alta en el Component 2 (0.674), junto a Affordable, y explica el 62.2% de la inercia de ese componente. Echo (0.276, −0.406) se sitúa cerca de EcoFriendly, Stylish e Innovative, y Bloom (0.481) se inclina hacia Stylish y Affordable.
Apex se sitúa cerca del centro (−0.039, 0.011) con una calidad de solo 0.038: su perfil es cercano al promedio de todas las marcas, por lo que no tiene una imagen distintiva. Para el equipo, Crest y Flint compiten por la misma posición premium y durable, Dune ocupa la posición asequible y Apex es la marca que necesita un mensaje más claro.
Preguntas frecuentes
¿Para qué se usa el análisis de correspondencias?
Se usa para ver de un vistazo el patrón de una tabla cruzada grande, por ejemplo qué tipos de defecto se asocian con qué máquinas, qué categorías de reclamaciones se asocian con qué productos o qué atributos relacionan los clientes con qué marcas. Las categorías de filas y columnas se dibujan como puntos, y las categorías que coinciden más de lo esperable por azar quedan próximas entre sí.
¿Qué es la inercia en el análisis de correspondencias?
La inercia mide la asociación de la tabla. Cada componente, o eje del mapa, tiene una inercia igual a su valor singular al cuadrado, y la inercia total es igual al estadístico de chi-cuadrado dividido entre el total general n. La tabla de inercia muestra la proporción que explica cada componente; en el ejemplo de las marcas, los dos primeros componentes mostraron el 91.1% del patrón.
¿Cómo se interpretan la calidad, la masa y la contribución?
Mass es la parte de una categoría en el conteo total, Inert su parte en la inercia total, Corr qué tan bien un componente representa el punto, Qual la suma de Corr sobre los componentes informados y Contr la parte de la inercia de un componente que explica el punto. Un punto cercano al centro con baja calidad, como Apex en el ejemplo, tiene un perfil cercano al promedio.
¿Cuál es la diferencia entre las gráficas simétricas y asimétricas?
Una gráfica simétrica muestra filas y columnas juntas, ambas en coordenadas principales, y está marcado por defecto. Una gráfica asimétrica de filas muestra las filas en coordenadas principales y las columnas en coordenadas estándar (principales divididas entre el valor singular), y una gráfica asimétrica de columnas hace lo contrario. También están disponibles las gráficas de solo filas o solo columnas.