
Tabulación cruzada y chi-cuadrado
Construya una tabla de doble entrada de conteos a partir de una fila por registro, con porcentajes opcionales por fila, columna y total. Pruebe la asociación con chi-cuadrado de Pearson y de razón de verosimilitud, revise los conteos esperados, los residuos y las contribuciones de cada celda, y mida la fuerza con la V de Cramér al cuadrado. La prueba exacta de Fisher cubre las tablas de 2x2. Se muestra una nota cuando los conteos esperados son menores de 5. Una variable de capa genera una tabla por nivel.
Última revisión:
Idea clave
Tabulación cruzada y chi-cuadrado cuenta con qué frecuencia aparece cada combinación de dos variables categóricas en registros sin procesar y prueba si están relacionadas, con la opción de dividir en capas según una tercera variable.
En esta página
Propósito
Tabulación cruzada y chi-cuadrado cuenta con qué frecuencia aparece cada combinación de dos variables categóricas en registros sin procesar, como departamento y nivel de satisfacción, tipo de defecto y línea, o proveedor y aprobado/rechazado, y prueba si las dos están relacionadas. Una tercera variable puede dividir el análisis en capas, por ejemplo una tabla por turno.
Capacidades principales
- Tabla de doble entrada de conteos con totales por fila y por columna, construida a partir de una fila por registro.
- Para las capas: una tabla y una prueba por separado para cada valor de una tercera variable.
- Porcentajes por fila, por columna y del total.
- Prueba chi-cuadrado de Pearson (activada de forma predeterminada) y chi-cuadrado de razón de verosimilitud.
- Conteos esperados, residuos brutos, estandarizados y ajustados, y la contribución de cada celda al chi-cuadrado.
- V de Cramér al cuadrado y prueba exacta de Fisher para tablas de 2×2.
- Advertencia cuando algunos conteos esperados son menores de 5.
Métodos estadísticos
Los registros con un valor faltante en la variable de fila, de columna o de capa se excluyen. Para la tabla de conteos observados O con totales de fila Rᵢ, totales de columna Cⱼ y total N, el conteo esperado bajo independencia es Eᵢⱼ = Rᵢ·Cⱼ / N. El estadístico de Pearson χ² = Σ (O − E)² / E (sin corrección de continuidad, también para tablas de 2×2) y el estadístico de razón de verosimilitud G² = 2 Σ O·ln(O / E) se comparan con una distribución chi-cuadrado con (r − 1)(c − 1) grados de libertad. Un valor p pequeño significa que la distribución de las columnas difiere entre las filas.
Para ver qué celdas determinan el resultado: la contribución de una celda es (O − E)² / E; el residuo bruto es O − E; el residuo estandarizado es (O − E) / √E; el residuo ajustado (O − E) / √(E(1 − Rᵢ/N)(1 − Cⱼ/N)) es aproximadamente normal estándar, por lo que los valores más allá de ±2 aproximadamente señalan celdas que difieren claramente de la independencia. La V de Cramér al cuadrado = χ² / (N·(min(r, c) − 1)) mide la fuerza de la asociación de 0 (ninguna) a 1 (completa); con una muestra grande, una asociación débil aún puede ser significativa.
La aproximación chi-cuadrado requiere conteos esperados razonablemente grandes; la página informa de cuántas celdas tienen un conteo esperado menor de 5. Para una tabla de 2×2, la prueba exacta de Fisher da un valor p exacto que no depende de esta aproximación. Las categorías aparecen en orden alfabético.
Campos de entrada y opciones
Campo | Descripción |
Rows | Columna categórica para las filas de la tabla. Obligatorio. |
Columns | Columna categórica para las columnas. Obligatorio; debe ser distinta de Rows. |
For layers | Opcional. Genera una tabla y una prueba por separado para cada valor de esta variable. |
Row percents / Column percents / Total percents | Añaden tablas de porcentajes. Desactivadas de forma predeterminada. |
Chi-Square test | Prueba chi-cuadrado de Pearson. Activada de forma predeterminada. |
Likelihood ratio chi-square | Añade la prueba de razón de verosimilitud. |
Expected cell counts / Raw residuals / Standardized residuals / Adjusted residuals / Each cell's contribution to chi-square | Añaden estas tablas. Desactivadas de forma predeterminada. |
Cramer's V-square statistic | Fuerza de la asociación. |
Fisher's exact test for 2x2 tables | Valor p exacto; se informa solo para tablas de 2×2. |
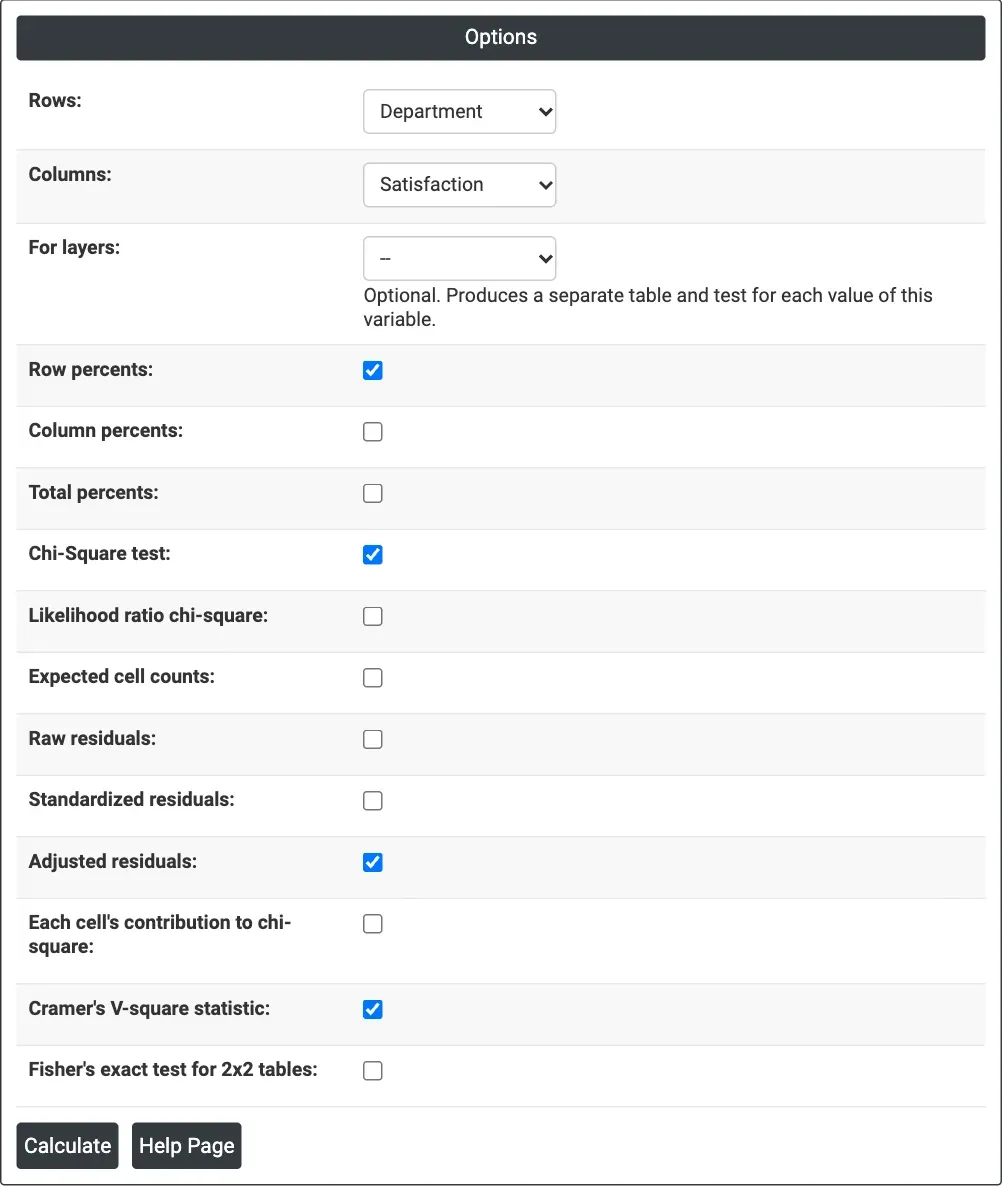
Figura 1 — Opciones del ejemplo de la encuesta: Department como filas, Satisfaction como columnas, porcentajes por fila, prueba chi-cuadrado, residuos ajustados y Cramer's V-square marcados.
Descripción de las salidas
- Counts — la tabla de conteos con los totales All (una por capa).
- Row percents, Column percents, Total percents, Expected counts, Raw, Standardized y Adjusted residuals, tablas Contribution — cuando se marcan.
- Chi-Square Test — Chi-Square, DF y P-Value de las pruebas de Pearson y de razón de verosimilitud, con una nota cuando los conteos esperados son menores de 5.
- Other Statistics — Cramer's V-square y P-Value de la prueba exacta de Fisher.
- Exportación a PDF mediante Download.
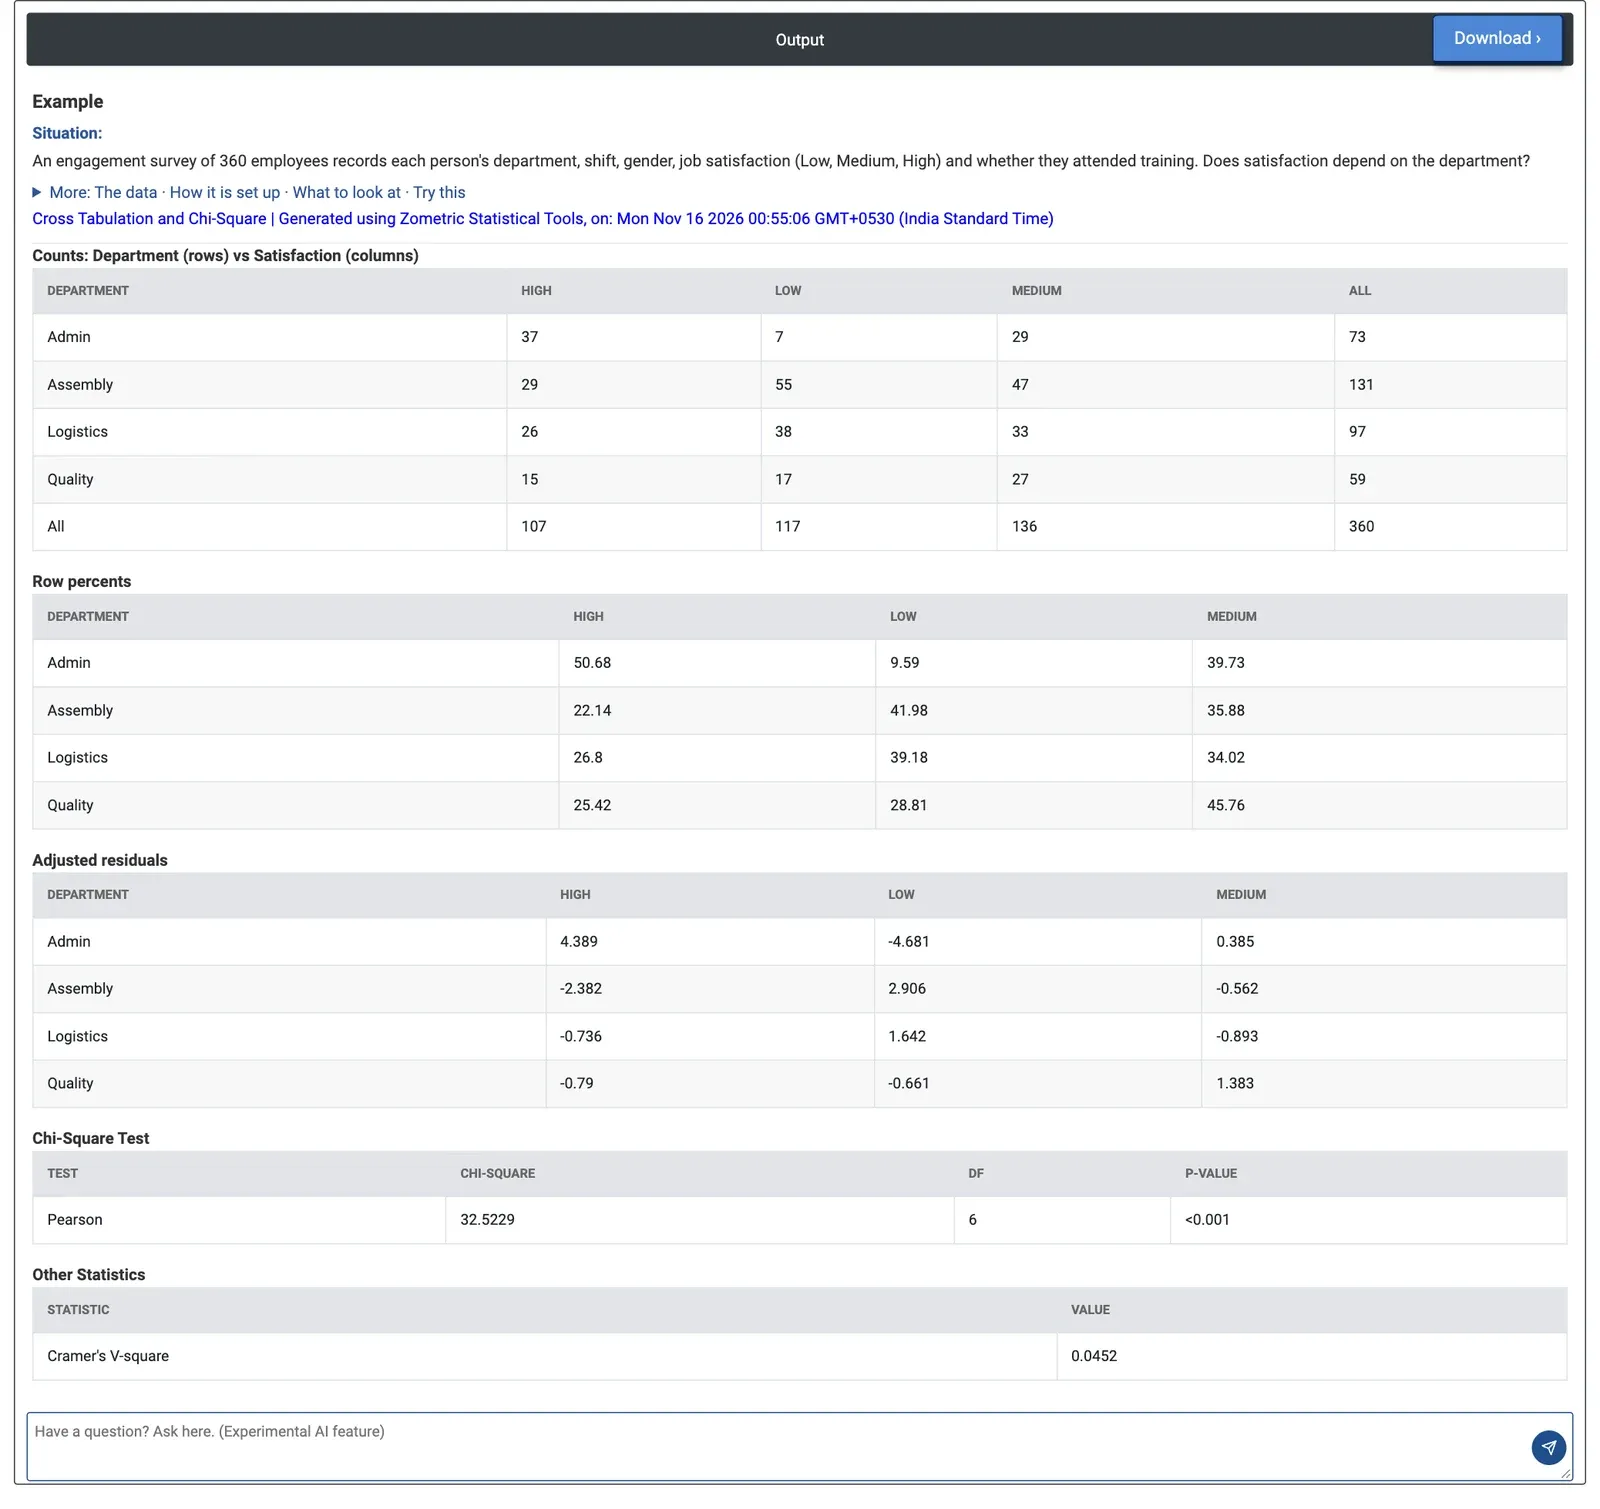
Figura 2 — Satisfacción por departamento: chi-cuadrado de Pearson 32.52 con 6 DF, p < 0.001; Admin tiene más calificaciones High y Assembly más Low.
Ejemplo
Una encuesta de compromiso a 360 empleados registra el departamento, el turno, el género, la satisfacción (Low, Medium, High) y si asistieron a capacitación. Recursos Humanos quiere saber si la satisfacción depende del departamento. Elige Department como filas y Satisfaction como columnas, y marca porcentajes por fila, residuos ajustados y Cramer's V-square.
La satisfacción sí depende del departamento: chi-cuadrado de Pearson 32.52 con 6 DF, p < 0.001. Admin es el más satisfecho, con 50.68% de High y solo 9.59% de Low; Assembly el menos satisfecho, con 41.98% de Low y 22.14% de High. Los residuos ajustados más allá de ±2 muestran las celdas que explican el resultado: Admin High (+4.389) y Low (−4.681), Assembly Low (+2.906) y High (−2.382). La V de Cramér al cuadrado es 0.0452: una asociación real pero modesta.
Al establecer For layers en Shift se obtiene una tabla por turno. En el turno de noche, Logistics tiene solo 4.88% de High y 53.66% de Low (residuo ajustado de High −2.475), frente a 42.86% de High en el turno de día, por lo que el equipo de Logistics del turno de noche es donde conviene empezar; la tabla de la noche incluye una nota de que 1 celda tiene un conteo esperado menor de 5. Género frente a asistencia a capacitación es una tabla de 2×2: la prueba exacta de Fisher da p = 0.5888, por lo que no hay indicio de que la asistencia a capacitación difiera según el género.
Preguntas frecuentes
¿Cuál es la diferencia entre la tabulación cruzada y la prueba chi-cuadrado?
La tabulación cruzada cuenta con qué frecuencia aparece cada combinación de dos variables categóricas y da una tabla de doble entrada con totales por fila y por columna y porcentajes opcionales. La prueba chi-cuadrado comprueba después si las dos variables están relacionadas: un valor p pequeño significa que la distribución de las columnas difiere entre las filas. Una tercera variable puede dividir el análisis en capas.
¿Qué mide la V de Cramér al cuadrado?
La V de Cramér al cuadrado = χ² / (N·(min(r, c) − 1)) mide la fuerza de la asociación, de 0 (ninguna) a 1 (completa). Con una muestra grande, una asociación débil aún puede ser estadísticamente significativa; en el ejemplo de la encuesta, V al cuadrado fue 0.0452, una asociación real pero modesta, aunque p fue menor de 0.001.
¿Cuándo se debe usar la prueba exacta de Fisher?
La aproximación chi-cuadrado requiere conteos esperados razonablemente grandes, y la salida informa de cuántas celdas tienen un conteo esperado menor de 5. Para una tabla de 2x2, la prueba exacta de Fisher da un valor p exacto que no depende de esta aproximación. Solo se informa para tablas de 2x2.
¿Cómo se determina qué celdas determinan la asociación?
Observe la contribución de cada celda al chi-cuadrado, (O − E)² / E, y los residuos. El residuo ajustado es aproximadamente normal estándar, por lo que los valores más allá de ±2 aproximadamente señalan celdas que difieren claramente de la independencia. En el ejemplo, Admin High (+4.389) y Assembly Low (+2.906) estuvieron entre las celdas que explican el resultado.