
Estadística descriptiva (tablas)
Elija variables numéricas y, opcionalmente, variables de agrupación para filas y columnas; luego seleccione entre nueve estadísticos: N, media, error estándar de la media, desviación estándar, mínimo, primer cuartil, mediana, tercer cuartil y máximo. Los valores faltantes se excluyen. Úsela para comparar subgrupos, como los pesos de llenado por llenadora y turno. Describe los datos, pero no prueba si las diferencias son reales.
Última revisión:
Idea clave
Estadística descriptiva (tablas) resume una o más columnas numéricas en una sola tabla desglosada por hasta dos columnas de agrupación, para comparar muchos subgrupos lado a lado antes de profundizar.
En esta página
Propósito
Estadística descriptiva (tablas) resume una o más columnas numéricas en una sola tabla, desglosada por hasta dos columnas de agrupación: una a lo largo del lateral de la tabla y otra en la parte superior. Para cada variable usted elige qué estadísticos mostrar: recuento, media, error estándar de la media, desviación estándar, mínimo, cuartiles, mediana y máximo. Úsela para poner muchos subgrupos lado a lado antes de decidir dónde profundizar, por ejemplo, pesos de llenado por llenadora y turno, tiempos de ciclo por línea y producto, o resultados de ensayo por proveedor y lote. Describe los datos; no prueba si las diferencias son reales.
Capacidades principales
- Varias variables numéricas en una sola tabla, cada una con su propio bloque de estadísticos.
- Desglose por una variable de fila, una variable de columna o ambas: los grupos de la variable de fila recorren la tabla hacia abajo y los de la variable de columna, a lo ancho, como en Minitab.
- Nueve estadísticos para elegir; N, Mean, Standard deviation, Minimum, Median y Maximum están marcados de forma predeterminada.
- Los valores faltantes de una variable se excluyen de los estadísticos de esa variable.
- Exportación a PDF mediante Download.
Métodos estadísticos
Los datos se dividen por los niveles de la variable de fila y de la variable de columna (cuando se indican), y los estadísticos se calculan por separado dentro de cada grupo y para cada variable, tras eliminar los valores faltantes y no numéricos. Los grupos aparecen en el orden de clasificación de los valores de agrupación. Sin variable de agrupación, la tabla tiene una fila para toda la columna.
N es el número de valores no faltantes. La media x̄ = Σx / N. La desviación estándar s usa el divisor N − 1: s = √(Σ(x − x̄)² / (N − 1)). SE of mean = s / √N, la incertidumbre de la media del grupo. Minimum, Median y Maximum son los valores más pequeño, central y más grande. El primer y el tercer cuartil son los percentiles 25 y 75, hallados por interpolación lineal entre los valores ordenados en la posición 1 + (N − 1)·p, por lo que pueden diferir ligeramente de los programas que usan la regla (N + 1)·p. Con grupos pequeños (menos de unos 10 valores), la desviación estándar y los cuartiles son aproximados, así que léalos con cautela.
Campos y opciones de entrada
Campo | Descripción |
Variables | Obligatorio. Una o más columnas numéricas que se resumirán (mantenga Ctrl o Cmd para seleccionar varias). |
For rows (optional) | Columna de agrupación. Cada uno de sus niveles obtiene sus propias filas en la tabla. |
For columns (optional) | Segunda columna de agrupación. Sus niveles se convierten en las columnas de la tabla, una por nivel; cada fila contiene entonces un estadístico de una variable (para cada nivel de la variable de fila, si se indicó). |
N / Mean / SE of mean / Standard deviation / Minimum / First quartile / Median / Third quartile / Maximum | Estadísticos que se mostrarán para cada variable. Marcados de forma predeterminada: N, Mean, Standard deviation, Minimum, Median y Maximum. Debe marcarse al menos uno. |
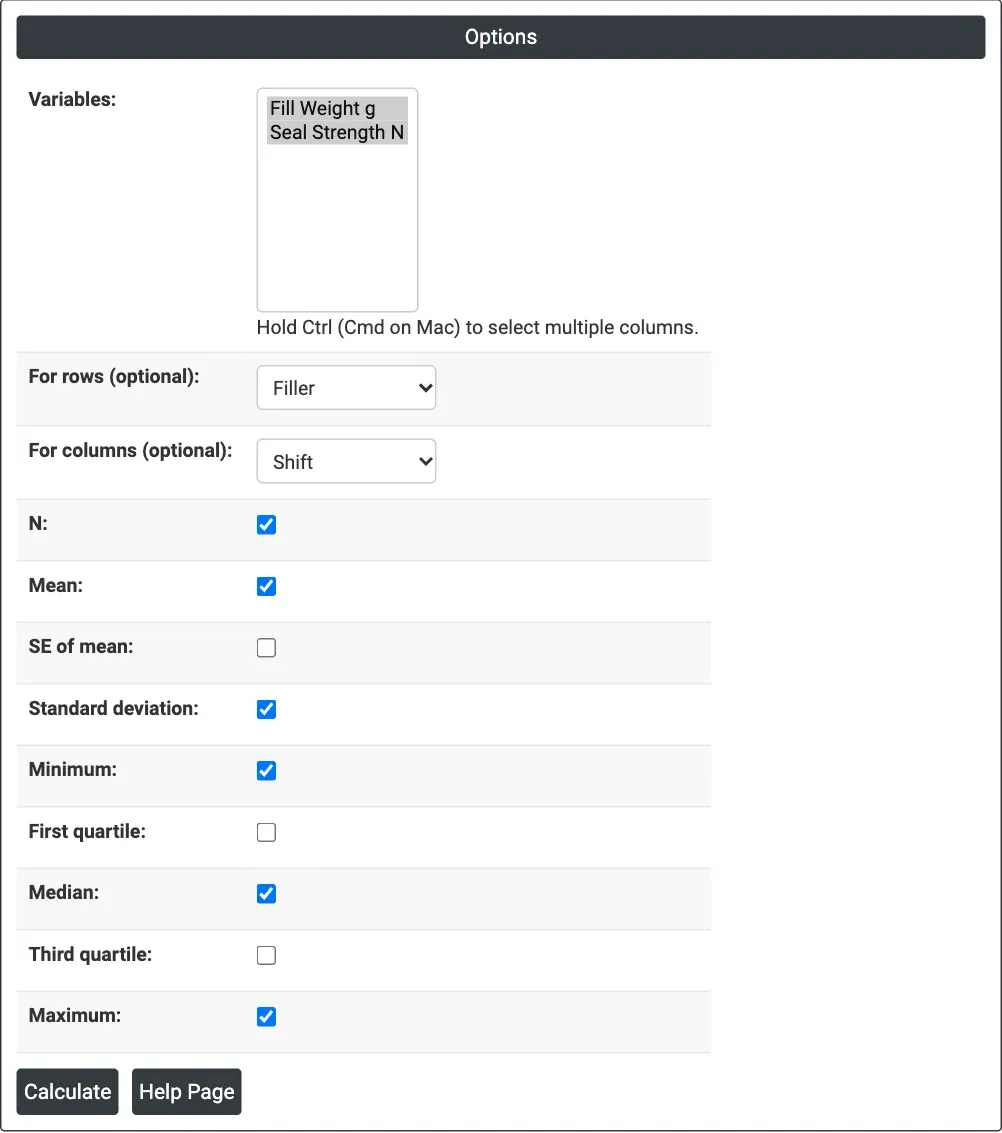
Figura 1 — Fill Weight g y Seal Strength N resumidos por Filler (filas) y Shift (columnas) con los estadísticos predeterminados.
Descripción de la salida
- Statistics table — con una variable de columna (encabezada “Rows: <row variable>; Columns: <column variable>”): primero el nivel de la variable de fila, Variable y Statistic, y luego una columna por cada nivel de la variable de columna. Sin ella: una fila por cada grupo de la variable de fila (o una sola fila en total), y luego una columna por variable y estadístico, denominada Variable_Statistic, p. ej., Fill Weight g_Mean, Seal Strength N_StDev (Q1, Q3 y SE Mean para los estadísticos opcionales).
- Exportación a PDF mediante Download.
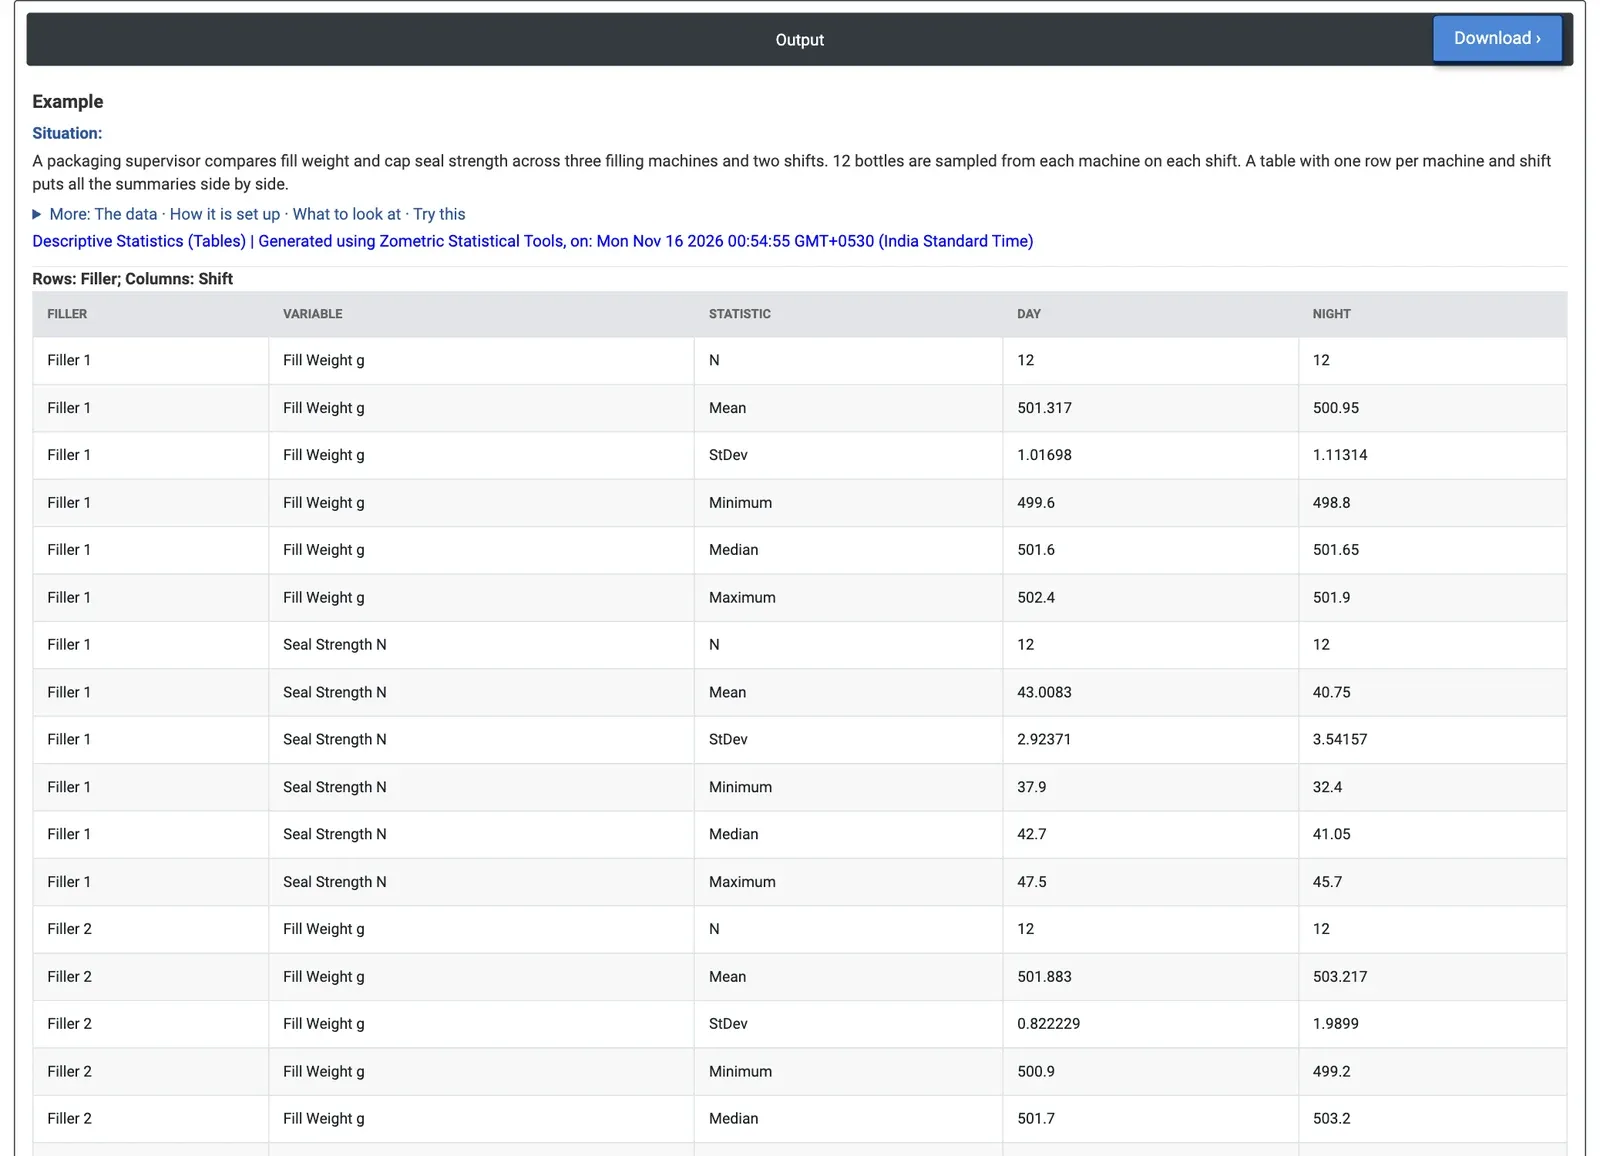
Figura 2 — Llenadoras en el lateral y turnos en la parte superior: la resistencia del sellado es menor en el turno Night para las tres llenadoras, y Filler 2 en el turno Night llena más pesado y con mayor variabilidad.
Ejemplo
Un supervisor de envasado compara tres máquinas llenadoras en dos turnos. Se muestrean doce botellas de cada llenadora en cada turno (72 en total) y se mide el peso de llenado (g) y la resistencia del sellado de la tapa (N) de cada botella. El supervisor selecciona Variables = Fill Weight g y Seal Strength N, For rows = Filler y For columns = Shift, y mantiene los estadísticos predeterminados.
La resistencia del sellado es menor en el turno Night para todas las llenadoras: medias de 40.75, 38.93 y 38.66 N de noche frente a 43.01, 43.38 y 43.23 N de día. El patrón es el mismo en las tres máquinas, lo que apunta a algo del turno (cuadrilla, lote de tapas, ajuste de par) y no a una sola máquina. El peso de llenado cuenta otra historia: Filler 2 en el turno Night es la más pesada (media 503.22 g) y la más variable (desviación estándar 1.99 g, rango de 499.2 a 506.2 g), mientras que Filler 3 es la más ligera en ambos turnos (499.67 y 499.61 g).
Para una vista por turno, al fijar For rows = Shift sin variable de columna y marcar First quartile y Third quartile se obtienen medias de resistencia del sellado de 43.21 N de día y 39.44 N de noche, con la mitad central de las botellas de la noche entre 37.15 y 41.18 N. La tabla muestra dónde mirar; para comprobar si las diferencias entre turnos y llenadoras son mayores que el azar, el supervisor ejecuta un ANOVA de dos factores sobre Seal Strength N con Filler y Shift como factores.
Preguntas frecuentes
¿Cuándo conviene usar tablas de estadística descriptiva?
Úselas para poner muchos subgrupos lado a lado antes de decidir dónde profundizar, por ejemplo, pesos de llenado por llenadora y turno, tiempos de ciclo por línea y producto, o resultados de ensayo por proveedor y lote. Una variable de agrupación recorre el lateral de la tabla y una segunda puede recorrer la parte superior.
¿Cómo se calculan los cuartiles?
El primer y el tercer cuartil son los percentiles 25 y 75, hallados por interpolación lineal entre los valores ordenados en la posición 1 + (N − 1)·p, por lo que pueden diferir ligeramente de los programas que usan la regla (N + 1)·p. Con grupos pequeños de menos de unos 10 valores, la desviación estándar y los cuartiles son aproximados, así que léalos con cautela.
¿Una tabla de estadística descriptiva prueba si los grupos difieren?
No. Describe los datos, pero no prueba si las diferencias son reales. En el ejemplo, la tabla mostró una resistencia del sellado menor en el turno de noche para las tres llenadoras; para comprobar si las diferencias entre turnos y llenadoras eran mayores que el azar, el supervisor ejecutó un ANOVA de dos factores.
¿Cómo se configura la tabla en Zometric Statistical Software?
Seleccione una o más Variables numéricas, opcionalmente una columna For rows y una columna For columns, y marque los estadísticos que se mostrarán. N, Mean, Standard deviation, Minimum, Median y Maximum están marcados de forma predeterminada, y debe marcarse al menos uno. La desviación estándar usa el divisor N − 1 y los valores faltantes se excluyen.