
Análisis discriminante
Se le proporcionan elementos de grupo conocido y predictores numéricos. El análisis discriminante lineal supone predictores con distribución normal multivariante y una matriz de covarianza común; el cuadrático admite una por grupo. Las probabilidades a priori pueden ser iguales, proporcionales o especificadas por el usuario. La salida incluye matrices de confusión, exactitud global y con validación cruzada dejando uno fuera, y funciones de clasificación lineales para evaluar nuevos elementos. Úselo para comprobar si un grado puede distinguirse a partir de datos de inspección.
Última revisión:
Idea clave
El análisis discriminante construye una regla que asigna elementos a grupos conocidos a partir de valores medidos, encontrando la combinación de mediciones que mejor separa los grupos e informando cuántos elementos clasifica correctamente.
En esta página
Propósito
El análisis discriminante construye una regla que asigna elementos a grupos conocidos a partir de valores medidos. Usted le proporciona elementos cuyo grupo se conoce (por ejemplo, lotes Standard y Premium, piezas buenas y malas, o proveedores) y las mediciones tomadas en ellos; la herramienta encuentra la combinación de mediciones que mejor separa los grupos y muestra cuántos elementos clasifica correctamente la regla. Úselo para comprobar si un grado o tipo puede distinguirse a partir de datos de inspección, o para construir una regla de clasificación de nuevos elementos.
Funciones principales
- Funciones discriminantes lineales o cuadráticas para dos o más grupos.
- Probabilidades a priori iguales para todos los grupos, proporcionales al tamaño de los grupos o definidas por usted.
- Matriz de confusión del grupo real frente al grupo predicho, con el porcentaje global clasificado correctamente.
- Validación cruzada dejando uno fuera para una estimación más realista del funcionamiento de la regla con nuevos elementos.
- Funciones de clasificación lineales (una constante y un coeficiente por predictor para cada grupo) para evaluar nuevos elementos.
Métodos estadísticos
Se descartan las filas con un grupo ausente o con un predictor ausente o no numérico. La respuesta se trata como una etiqueta de texto, y los grupos se enumeran en orden alfabético o numérico. Debe haber al menos 2 grupos y más filas que la suma del número de predictores y el número de grupos.
El análisis discriminante lineal supone que los predictores siguen una distribución normal multivariante en cada grupo con la misma matriz de covarianza. Estima la media de cada grupo x̄g y una matriz de covarianza combinada dentro de los grupos S, y asigna a cada grupo una puntuación Lg(x) = x̄gᵀ S⁻¹ x − ½ x̄gᵀ S⁻¹ x̄g + ln(pg), donde pg es la probabilidad a priori del grupo. Un elemento se asigna al grupo con la puntuación más alta. La tabla Linear Discriminant (Classification) Functions enumera, para cada grupo, la constante (−½ x̄gᵀ S⁻¹ x̄g + ln pg) y los coeficientes S⁻¹ x̄g. El análisis discriminante cuadrático prescinde del supuesto de covarianzas iguales y estima una matriz de covarianza distinta para cada grupo, lo que da fronteras curvas; necesita más datos por grupo y no tiene funciones de clasificación sencillas.
Las probabilidades a priori son 1/k para k grupos por defecto. Las probabilidades a priori proporcionales usan la participación de cada grupo en los datos, lo que favorece a los grupos más grandes. La exactitud por resustitución clasifica los mismos elementos con los que se construyó la regla y es optimista. La validación cruzada dejando uno fuera retira cada elemento por turno, construye la regla con el resto y clasifica el elemento retirado, por lo que es una mejor guía de la exactitud con nuevos elementos.
Campos de entrada y opciones
Campo | Descripción |
Response (grouping variable) | Obligatorio. Columna categórica con el grupo conocido de cada elemento. |
Predictors | Una o más columnas numéricas usadas para separar los grupos. |
Discriminant function | Linear (predeterminado; matriz de covarianza común) o Quadratic (una matriz de covarianza por grupo). |
Prior probabilities | All groups equal (predeterminado), Proportional to group sizes in the data o User-specified. |
Custom priors | Solo se usa cuando Prior probabilities es User-specified. Un valor por grupo, separados por comas o espacios, en orden alfabético o numérico de los grupos; todos positivos y con suma 1, p. ej., 0.2, 0.5, 0.3. |
Cross-validate (leave-one-out) | Marcada por defecto. Añade la exactitud con validación cruzada y la matriz de confusión correspondiente. |
Title | Título del análisis. Por defecto Discriminant Analysis. |
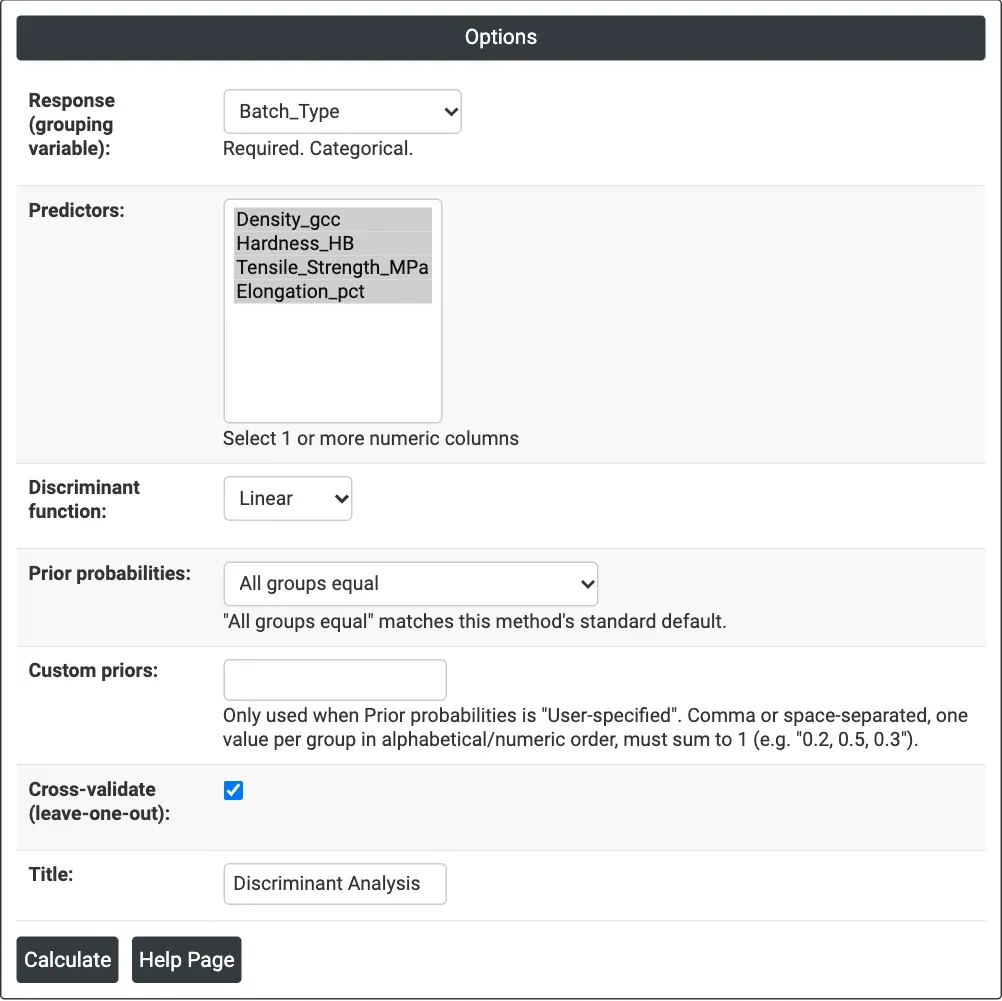
Figura 1: opciones del ejemplo: Batch_Type como respuesta, cuatro columnas de propiedades como predictores, función lineal, probabilidades a priori iguales, validación cruzada dejando uno fuera.
Descripción de la salida
- Summary line — N usado, exactitud por resustitución y, cuando está marcada, exactitud con validación cruzada (dejando uno fuera).
- Prior Probabilities — la probabilidad a priori usada para cada grupo.
- Confusion Matrix (Resubstitution) — grupo real en las filas, grupo predicho en las columnas.
- Confusion Matrix (Cross-Validated) — lo mismo con las predicciones dejando uno fuera.
- Linear Discriminant (Classification) Functions — solo para una función lineal: la constante y el coeficiente de cada predictor para cada grupo. Un nuevo elemento se asigna al grupo cuya función da el valor más alto.
- Exportación a PDF mediante Download.
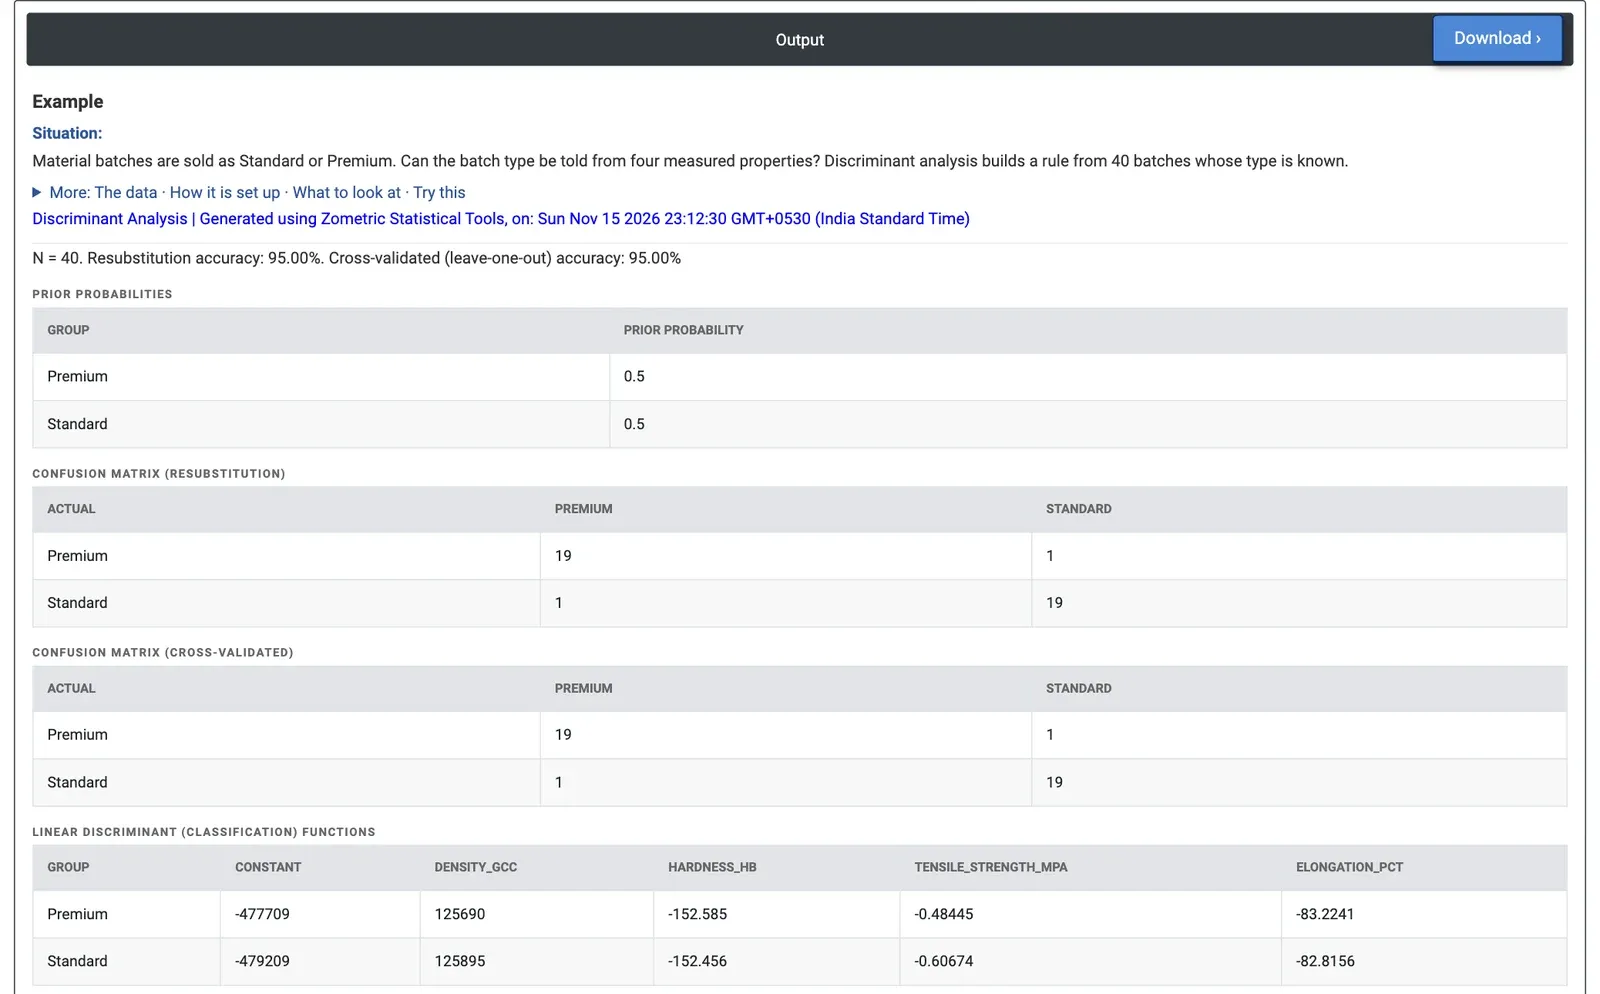
Figura 2: resultados de 40 lotes: el 95 % se clasifica correctamente, tanto con los datos como con la validación cruzada dejando uno fuera; se clasifica mal un lote de cada tipo.
Ejemplo práctico
Una planta de materiales vende lotes como Standard o Premium. El ingeniero de calidad quiere saber si el tipo de lote puede distinguirse a partir de cuatro mediciones de rutina: densidad (g/cc), dureza (HB), resistencia a la tracción (MPa) y alargamiento (%). El ingeniero usa 40 lotes cuyo tipo se conoce, 20 de cada uno, y establece Response (grouping variable) = Batch_Type, las cuatro propiedades como Predictors, Discriminant function = Linear, Prior probabilities = All groups equal y Cross-validate marcada.
La regla clasifica correctamente 38 de los 40 lotes: 95.00 % con los datos y 95.00 % con la validación cruzada dejando uno fuera, por lo que no solo se ajusta a los 40 lotes con los que se construyó. En cada tipo, 19 de 20 son correctos. Los dos lotes mal clasificados son la fila 3 (Standard, 197.4 HB, 1,210.8 MPa) y la fila 27 (Premium, 202.3 HB, 1,209.7 MPa): se sitúan entre las medias de los grupos (Premium 212.9 HB y 1,253.6 MPa, Standard 180.1 HB y 1,126.2 MPa) y conviene revisarlos. Las funciones de clasificación dan a cada nuevo lote una puntuación Premium y una puntuación Standard a partir de sus cuatro mediciones, y el lote se asigna al tipo con la puntuación más alta.
La densidad importa más de lo que sugiere su pequeña dispersión: la media Premium es 7.878 g/cc frente a 7.850 de Standard, y al quitar la densidad de los predictores la exactitud baja a 82.5 % (75.0 % con validación cruzada). Una función cuadrática lo hace peor aquí, con 92.5 % con los datos y 85.0 % con validación cruzada, porque estima más parámetros con solo 20 lotes por grupo. Para el ingeniero, la regla lineal con las cuatro propiedades es suficientemente buena para señalar lotes cuya etiqueta no coincide con sus mediciones. En comparación con agrupar los mismos datos sin las etiquetas (Cluster K-Means coincide con los tipos en 28 de 40), conocer los grupos da una separación mucho más clara.
Preguntas frecuentes
¿Cuál es la diferencia entre el análisis discriminante lineal y el cuadrático?
El análisis discriminante lineal supone que los predictores tienen distribución normal multivariante en cada grupo con la misma matriz de covarianza, y da funciones de clasificación lineales. El análisis discriminante cuadrático estima una matriz de covarianza distinta para cada grupo, lo que da fronteras curvas, pero necesita más datos por grupo y no tiene funciones de clasificación sencillas. En el ejemplo, el cuadrático lo hizo peor con solo 20 lotes por grupo.
¿Por qué usar la validación cruzada dejando uno fuera?
La exactitud por resustitución clasifica los mismos elementos con los que se construyó la regla, por lo que es optimista. La validación cruzada dejando uno fuera retira cada elemento por turno, construye la regla con el resto y clasifica el elemento retirado, lo que da una mejor guía de la exactitud con nuevos elementos. En el ejemplo ambas fueron del 95 %, por lo que la regla no solo se ajustaba a sus propios datos.
¿Cómo afectan las probabilidades a priori al análisis discriminante?
Por defecto, cada uno de los k grupos recibe una probabilidad a priori de 1/k. Las probabilidades a priori proporcionales usan la participación de cada grupo en los datos, lo que favorece a los grupos más grandes. Las probabilidades a priori especificadas por el usuario deben ser positivas, indicarse una por grupo en orden alfabético o numérico de los grupos y sumar 1. La probabilidad a priori interviene en la puntuación de cada grupo a través de su logaritmo natural.
¿Cómo se clasifica un nuevo elemento con el análisis discriminante?
Para una función discriminante lineal, Zometric Statistical Software enumera una constante y un coeficiente por predictor para cada grupo en la tabla Linear Discriminant (Classification) Functions. Evalúe el nuevo elemento con la función de cada grupo y asígnelo al grupo cuya función dé el valor más alto.