
Gráfica de puntos (Dotplot)
Una gráfica de puntos divide el rango de los datos en intervalos iguales y apila un punto por valor, de modo que la altura de la pila es el conteo. Úselo para muestras de hasta unos cientos de valores antes de resumirlas o de aplicar pruebas que suponen normalidad. Las opciones incluyen una columna de agrupación o varias columnas, el número de intervalos, la escala logarítmica y la exclusión de valores atípicos por la regla de 1.5xIQR.
Última revisión:
Idea clave
Una gráfica de puntos muestra cada valor de un conjunto de datos pequeño o mediano como un punto sobre una recta numérica, apilando los similares, para ver la forma de los datos: concentraciones, huecos, grupos separados y puntos aislados.
En esta página
Finalidad
Una gráfica de puntos (dotplot) muestra cada valor de un conjunto de datos pequeño o mediano como un punto sobre una recta numérica, con los puntos de valor similar apilados unos sobre otros. A diferencia de la media y la desviación estándar, muestra la forma de los datos: dónde se acumulan los valores, los huecos, los grupos separados y los puntos aislados. Úselo para muestras de hasta unos cientos de valores, por ejemplo volúmenes de llenado, dimensiones de una comprobación de la primera pieza o resultados de ensayos de una prueba, antes de resumirlos o de aplicar una prueba que suponga una distribución normal.
Capacidades principales
- Una columna de datos, o varias columnas (modo Multiple Ys), cada una en su propia fila y color.
- Columna de agrupación opcional: una fila de puntos apilados por grupo, como en la gráfica de puntos With Groups de Minitab.
- Número de intervalos definido por usted o calculado a partir del tamaño de muestra.
- Eje X en escala logarítmica para datos positivos y asimétricos.
- Exclusión opcional de valores atípicos por la regla de 1.5×IQR, con una nota de cuántos se eliminaron.
- Data Options para excluir filas, o conservar solo ciertas filas, por número de fila o por una condición.
Métodos estadísticos
Los valores se convierten en números y se descartan las entradas ausentes o no numéricas. El rango desde el valor más pequeño hasta el más grande se divide en intervalos iguales; cuando Number of bins está en blanco, el número es 2 × √n redondeado hacia arriba, entre 10 y 60 (10 intervalos para 25 valores). Cada valor se sitúa en el centro de su intervalo y los valores del mismo intervalo se apilan unos sobre otros, por lo que la altura de una pila es el conteo de ese intervalo. Por tanto, los puntos muestran los valores con la precisión del intervalo, no exactamente; el valor más grande va al último intervalo. Con una columna de agrupación, o con varias columnas de datos, cada grupo o columna tiene su propia fila (la primera arriba) y todas las filas comparten los mismos intervalos, de modo que las filas pueden compararse directamente. Con Log scale X-axis los intervalos son iguales en la escala logarítmica; entonces todos los valores deben ser mayores que cero.
Con Exclude outliers marcado, los valores por debajo de Q1 − 1.5×IQR o por encima de Q3 + 1.5×IQR (IQR = Q3 − Q1, calculado por grupo cuando se define una columna de agrupación) se eliminan antes de graficar, y una nota bajo la gráfica indica cuántos. Cómo leer la gráfica: una concentración central que decae de forma pareja a ambos lados es coherente con una distribución normal; dos o más concentraciones con huecos entre ellas sugieren una mezcla de fuentes (dos boquillas, dos turnos, dos proveedores) que conviene separar antes de cualquier análisis posterior.
Campos y opciones de entrada
Campo | Descripción |
Data column(s) | Obligatorio. Una columna numérica, o varias para el modo Multiple Ys. Mantenga pulsada la tecla Ctrl o Command para seleccionar varias. |
Grouping column | Opcional. Una fila de puntos apilados por grupo, cada una de su propio color y nombrada en el eje vertical ("With Groups"). |
Number of bins | Opcional, de 5 a 200. Déjelo vacío para calcularlo a partir del número de valores. |
Log scale X-axis | Sin marcar por defecto. Usa un eje X logarítmico e intervalos iguales en esa escala. |
Title | Título que se muestra en la gráfica. Por defecto Dotplot. |
Discrete color sequence | Paleta para los grupos o las columnas, por defecto D3. Una sola columna sin grupos se dibuja en azul marino. |
Exclude outliers (1.5×IQR rule) | Sin marcar por defecto. Elimina los puntos más allá de Q1 − 1.5×IQR y Q3 + 1.5×IQR (por columna de agrupación, cuando se define) antes de graficar. |
Data Options: Subset (optional) | Exclude matching rows (por defecto) o Include only matching rows, según Row numbers (p. ej., 3,7,12-15, con los números de fila originales de la cuadrícula) y/o una Condition (p. ej., Fill_Volume_mL > 249). No tiene efecto a menos que se rellene Row numbers o Condition. |
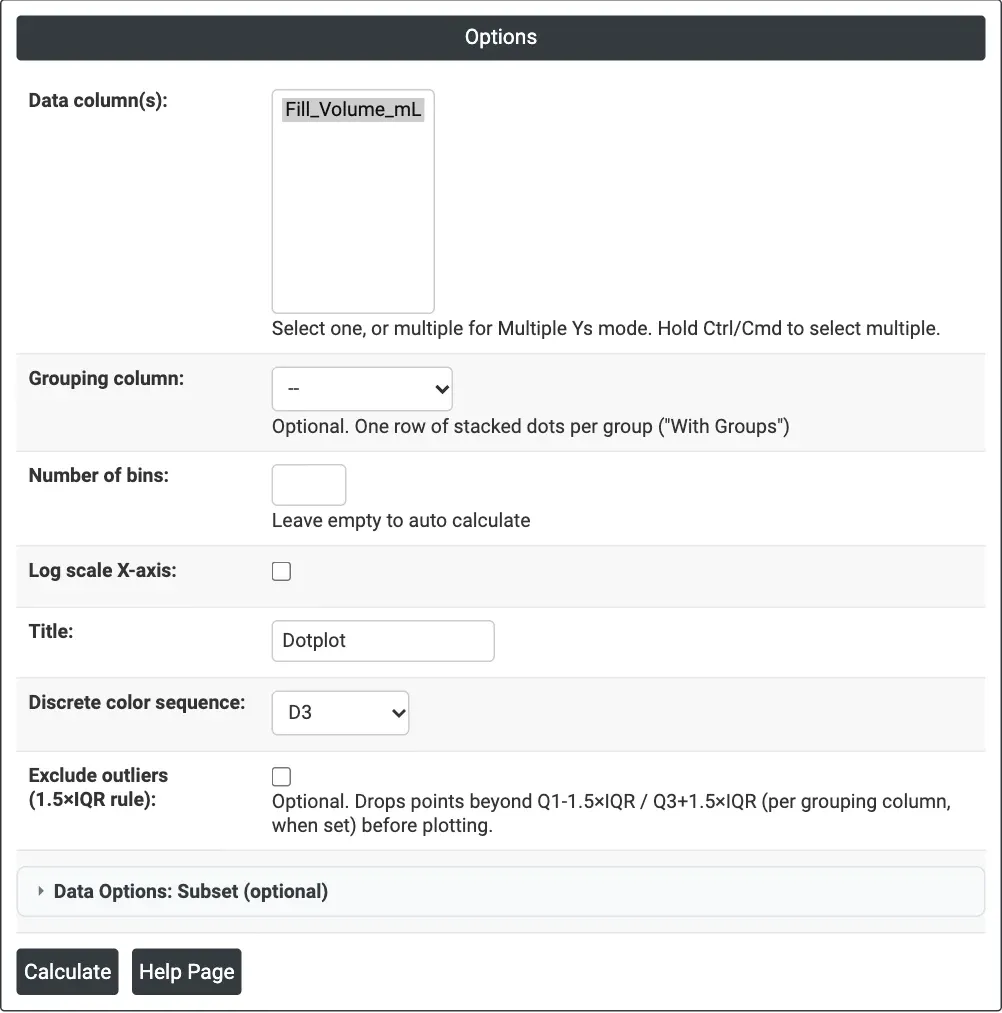
Figura 1 — Gráfica de puntos del volumen de llenado de 25 botellas, con el número de intervalos calculado automáticamente.
Descripción de la salida
- Dotplot — puntos apilados a lo largo del eje X, un punto por valor; con grupos o varias columnas, una fila para cada uno, nombrada en el eje vertical.
- Outlier note — cuando Exclude outliers elimina puntos: cuántos se excluyeron.
- Exportación a PDF mediante Download.
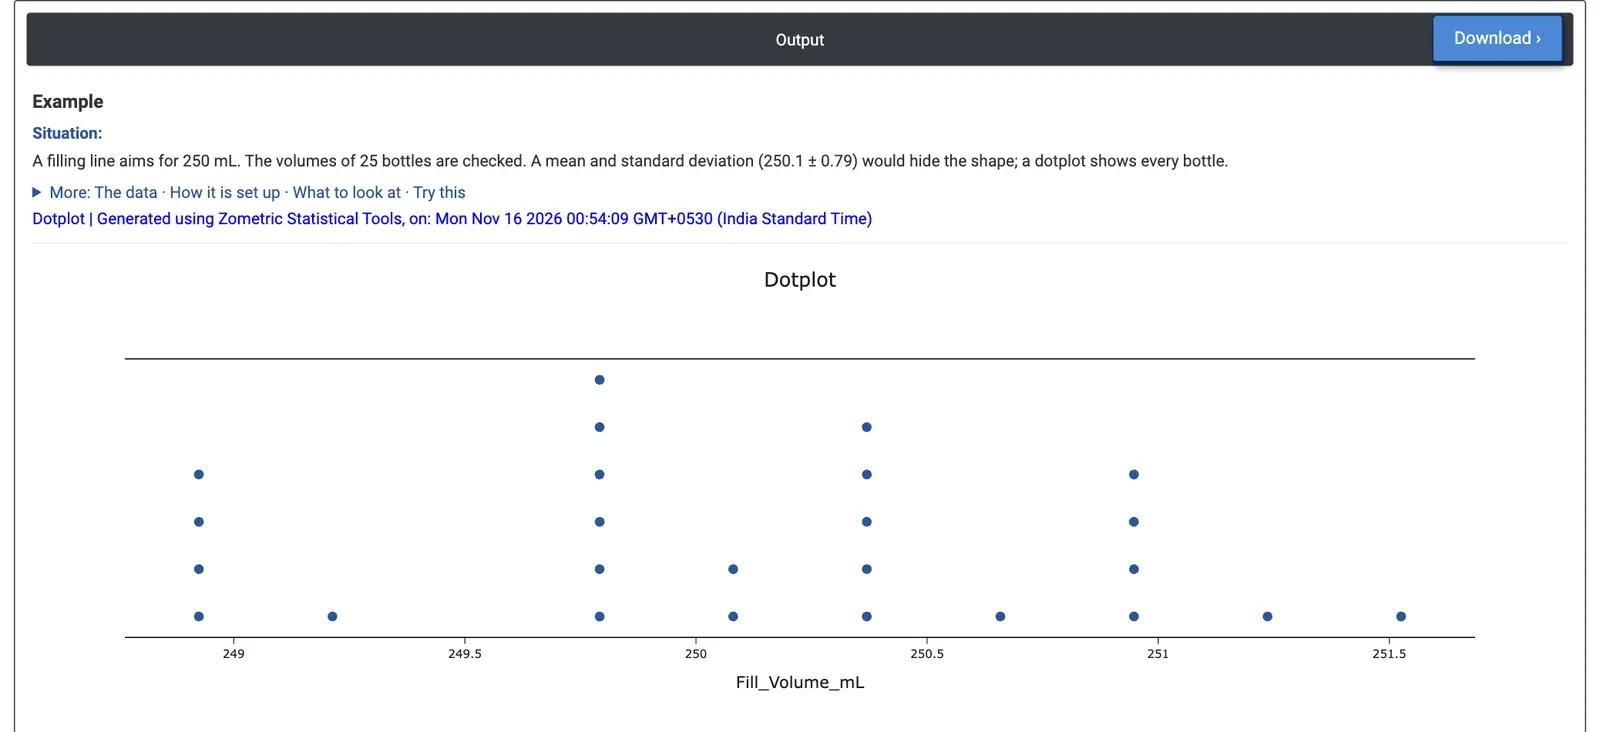
Figura 2 — Volúmenes de llenado de 25 botellas: concentraciones cerca de 249.8, 250.4 y 251.0 mL y un grupo separado de cuatro cerca de 248.9 mL.
Ejemplo
Una línea de llenado apunta a 250 mL por botella. El supervisor de la línea comprueba el volumen de 25 botellas. La media es 250.10 mL con una desviación estándar de 0.79 mL, lo que parece correcto, pero cifras como estas ocultan la forma de los datos. El supervisor selecciona Data column(s) = Fill_Volume_mL y deja Number of bins vacío, por lo que la herramienta usa 10 intervalos de unos 0.29 mL de anchura.
Los llenados van de 248.78 a 251.67 mL. Los puntos no forman una campana ordenada: hay concentraciones de seis botellas cerca de 249.8 mL, cinco cerca de 250.4 mL y cuatro cerca de 251.0 mL, y un grupo separado de cuatro botellas bajas cerca de 248.9 mL (248.78 a 249.05 mL), apartado por un hueco sin botellas entre 249.21 y 249.68 mL. Con Number of bins = 30 las pilas tienen como máximo tres puntos de altura, pero las cuatro botellas bajas siguen apartadas del resto. Exclude outliers no elimina ninguna de ellas, porque están dentro de 1.5×IQR de los cuartiles: son un grupo, no puntos aislados.
Para la decisión, esto significa preguntarse qué divide las botellas, por ejemplo si una boquilla de llenado trabaja por debajo, antes de ajustar la configuración de la línea en su conjunto. Si se registra el número de boquilla de cada botella, usarlo como Grouping column muestra directamente si las botellas bajas proceden de una sola boquilla.
Preguntas frecuentes
¿Cómo se lee una gráfica de puntos?
Una concentración central que decae de forma pareja a ambos lados es coherente con una distribución normal. Dos o más concentraciones con huecos entre ellas sugieren una mezcla de fuentes, como dos boquillas, dos turnos o dos proveedores, que conviene separar antes de cualquier análisis posterior. La altura de cada pila es el conteo de valores de ese intervalo.
¿Cuándo debe usar una gráfica de puntos en lugar de la media y la desviación estándar?
Use una gráfica de puntos siempre que importe la forma de los datos, en muestras de hasta unos cientos de valores. En el ejemplo, 25 volúmenes de llenado tenían una media de 250.10 mL y una desviación estándar de 0.79 mL, lo que parecía correcto, pero la gráfica de puntos reveló un grupo separado de cuatro botellas bajas cerca de 248.9 mL.
¿Cuántos intervalos usa una gráfica de puntos?
Cuando Number of bins se deja en blanco, el número es 2 x √n redondeado hacia arriba, entre 10 y 60, lo que da 10 intervalos para 25 valores. Cada valor se sitúa en el centro de su intervalo, por lo que los puntos muestran los valores con la precisión del intervalo, no exactamente. También puede fijar usted mismo de 5 a 200 intervalos.
¿Cómo se comparan grupos en una gráfica de puntos?
En Zometric Statistical Software, elija una columna de agrupación para obtener una fila de puntos apilados por grupo, o seleccione varias columnas de datos. Todas las filas comparten los mismos intervalos, por lo que pueden compararse directamente. En el ejemplo de llenado, agrupar por número de boquilla mostraría directamente si las botellas bajas procedían de una sola boquilla.