
CDF empírica (función de distribución acumulada empírica)
La CDF empírica ordena los valores y representa cada uno en (i − 0.5) / n como porcentaje, unidos en forma de escalones. Úsela para comparar grupos más allá de sus promedios, leer la proporción de piezas por debajo de un límite o contrastar los datos con una distribución ajustada, como la normal o la de Weibull. Una columna By da una curva por grupo, y se pueden superponer varias variables.
Última revisión:
Idea clave
Una CDF empírica traza, para cada valor de una medición, el porcentaje de observaciones iguales o inferiores a él como una curva escalonada, y muestra a la vez la mediana, la dispersión, las colas y los huecos de toda la distribución.
En esta página
Propósito
La CDF empírica traza, para cada valor de una medición, el porcentaje de observaciones iguales o inferiores a él. El resultado es una curva escalonada que muestra toda la distribución de una vez: la mediana, la dispersión, las colas y cualquier hueco. Úsela para comparar dos o más grupos (máquinas, proveedores, configuraciones) más allá de sus promedios, para leer la proporción de piezas por debajo de un límite o para contrastar los datos con una distribución ajustada.
Capacidades principales
- Una curva escalonada por variable, o por grupo de una variable cuando se elige una columna By.
- Varias variables superpuestas en una sola gráfica para una comparación directa.
- Distribución ajustada opcional superpuesta como línea discontinua: Normal, Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest o Largest Extreme Value, Logistic o Loglogistic.
- Escala porcentual de 0 a 100 en el eje vertical, para poder leer los percentiles directamente en la curva.
- Las filas pueden excluirse o conservarse por número de fila o por una condición antes de graficar.
Métodos estadísticos
Para cada curva se ordenan los valores numéricos no vacíos, x₁ ≤ x₂ ≤ … ≤ xₙ, y el i-ésimo valor se representa en la posición de graficación pᵢ = (i − 0.5) / n, expresada como porcentaje. Los puntos se unen en forma de escalón (horizontal y luego vertical), de modo que la curva sube 100/n por ciento en cada observación. El valor en que una curva cruza el 50% es la mediana de ese grupo; donde cruza el 90% es el percentil 90.
Con una columna By y una sola variable, las filas se dividen según los niveles de la columna By y cada nivel recibe su propia curva. Con varias variables, cada variable recibe una curva y se ignora la columna By.
Cuando se elige una distribución ajustada, sus parámetros se estiman por separado para cada curva (cada grupo o cada variable), como en Minitab, y cada CDF ajustada se dibuja en el rango de sus propios datos. La normal usa la media y la desviación estándar de la muestra; las demás distribuciones usan máxima verosimilitud (Lognormal, Weibull, Exponential y Loglogistic con el umbral fijado en 0, por lo que necesitan valores positivos). La leyenda muestra los parámetros ajustados de cada curva, de modo que cada grupo puede contrastarse con su propio modelo.
Campos de entrada y opciones
Campo | Descripción |
Variables | Una o más columnas numéricas. Seleccione una variable, o varias para superponer sus curvas. |
By (grouping) column | Opcional. Una curva por nivel de esta columna. Solo se usa cuando se selecciona una única variable. |
Overlay fitted distribution | Predeterminado “--- (empirical only)”: sin línea ajustada. O una de Normal, Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest Extreme Value, Largest Extreme Value, Logistic, Loglogistic. |
Title | Título de la gráfica. Valor predeterminado: “Empirical CDF”. |
Data Options: Subset (optional) | Exclude matching rows (predeterminado) o Include only matching rows; Row numbers (p. ej., 3,7,12-15) y/o una Condition (p. ej., Weight_kg > 100) seleccionan las filas. No tiene efecto cuando ambos están en blanco. |
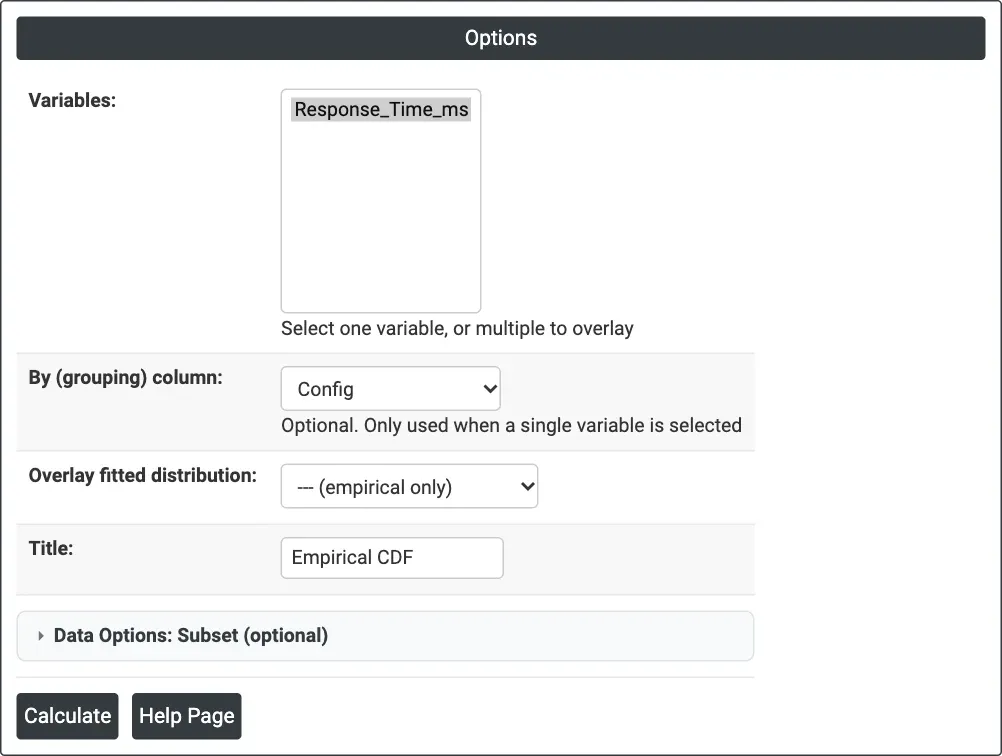
Figura 1 — Opciones del ejemplo: Variables = Response_Time_ms, By (grouping) column = Config, sin distribución ajustada.
Descripción de la salida
- Empirical CDF — curva escalonada del porcentaje frente a la variable para cada grupo o variable, con marcadores en cada observación y una leyenda que nombra las curvas; la distribución ajustada, si se elige, es una línea discontinua para cada curva, del color de la curva (negra cuando solo hay una curva), rotulada con sus parámetros.
- Exportación a PDF mediante Download.
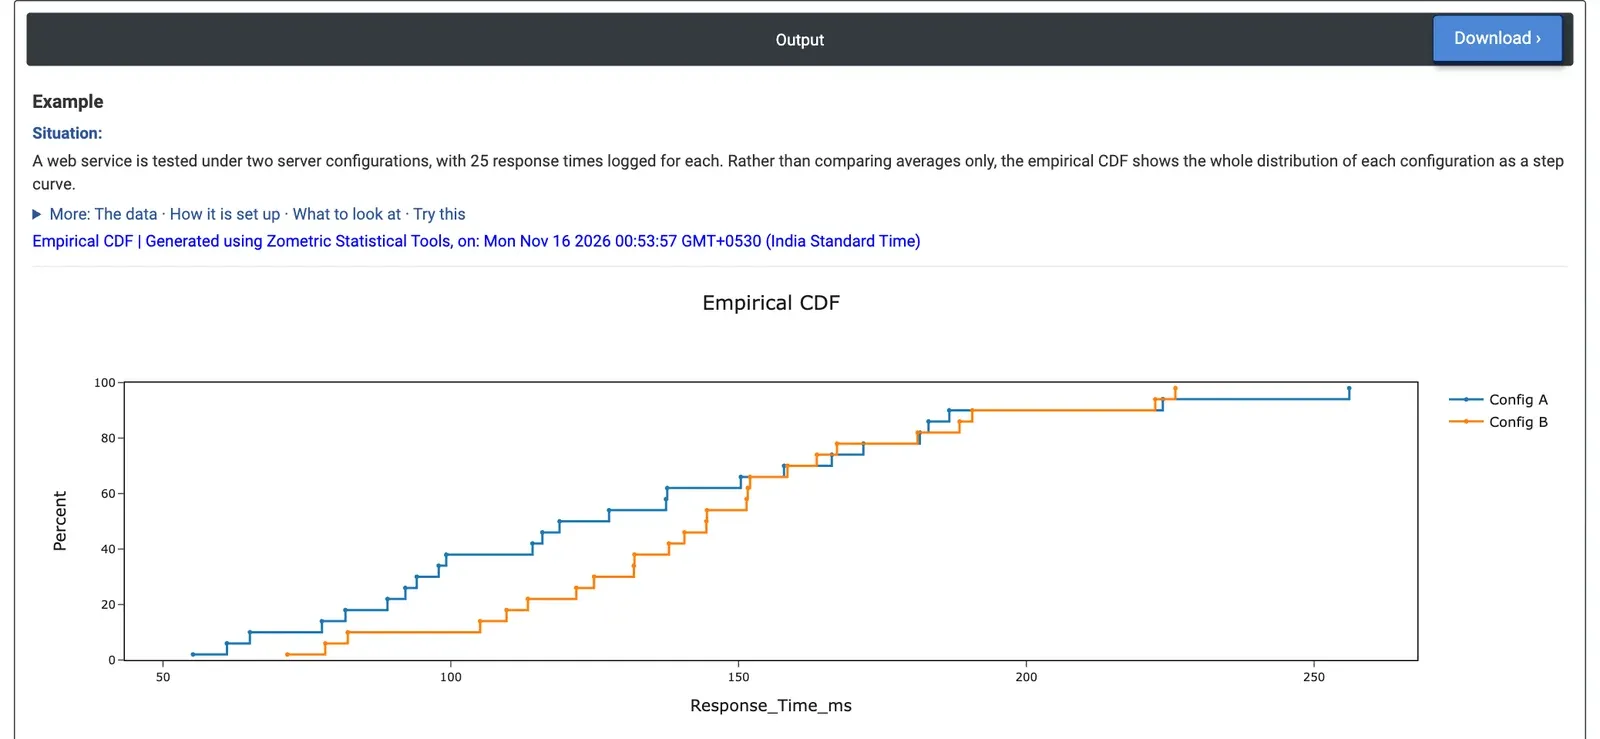
Figura 2 — CDF empírica del tiempo de respuesta de Config A (azul) y Config B (naranja), 25 solicitudes cada una.
Ejemplo
Un equipo de TI prueba un servicio web con dos configuraciones de servidor y registra 25 tiempos de respuesta (ms) para cada una. Los promedios por sí solos (129.7 ms para A, 143.6 ms para B) sugieren que A es más rápida, pero el equipo quiere saber cómo se compara toda la distribución, especialmente las solicitudes lentas que notan los usuarios. Seleccionan Response_Time_ms como variable y Config como columna By, sin distribución ajustada.
Leyendo en horizontal al 50%, la mediana es 118.9 ms para Config A y 144.4 ms para Config B: en la mayor parte del rango la curva de B queda a la derecha, por lo que una solicitud típica es más lenta en B. A 150 ms, el 64% de las solicitudes de A están completadas frente al 56% de las de B. En la parte superior las curvas se cruzan: la solicitud más lenta de A tarda 256.1 ms frente a 225.9 ms para la más lenta de B, y la dispersión de A es mayor (desviación estándar 51.8 frente a 39.7 ms). Ambas configuraciones tienen el 92% de las solicitudes dentro de 200 ms. Así, B es más lenta en una solicitud típica mientras que A tiene la cola más larga; la elección depende de si importa más la mediana o el peor caso para el servicio.
Al elegir Normal como superposición se agrega una curva normal discontinua para cada configuración, ajustada a sus propios 25 valores: media 129.7 ms y desviación estándar 51.8 ms para A, media 143.6 ms y desviación estándar 39.7 ms para B. Donde una curva escalonada se aparta de su curva discontinua, los tiempos de respuesta de esa configuración no son normales.
Preguntas frecuentes
¿Cómo se lee una CDF empírica?
La curva sube 100/n por ciento en cada observación. Lea en horizontal al 50% para hallar la mediana de cada grupo y al 90% para el percentil 90, o lea hacia arriba desde un límite para ver la proporción de valores por debajo de él. En el ejemplo, el tiempo de respuesta mediano fue 118.9 ms para Config A y 144.4 ms para Config B.
¿Por qué comparar grupos con una CDF empírica en lugar de con promedios?
Los promedios ocultan las diferencias de dispersión y de colas. En el ejemplo, Config A tuvo la media y la mediana de tiempo de respuesta más bajas, pero las curvas se cruzaron en la parte superior: la solicitud más lenta de A tardó 256.1 ms frente a 225.9 ms para la más lenta de B. La CDF muestra si lo que difiere es el caso típico o el peor caso.
¿Cómo se contrastan los datos con una distribución ajustada?
Elija una distribución para superponer, como Normal, Lognormal, Weibull, Exponential, Logistic o una distribución de valores extremos. Sus parámetros se estiman por separado para cada curva y se dibujan como una línea discontinua. Donde una curva escalonada se aparta de su curva discontinua, los datos no siguen esa distribución. Lognormal, Weibull, Exponential y Loglogistic requieren valores positivos.
¿Cómo se comparan grupos en Zometric Statistical Software?
Seleccione una sola variable y una By (grouping) column para obtener una curva escalonada por nivel, o seleccione varias variables para superponer sus curvas, en cuyo caso se ignora la columna By. Las filas pueden excluirse o conservarse por número de fila o por una condición antes de graficar, mediante Data Options.