
Análisis factorial
El análisis factorial resume tres o más variables numéricas correlacionadas con menos factores subyacentes. Úselo para hallar las características que hay detrás de resultados de pruebas, mediciones de proceso o ítems de cuestionario. El número de factores debe ser menor que el de variables, con más filas que variables; la máxima verosimilitud supone una normalidad multivariada aproximada. La salida incluye cargas factoriales, comunalidades, unicidad, varianza explicada y una gráfica de cargas.
Última revisión:
Idea clave
El análisis factorial explica las correlaciones entre muchas variables medidas con unos pocos factores subyacentes, de modo que muchas mediciones o ítems de encuesta pueden resumirse en un puñado de factores más fáciles de nombrar.
En esta página
Propósito
El análisis factorial (Factor Analysis) explica las correlaciones entre muchas variables medidas con unos pocos factores subyacentes. Las variables que se mueven juntas cargan en el mismo factor, de modo que una larga lista de mediciones o ítems de encuesta puede resumirse en un puñado de factores más fáciles de nombrar y de seguir. Úselo para hallar las pocas características subyacentes que hay detrás de un conjunto de resultados de pruebas, mediciones de proceso o ítems de cuestionario, y para ver qué variables son en gran medida independientes.
Capacidades principales
- Extrae el número de factores que usted elija a partir de tres o más variables numéricas.
- Dos métodos de extracción: Principal Components y Maximum Likelihood.
- Rotación varimax para que cada factor cargue con fuerza en menos variables y resulte más fácil de nombrar.
- Tabla Factor Loadings con la comunalidad y la unicidad de cada variable.
- Porcentaje de varianza explicada por cada factor y una gráfica de cargas de los dos primeros factores.
Métodos estadísticos
Las filas con un valor ausente o no numérico en cualquiera de las variables seleccionadas se descartan, y cada variable se estandariza a media 0 y desviación estándar 1, de modo que el análisis trabaja sobre la matriz de correlación. El número de factores debe ser menor que el de variables y debe haber más filas que variables.
Con la extracción Principal Components, la matriz de correlación se descompone en valores propios y vectores propios; las cargas del factor j son el j-ésimo vector propio multiplicado por la raíz cuadrada de su valor propio, para los valores propios más grandes. Con la extracción Maximum Likelihood, el modelo de factores comunes (cada variable estandarizada = cargas × factores + un error único) se ajusta por máxima verosimilitud con un algoritmo iterativo, que se detiene tras Maximum iterations (predeterminado 1000) o cuando el cambio cae por debajo de la Convergence tolerance (predeterminado 0.01). La máxima verosimilitud supone que las variables siguen aproximadamente una distribución normal multivariada.
La rotación varimax (método de Kaiser) gira los factores de modo que la varianza de las cargas al cuadrado dentro de cada factor sea lo más grande posible: cada variable carga entonces alto en un factor y cerca de cero en los demás. La rotación no cambia cuánto se explica de cada variable. Tras la rotación, los factores se ordenan según la varianza que explican. La comunalidad de una variable es la suma de sus cargas al cuadrado, la parte de su varianza explicada por los factores; la unicidad es 1 − comunalidad. La varianza explicada por un factor es la suma de sus cargas al cuadrado, expresada como porcentaje del número de variables. El signo de un factor es arbitrario: un factor con todos los signos invertidos significa lo mismo.
Campos y opciones de entrada
Campo | Descripción |
Variables | Tres o más columnas numéricas. Ctrl o Comando + clic para seleccionar varias. |
Number of factors to extract | Predeterminado 2. Debe ser menor que el número de variables. |
Method of extraction | Principal Components (predeterminado) o Maximum Likelihood. |
Type of rotation | Varimax (predeterminado) o None. La rotación solo se aplica con 2 o más factores. |
Maximum iterations | Opcional, solo lo usa la extracción Maximum Likelihood. Déjelo en blanco para el valor predeterminado (1000). |
Convergence tolerance | Opcional, solo lo usa la extracción Maximum Likelihood. Déjelo en blanco para el valor predeterminado (0.01). |
Title | Título que se muestra en la gráfica de cargas. Predeterminado Factor Analysis. |
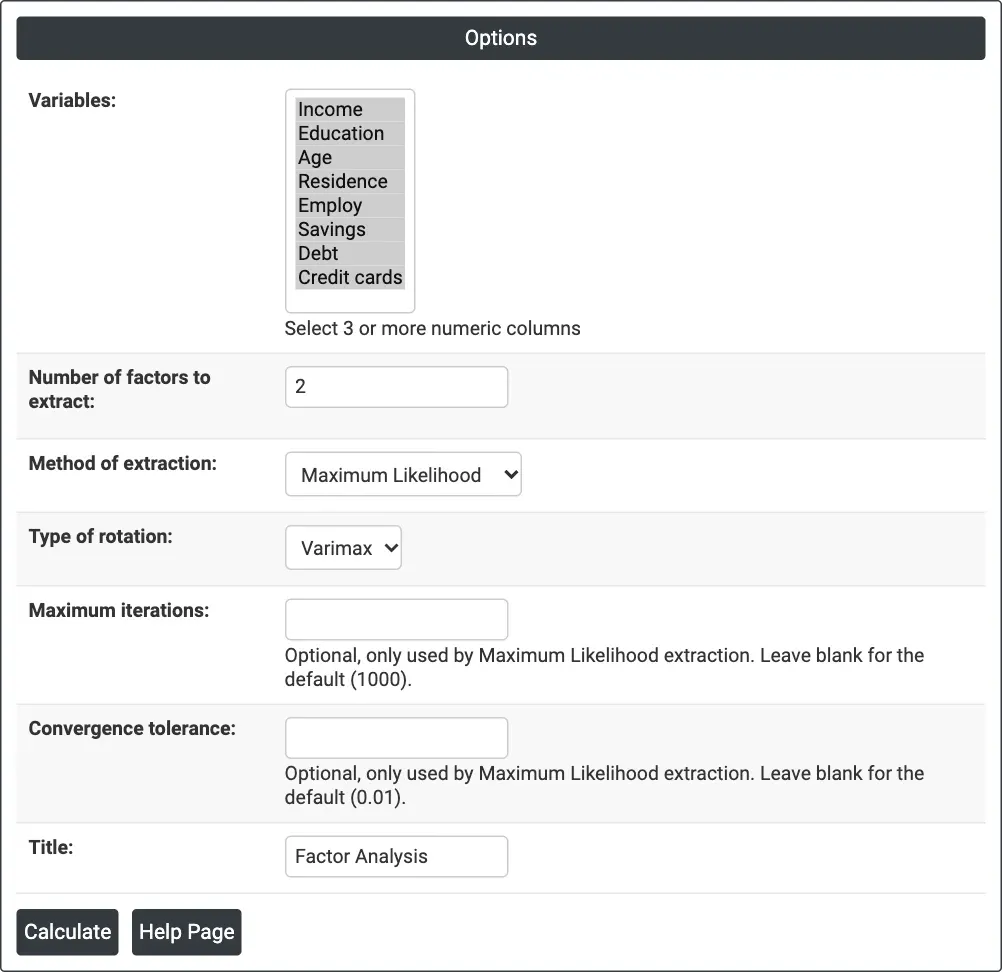
Figura 1: opciones del ejemplo: ocho variables de solicitantes de préstamo, 2 factores, extracción Maximum Likelihood, rotación Varimax.
Descripción de la salida
- Factor Loading Plot: cada variable se dibuja como una línea desde el origen hasta sus cargas en Factor1 (x) y Factor2 (y). Las variables que apuntan en la misma dirección cargan en el mismo factor.
- Método, rotación y varianza explicada: el método y la rotación por su nombre (por ejemplo, Maximum Likelihood, Varimax), el porcentaje de la varianza total explicada por cada factor y el porcentaje acumulado.
- Factor Loadings: para cada variable, su carga en cada factor, su Communality y su Uniqueness.
- Exportación a PDF mediante Download.
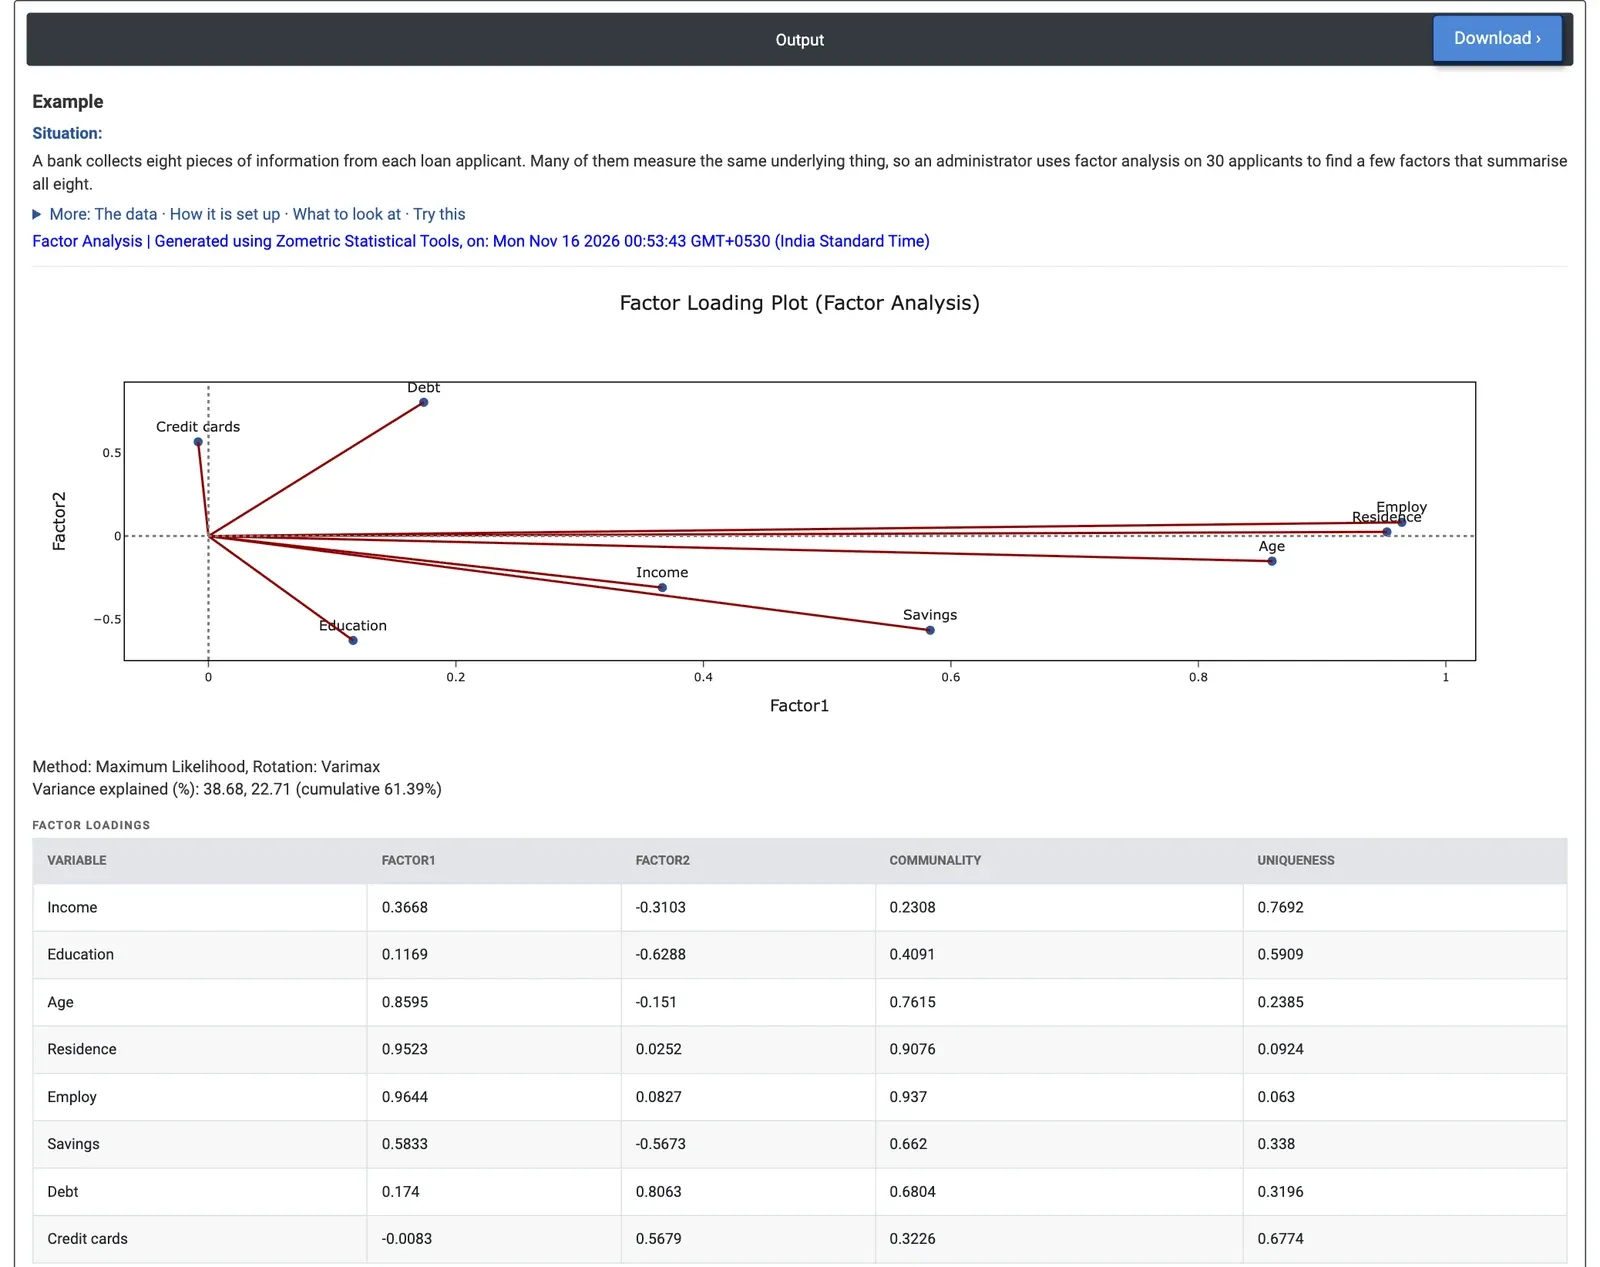
Figura 2: dos factores rotados para ocho variables de solicitantes de préstamo: un factor de estabilidad (Employ, Residence, Age) y un factor de endeudamiento (Debt, Credit cards frente a Education), que explican el 61.39% de la varianza.
Ejemplo
Un banco recopila ocho datos de cada solicitante de préstamo: ingresos, años de estudios, edad, años en el domicilio actual (Residence), años con el empleador actual (Employ), ahorros, deuda y número de tarjetas de crédito. Muchos de ellos parecen medir lo mismo. Un administrador de crédito quiere unos pocos factores que resuman los ocho. Con 30 solicitantes, el ingeniero selecciona las ocho columnas, define Number of factors to extract = 2, Method of extraction = Maximum Likelihood y Type of rotation = Varimax.
Los dos factores explican el 38.68% y el 22.71% de la varianza, el 61.39% en conjunto. El factor 1 carga fuertemente en Employ (0.9644), Residence (0.9523) y Age (0.8595) y moderadamente en Savings (0.5833): un factor de estabilidad y experiencia. El factor 2 carga en Debt (0.8063) y Credit cards (0.5679), frente a Education (−0.6288) y Savings (−0.5673): un factor de endeudamiento. Las comunalidades muestran lo bien que los dos factores describen cada variable: altas para Employ (0.937) y Residence (0.9076), bajas para Income (0.2308) y Credit cards (0.3226).
Para el banco, dos factores describen bien la estabilidad y el endeudamiento de los solicitantes, pero los ingresos son en gran medida independientes. Con 3 factores, la varianza explicada sube al 72.93% (36.67%, 20.63% y 15.63%), y el tercer factor es principalmente Income (−0.8835) con Education (−0.5491); la comunalidad de Income sube a 0.8545. Esto coincide con la agrupación de variables (Cluster Variables) con los mismos datos, que agrupa Income con Education, las variables de estabilidad juntas, y Debt con Credit cards. Sin rotación, las cargas cambian solo un poco en este caso (factor 1: Employ 0.9666, Residence 0.9526), porque la solución sin rotar ya es bastante simple.
Preguntas frecuentes
¿Para qué se usa el análisis factorial?
El análisis factorial explica las correlaciones entre muchas variables medidas con unos pocos factores subyacentes. Las variables que se mueven juntas cargan en el mismo factor, de modo que una larga lista de resultados de pruebas, mediciones de proceso o ítems de cuestionario puede resumirse en un puñado de factores, y se puede ver qué variables son en gran medida independientes.
¿Cuál es la diferencia entre la extracción Principal Components y Maximum Likelihood?
Con la extracción Principal Components, la matriz de correlación se descompone en valores propios y vectores propios, y las cargas de cada factor son un vector propio multiplicado por la raíz cuadrada de su valor propio. La extracción Maximum Likelihood ajusta el modelo de factores comunes con un algoritmo iterativo y supone que las variables siguen aproximadamente una distribución normal multivariada.
¿Qué hace la rotación varimax en el análisis factorial?
La rotación varimax gira los factores para que cada variable cargue alto en un factor y cerca de cero en los demás, lo que facilita nombrar los factores. La rotación no cambia cuánto se explica de cada variable. Tras la rotación, los factores se ordenan según la varianza que explican. La rotación solo se aplica con dos o más factores.
¿Cómo se interpretan la comunalidad y la unicidad en el análisis factorial?
La comunalidad de una variable es la suma de sus cargas al cuadrado, la parte de su varianza explicada por los factores. La unicidad es 1 menos la comunalidad. En el ejemplo de los solicitantes de préstamo, Employ tuvo una comunalidad de 0.937, mientras que Income tuvo solo 0.2308, lo que muestra que los ingresos eran en gran medida independientes con dos factores.