
Ajustar modelo de efectos mixtos
Ajustar modelo de efectos mixtos contrasta factores categóricos fijos y covariables mientras estima los componentes de varianza de factores aleatorios, como lotes, operadores o días. Úselo cuando ignorar los factores aleatorios haría que las pruebas de los factores fijos fueran demasiado optimistas. Cada factor aleatorio necesita al menos 3 niveles. La salida incluye componentes de varianza, pruebas F con grados de libertad de Satterthwaite, coeficientes y un resumen del modelo con AICc y BIC.
Última revisión:
Idea clave
Un modelo de efectos mixtos analiza una respuesta que depende de factores fijos, cuyos niveles se comparan, y de factores aleatorios muestreados de una población, contrastando los fijos y estimando la varianza aleatoria.
En esta página
Finalidad
Ajustar modelo de efectos mixtos analiza una respuesta que depende de dos tipos de factor: los factores fijos, cuyos niveles concretos desea comparar (dos máquinas, tres proveedores, un método nuevo y uno antiguo), y los factores aleatorios, cuyos niveles son una muestra de una población mayor (lotes, muestras, operadores, días). Contrasta los factores fijos y estima cuánta varianza aporta cada factor aleatorio. Úselo cuando ignorar los factores aleatorios haría que las pruebas de los factores fijos fueran demasiado optimistas, por ejemplo cuando los mismos lotes o piezas se miden en todas las condiciones.
Capacidades principales
- Uno o más factores categóricos fijos y covariables continuas, con uno o más factores aleatorios.
- Componentes de varianza de cada factor aleatorio y del error, con % del total, error estándar, prueba Z e intervalo de confianza.
- Pruebas F de los efectos fijos con grados de libertad del denominador de Satterthwaite.
- Coeficientes con grados de libertad de Satterthwaite, pruebas t e intervalos de confianza.
- Resumen del modelo con S, R-sq, R-sq(adj), AICc, BIC y −2 log verosimilitud.
- Estimación por máxima verosimilitud restringida (REML) o por máxima verosimilitud (ML).
- Data Options: seleccione un subconjunto de filas antes del análisis.
Métodos estadísticos
El modelo es y = Xβ + Σ Zᵢuᵢ + ε, donde Xβ contiene los factores fijos (codificación con suma cero −1/0/+1) y las covariables, cada factor aleatorio i añade efectos independientes uᵢ con varianza σᵢ², y los errores ε tienen varianza σ². Los factores aleatorios son componentes de varianza independientes (no se ajustan interacciones). Las varianzas se estiman por REML (por defecto), que tiene en cuenta los grados de libertad usados por los efectos fijos y da componentes de varianza casi insesgados, o por ML, que es necesario para comparar modelos con distintos efectos fijos mediante AICc o BIC. Se descartan las filas con un valor ausente; cada factor aleatorio necesita al menos 3 niveles.
Dadas las estimaciones de varianza, los coeficientes fijos son estimaciones de mínimos cuadrados generalizados. Cada término fijo se contrasta con un estadístico F cuyos grados de libertad del denominador provienen de la aproximación de Satterthwaite, y cada coeficiente con una prueba t sobre grados de libertad de Satterthwaite. Los componentes de varianza tienen errores estándar obtenidos de la información de Fisher, una prueba Z unilateral Z = Var / SE Var de que el componente es cero, y un intervalo de confianza calculado en escala logarítmica, por lo que nunca es negativo. Con pocos niveles de un factor aleatorio, esta prueba Z tiene poca potencia y el intervalo es amplio.
R-sq compara los ajustes condicionales (efectos fijos más efectos aleatorios predichos) con la variación total. S es la raíz cuadrada de la varianza del error. AICc y BIC son menores en los mejores modelos; con REML solo comparan modelos que tienen los mismos efectos fijos.
Campos y opciones de entrada
Campo | Descripción |
Response (Y) | Columna numérica de respuesta. Obligatorio. |
Fixed factors (categorical) | Una o más columnas cuyos niveles concretos son de interés directo. Obligatorio. |
Random factors (categorical) | Una o más columnas cuyos niveles son una muestra aleatoria de una población mayor (p. ej., Field, Batch, Operator), modeladas como componentes de varianza independientes. Obligatorio. |
Covariates (continuous) | Columnas numéricas opcionales, introducidas solo como efectos principales fijos. |
Confidence level | Por defecto 95. |
Estimation method | Restricted maximum likelihood (REML), la opción por defecto, o Maximum likelihood (ML). |
Data Options: Subset (optional) | Exclude matching rows (por defecto) o Include only matching rows, según los números de fila y/o una condición. |
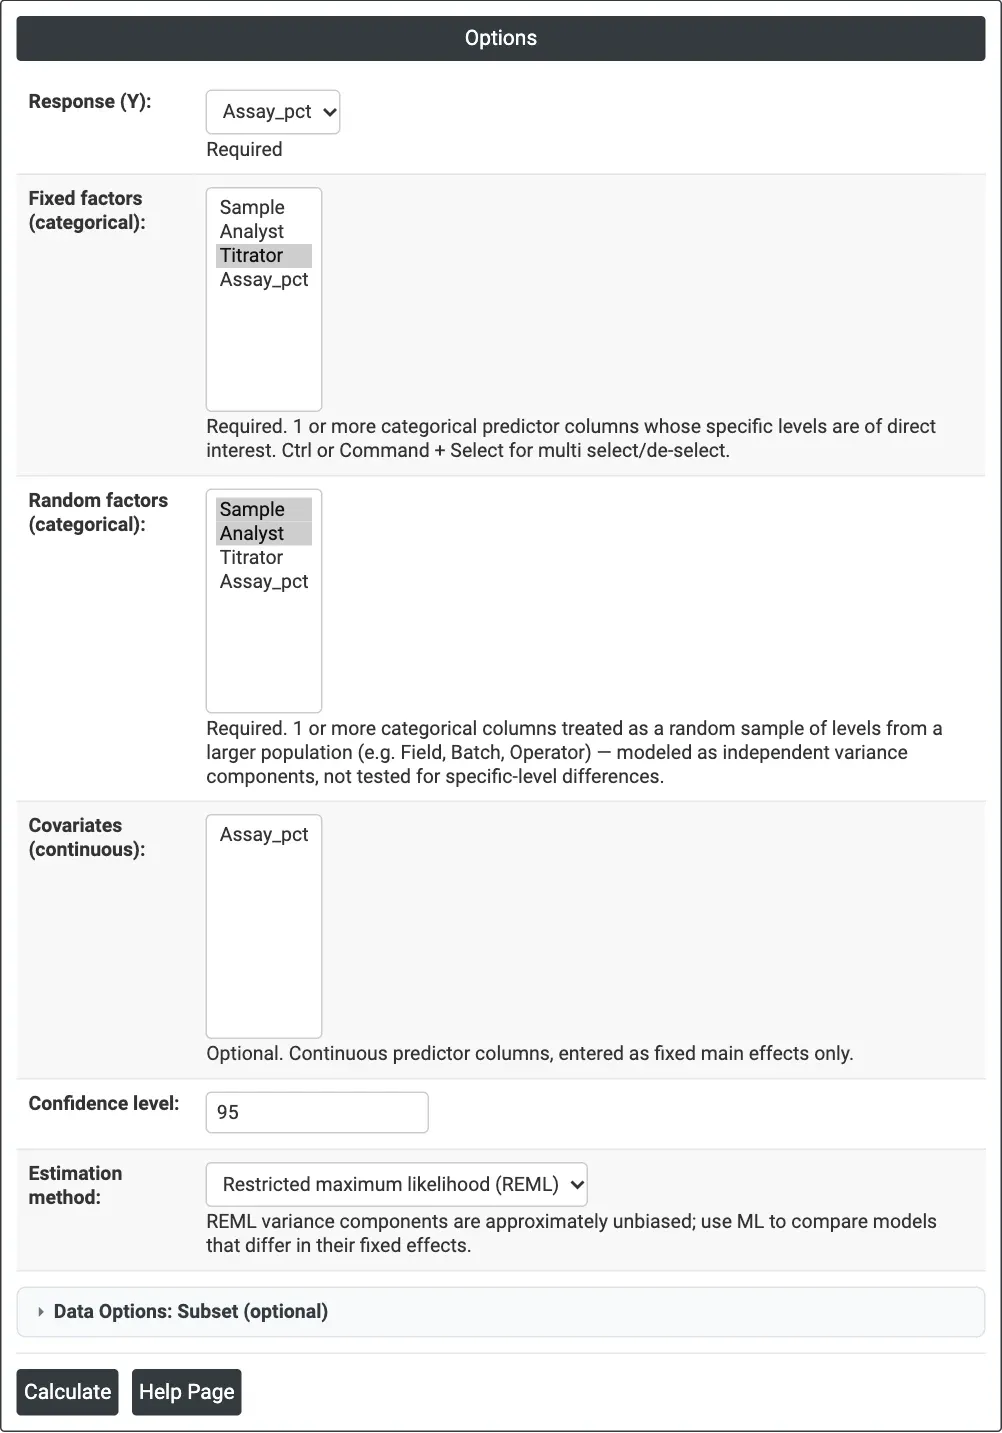
Figura 1 — Opciones del ejemplo de los tituladores: Assay_pct como respuesta, Titrator como factor fijo, Sample y Analyst como factores aleatorios, REML.
Descripción de la salida
- Method — el método de estimación de la varianza y el método de grados de libertad de los efectos fijos.
- Variance Components — Var, % of Total, SE Var, Z-Value, P-Value e intervalo de confianza de cada factor aleatorio, del error y del total.
- Tests of Fixed Effects — DF Num, DF Den, F-Value y P-Value de cada factor fijo y covariable.
- Model Summary — S, R-sq, R-sq(adj), AICc, BIC y −2 log verosimilitud.
- Coefficients — Coef, SE Coef, DF, T-Value, P-Value e intervalo de confianza.
- Se muestra una advertencia si el optimizador no convergió por completo.
- Exportación a PDF mediante Download.
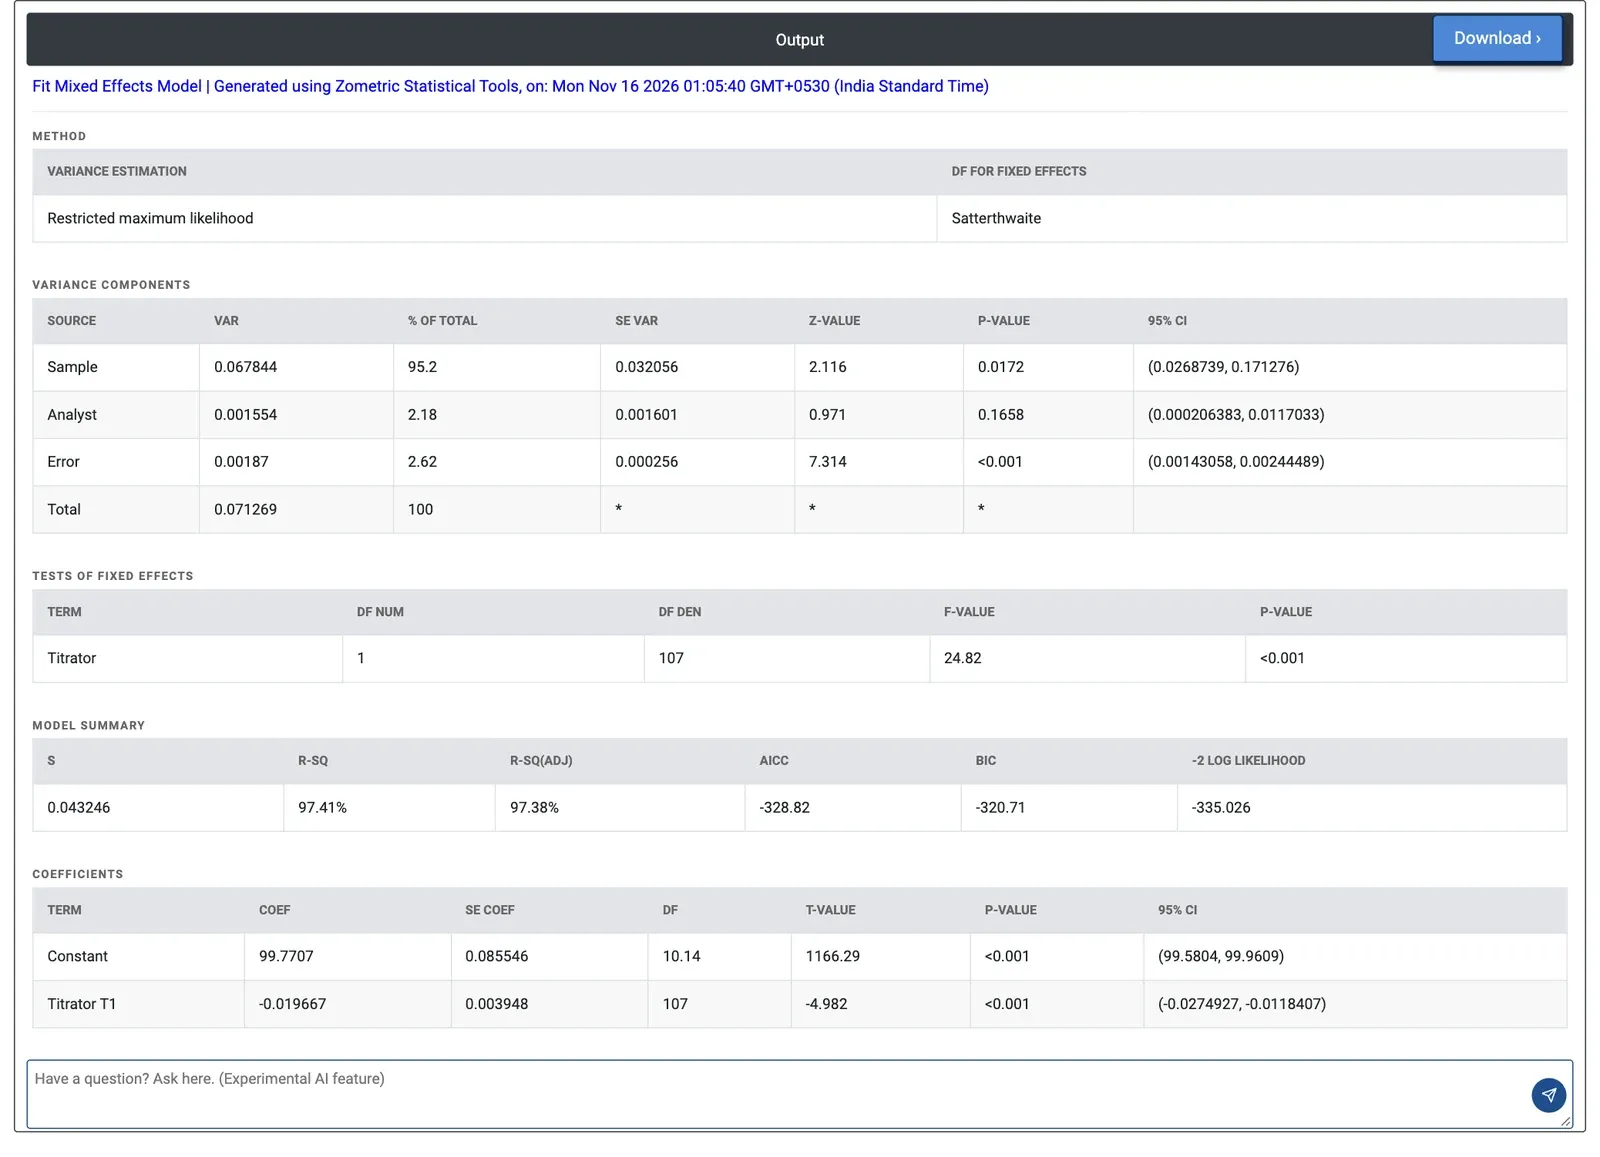
Figura 2 — Modelo mixto de los resultados del ensayo: las muestras explican el 95.2% de la varianza y los dos tituladores difieren (F = 24.82, p < 0.001).
Ejemplo
Un laboratorio de carbonato de sodio mide la pureza del producto (Assay_pct) en dos tituladores automáticos, T1 y T2. Diez muestras se miden dos veces cada una por tres analistas en ambos tituladores: 120 resultados. La pregunta es si los dos tituladores dan el mismo resultado. Los tituladores son los dos instrumentos que posee el laboratorio, por lo que Titrator es un factor fijo; las muestras y los analistas representan muchas posibles muestras y analistas, por lo que son factores aleatorios. El laboratorio introduce Assay_pct como respuesta, Titrator como factor fijo y Sample y Analyst como factores aleatorios, con REML. Load Example rellena estos datos (soda-ash-assay-expanded-grr, el mismo estudio que el ejemplo de Estudio Gage R&R (expandido)) y estos ajustes.
Los componentes de varianza muestran que las propias muestras son las que más difieren: 0.0678 (95.2% del total, desviación estándar de unos 0.26 puntos porcentuales). El componente del analista es pequeño, 0.00155 (2.18%), y no difiere significativamente de cero (p = 0.1658); el error, la repetibilidad de un único resultado, es 0.00187 (desviación estándar 0.043).
Titrator es significativo: F = 24.82 con 1 y 107 grados de libertad, p < 0.001. El coeficiente de T1 es −0.0197 con codificación de suma cero, por lo que T2 da una lectura unos 0.039 puntos porcentuales superior a T1, cercana a una desviación estándar de repetibilidad. Como cada muestra se midió en ambos tituladores, la dispersión entre muestras no oculta esta diferencia. El laboratorio decide comprobar la calibración de ambos tituladores con un patrón de referencia.
Preguntas frecuentes
¿Cuál es la diferencia entre un factor fijo y un factor aleatorio?
Un factor fijo tiene niveles concretos que desea comparar, como dos máquinas, tres proveedores o un método nuevo y uno antiguo. Un factor aleatorio tiene niveles que son una muestra de una población mayor, como lotes, muestras, operadores o días. Un modelo de efectos mixtos contrasta los factores fijos y estima cuánta varianza aporta cada factor aleatorio.
¿Cuándo debe usar un modelo de efectos mixtos?
Use un modelo de efectos mixtos cuando ignorar los factores aleatorios haría que las pruebas de los factores fijos fueran demasiado optimistas, por ejemplo cuando los mismos lotes o piezas se miden en todas las condiciones. En el ejemplo de los tituladores, diez muestras se midieron en ambos tituladores, por lo que la dispersión entre muestras no ocultó la diferencia entre tituladores.
¿Debe usar la estimación REML o ML en un modelo mixto?
REML, la opción por defecto, tiene en cuenta los grados de libertad usados por los efectos fijos y da componentes de varianza casi insesgados. ML es necesario para comparar modelos con distintos efectos fijos mediante AICc o BIC. Con REML, AICc y BIC solo comparan modelos que tienen los mismos efectos fijos.
¿Cómo se interpreta la tabla de componentes de varianza?
Cada factor aleatorio y el error tienen una varianza, su porcentaje del total, un error estándar, una prueba Z unilateral de que el componente es cero y un intervalo de confianza calculado en escala logarítmica, por lo que nunca es negativo. Con pocos niveles de un factor aleatorio, la prueba Z tiene poca potencia y el intervalo es amplio.