
Ajustar modelo de regresión
Fit Regression Model ajusta una ecuación de regresión para una respuesta continua con varios predictores continuos y categóricos. Úselo para predicción, análisis de relaciones y pronóstico; las respuestas categóricas requieren regresión logística. Recopile datos representativos y exactos, compruebe la multicolinealidad con el VIF y valide con gráficas de residuos. Las pruebas usan sumas de cuadrados Adjusted (Type III, por defecto) o Sequential (Type I), con intervalos de confianza al 95% por defecto.
Última revisión:
Idea clave
Fit Regression Model construye una ecuación que cuantifica cómo influyen uno o más predictores continuos o categóricos en una respuesta continua, para identificar variables significativas y predecir resultados.
En esta página
¿Qué es Fit Regression Model?
Fit Regression Model es una herramienta estadística que se utiliza para examinar y cuantificar la relación entre una o más variables predictoras y una variable de respuesta continua. A diferencia de Fit Line Model, que solo maneja un único predictor, Fit Regression Model admite varios predictores, tanto continuos como categóricos, lo que lo hace más versátil para el análisis de datos reales.
Construye una ecuación matemática a través de sus datos que describe de la mejor manera cómo influyen conjuntamente los predictores en la respuesta. Esta ecuación puede utilizarse después para comprender patrones, identificar variables significativas y predecir resultados futuros.
Definición sencilla: Una herramienta que encuentra la mejor relación matemática entre varias variables de entrada y una variable de salida, para que pueda comprender tendencias y hacer predicciones precisas.
¿Cuándo usar Fit Regression Model?
Un modelo de regresión ajustado se usa normalmente cuando es necesario analizar la relación entre una o más variables independientes y una variable dependiente. Es una herramienta útil para predecir y comprender el comportamiento de una variable dependiente a partir de los valores de las variables independientes.
Estos son algunos escenarios habituales en los que un modelo de regresión ajustado puede resultar útil:
- Modelado predictivo: si desea predecir el valor de una variable dependiente a partir de los valores de una o más variables independientes, un modelo de regresión ajustado puede ser útil. Por ejemplo, puede querer predecir las ventas de un producto a partir de factores como el precio, la publicidad y los datos demográficos de los clientes.
- Análisis de relaciones: si desea comprender la relación entre una variable dependiente y una o más variables independientes, un modelo de regresión ajustado puede ayudar. Por ejemplo, puede querer comprender la relación entre los ingresos y el nivel educativo, o entre los hábitos de ejercicio y los resultados de salud.
- Pronóstico: si desea pronosticar valores futuros de una variable dependiente a partir de datos históricos, un modelo de regresión ajustado puede ser útil. Por ejemplo, puede querer pronosticar las ventas futuras a partir de datos históricos de ventas y otras variables como indicadores económicos y tendencias estacionales.
- Los predictores pueden ser continuos, categóricos o una combinación de ambos.
- Las variables discretas pueden tratarse como continuas o categóricas según el número de niveles y el propósito del análisis.
- La variable de respuesta debe ser continua.
- Es poco probable que una respuesta categórica cumpla los supuestos del modelo o produzca predicciones precisas.
En general, un modelo de regresión ajustado puede resultar útil siempre que sea necesario comprender o predecir el comportamiento de una variable dependiente a partir de una o más variables independientes.
Pautas para el uso correcto de Fit Regression Model
- Use una variable de respuesta continua con uno o más predictores continuos o categóricos; si la respuesta es categórica o de conteo, aplique en su lugar el modelo logístico o de Poisson adecuado.
- Asegúrese de que los datos representan con exactitud a la población objetivo; las muestras sesgadas o incompletas conducen a resultados poco fiables.
- Recopile suficientes puntos de datos para obtener la precisión estadística necesaria y asegurar un modelo de regresión estable.
- Mida todas las variables con la mayor exactitud y precisión posibles; los errores de medición afectan directamente a la calidad del modelo ajustado.
- Registre los datos en el orden en que se recopilan para ayudar a detectar tendencias o patrones temporales en los residuos.
- Compruebe la multicolinealidad entre los predictores: si es grave, resulta difícil identificar qué predictores son realmente significativos. Use los factores de inflación de la varianza (VIF) de la tabla Coefficients para evaluar su gravedad.
- Después del ajuste, valide el modelo con gráficas de residuos, estadísticos de diagnóstico y estadísticos de resumen del modelo; un modelo con mal ajuste puede producir conclusiones engañosas.
Alternativas: cuándo no usar Fit Regression Model
- Para visualizar la relación entre un predictor continuo y una respuesta continua, use una gráfica de línea ajustada.
- Para una variable de respuesta con dos categorías, use la regresión logística binaria (Fit Binary Logistic Model).
- Para variables de respuesta con tres o más categorías con un orden natural, como de totalmente en desacuerdo a totalmente de acuerdo, use la regresión logística ordinal.
- Para variables de respuesta con tres o más categorías sin un orden natural, como rayadura, abolladura y desgarro, use la regresión logística nominal.
Ejemplo de Fit Regression Model
Un investigador médico quiere estudiar los efectos de varios factores sobre la frecuencia del pulso. El investigador registra la estatura, el peso, el sexo, la preferencia respecto al tabaco, el nivel de actividad y la frecuencia del pulso en reposo de 91 estudiantes universitarios. A continuación, divide aleatoriamente a los estudiantes en dos grupos. El primer grupo corre en el sitio durante un minuto, mientras que el otro permanece quieto. Después, el investigador vuelve a registrar el pulso de los estudiantes. Los pasos son los siguientes:
- Ya dispone de los datos necesarios.
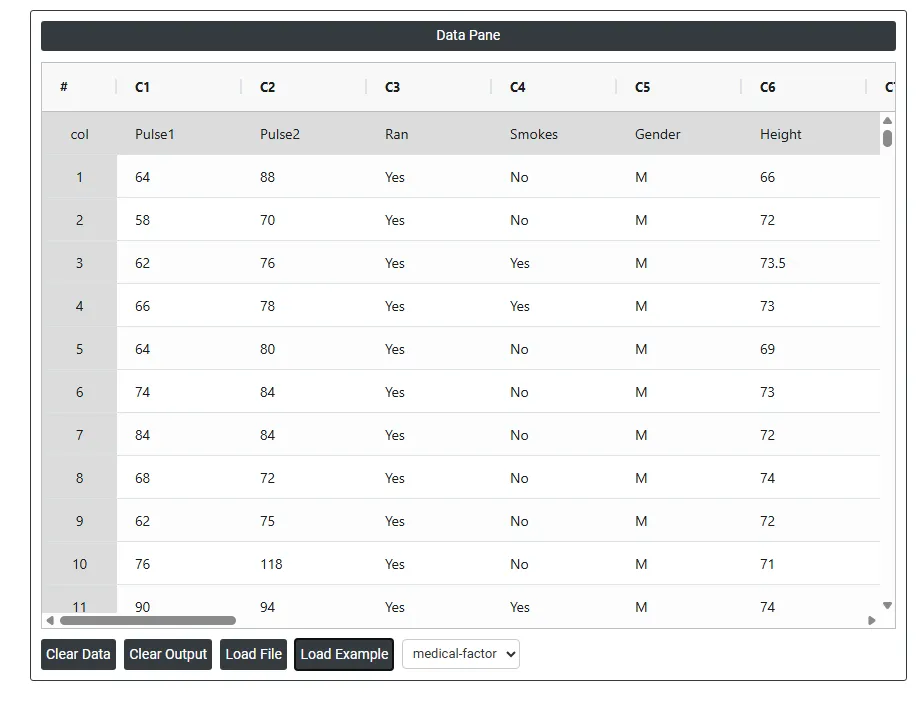
- Ahora analice los datos en Zometric Statistical Software en https://statsai.zometric.com/.
- Para encontrar Fit Regression Model, elija Statistical module> Regression>Fit Regression Model.
- Dentro de la herramienta, introduzca los datos junto con las demás entradas de la siguiente manera:
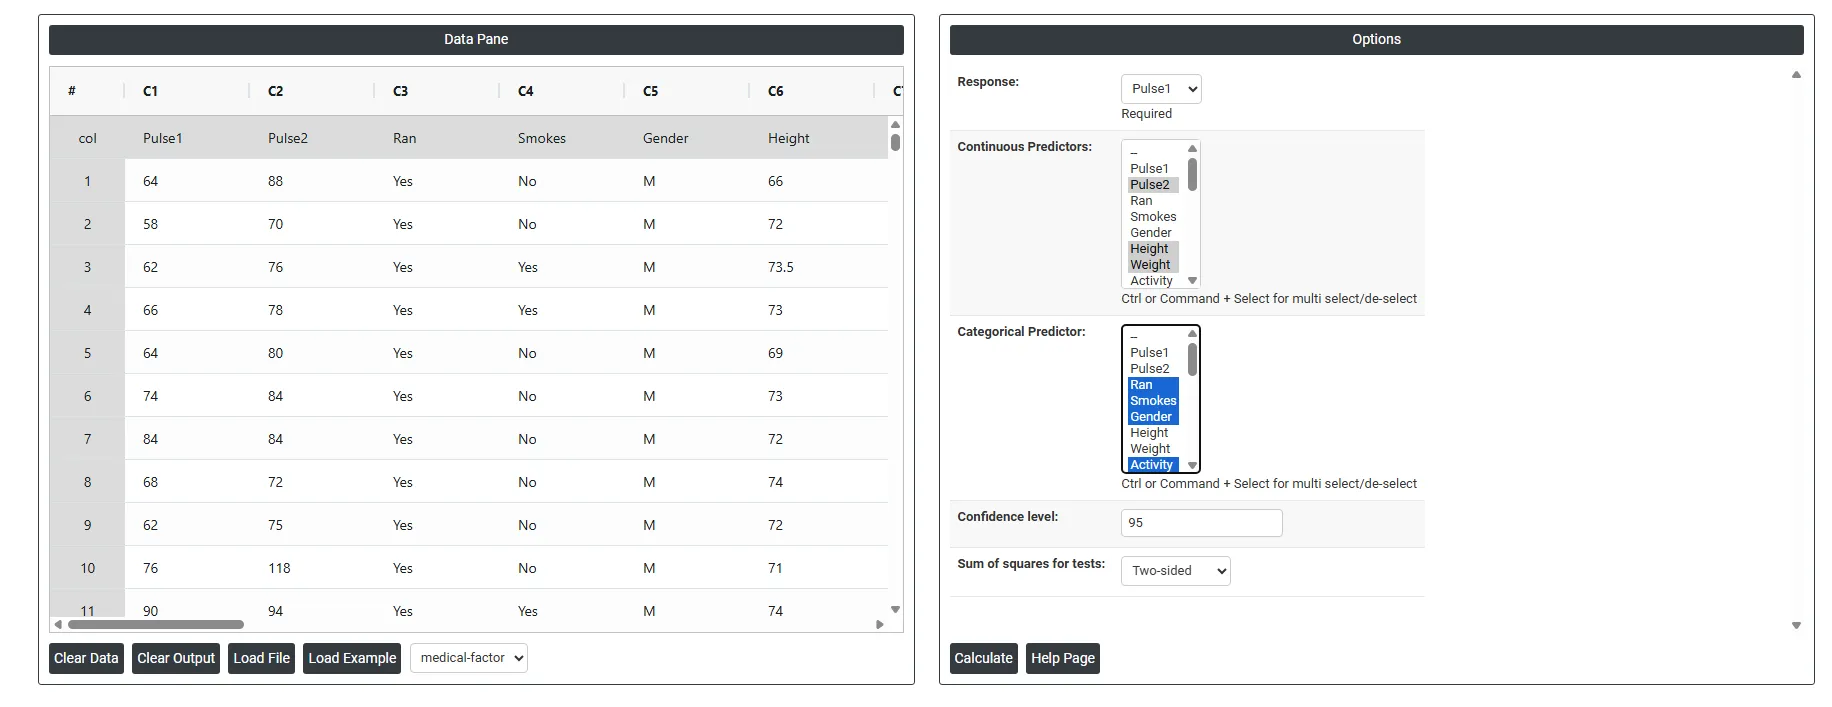
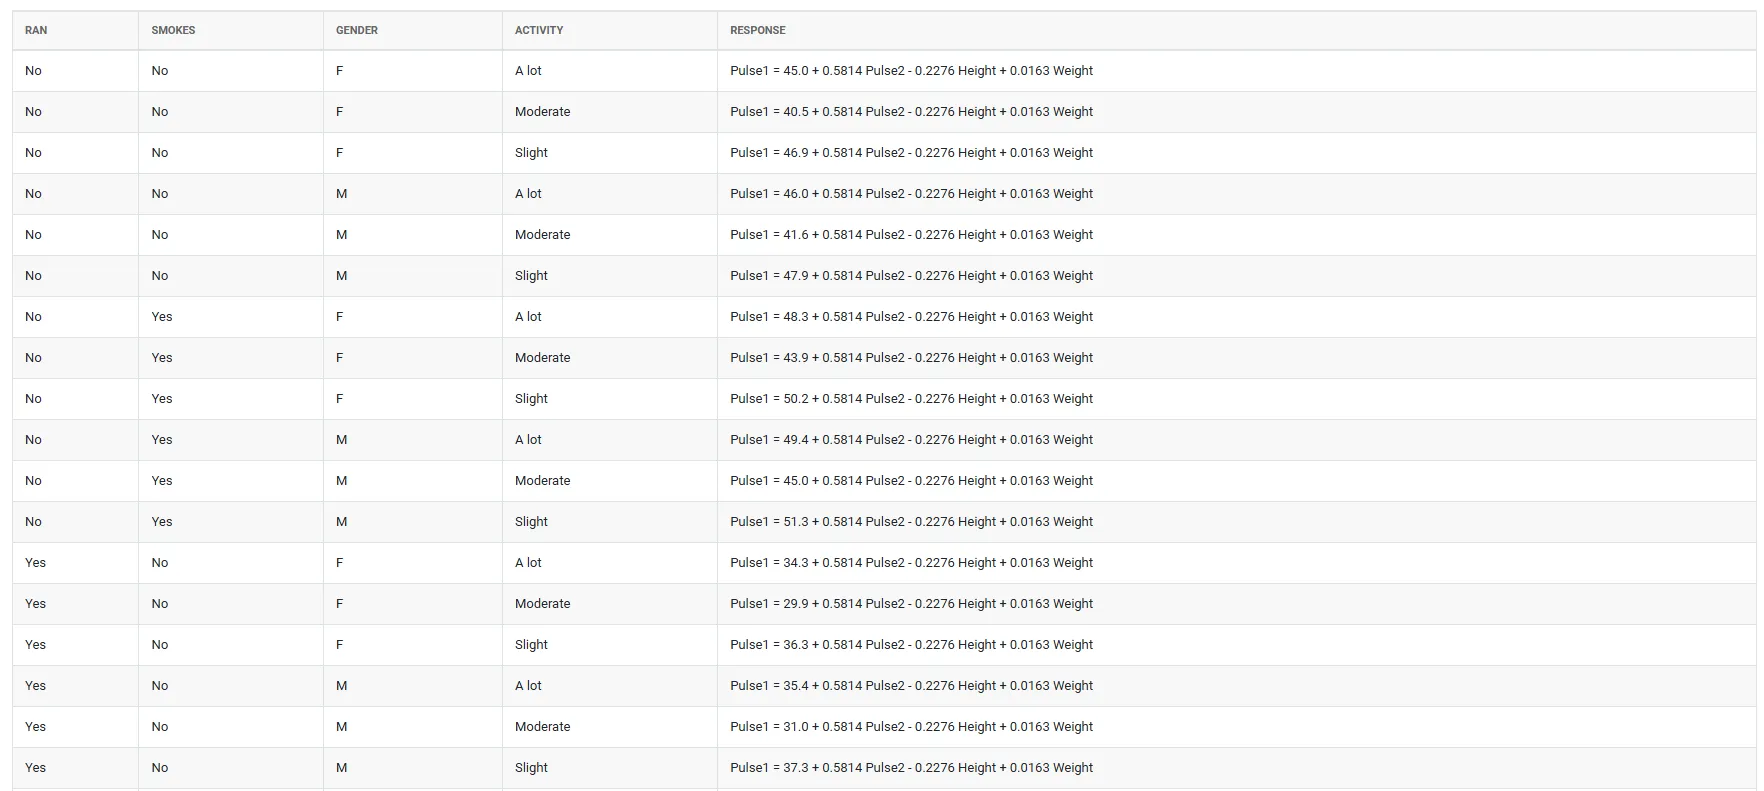
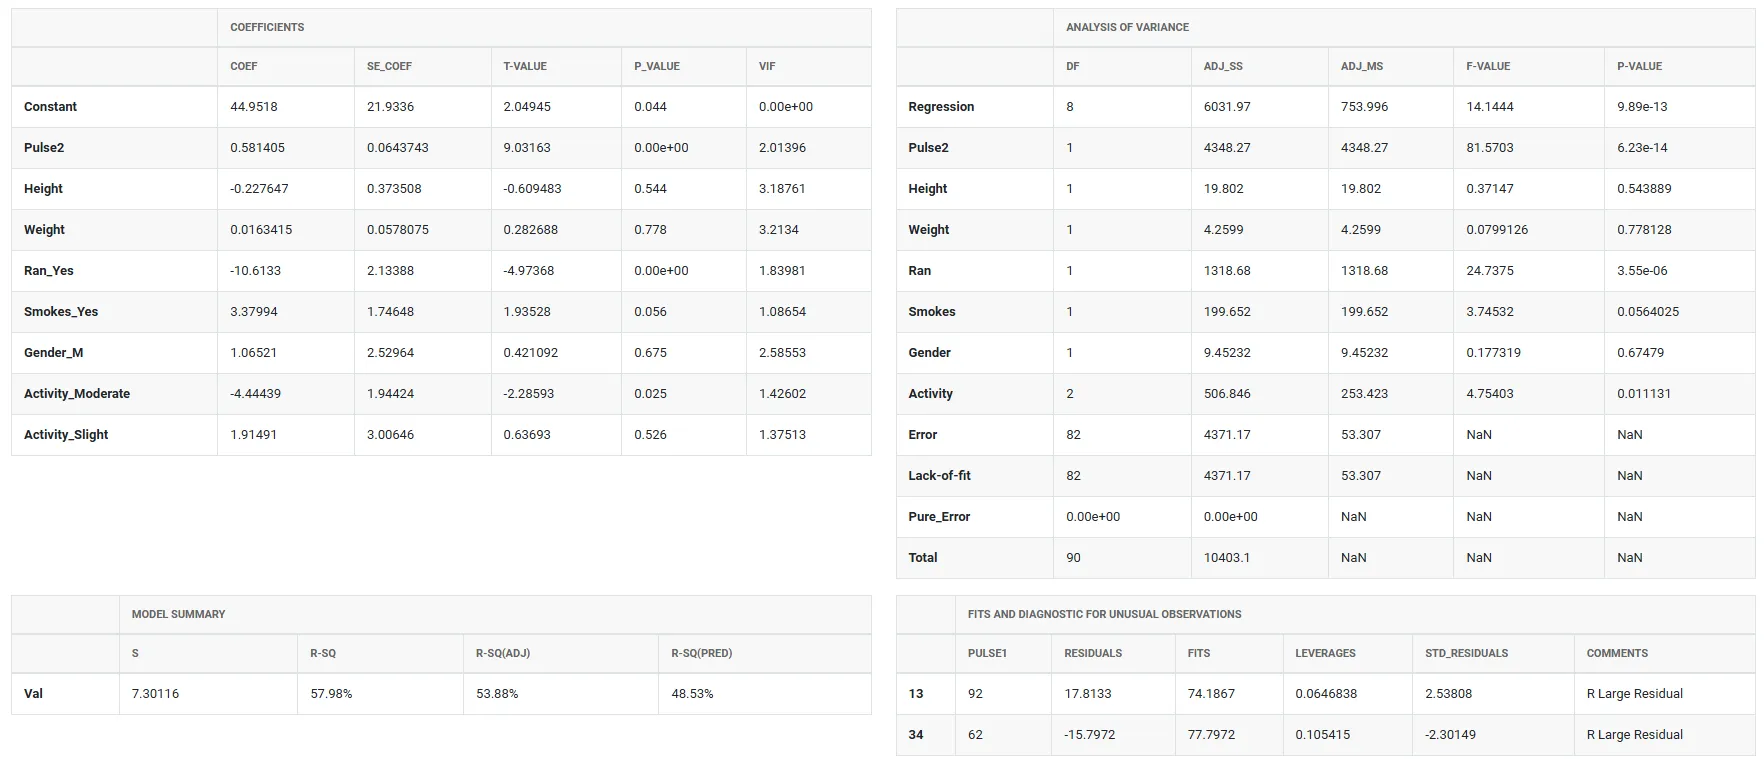
- Tras usar la herramienta mencionada, se obtiene la siguiente salida:
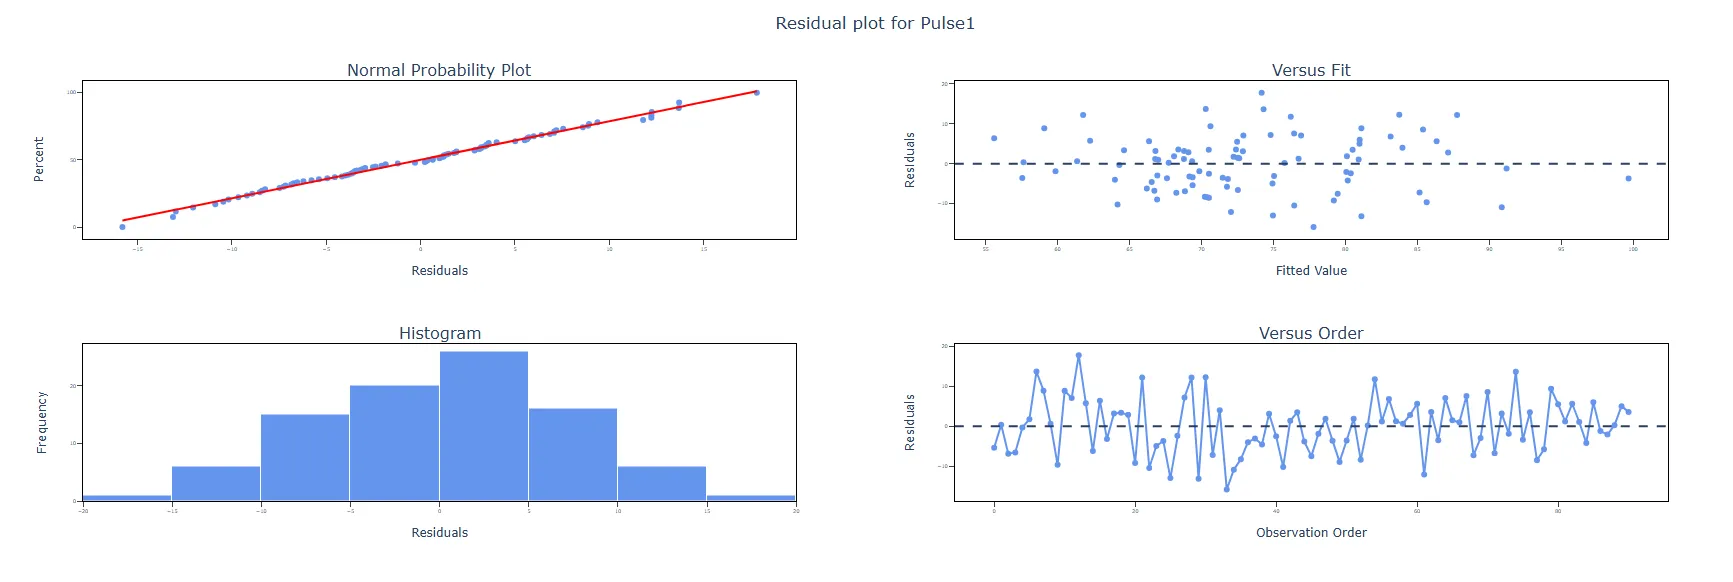
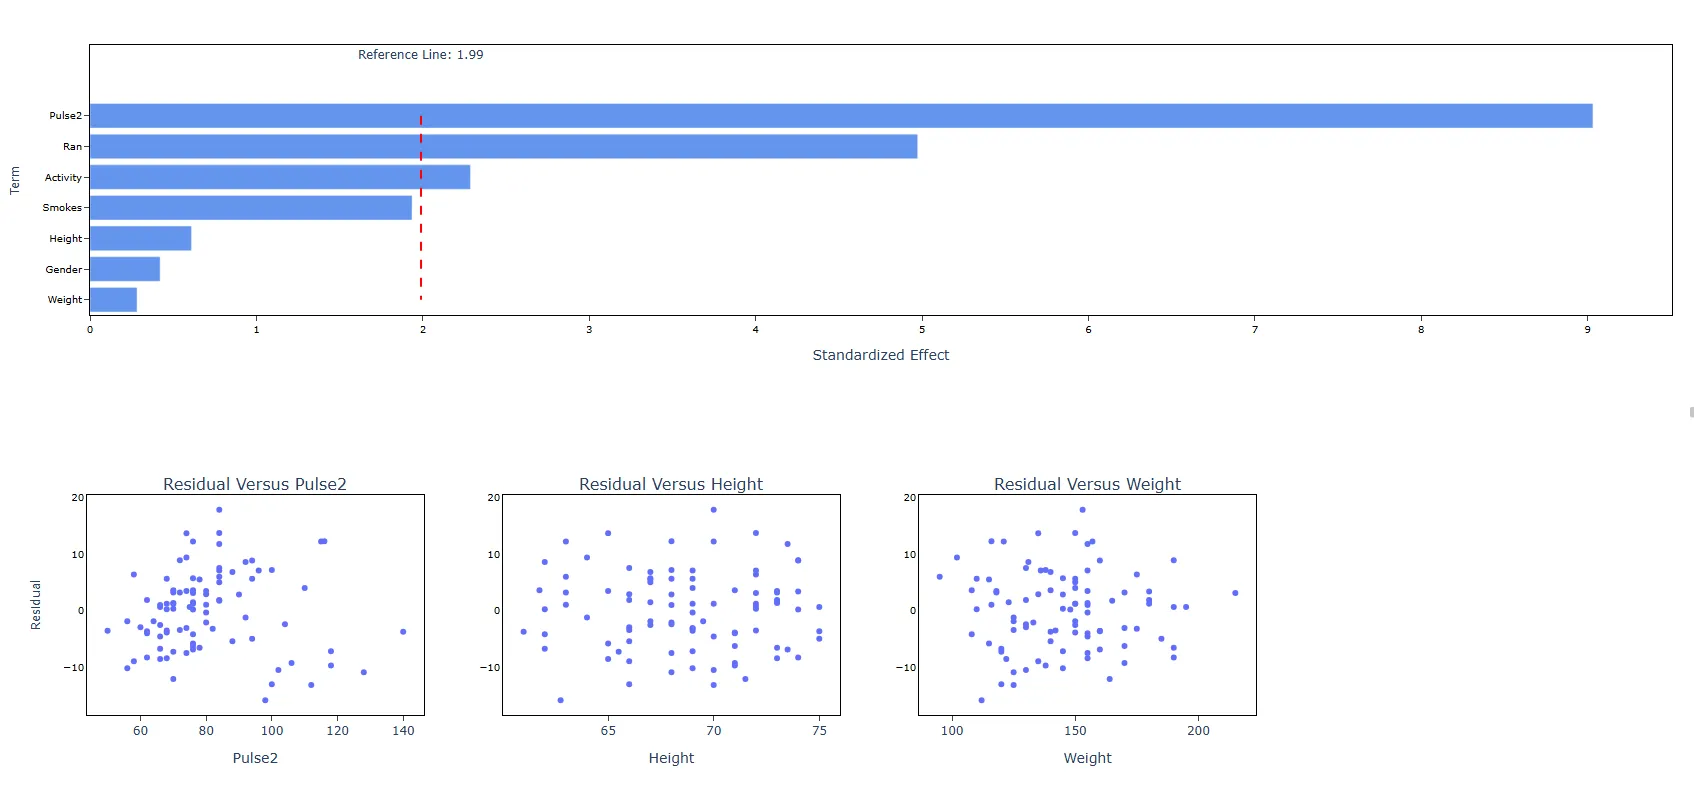
Cómo usar Fit Regression Model
La guía es la siguiente:
- Inicie sesión en Zometric Statistical Software en https://statsai.zometric.com/
- En la página de inicio, elija Statistical Tool> Regression > Fit Regression Model.
- A continuación, introduzca los datos manualmente o copie todos los datos (Ctrl+C) de una hoja de Excel y péguelos (Ctrl+V); también puede usar la opción Load Example, con la que se cargarán los datos de ejemplo.
- A continuación, debe completar las opciones necesarias.
- Por último, haga clic en calculate en la parte inferior de la página para obtener los resultados deseados.
En el tablero de Fit Regression Model, la ventana está dividida en dos partes.
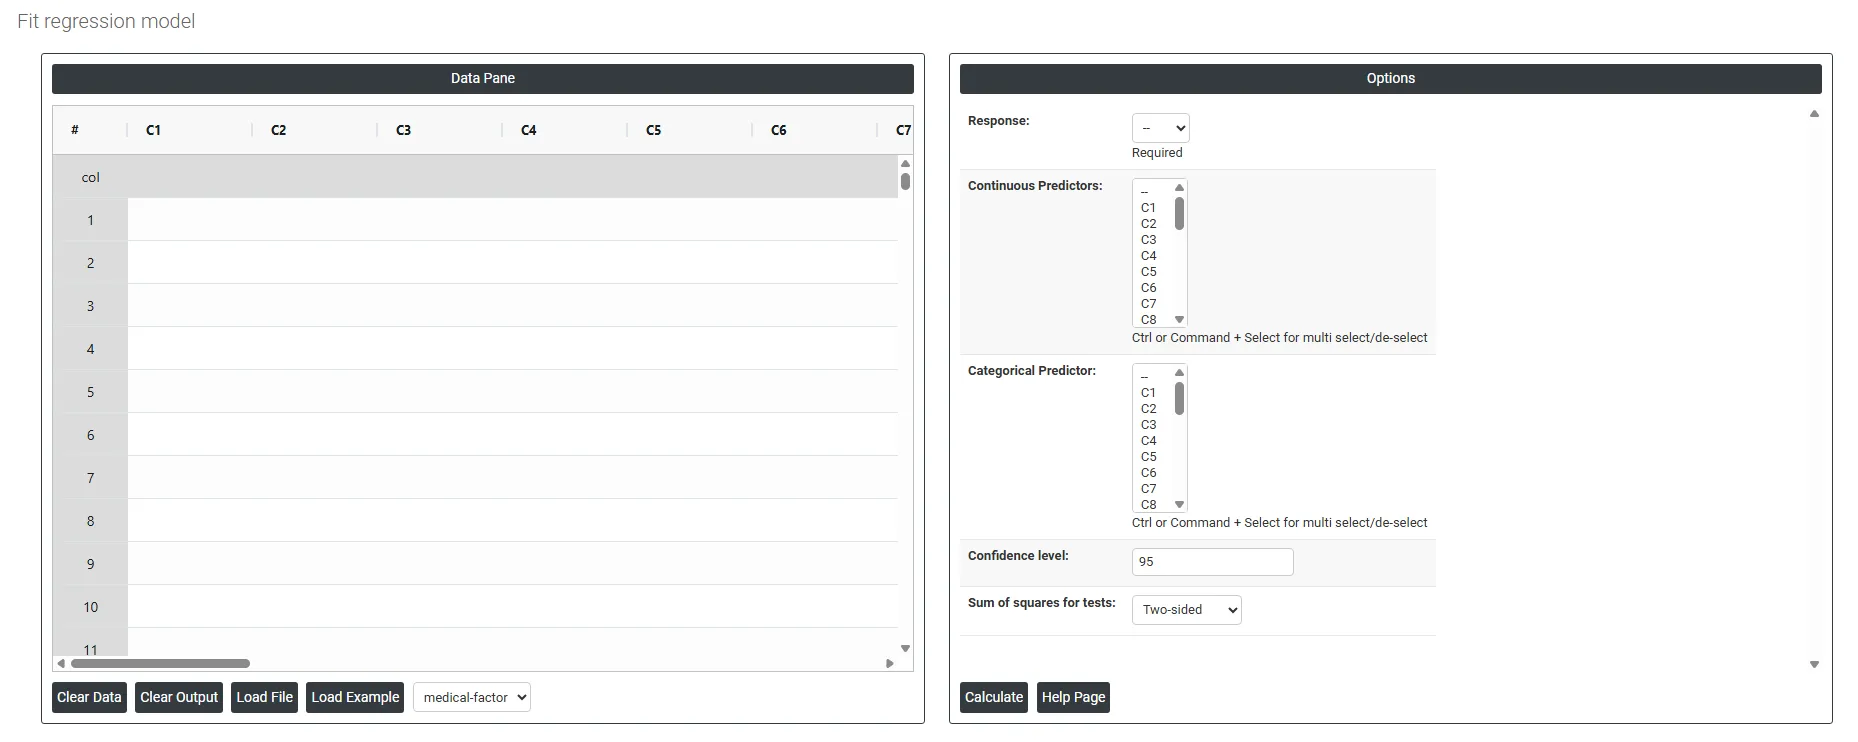
En la parte izquierda se encuentra el panel de datos (Data Pane). En el Data Pane, cada fila forma un subgrupo. Los datos pueden introducirse manualmente o puede copiar todos los datos (Ctrl+C) de una hoja de Excel y pegarlos (Ctrl+V) aquí.
Load example:Se cargarán los datos de ejemplo.
Load File: Se usa para cargar directamente los datos de Excel.
En la parte derecha hay muchas opciones, como las siguientes:
- Response: en un modelo de regresión, la variable de respuesta es la variable que se predice o se explica mediante las variables independientes o predictores. También se conoce como variable dependiente o variable objetivo. La variable de respuesta es la variable que el modelo de regresión intenta estimar o predecir a partir de los valores de las variables independientes.
- Continuous Predictors: en un modelo de regresión, un predictor continuo es una variable que toma valores continuos o numéricos y se utiliza para predecir o explicar la variación de la variable de respuesta. Los predictores continuos pueden tomar cualquier valor dentro de un rango o intervalo determinado y pueden tener decimales o fracciones.
- Categorical Predictors: en el análisis de regresión, los predictores categóricos son variables que toman un número limitado de valores discretos, a menudo denominados categorías o niveles. Estas variables también se conocen como variables cualitativas o nominales, en contraposición a las variables cuantitativas o numéricas.
- Confidence level: en el análisis de regresión, el nivel de confianza es una medida de la precisión y la exactitud de los coeficientes estimados del modelo de regresión. En concreto, el nivel de confianza es la proporción a largo plazo de intervalos de confianza, calculados de la misma manera a partir de muestras repetidas, que contendrían el valor poblacional verdadero de un coeficiente. El nivel de confianza suele expresarse como porcentaje, y un valor habitual es el 95%. Esto significa que, si el mismo modelo de regresión se estimara repetidamente con distintas muestras de datos, aproximadamente el 95% de los intervalos de confianza resultantes contendría el valor verdadero de ese coeficiente.
- Sum of squares for tests:
- Adjusted (Type III): La suma de cuadrados de cada término es la reducción de la suma de cuadrados del error cuando ese término se añade a un modelo que ya contiene todos los demás términos, por lo que su prueba no depende del orden en que se introducen los términos. Es la opción por defecto y suele ser la preferida. Sequential (Type I): La suma de cuadrados de cada término es la reducción de la suma de cuadrados del error cuando el término se añade al modelo en el orden en que se introduce, por lo que la prueba de un término depende de los términos introducidos antes.
Preguntas frecuentes
¿Qué es Fit Regression Model?
Fit Regression Model examina y cuantifica la relación entre una o más variables predictoras y una variable de respuesta continua. Construye una ecuación que describe de la mejor manera cómo influyen conjuntamente los predictores en la respuesta, y que puede utilizarse para comprender patrones, identificar variables significativas y predecir resultados futuros. Los predictores pueden ser continuos, categóricos o una combinación de ambos.
¿Cuál es la diferencia entre Fit Regression Model y Fit Line Model?
Fit Line Model solo maneja un único predictor, mientras que Fit Regression Model admite varios predictores, tanto continuos como categóricos. Para visualizar la relación entre un predictor continuo y una respuesta continua, una gráfica de línea ajustada es la opción más sencilla; para varios predictores, use Fit Regression Model.
¿Cuándo no se debe usar Fit Regression Model?
La respuesta debe ser continua. Para una respuesta con dos categorías, use la regresión logística binaria (Fit Binary Logistic Model). Para tres o más categorías con un orden natural, como de totalmente en desacuerdo a totalmente de acuerdo, use la regresión logística ordinal. Para tres o más categorías sin un orden natural, como rayadura, abolladura y desgarro, use la regresión logística nominal.
¿Cómo se comprueba la multicolinealidad en un modelo de regresión?
Use los factores de inflación de la varianza (VIF) de la tabla Coefficients para evaluar la gravedad de la multicolinealidad entre los predictores. Si es grave, resulta difícil identificar qué predictores son realmente significativos. Después del ajuste, valide también el modelo con gráficas de residuos, estadísticos de diagnóstico y estadísticos de resumen del modelo, ya que un modelo con mal ajuste puede producir conclusiones engañosas.