
ANOVA totalmente anidado
Fully Nested ANOVA estima cuánta variación procede de cada nivel de una jerarquía, con dos a cuatro factores aleatorios anidados y las lecturas repetidas como error. Cada unidad de nivel inferior debe pertenecer a una sola unidad de nivel superior. La salida incluye una tabla ANOVA (F y P solo en diseños balanceados), componentes de varianza con % del total, cuadrados medios esperados, resumen del modelo y medias por celda.
Última revisión:
Idea clave
El ANOVA totalmente anidado descompone la variación de una medición en los niveles de una jerarquía, como lotes, muestras dentro de los lotes y lecturas repetidas, para mostrar de dónde procede la mayor parte de la variación.
En esta página
Finalidad
Fully Nested ANOVA descompone la variación de una medición en los niveles de una jerarquía, como lotes, muestras dentro de cada lote y lecturas repetidas dentro de cada muestra. Úselo cuando cada unidad de nivel inferior pertenezca a una sola unidad de nivel superior (la muestra 1 del lote 1 no es el mismo material que la muestra 1 del lote 2) y quiera saber de dónde procede la mayor parte de la variación, para saber dónde actuar: el proceso, el muestreo o la medición.
Capacidades principales
- De dos a cuatro factores anidados, desde el más externo (p. ej., Batch) hasta el más interno (p. ej., Sample); las lecturas repetidas dentro del factor más interno forman el error.
- Un análisis por respuesta cuando se seleccionan varias respuestas.
- Tabla ANOVA con sumas de cuadrados secuenciales y pruebas F de cada nivel frente al nivel inferior.
- Componentes de varianza con su % del total y desviaciones estándar.
- Cuadrados medios esperados, resumen del modelo y una tabla de medias y desviaciones estándar de cada celda.
- Maneja datos no balanceados para los componentes de varianza; Data Options para filtrar las filas.
Métodos estadísticos
Todos los factores se tratan como aleatorios y cada uno está anidado en el anterior. La suma de cuadrados de cada factor es la dispersión de las medias de sus celdas alrededor de las medias del nivel superior; la suma de cuadrados del error es la dispersión de las lecturas alrededor de las medias de las celdas más internas. Cada factor tiene (número de sus celdas − número de celdas del nivel superior) grados de libertad, y el error tiene N − número de celdas más internas.
Cada factor se contrasta con el siguiente factor interior, y el factor más interno con el error: F = MS(factor) / MS(siguiente término interior). F y P se dan solo para diseños balanceados (el mismo número de lecturas en cada celda y el mismo número de subunidades en cada unidad); para datos no balanceados la página lo indica y los omite.
Los componentes de varianza proceden de los cuadrados medios esperados (método ANOVA): el E(MS) de cada factor es σ²(error) más múltiplos de los componentes de ese factor y de los factores interiores, como se muestra en la tabla Expected Mean Squares, donde (1), (2), … numeran los factores en orden de anidamiento y el último número es el error. Resolver estas ecuaciones del término más interno hacia fuera da cada componente; una estimación negativa se muestra con el 0% del total. % of Total es la parte de cada componente en la varianza sumada, y StDev su raíz cuadrada. Las filas con un valor faltante de respuesta o de factor se descartan.
Campos de entrada y opciones
Campo | Descripción |
Responses | Una o más columnas numéricas. Obligatorio; un análisis por respuesta. |
Factor 1 (outermost) | El nivel superior de la jerarquía, p. ej., Batch. Obligatorio. |
Factor 2 (nested in Factor 1) | Obligatorio, p. ej., Sample dentro de Batch. |
Factor 3 (nested in Factor 2) / Factor 4 (nested in Factor 3) | Niveles más profundos opcionales; Factor 4 requiere Factor 3. |
Data Options: Subset (optional) | Exclude matching rows (por defecto) o Include only matching rows, según los números de fila y/o una condición. |
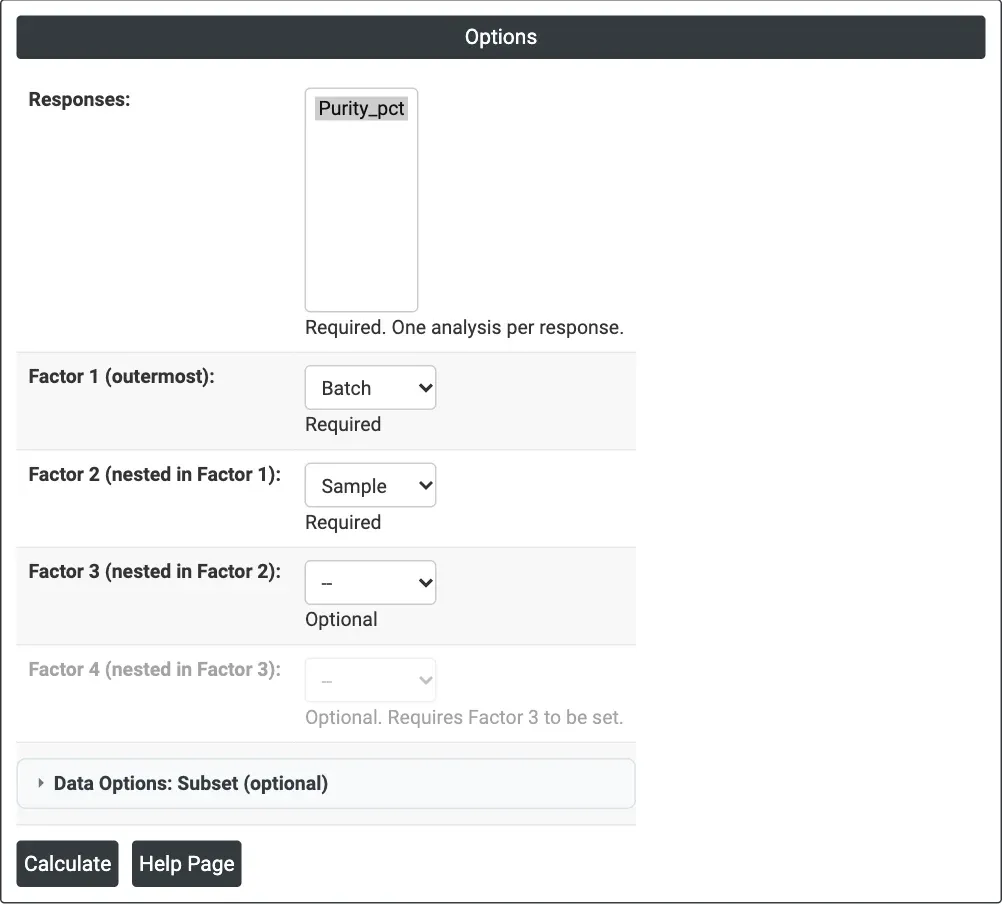
Figura 1: opciones del ejemplo de pureza: Purity_pct como respuesta, Batch como Factor 1 y Sample (anidado en Batch) como Factor 2.
Descripción de la salida
- Analysis of Variance: DF, SS, MS, F y P de cada factor, del error y del total.
- Variance Components: Var Comp, % of Total y StDev de cada factor, del error y del total.
- Expected Mean Squares: la composición de cada cuadrado medio en función de los componentes de varianza.
- Model Summary: S, R-sq y R-sq(adj).
- Means: N, media y desviación estándar de cada celda más interna.
- Exportación a PDF mediante Download.
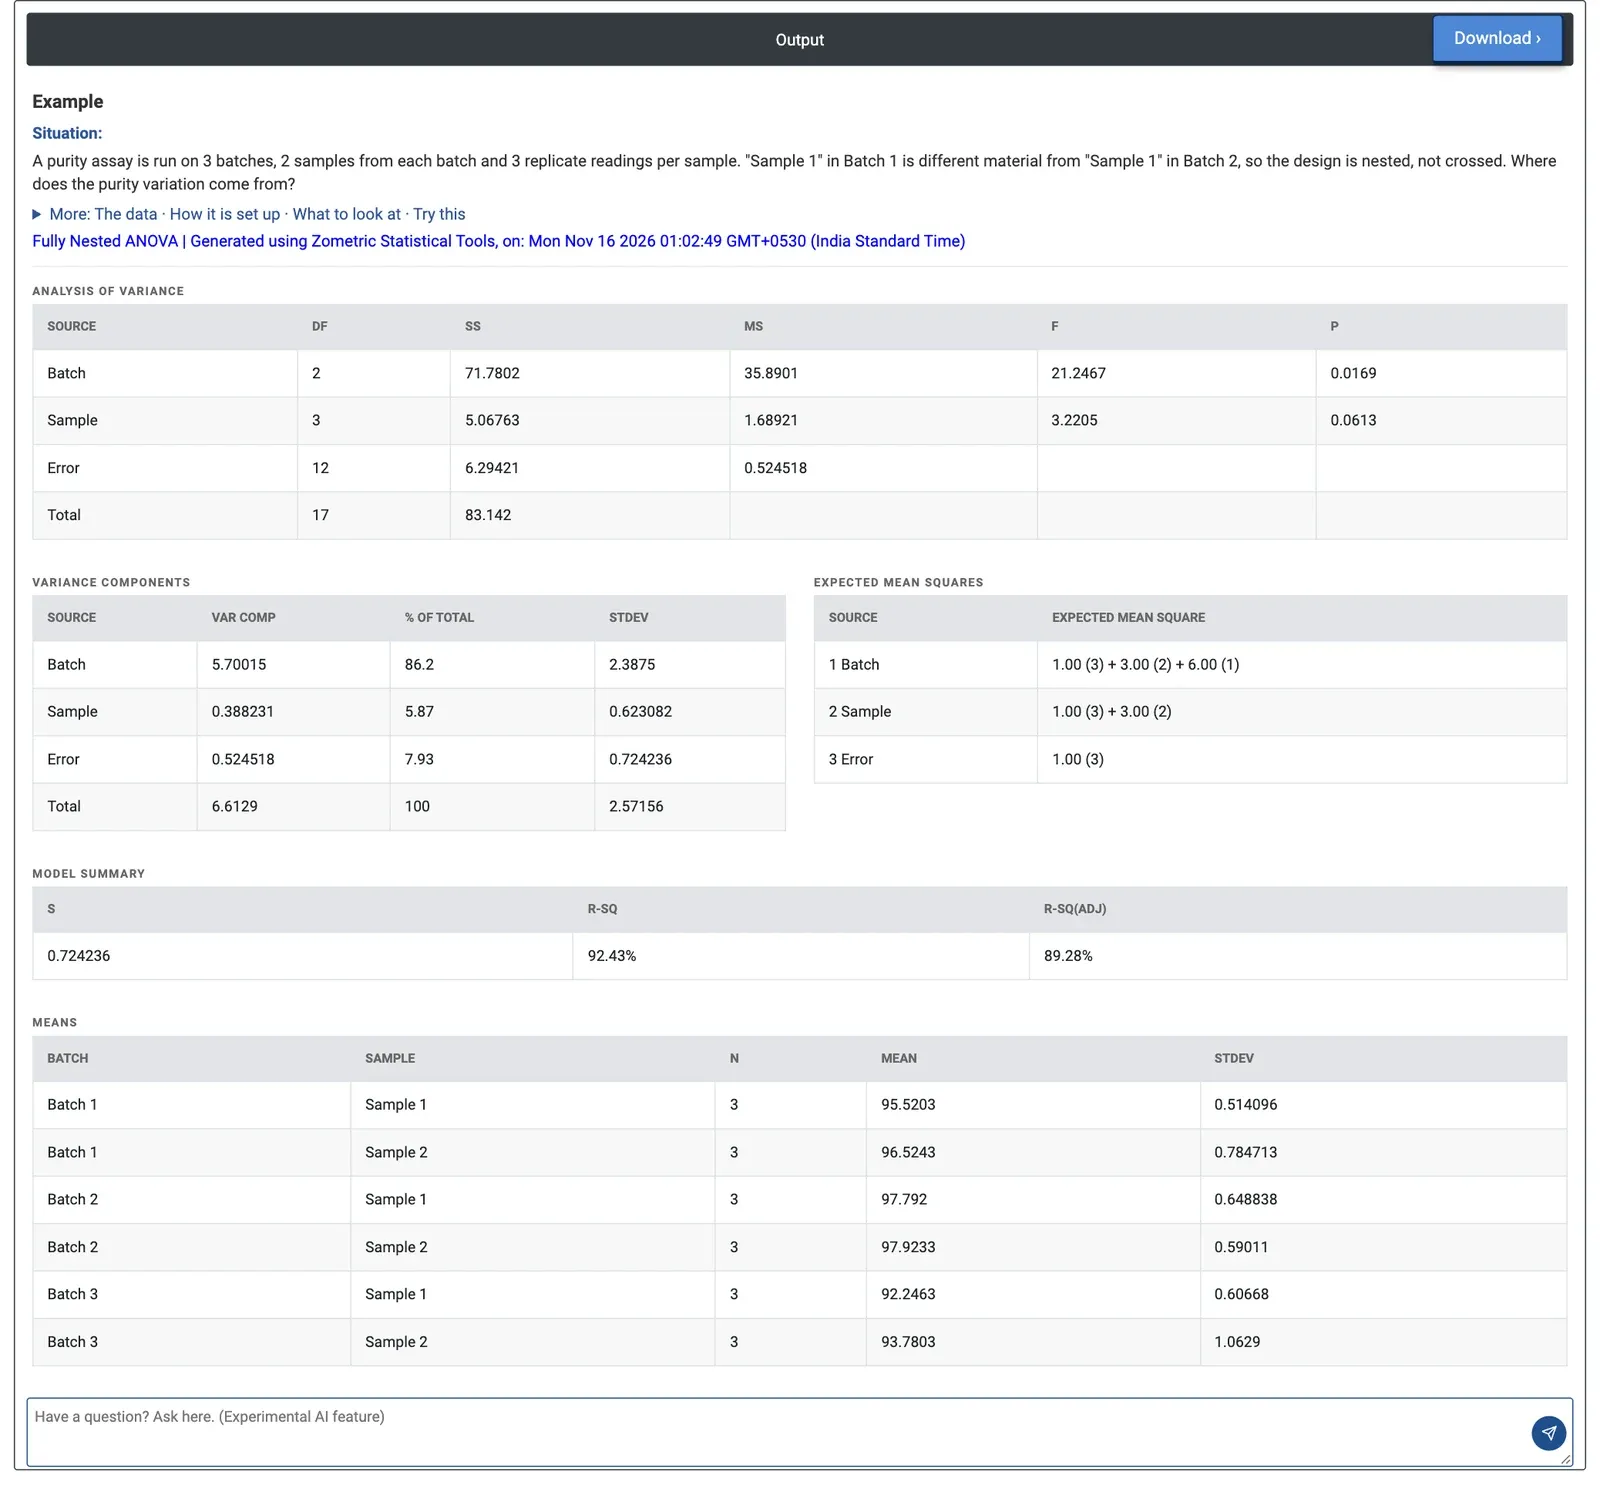
Figura 2: ANOVA anidado de la pureza: la variación entre lotes es el 86.2% del total; las muestras dentro de un lote aportan el 5.87% y las lecturas repetidas el 7.93%.
Ejemplo
Se realiza un ensayo de pureza en 3 lotes, con 2 muestras tomadas de cada lote y 3 lecturas repetidas de cada muestra: 18 resultados. El equipo de calidad quiere saber si la dispersión de la pureza procede del proceso de los lotes, del muestreo o de la medición. Selecciona Purity_pct como respuesta, Batch como Factor 1 y Sample como Factor 2; las lecturas repetidas forman el error.
Los lotes difieren: F = 21.25 con 2 y 3 grados de libertad, p = 0.0169 (Batch se contrasta con Sample dentro de Batch). Las muestras dentro de un lote no difieren de forma significativa al nivel del 5% (F = 3.22, p = 0.0613). El lote 3 es el más bajo (medias de celda 92.25% y 93.78%) y el lote 2 el más alto (97.79% y 97.92%).
Los componentes de varianza aclaran la situación: la varianza entre lotes es 5.70 (86.2% del total, desviación estándar de 2.39 puntos porcentuales), la varianza entre muestras 0.388 (5.87%) y las lecturas repetidas 0.525 (7.93%, desviación estándar 0.72). Un mejor muestreo o un ensayo más preciso cambiarían poco; el equipo debería investigar qué difiere entre los lotes.
Preguntas frecuentes
¿Cuándo se debe usar un ANOVA totalmente anidado?
Úselo cuando cada unidad de nivel inferior pertenezca a una sola unidad de nivel superior, por ejemplo, cuando la muestra 1 del lote 1 no es el mismo material que la muestra 1 del lote 2, y quiera saber de dónde procede la mayor parte de la variación. Eso le indica si debe actuar sobre el proceso, el muestreo o la medición.
¿Cómo se contrastan los factores en un ANOVA totalmente anidado?
Todos los factores se tratan como aleatorios, cada uno anidado en el anterior. Cada factor se contrasta con el siguiente factor interior, y el factor más interno con el error, de modo que F = MS(factor) / MS(siguiente término interior). F y P se dan solo para diseños balanceados; para datos no balanceados se omiten, aunque los componentes de varianza se siguen estimando.
¿Cómo se interpretan los componentes de varianza en un ANOVA anidado?
El % of Total de cada componente es su parte en la varianza sumada, y su StDev es la raíz cuadrada. En el ejemplo de pureza, la varianza entre lotes fue el 86.2% del total, las muestras dentro de un lote el 5.87% y las lecturas repetidas el 7.93%, por lo que un mejor muestreo o un ensayo más preciso cambiarían poco y el equipo debería investigar las diferencias entre lotes.
¿Cuántos factores anidados puede incluir un ANOVA totalmente anidado?
De dos a cuatro factores anidados, desde el más externo, como Batch, hasta el más interno, como Sample. Factor 1 y Factor 2 son obligatorios, mientras que Factor 3 y Factor 4 son opcionales, y Factor 4 requiere Factor 3. Las lecturas repetidas dentro del factor más interno forman el error, y se ejecuta un análisis por cada respuesta seleccionada.