
Modelo lineal general
El modelo lineal general ajusta por mínimos cuadrados factores categóricos fijos, interacciones de dos factores opcionales y covariables continuas, con sumas de cuadrados ajustadas (Tipo III) o secuenciales. Úselo cuando el ANOVA de un factor no baste o los datos estén desbalanceados. Supone errores independientes, normales y de varianza constante. La salida incluye la tabla ANOVA, las medias de mínimos cuadrados, los coeficientes con VIF, comparaciones múltiples y gráficas de residuos.
Última revisión:
Idea clave
Un modelo lineal general (GLM) ejecuta un análisis de varianza con uno o más factores categóricos, sus interacciones de dos factores y covariables continuas en un solo modelo, incluidos datos desbalanceados y el ANOVA de dos factores.
En esta página
Propósito
General Linear Model (GLM) ejecuta un análisis de varianza con uno o más factores categóricos, sus interacciones de dos factores y covariables continuas en un solo modelo. Úselo cuando un ANOVA de un factor no sea suficiente: por ejemplo, cuando el rendimiento pueda depender de la máquina, del operador, de cómo se combinan ambos y también de una condición medida, como la temperatura, o cuando los datos estén desbalanceados. También abarca el ANOVA clásico de dos factores.
Capacidades principales
- Cualquier número de factores categóricos fijos, con todas las interacciones de dos factores si se solicitan.
- Covariables continuas introducidas como efectos principales (análisis de covarianza).
- Sumas de cuadrados ajustadas (Tipo III) o secuenciales (Tipo I); pruebas correctas para datos desbalanceados.
- Medias de mínimos cuadrados para cada factor, ajustadas por los demás términos.
- Comparaciones múltiples de las medias de mínimos cuadrados de un factor mediante Tukey, Fisher, Bonferroni, Sidak o Dunnett (frente a un control), con letras de agrupación y una gráfica de intervalos de las diferencias.
- Coeficientes con VIF, resumen del modelo con R-sq(pred), observaciones inusuales y cuatro gráficas de residuos.
- Data Options: subconjunto de las filas antes del análisis.
Métodos estadísticos
El modelo se ajusta por mínimos cuadrados ordinarios. Los factores usan una codificación de suma cero (−1, 0, +1), de modo que cada coeficiente es la desviación de un nivel respecto de la media general y la prueba de Tipo III de un efecto principal promedia sobre los niveles de los demás factores. Se descartan las filas con un valor faltante en cualquiera de las columnas seleccionadas. Cada término se prueba con F = Adj MS(término) / MS(Error), con sus propios grados de libertad y los del error; con sumas de cuadrados secuenciales, cada término se prueba después de los términos anteriores. La fila Total es la suma de cuadrados total respecto de la media, a la que las sumas de cuadrados ajustadas no tienen por qué sumar cuando los datos están desbalanceados.
S = √MS(Error). R-sq(pred) = 1 − PRESS / SS Total, donde PRESS suma los cuadrados de los errores de predicción dejando una observación fuera. Una media de mínimos cuadrados es la predicción del modelo para un nivel de un factor, con los demás factores promediados sobre sus niveles y las covariables en su media; a diferencia de las medias simples, no se sesga por tamaños de grupo desiguales ni por diferencias en las covariables.
Las comparaciones usan la diferencia entre medias de mínimos cuadrados con su error estándar obtenido de la matriz de covarianza de los coeficientes. Tukey usa la distribución del rango estudentizado para todos los pares; Fisher usa pruebas t individuales; Bonferroni y Sidak ajustan el valor crítico de t según el número de pares; Dunnett compara cada nivel con un control mediante la distribución t multivariante. Un intervalo que no contiene el cero, o medias que no comparten una letra de agrupación, indican una diferencia significativa. Los residuos estandarizados mayores que ±2 se marcan con R y los apalancamientos superiores a 3p/n se marcan con X. El modelo supone errores independientes y con distribución normal y varianza constante: revise las gráficas de residuos.
Campos de entrada y opciones
Campo | Descripción |
Response (Y) | Columna numérica de respuesta. Obligatoria. |
Factors (categorical) | Una o más columnas de predictores categóricos. Obligatorio. |
Covariates (continuous) | Columnas numéricas opcionales, introducidas solo como efectos principales (sin interacciones con los factores). |
Include all 2-way factor interactions | Marcada de forma predeterminada: agrega todas las interacciones de dos factores. |
Confidence level | Valor predeterminado 95; se usa para las comparaciones. |
Comparison procedure | None (default), Tukey, Fisher, Bonferroni, Sidak o Dunnett (vs. a control level). |
Comparison factor | El factor cuyas medias de mínimos cuadrados se comparan; obligatorio si se elige un procedimiento. |
Control group level (Dunnett) | Nivel de control para Dunnett; si se deja en blanco, se usa el primer nivel. |
Grouping information / Interval plot for differences of means | Marcadas de forma predeterminada: tabla de letras de agrupación y gráfica de los intervalos de comparación. |
Sum of squares for tests | Adjusted (Type III, default) o Sequential (Type I). |
Residual versus fit graph / Residual versus order graph / Histogram / Probability plot | Gráficas de residuos; todos marcados de forma predeterminada. |
Data Options: Subset (optional) | Exclude matching rows (default) o Include only matching rows, según números de fila (p. ej., 3,7,12-15) y/o una condición (p. ej., Temperature_C > 185). |
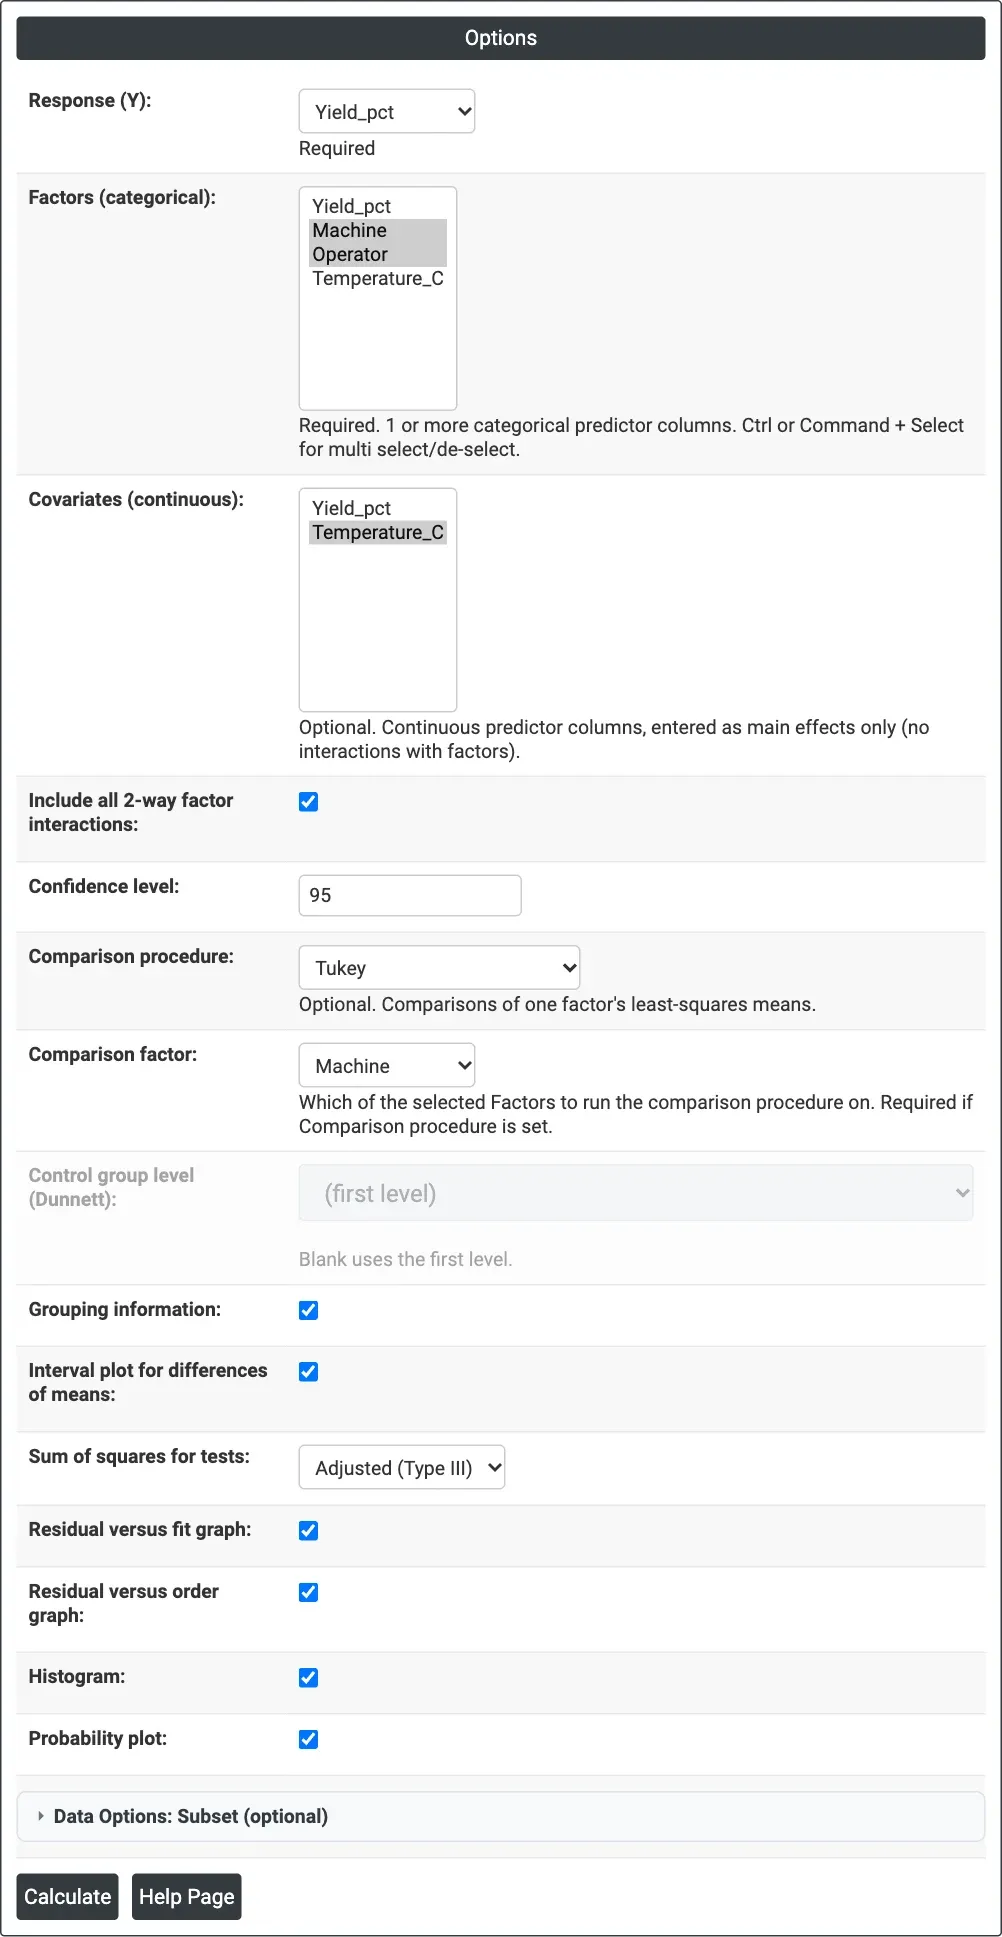
Figura 1: opciones del ejemplo de rendimiento: Yield_pct con los factores Machine y Operator, su interacción, la covariable Temperature_C y comparaciones de Tukey de las máquinas.
Descripción de la salida
- Method: codificación de los factores y tipo de sumas de cuadrados.
- Factor Information: tipo, número de niveles y valores de los niveles de cada factor.
- Analysis of Variance: DF, Adj SS (o Seq SS), Adj MS, F-Value y P-Value para cada término, el error y el total.
- Model Summary: S, R-sq, R-sq(adj) y R-sq(pred).
- Least-Squares Means: N y media de mínimos cuadrados (LS mean) de cada nivel de cada factor.
- Coefficients: Coef, SE Coef, T-Value, P-Value y VIF.
- Fits and Diagnostics for Unusual Observations: se muestra solo cuando hay alguna.
- Grouping Information, Simultaneous (o Individual) Tests for Differences of Means y la gráfica de intervalos: cuando se elige un procedimiento de comparación.
- Versus Fit, Versus Order, Residuals Histogram y Probability Plot.
- Exportación a PDF mediante Download.
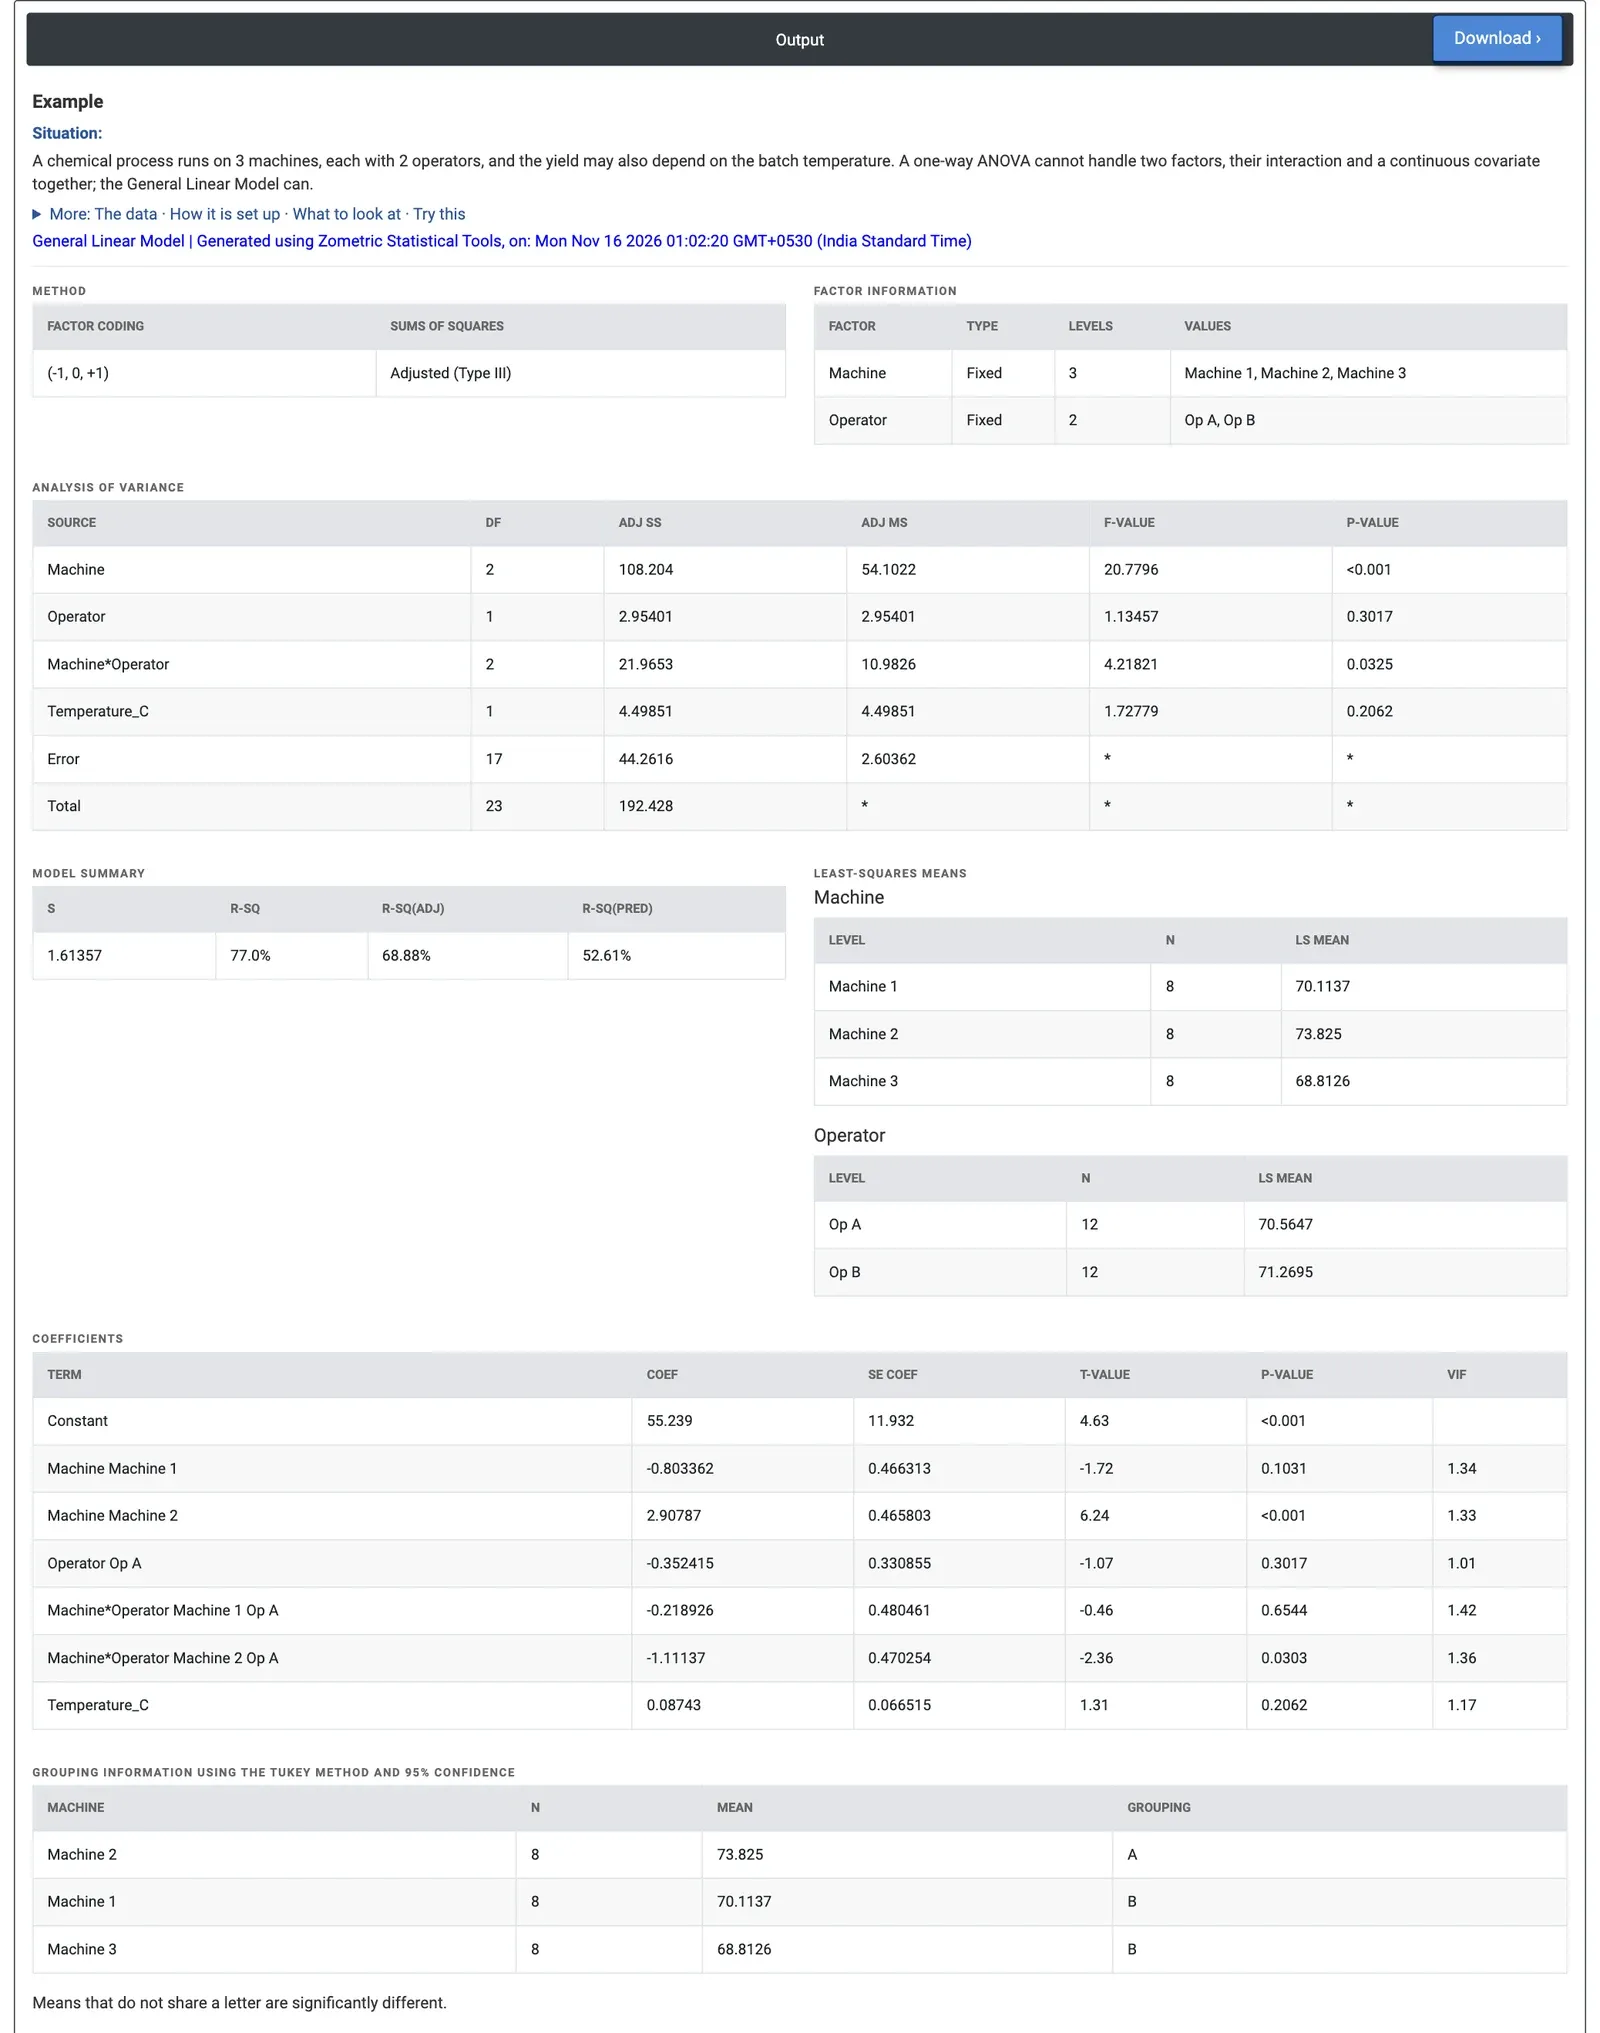
Figura 2: resultados del GLM para el rendimiento: Machine es significativo (p < 0.001), igual que la interacción Machine*Operator (p = 0.0325); Machine 2 tiene la media de mínimos cuadrados más alta, 73.83%.
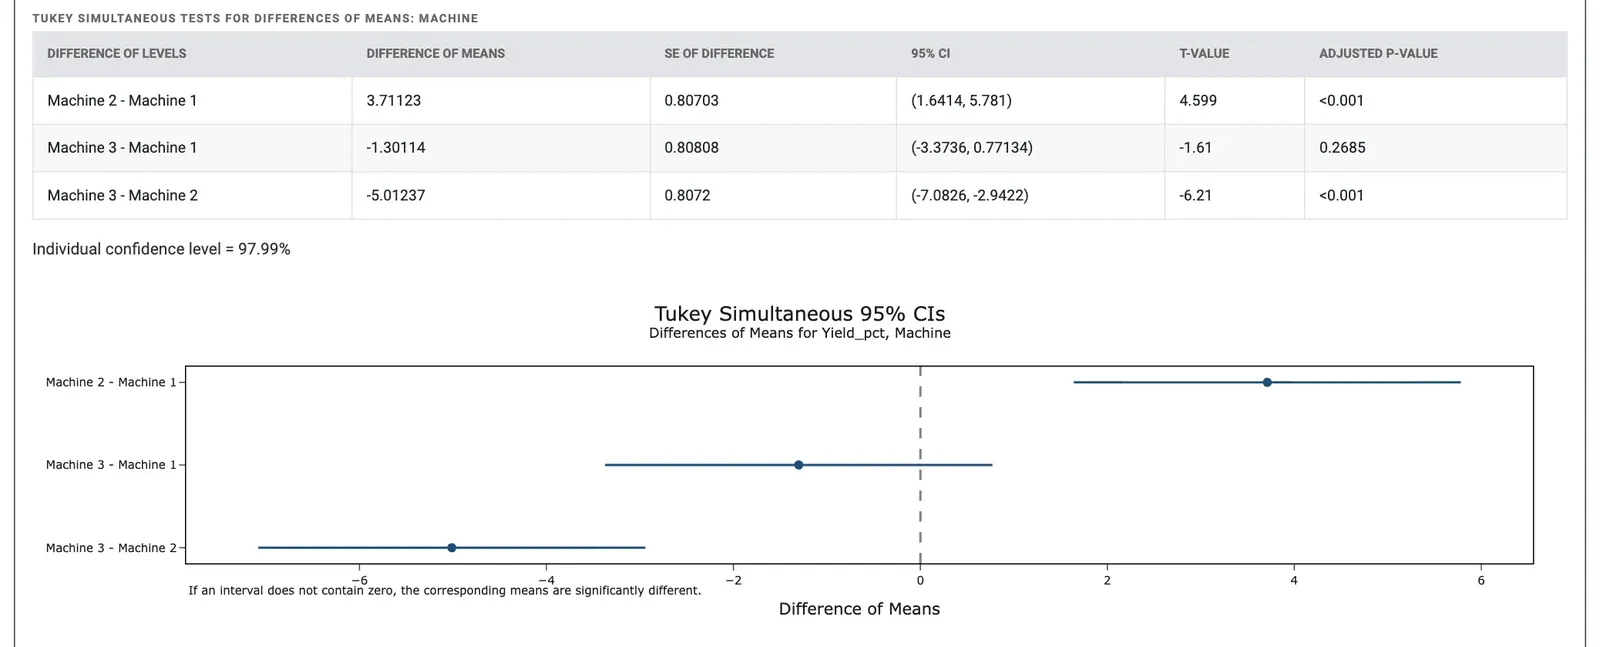
Figura 3: comparaciones de Tukey de las máquinas: Machine 2 difiere de las otras dos; el intervalo de Machine 3 − Machine 1 contiene el cero.
Ejemplo
Un proceso químico funciona en tres máquinas, cada una con dos operadores (Op A y Op B), y el rendimiento del lote también puede depender de la temperatura del lote (170 a 190 °C). Hay 24 lotes, cuatro por cada máquina y operador. El ingeniero selecciona Yield_pct como respuesta, Machine y Operator como factores con su interacción, Temperature_C como covariable y solicita comparaciones de Tukey de las máquinas.
Las máquinas difieren claramente (F = 20.78, p < 0.001). La interacción Machine*Operator también es significativa (F = 4.22, p = 0.0325): Op B obtiene más de las máquinas 1 y 2, pero menos de la máquina 3. El operador por sí solo (p = 0.3017) y la temperatura (p = 0.2062) no tienen un efecto significativo en el rango estudiado. El modelo explica el 77.0% de la variación (R-sq(adj) 68.88%), con S = 1.61 puntos porcentuales; R-sq(pred) es menor, 52.61%, por lo que las predicciones para lotes nuevos serán menos precisas de lo que sugiere el ajuste.
Las medias de mínimos cuadrados son 73.83% para la máquina 2, 70.11% para la máquina 1 y 68.81% para la máquina 3. Tukey coloca a la máquina 2 sola en el grupo A: rinde 3.71 puntos más que la máquina 1 (IC del 95%: 1.64 a 5.78) y 5.01 más que la máquina 3, ambos con p ajustado < 0.001, mientras que las máquinas 1 y 3 no difieren (p ajustado = 0.2685). El ingeniero estudia qué es distinto en la máquina 2 y, debido a la interacción, examina la combinación de operadores en la máquina 3 antes de estandarizar el método.
Preguntas frecuentes
¿Cuándo debe usarse un modelo lineal general en lugar de un ANOVA de un factor?
Use un modelo lineal general cuando un ANOVA de un factor no sea suficiente, por ejemplo, cuando el rendimiento pueda depender de la máquina, del operador, de cómo se combinan ambos y de una condición medida, como la temperatura, o cuando los datos estén desbalanceados. Maneja varios factores categóricos, interacciones de dos factores y covariables continuas en un solo modelo, y también abarca el ANOVA clásico de dos factores.
¿Qué son las medias de mínimos cuadrados en un GLM?
Una media de mínimos cuadrados es la predicción del modelo para un nivel de un factor, con los demás factores promediados sobre sus niveles y las covariables mantenidas en su media. A diferencia de las medias simples, no se sesga por tamaños de grupo desiguales ni por diferencias en las covariables. Las comparaciones múltiples del GLM comparan estas medias de mínimos cuadrados entre los niveles de un factor.
¿Qué método de comparación múltiple debe usarse en un GLM?
Tukey compara todos los pares con la distribución del rango estudentizado; Fisher usa pruebas t individuales; Bonferroni y Sidak ajustan el valor crítico de t según el número de pares; Dunnett compara cada nivel con un control. Un intervalo que no contiene el cero, o medias que no comparten una letra de agrupación, indican una diferencia significativa.
¿Cuáles son los supuestos de un modelo lineal general?
El modelo supone errores independientes y con distribución normal y varianza constante, que se comprueban con las gráficas de residuos: residuos frente a valores ajustados, frente al orden, histograma y gráfica de probabilidad. Los residuos estandarizados mayores que más o menos 2 se marcan con R, y las observaciones con apalancamiento superior a 3p/n se marcan con X como inusuales.