
Identificación de distribución individual
La identificación de distribución individual ajusta simultáneamente varias distribuciones de probabilidad a sus datos y evalúa cuál ofrece el mejor ajuste estadístico. En lugar de suponer normalidad, esta herramienta contrasta una amplia gama de distribuciones (entre ellas Weibull, lognormal, exponencial, logística, gamma y otras) y las ordena según lo bien que describen la forma y el comportamiento de sus datos.
Última revisión:
Idea clave
La identificación de distribución individual ajusta simultáneamente varias distribuciones de probabilidad a sus datos y evalúa cuál ofrece el mejor ajuste estadístico.
En esta página
- ¿Qué es la identificación de distribución individual?
- ¿Cuándo usar la identificación de distribución individual?
- Pautas para el uso correcto de la identificación de distribución individual
- Alternativas: cuándo no usar la identificación de distribución individual
- Ejemplo de identificación de distribución individual
- Cómo usar Individual Distribution Identification
¿Qué es la identificación de distribución individual?
La identificación de distribución individual ajusta simultáneamente varias distribuciones de probabilidad a sus datos y evalúa cuál ofrece el mejor ajuste estadístico. En lugar de suponer normalidad, esta herramienta contrasta una amplia gama de distribuciones (entre ellas Weibull, lognormal, exponencial, logística, gamma y otras) y las ordena según lo bien que describen la forma y el comportamiento de sus datos.
Esto es esencial para el análisis de capacidad con datos no normales, en el que usar una distribución incorrecta produce estimaciones inexactas de Pp, Ppk, o Cp, Cpk y predicciones engañosas de la tasa de defectos.
Definición sencilla: Una herramienta que contrasta sus datos con muchas distribuciones estadísticas distintas y le indica cuál ajusta mejor, para que pueda realizar un análisis de capacidad preciso incluso cuando los datos no siguen una distribución normal.
¿Cuándo usar la identificación de distribución individual?
- Úsela cuando sus datos no superan una prueba de normalidad y necesite identificar la distribución correcta antes de realizar el análisis de capacidad.
- Úsela cuando trabaje con datos de proceso inherentemente asimétricos , como tiempos de ciclo, tiempos hasta el fallo, concentraciones químicas o tamaños de partícula.
- Úsela antes de aplicar el análisis de capacidad no normal para asegurarse de que la distribución seleccionada representa con exactitud el comportamiento del proceso.
- Úsela cuando la transformación de Box-Cox no sea adecuada , por ejemplo, cuando los datos contienen ceros o valores negativos.
Pautas para el uso correcto de la identificación de distribución individual
- Recopile al menos 50 a 100 puntos de datos para que el ajuste de distribuciones sea fiable: las muestras pequeñas no aportan información suficiente para distinguir entre distribuciones.
- Use estadísticos de bondad de ajuste (Anderson-Darling) y gráficas de probabilidad conjuntamente al seleccionar la mejor distribución; no se base únicamente en el valor p.
- Seleccione una distribución que tenga sentido físico para el proceso : una distribución con el estadístico AD más bajo pero sin fundamento físico puede no ser la mejor opción.
- Asegúrese de que los datos proceden de un proceso estable y bajo control antes de ajustar distribuciones: el ajuste de distribuciones a datos de un proceso inestable produce resultados sin sentido.
- Considere usar la transformación de Johnson o de Box-Cox como alternativa cuando ninguna distribución estándar ajuste bien.
Alternativas: cuándo no usar la identificación de distribución individual
- Si los datos ya se han confirmado como normales, proceda directamente con el análisis de capacidad normal estándar: la identificación de distribución es innecesaria.
- Si solo necesita comprobar la normalidad sin explorar otras distribuciones, use una sencilla prueba de normalidad
- Si los datos tienen límites físicos claros o un tipo de distribución conocido, especifique esa distribución directamente en el análisis de capacidad en lugar de probar todas las opciones.
Ejemplo de identificación de distribución individual
Un ingeniero recopila una muestra aleatoria de cápsulas y registra su contenido de calcio. Para determinar la distribución de datos que mejor se ajusta, realiza una identificación de distribución individual. La prueba sigue estos pasos:
- Ya dispone de los datos necesarios.
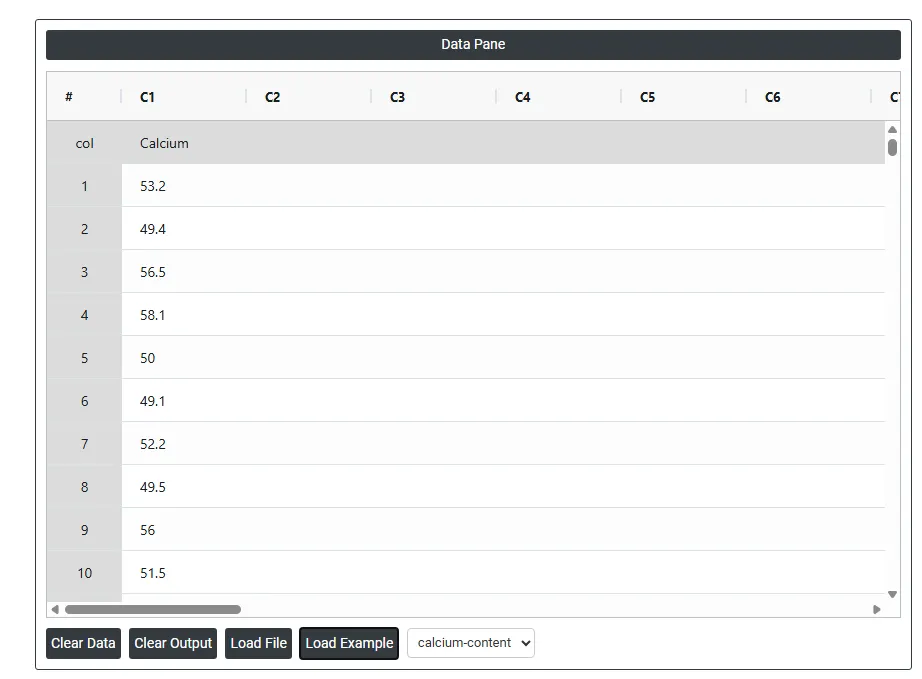
- Ahora analice los datos en Zometric Statistical Software en https://statsai.zometric.com/.
- Para encontrar Individual Distribution Identification, elija Statistical module> Hypothesis Test> Individual Distribution Identification.
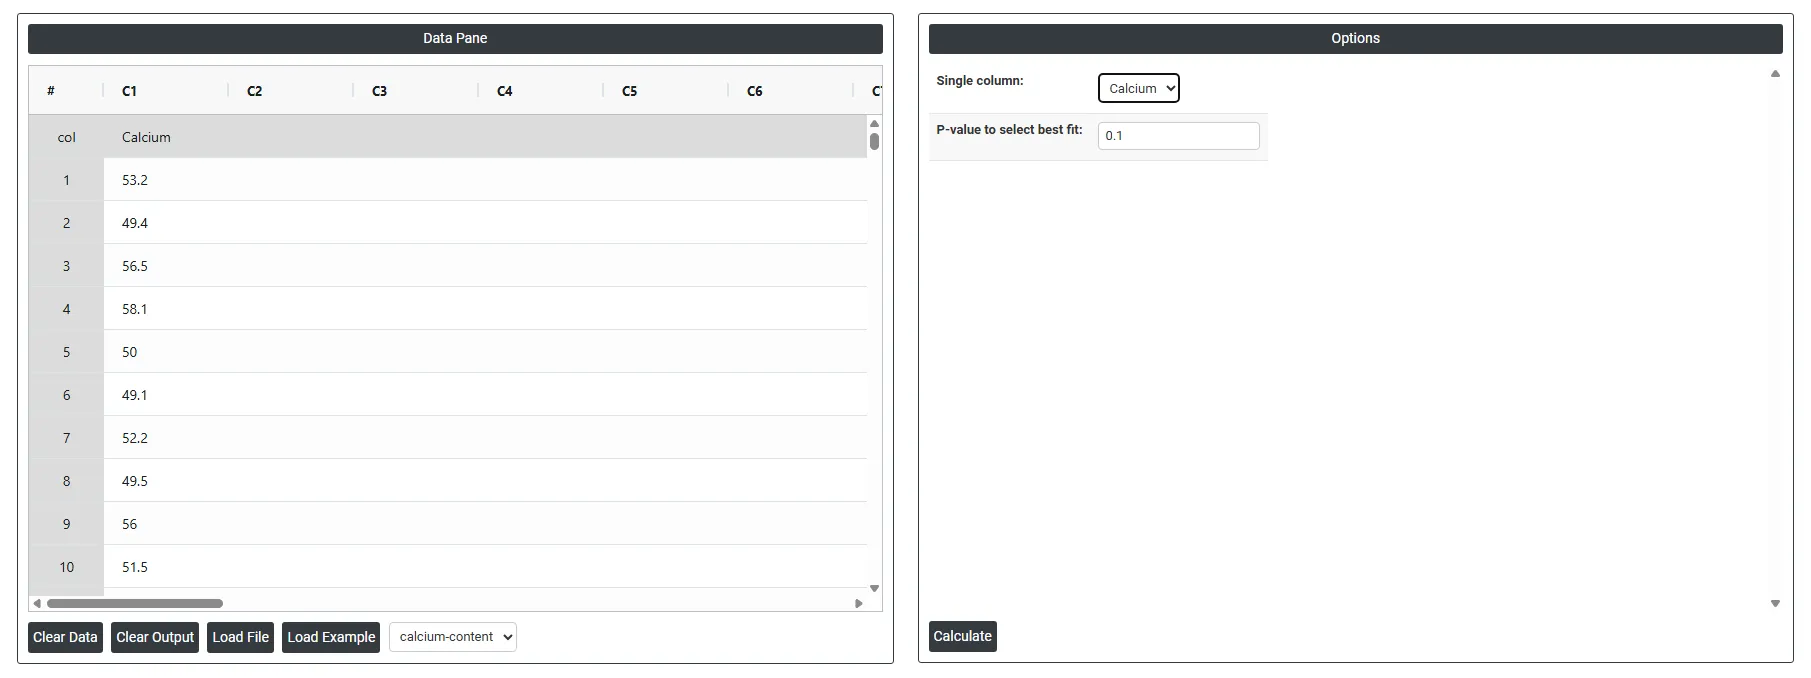
- Dentro de la herramienta, introduzca los datos junto con las demás entradas de la siguiente manera:
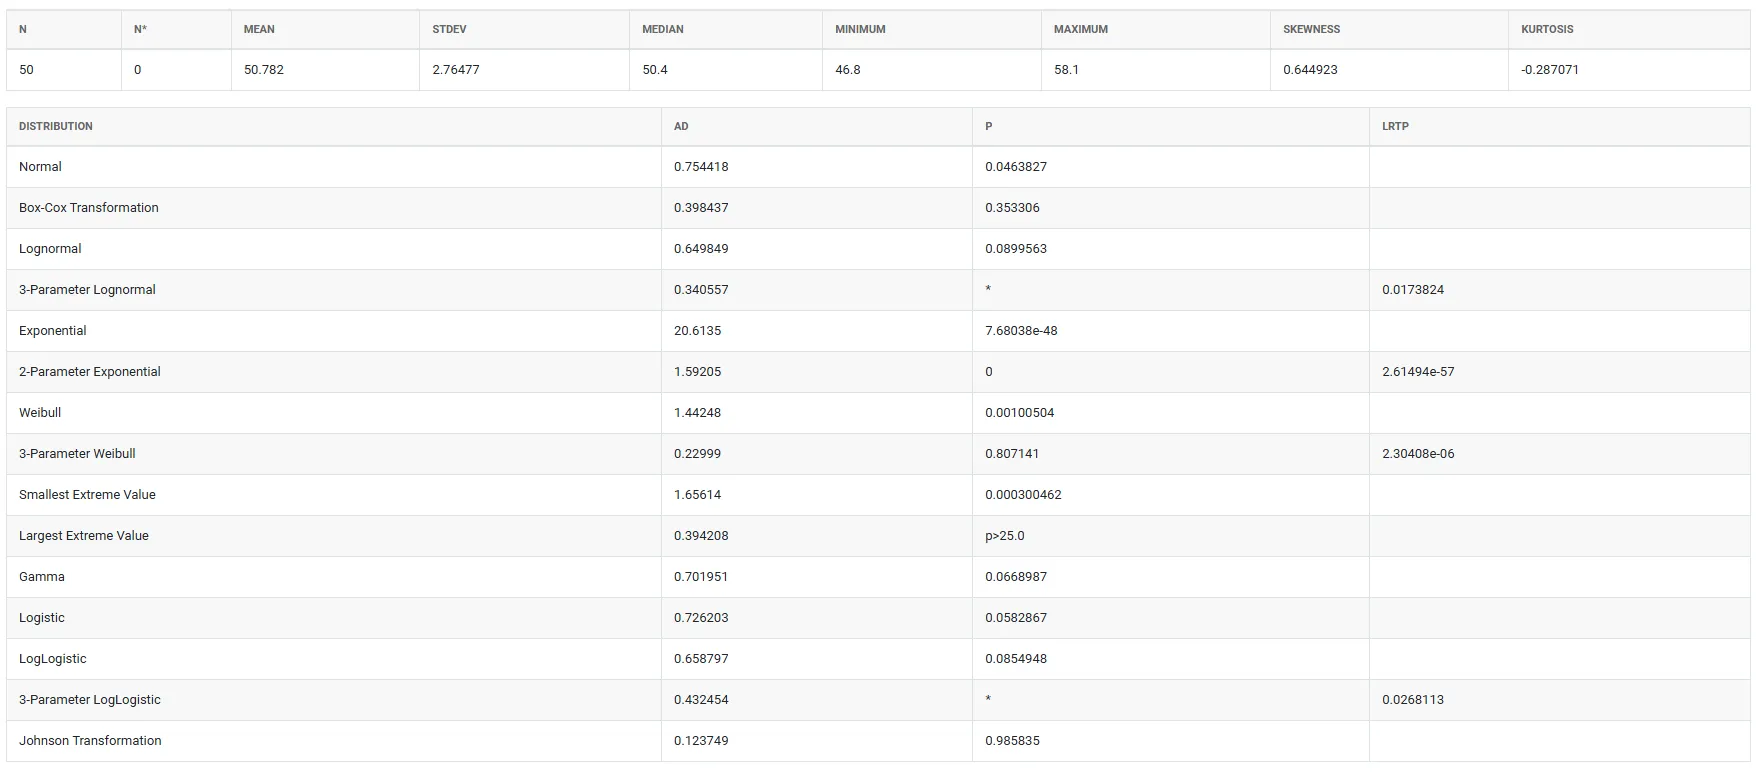
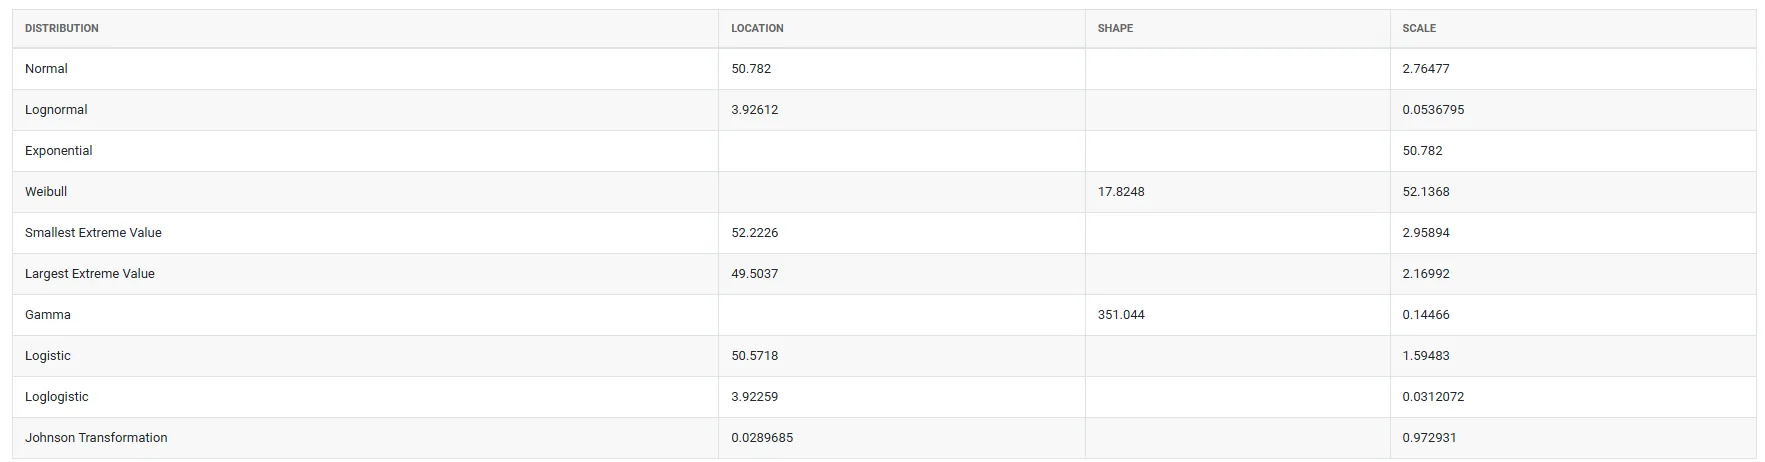
5. Tras usar la herramienta mencionada, se obtiene la siguiente salida:
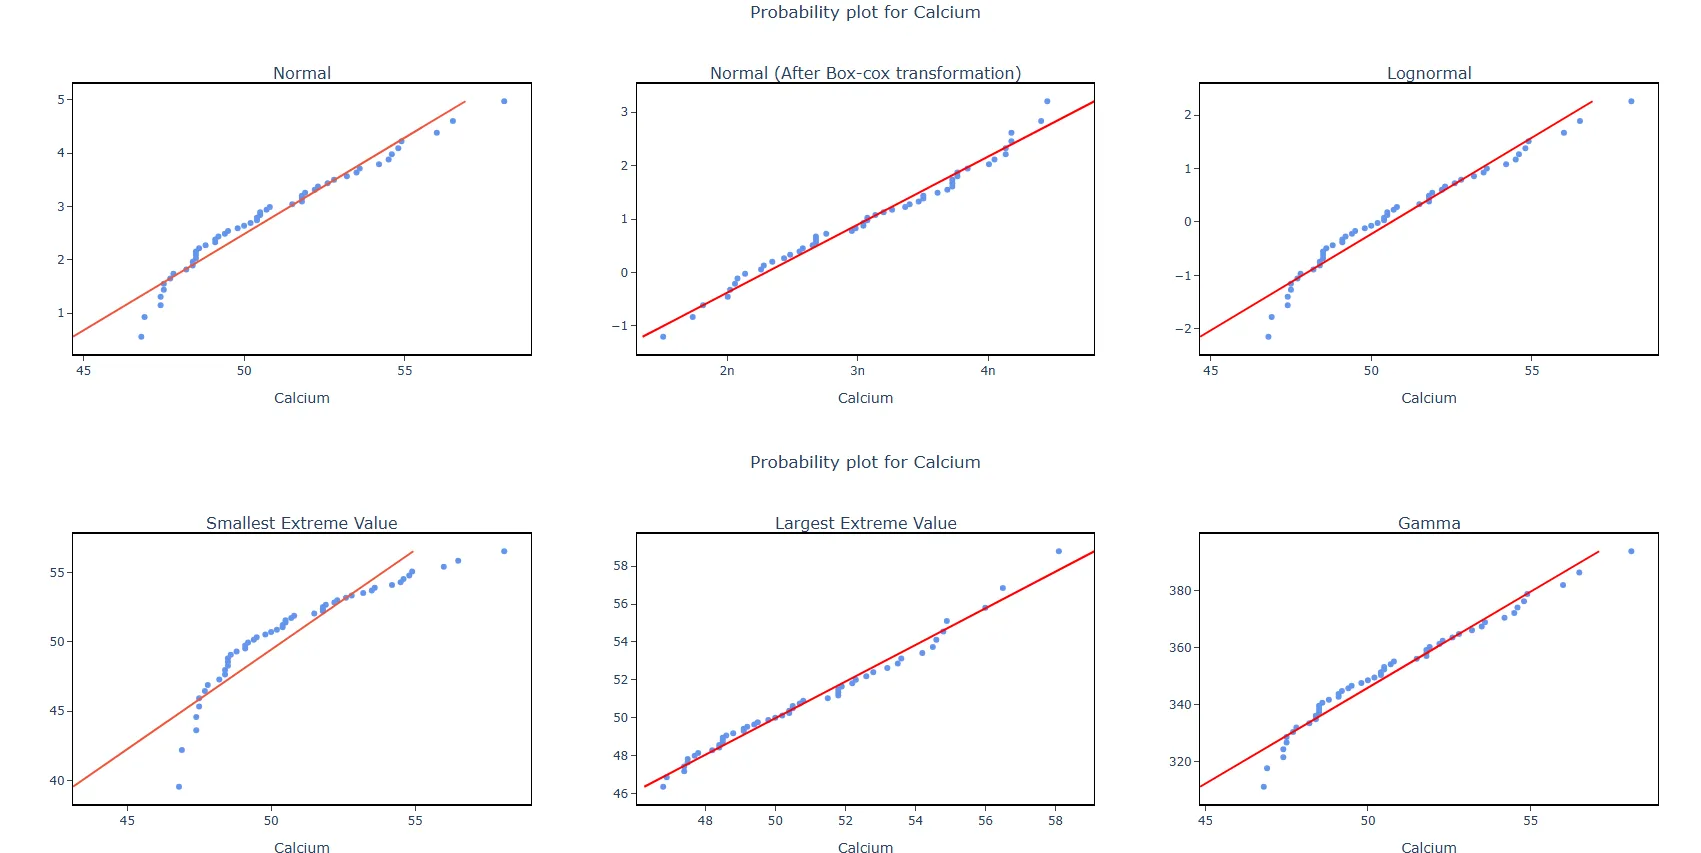
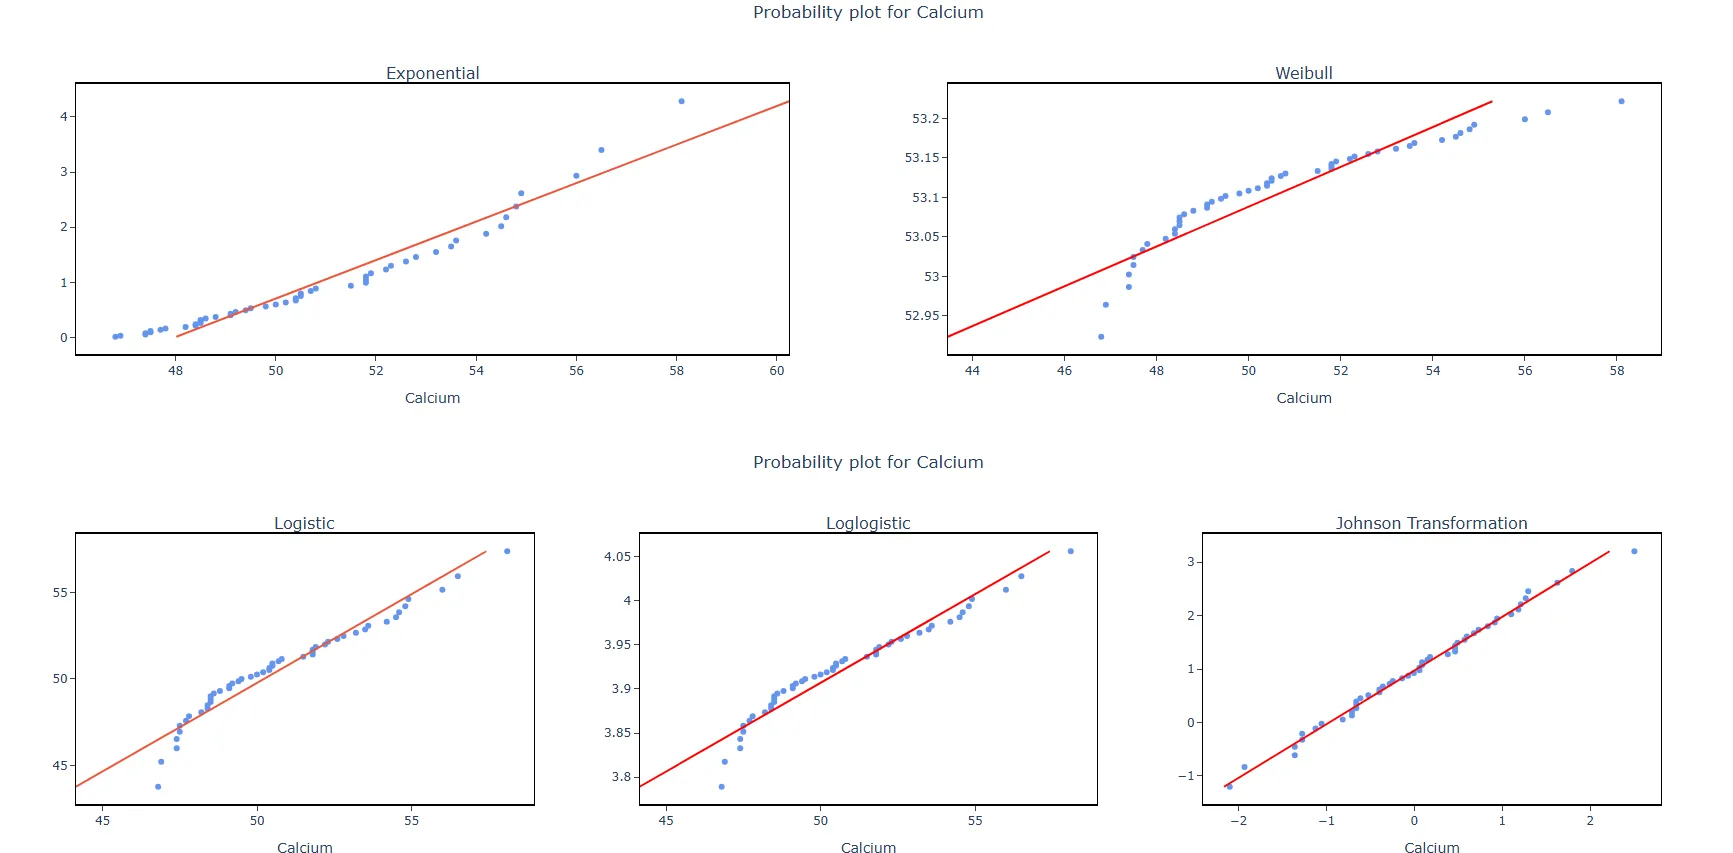
Cómo usar Individual Distribution Identification
La guía es la siguiente:
- Inicie sesión en Zometric Statistical Software en https://statsai.zometric.com/
- En la página de inicio, elija Statistical Tool> Hypothesis Test >Individual Distribution Identification .
- A continuación, introduzca los datos manualmente o copie todos los datos (Ctrl+C) de una hoja de Excel y péguelos (Ctrl+V).
- Complete las opciones necesarias.
- Por último, haga clic en calculate en la parte inferior de la página para obtener los resultados deseados.
En el tablero de Individual Distribution Identification, la ventana está dividida en dos partes.
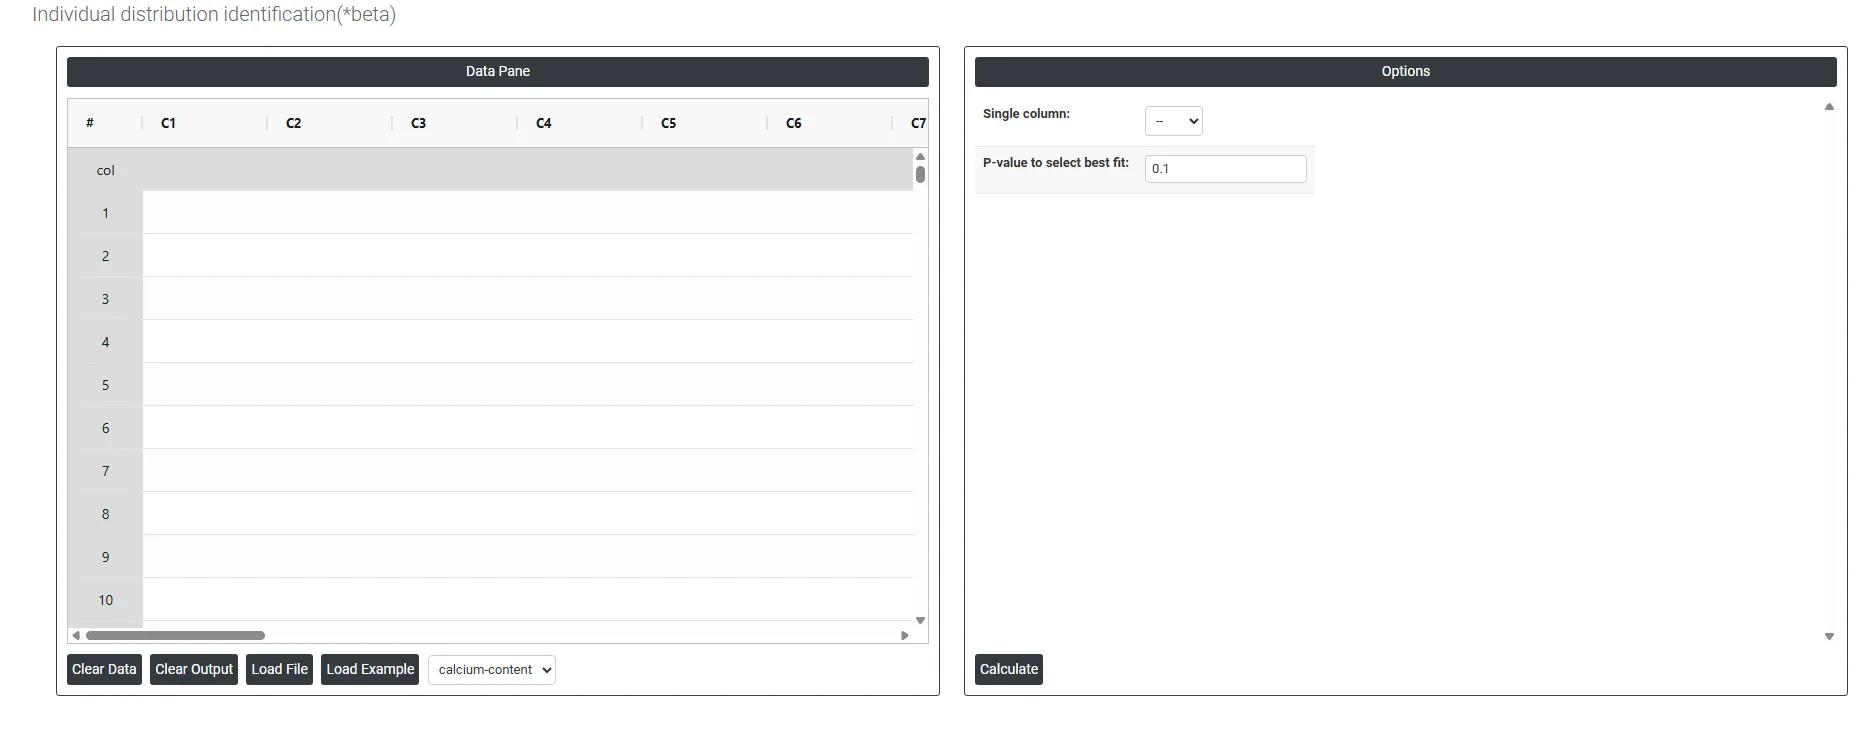
En la parte izquierda se encuentra el panel de datos (Data Pane). En el Data Pane, cada fila forma un subgrupo. Los datos pueden introducirse manualmente o puede copiar todos los datos (Ctrl+C) de una hoja de Excel y pegarlos (Ctrl+V) aquí.
Load example: Se cargarán los datos de ejemplo.
Load File: Se usa para cargar directamente los datos de Excel.
En la parte derecha hay muchas opciones, como las siguientes:
- Single Column: Seleccione la columna que contiene los datos continuos a los que desea ajustar distribuciones, por ejemplo, mediciones como niveles de calcio, tiempos de ciclo, resistencia a la tracción o tamaños de partícula. La herramienta toma todos los valores de esta columna y los contrasta simultáneamente con varias distribuciones de probabilidad para determinar cuál describe mejor la forma y el comportamiento de sus datos. Solo se puede seleccionar una columna a la vez, ya que cada variable se evalúa de forma independiente.
- P-Value to Select Best Fit: Establece el umbral de significancia utilizado para determinar qué distribuciones ofrecen un ajuste aceptable a sus datos. El valor estándar por defecto es 0.05, lo que significa que cualquier distribución cuyo valor p de bondad de ajuste de Anderson-Darling sea mayor que 0.05 se considera un ajuste estadísticamente aceptable: no hay evidencia suficiente para rechazar esa distribución como modelo de sus datos. Cómo interpretar el valor p en este contexto:
- Valor p > 0.05 : la distribución ajusta los datos de forma aceptable. Cuanto mayor es el valor p, más sólida es la evidencia de que la distribución es una buena coincidencia.
- Valor p ≤ 0.05 : la distribución no ajusta bien los datos y no debe utilizarse para el análisis de capacidad ni para otros modelados.
- Cuando varias distribuciones producen valores p aceptables, elija la que tenga el valor p más alto como candidata principal, pero combínelo siempre con una revisión visual de la gráfica de probabilidad y considere si la distribución seleccionada tiene sentido físico para su proceso. Una distribución que ajusta estadísticamente pero no tiene fundamento lógico para su tipo de datos debe cuestionarse antes de usarla.
Preguntas frecuentes
¿Qué es la identificación de distribución individual?
La identificación de distribución individual ajusta a la vez varias distribuciones de probabilidad a sus datos, entre ellas Weibull, lognormal, exponencial, logística y gamma, y las ordena según lo bien que describen los datos. Es esencial para el análisis de capacidad con datos no normales, porque usar una distribución incorrecta produce estimaciones inexactas de Pp, Ppk, Cp o Cpk y predicciones engañosas de la tasa de defectos.
¿Cuándo se debe usar la identificación de distribución individual?
Úsela cuando los datos no superan una prueba de normalidad y necesita la distribución correcta antes del análisis de capacidad, cuando los datos del proceso son inherentemente asimétricos, como tiempos de ciclo, tiempos hasta el fallo, concentraciones químicas o tamaños de partícula, y cuando una transformación de Box-Cox no es adecuada, por ejemplo porque los datos contienen ceros o valores negativos.
¿Cómo se elige la distribución que mejor ajusta?
Una distribución cuyo valor p de Anderson-Darling supera el umbral, 0.05 por defecto, es un ajuste aceptable; si es igual o inferior, la distribución no debe utilizarse. Cuando varias ajustan, tome la de valor p más alto como candidata principal, pero revise también la gráfica de probabilidad y compruebe que la distribución tiene sentido físico para el proceso.
¿Cuántos puntos de datos se necesitan para la identificación de distribución?
Recopile al menos 50 a 100 puntos de datos, porque las muestras pequeñas no aportan información suficiente para distinguir entre distribuciones. Los datos también deben proceder de un proceso estable y bajo control, ya que ajustar distribuciones a datos de un proceso inestable produce resultados sin sentido.