
Capacidad de proceso de múltiples variables
Multiple Variables Process Capability evalúa dos o más columnas, como cavidades, máquinas o líneas, frente a un mismo LSL/USL y un Target opcional. Úsela para encontrar el proceso de peor desempeño sin comparar informes separados. Se supone que cada variable es Normal, sin prueba de normalidad por variable. La salida es una tabla comparativa con N, Mean, StDev, Pp, Ppk, Cpm y PPM, más un histograma por variable.
Última revisión:
Idea clave
La capacidad de proceso de múltiples variables compara varios procesos paralelos, como cavidades de molde, máquinas o líneas, con una misma especificación en una sola tabla de Pp, Ppk y Cpm para mostrar cuál es el peor.
En esta página
Propósito
Multiple Variables Process Capability responde a una pregunta concreta y frecuente que las herramientas de capacidad existentes de la aplicación solo podían responder de forma indirecta: cuando la misma característica se mide en varias variables paralelas (distintas cavidades de un molde de inyección, distintas máquinas, distintas líneas) frente a una misma especificación, ¿cuál es la peor? En lugar de ejecutar N informes de capacidad por separado y compararlos a simple vista, esta herramienta produce UNA tabla comparativa unificada, en paralelo, y un conjunto de histogramas, de modo que los índices de la familia Cp/Cpk de cada variable quedan en la misma tabla.
Capacidades principales
- Seleccione 2 o más columnas cualesquiera y obtenga una tabla comparativa agregada en lugar de N informes apilados.
- Un único par LSL/USL se aplica de manera uniforme a todas las variables seleccionadas, de modo que la comparación se hace siempre en igualdad de condiciones frente a la misma especificación.
- Un Target compartido opcional agrega el índice Cpm por variable a la misma tabla comparativa.
- Histogramas por variable con los límites de especificación compartidos superpuestos, junto con la tabla agregada.
- Multiplicador de tolerancia K-sigma configurable, coherente con las demás herramientas de capacidad de la aplicación.
Métodos estadísticos
Cada variable o columna seleccionada se trata como un proceso independiente y se procesa con el mismo motor de capacidad Normal que usa la ruta Normal de la herramienta Automated Process Capability. Para cada una, σ_overall se estima mediante el método del rango móvil (MRbar/d2, o mediana del rango móvil), y se calcula la familia estándar de índices de desempeño basados en z: Pp = (USL − LSL) / (K·σ), Ppu = (USL − x̄) / ((K/2)·σ), Ppl = (x̄ − LSL) / ((K/2)·σ), Ppk = min(Ppu, Ppl), con K = 6 de forma predeterminada. Aquí se supone siempre que cada variable es Normal: esta herramienta no incluye prueba de normalidad por variable ni redirección a distribuciones no normales.
Cuando se proporciona un Target compartido, además se calcula Cpm por variable: Cpm = (USL − LSL) / (K·√(mean((x − Target)²))), que penaliza a una variable cuya media está desviada del valor objetivo aunque su dispersión por sí sola parezca capaz.
Como cada variable se evalúa frente a los mismos LSL/USL (y Target, cuando se proporciona), los valores resultantes de Ppk y Cpm son directamente comparables entre variables: la variable con el menor Ppk (o Cpm) en la tabla comparativa es la de peor desempeño en relación con la especificación compartida.
PPM Expected se calcula a partir de la probabilidad de cola de la distribución Normal ajustada más allá de cada límite de especificación para esa variable; PPM Observed es la fracción empírica de la propia muestra de esa variable que queda fuera de los límites de especificación, lo que permite detectar casos en que ambos discrepan (señal de que el supuesto de distribución Normal puede no cumplirse para esa variable en particular).
Campos de entrada y opciones
Campo | Descripción |
Process variables | Obligatorio. Seleccione 2 o más columnas para comparar: cada columna se trata como su propio proceso. |
LSL / USL | Se aplica a todas las variables seleccionadas. |
Target | Opcional. Agrega el índice Cpm por variable a la tabla comparativa. |
Tolerance (K) | Multiplicador aplicado a sigma al formar la banda de tolerancia de capacidad; valor predeterminado 6. |
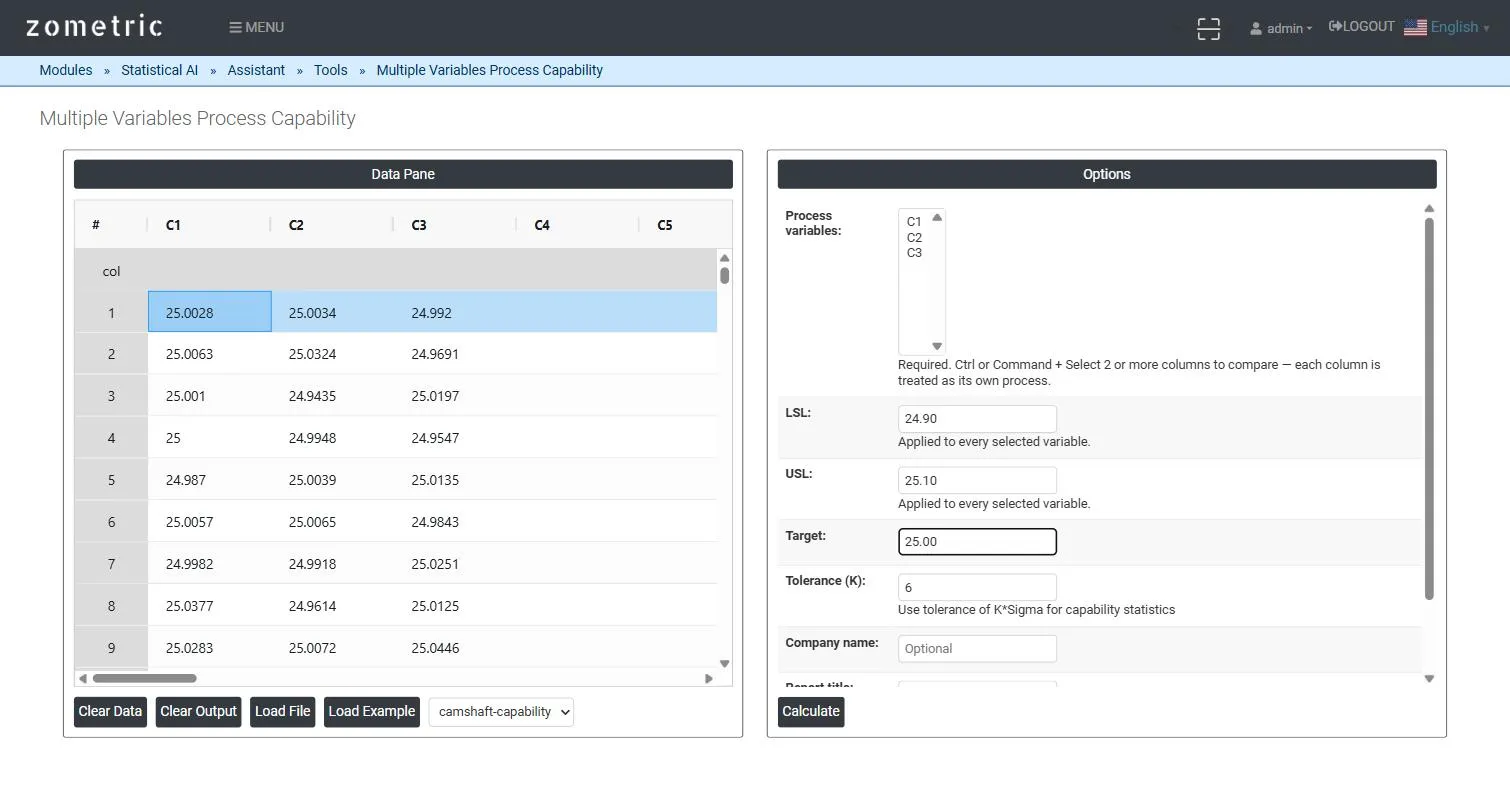
Figura 1: Data Pane con lecturas del diámetro de un orificio de 3 cavidades en C1–C3, las tres seleccionadas como Process variables, con LSL/USL/Target compartidos.
Descripción de la salida
- Comparison table: una fila por cada variable seleccionada con N, Mean, StDev, Pp, Ppl, Ppu, Ppk, Cpm (cuando se proporciona Target), PPM Expected y PPM Observed, todo frente a los mismos límites de especificación compartidos.
- Per-variable histogram: la distribución propia de cada variable con las líneas de referencia LSL/Target/USL compartidas y una curva Normal ajustada.
- Exportación a PDF del informe comparativo completo mediante Download as PDF.
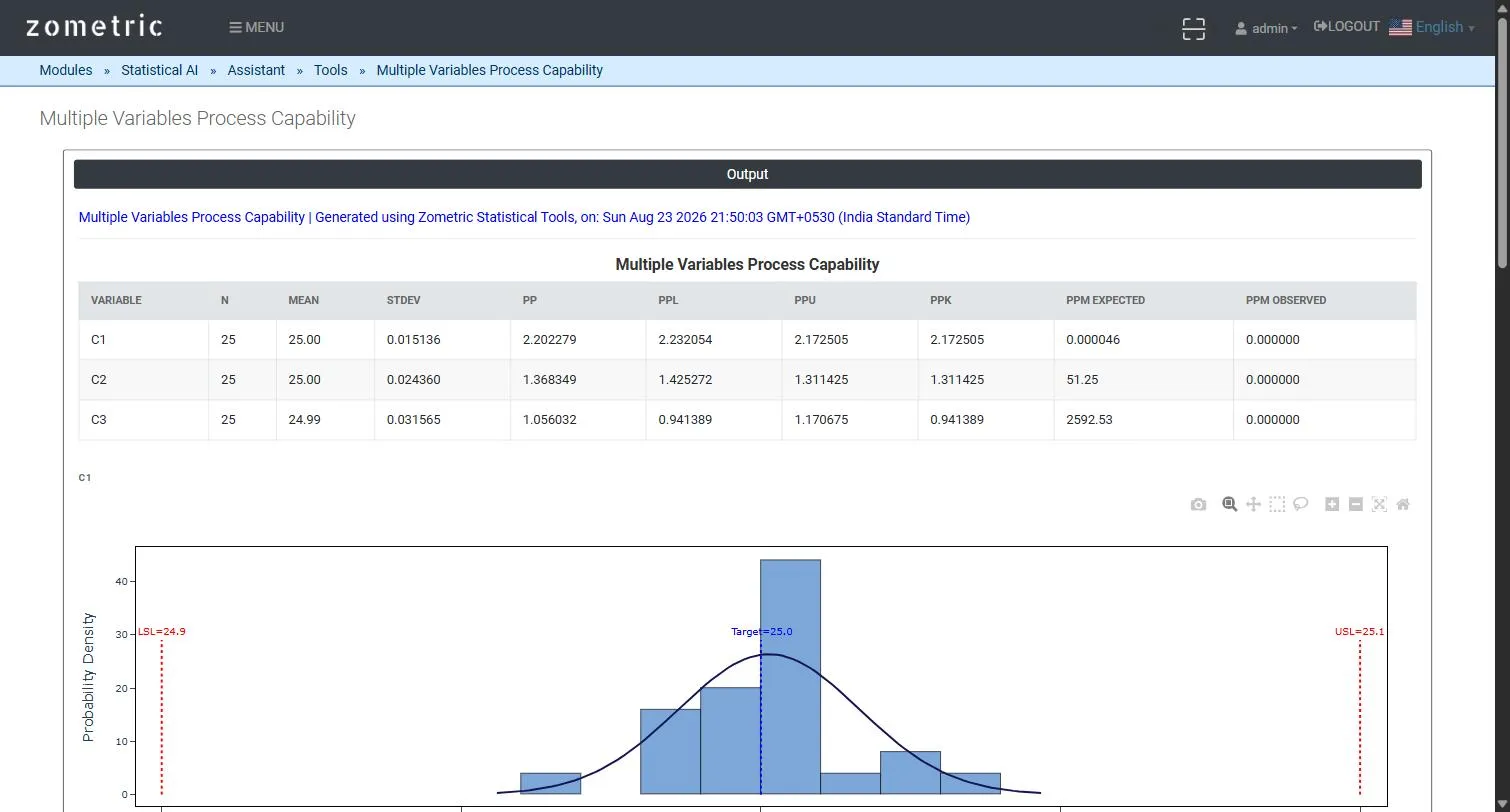
Figura 2: la tabla comparativa unificada (N, Mean, StDev, Pp, Ppl, Ppu, Ppk, Cpm, PPM Expected, PPM Observed por variable) con el histograma de la primera variable.
Ejemplo
Un molde de inyección tiene 3 cavidades que producen la misma pieza; se mide el diámetro del orificio (mm) en 25 piezas de cada cavidad (C1 = cavidad 1, C2 = cavidad 2, C3 = cavidad 3), frente a LSL = 24.90, USL = 25.10 y Target = 25.00 compartidos. La tabla comparativa muestra que la cavidad 1 tiene la dispersión más reducida (Ppk ≈ 2.17, Cpm ≈ 2.24) y la cavidad 3 es claramente peor (Ppk ≈ 0.94), lo que señala de inmediato a la cavidad 3 como la que requiere atención, sin tener que ejecutar y comparar manualmente tres informes separados.
Preguntas frecuentes
¿Qué es la capacidad de proceso de múltiples variables?
Es un análisis de capacidad que compara la misma característica medida en varias variables paralelas, como distintas cavidades de molde, máquinas o líneas, frente a una misma especificación. En lugar de informes separados, produce una tabla comparativa en paralelo con los valores de Pp, Ppl, Ppu, Ppk, Cpm y PPM, de modo que resulta fácil identificar la variable de peor desempeño.
¿Cómo se identifica el peor proceso en un estudio de capacidad de múltiples variables?
Como cada variable se evalúa frente a los mismos LSL, USL y Target, los valores de Ppk y Cpm son directamente comparables. La variable con el menor Ppk, o con el menor Cpm cuando se proporciona un Target, es la de peor desempeño en relación con la especificación compartida y debe investigarse primero.
¿La capacidad de proceso de múltiples variables supone normalidad?
Sí. Cada variable se analiza con un cálculo de capacidad Normal y no hay prueba de normalidad por variable ni redirección a distribuciones no normales. Comparar PPM Expected, obtenido de la cola Normal ajustada, con PPM Observed, la fracción real fuera de especificación, ayuda a detectar variables en las que ambos discrepan, señal de que el supuesto de normalidad puede no cumplirse.
¿Qué aporta Cpm a la comparación?
Cuando se proporciona un Target compartido, Cpm se calcula para cada variable como (USL - LSL) dividido por K veces la raíz de la desviación cuadrática media respecto del Target. Penaliza a una variable cuya media está desviada del valor objetivo, aunque su dispersión por sí sola parezca capaz.