
Capacidad del proceso de múltiples variables (no normal)
Esta herramienta compara la capacidad de dos o más columnas con una misma especificación cuando los datos son asimétricos, como el tamaño de partícula, la planitud o las impurezas. Ajusta a cada columna un modelo elegido entre quince, incluidos Weibull, Lognormal, Box-Cox y Johnson, con el método Z-Score o ISO. Cada columna necesita al menos 4 valores. La salida es una tabla de Pp, PPL, PPU, Ppk y PPM, además de histogramas.
Última revisión:
Idea clave
La capacidad del proceso de múltiples variables (no normal) compara varios procesos con una misma especificación cuando los datos no son normales, ajustando la misma distribución a cada uno y listando Pp, Ppk y PPM en paralelo.
En esta página
Finalidad
La capacidad del proceso de múltiples variables (no normal) compara la capacidad de varios procesos, líneas, máquinas o cavidades con una misma especificación cuando los datos no tienen distribución normal. Ajusta la misma distribución a cada columna por separado y presenta en una sola tabla, en paralelo, Pp, PPL, PPU, Ppk y las partes por millón esperadas y observadas fuera de especificación, con un histograma de cada columna. Úsela para características asimétricas, como el tamaño de partícula, la planitud, el descentramiento o las impurezas, en las que un Ppk basado en la normal juzga mal la cola, y cuando quiera clasificar los procesos.
Capacidades principales
- Dos o más columnas, cada una tratada como su propio proceso y ajustada de forma independiente.
- Quince modelos: Weibull, Exponential, Logistic, Loglogistic, Largest and Smallest Extreme Value, 2-Parameter Exponential, 3-Parameter Weibull, Gamma, Lognormal, 3-Parameter Lognormal, 3-Parameter LogLogistic, transformaciones Box-Cox y Johnson, y una Mixed Distribution (ISO 22514-2).
- Método Z-Score o de percentiles ISO para los índices.
- Especificaciones unilaterales o bilaterales aplicadas a todas las columnas.
- Tabla comparativa con Pp, PPL, PPU, Ppk, PPM Expected y PPM Observed, y un histograma de cada columna con los límites de especificación y la curva ajustada.
Métodos estadísticos
Para cada columna, la distribución elegida se ajusta por máxima verosimilitud (Weibull, Gamma y Exponential con el umbral fijado en 0; los modelos de 3 parámetros lo estiman). Lognormal usa la media y la desviación estándar de los datos en logaritmos. Box-Cox y Johnson transforman los datos a la normal y trabajan en la escala transformada; la Mixed Distribution ajusta una mezcla de distribuciones normales, con el número de componentes elegido por BIC salvo que se fije. Cada columna necesita al menos 4 valores.
Método Z-Score (por defecto): las probabilidades ajustadas más allá de cada límite se convierten en puntuaciones normales, Z_USL = Φ⁻¹(F(USL)) y Z_LSL = Φ⁻¹(F(LSL)), donde F es la distribución acumulada ajustada. Entonces PPU = Z_USL / 3, PPL = −Z_LSL / 3, Pp = (Z_USL − Z_LSL) / 6 y Ppk = min(PPL, PPU). Método ISO: los índices usan los percentiles ajustados X₀.₁₃₅, X₅₀ y X₉₉.₈₆₅ (los puntos que cubren la misma proporción de ±3σ que una normal): Pp = (USL − LSL) / (X₉₉.₈₆₅ − X₀.₁₃₅), PPL = (X₅₀ − LSL) / (X₅₀ − X₀.₁₃₅), PPU = (USL − X₅₀) / (X₉₉.₈₆₅ − X₅₀). Con un solo límite no se da Pp y Ppk es el índice unilateral.
PPM Expected es la proporción ajustada de la población más allá de los límites, multiplicada por 1,000,000; PPM Observed es la proporción de los valores de la muestra más allá de ellos. Son índices generales (a largo plazo) calculados con todos los datos. Solo valen lo que valga la distribución: el mismo modelo se aplica a todas las columnas, por lo que debe comprobar el ajuste de cada una (por ejemplo, con Individual Distribution Identification) antes de comparar las columnas.
Campos de entrada y opciones
Campo | Descripción |
Process variables | Obligatorio. Dos o más columnas numéricas que comparar; cada una se ajusta por sí sola. |
Fit distribution | Obligatorio. Uno de los quince modelos enumerados arriba (por defecto Weibull), aplicado a todas las columnas. |
Mixture components | Solo para Mixed Distribution (ISO 22514-2): Auto (seleccionado por BIC, por defecto) o de 2 a 6 componentes. |
Method of analysis | Z-Score (por defecto) o ISO. |
LSL / USL | Límites de especificación aplicados a todas las columnas; se requiere al menos uno, y LSL debe ser menor que USL. |
Company name / Report title | Texto opcional para el informe; el título por defecto es Multiple Variables Process Capability (Nonnormal). |
Data Options: Subset (optional) | Exclude matching rows (por defecto) o Include only matching rows, según los números de fila (p. ej., 3,7,12-15) y/o una condición. |
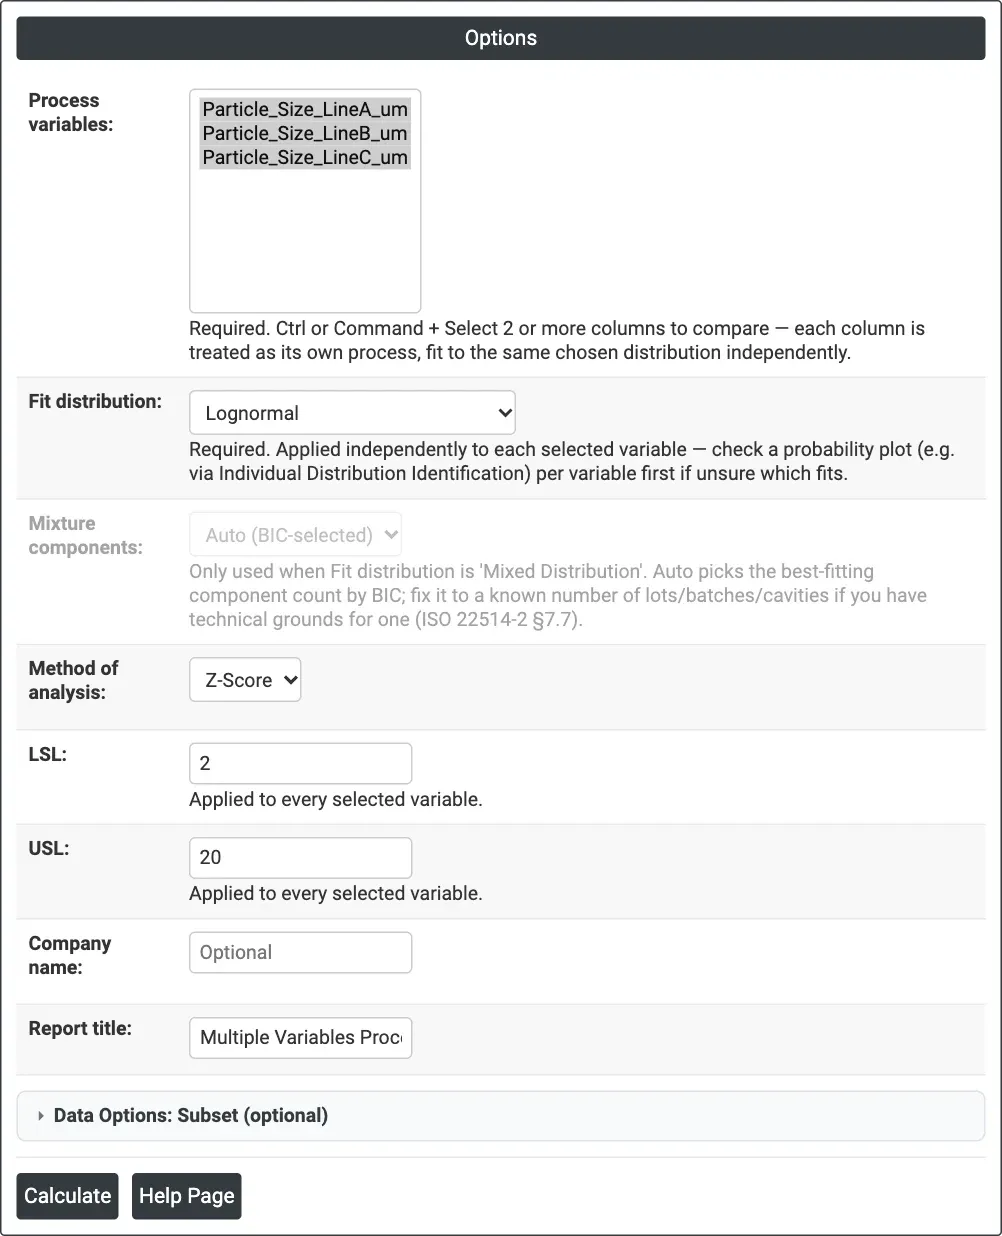
Figura 1 — Opciones del ejemplo: tamaño de partícula de tres líneas, Lognormal, método Z-Score, LSL 2 µm y USL 20 µm.
Descripción de la salida
- Multiple Variables Process Capability (Nonnormal) — una fila por columna: Variable, N, Distribution, Pp, PPL, PPU, Ppk, PPM Expected y PPM Observed.
- Histogram of <distribution> Distribution — uno por columna, bajo el nombre de la columna, con LSL y USL y la curva de densidad ajustada.
- Exportación a PDF mediante Download.
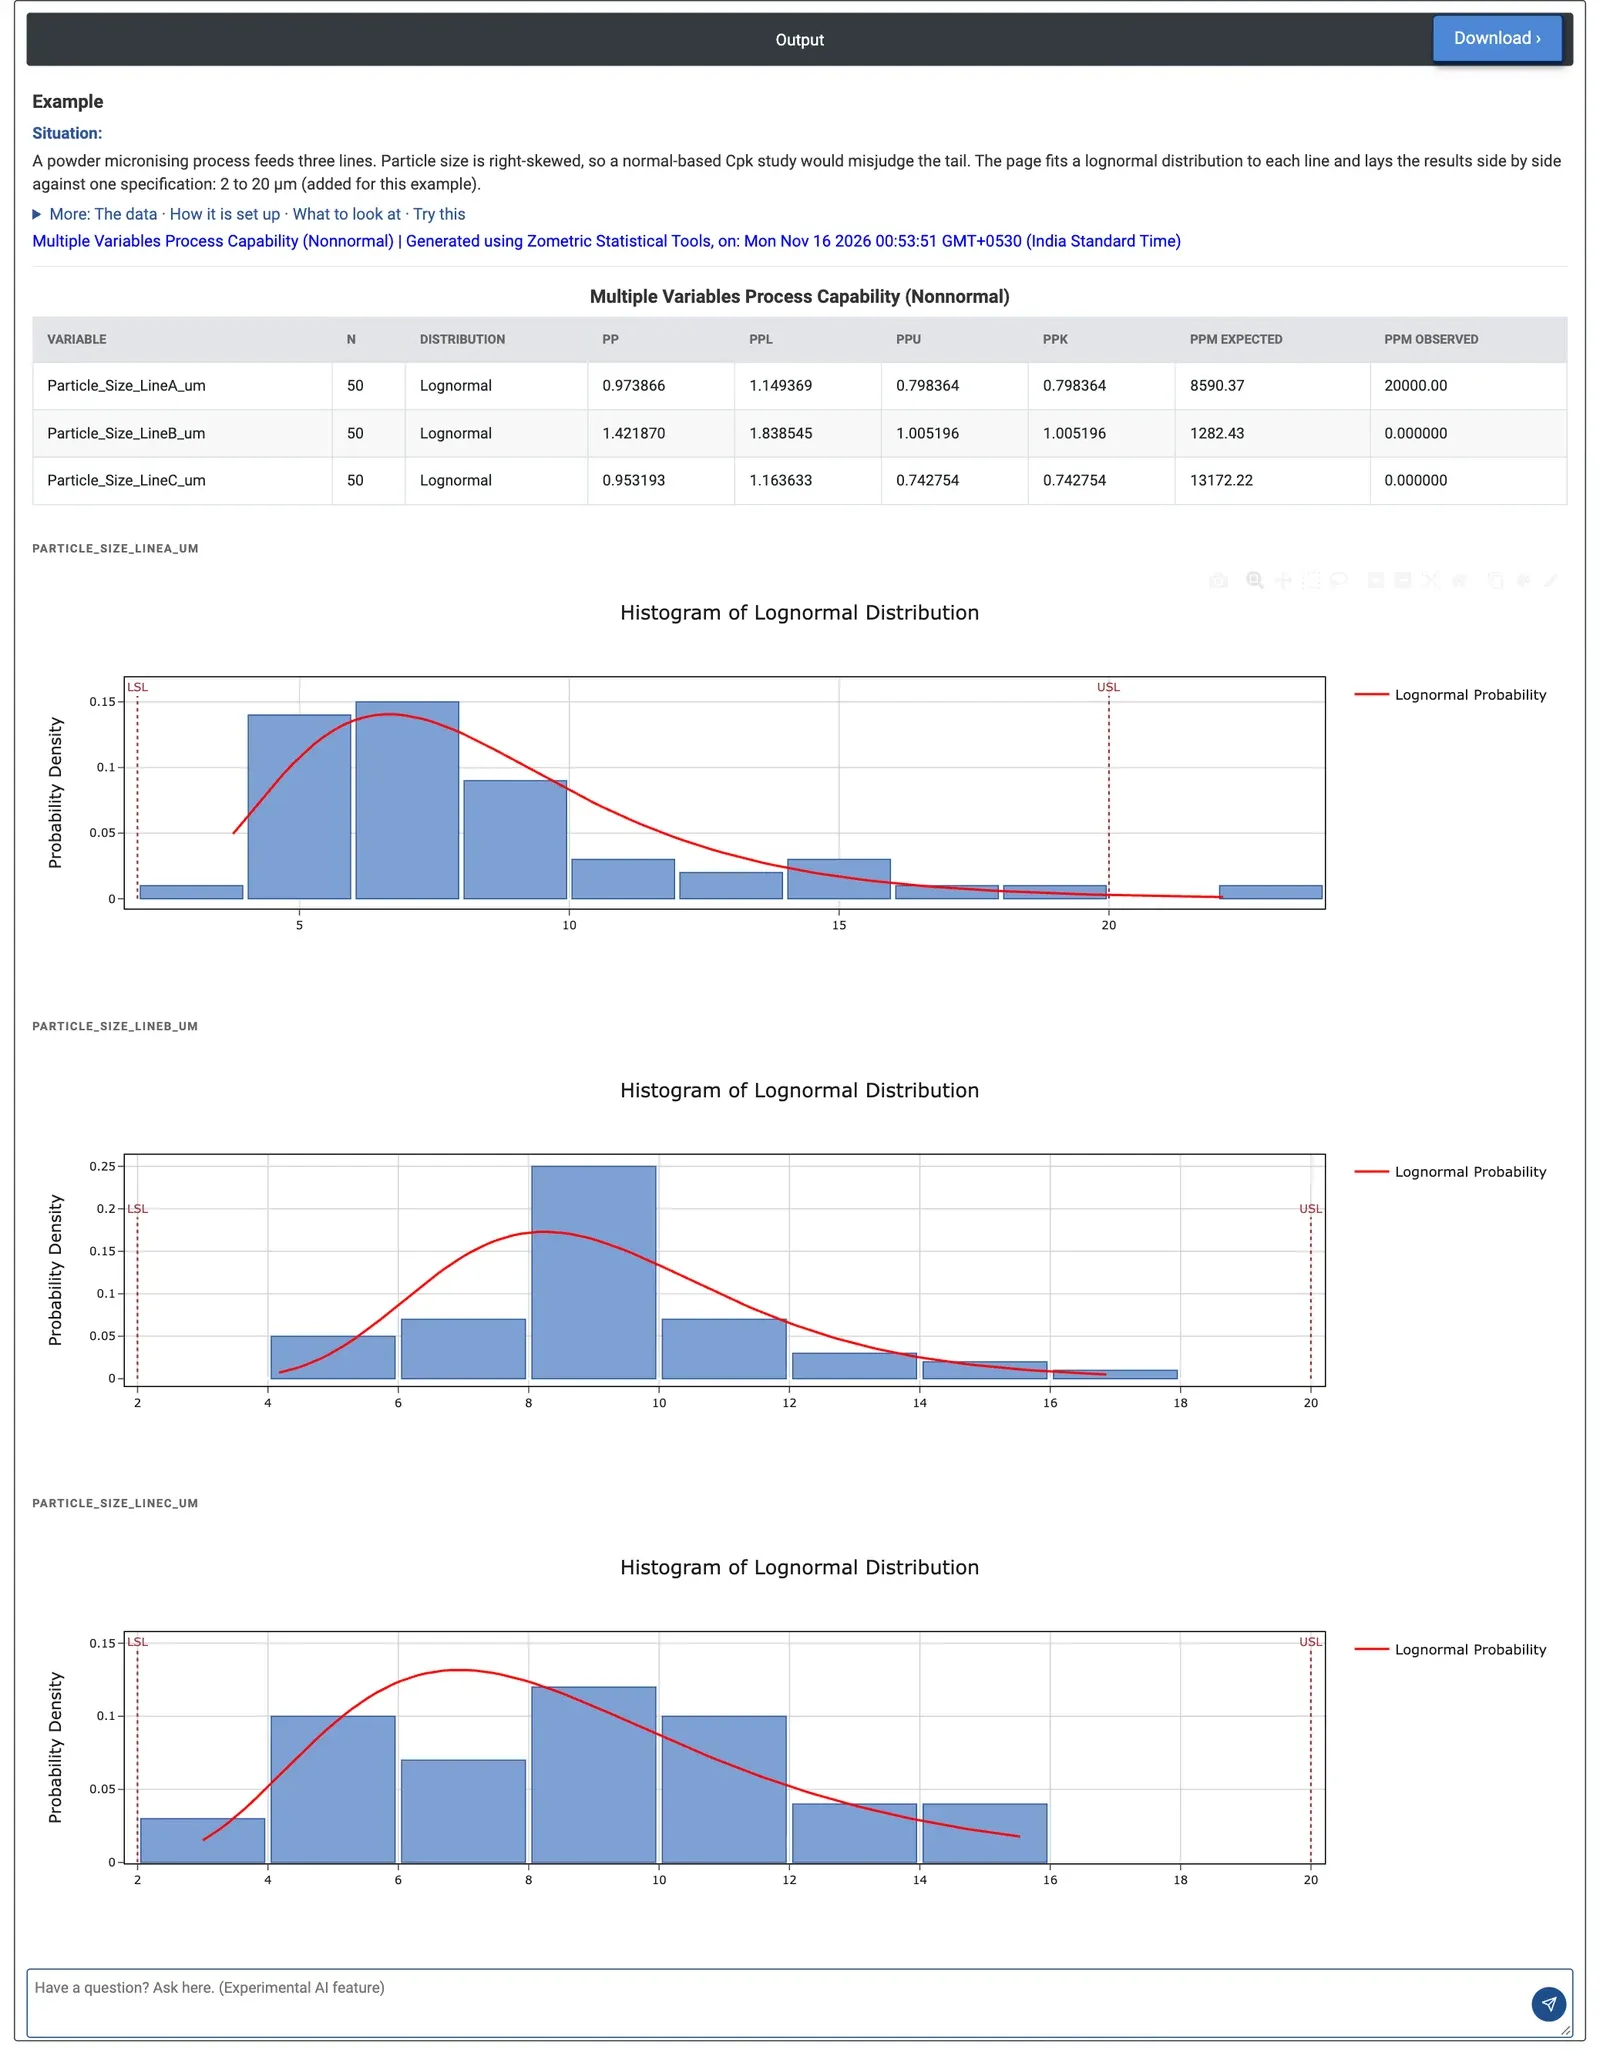
Figura 2 — Tabla comparativa e histogramas lognormales de las tres líneas: Ppk de 0.798 para la línea A, 1.005 para la línea B y 0.743 para la línea C, con PPU por debajo de PPL en todas las líneas; solo la línea A tiene una muestra por encima del USL.
Ejemplo
Un proceso de micronizado de polvo alimenta tres líneas y el tamaño de partícula tiene asimetría a la derecha (mediana de aproximadamente 7 a 9 µm, con una cola larga hacia las partículas gruesas). El ingeniero de procesos quiere comparar las líneas con una especificación de 2 a 20 µm usando 50 muestras de cada una. Process variables = Particle_Size_LineA_um, Particle_Size_LineB_um y Particle_Size_LineC_um, Fit distribution = Lognormal, Method of analysis = Z-Score, LSL = 2, USL = 20.
La línea A tiene un Ppk de 0.798 y 8,590 PPM esperadas fuera de especificación; una muestra (22.11 µm) ya está por encima de 20 µm, por lo que se observan 20,000 PPM. La línea B es la mejor, con un Ppk de 1.005 y 1,282 PPM esperadas, pero aún por debajo del objetivo habitual de 1.33. La línea C es la más arriesgada, con un Ppk de 0.743 y 13,172 PPM esperadas. En todas las líneas PPU es menor que PPL: el riesgo son las partículas gruesas por encima de 20 µm, no las finas por debajo de 2 µm, por lo que el trabajo de mejora debe dirigirse a la cola gruesa, empezando por la línea C. Los histogramas muestran la misma imagen: cada curva ajustada tiene su cola larga hacia el USL y, en la línea A, una barra queda más allá de este.
El modelo importa. Con el método ISO, los valores de Ppk bajan a 0.694, 1.008 y 0.619, con la misma clasificación. Con un ajuste Weibull, PPL pasa a ser el índice menor en todas las líneas y la clasificación cambia (Ppk de 0.641, 0.948 y 0.798, con la línea A ahora la peor). Los estadísticos de Anderson-Darling calculados por separado de esta página favorecen la lognormal en las líneas A y B (0.79 frente a 2.17, y 0.63 frente a 1.34) pero la Weibull en la línea C (0.20 frente a 0.55), por lo que conviene comprobar las líneas una por una antes de usar la clasificación para tomar decisiones.
Preguntas frecuentes
¿Cuándo debe usarse el análisis de capacidad no normal para múltiples variables?
Úselo para comparar y clasificar la capacidad de varios procesos, líneas, máquinas o cavidades con una misma especificación cuando los datos no tienen distribución normal. Son ejemplos típicos las características asimétricas, como el tamaño de partícula, la planitud, el descentramiento o las impurezas, en las que un Ppk basado en la normal juzga mal la cola de la distribución.
¿Cuál es la diferencia entre los métodos Z-Score e ISO?
El método Z-Score convierte las probabilidades ajustadas más allá de cada límite en puntuaciones normales y las divide entre 3 para dar PPU y PPL. El método ISO usa los percentiles ajustados 0.135, 50 y 99.865 en lugar de la dispersión normal de más o menos 3 sigma. Ambos pueden dar valores de Ppk distintos, como muestra el ejemplo, aunque la clasificación puede seguir siendo la misma.
¿Por qué importa la elección de la distribución en la capacidad no normal?
Los índices solo valen lo que valga la distribución ajustada, y el mismo modelo se aplica a todas las columnas. En el ejemplo, pasar de Lognormal a Weibull cambió qué índice era menor y cambió la clasificación de las líneas. Compruebe el ajuste de cada columna, por ejemplo con Individual Distribution Identification, antes de compararlas.
¿Cuál es la diferencia entre PPM Expected y PPM Observed?
PPM Expected es la proporción de la población, según la distribución ajustada, más allá de los límites de especificación, multiplicada por 1,000,000. PPM Observed es la proporción de los valores reales de la muestra más allá de los límites. Ambas son medidas generales, a largo plazo, calculadas con todos los datos de cada columna.