
Capacidad de proceso no normal
Use la capacidad de proceso no normal para datos continuos asimétricos o que siguen una distribución como Weibull, exponencial, gamma o lognormal. Recopile al menos 100 puntos de datos de un proceso estable y confirme que la distribución se ajusta. Introduzca LSL y USL y elija el método de puntuación Z o el método de percentiles de ISO 22514. La salida incluye índices de capacidad y el porcentaje previsto de salida fuera de especificación.
Última revisión:
Idea clave
La capacidad de proceso no normal evalúa si un proceso produce salida dentro de los límites de especificación cuando sus datos no tienen distribución normal, ajustando una distribución adecuada, como Weibull o lognormal.
En esta página
- ¿Qué es la capacidad de proceso no normal?
- ¿Cuándo usar la capacidad de proceso no normal?
- Pautas para el uso correcto de la capacidad de proceso no normal
- Alternativas: cuándo no usar la capacidad de proceso no normal
- ¿Ejemplo de capacidad de proceso no normal?
- Cómo realizar un análisis de capacidad de proceso no normal
¿Qué es la capacidad de proceso no normal?
La capacidad de proceso no normal es un método que se usa para evaluar la capacidad de un proceso de producir salidas dentro de los límites especificados cuando los datos se desvían de una distribución normal. Este análisis es fundamental cuando los datos presentan características como asimetría o valores atípicos, o siguen una distribución distinta de la curva normal en forma de campana. Al elegir el modelo de distribución no normal correcto, este análisis evalúa en qué medida los resultados del proceso cumplen los requisitos del cliente, mide el desempeño global del proceso y predice el porcentaje de salidas que probablemente caerán fuera del rango aceptable. Este enfoque ayuda a determinar si el proceso puede cumplir de forma fiable las normas deseadas, incluso cuando la distribución de los datos no es normal.
En términos sencillos, es una forma de asegurarse de que un proceso funciona bien, incluso cuando los datos no tienen el aspecto que esperamos.
¿Cuándo usar la capacidad de proceso no normal?
La capacidad de proceso no normal debe usarse cuando los datos que se analizan no siguen una distribución normal, es decir, no tienen la típica curva en forma de campana, simétrica y centrada en la media. Estas son algunas situaciones en las que usaría la capacidad de proceso no normal:
- Datos asimétricos: si sus datos son asimétricos hacia la izquierda o hacia la derecha, es decir, la mayoría de los valores se agrupan en un lado, es más apropiado un análisis de capacidad de proceso no normal.
- Presencia de valores atípicos: si sus datos tienen valores extremos que no encajan en el patrón general, pueden distorsionar una distribución normal. Investíguelos primero; si forman parte genuina de un proceso de cola larga, una distribución no normal puede modelar la cola mejor que la distribución normal.
- Distribuciones no simétricas: cuando los datos muestran un patrón que no es simétrico (p. ej., distribuciones lognormales o exponenciales), la capacidad de proceso no normal ayuda a obtener una evaluación más precisa.
- Varios picos: si sus datos tienen más de un pico (distribución bimodal o multimodal), no siguen una distribución normal; esto suele significar que los datos proceden de más de un flujo del proceso (por ejemplo, distintas máquinas o lotes), que deben separarse antes de evaluar la capacidad.
- Características del proceso: algunos procesos producen de forma natural datos no normales debido a la naturaleza del proceso o del producto. Por ejemplo, el desgaste con el tiempo, los procesos por lotes o los procesos con límites inherentes pueden producir datos no normales.
Pautas para el uso correcto de la capacidad de proceso no normal
- Use datos continuos para el análisis; si trabaja con datos de atributos, aplique en su lugar el análisis de Capacidad Binomial o de Capacidad de Poisson.
- Recopile al menos 100 puntos de datos para asegurar estimaciones fiables de la capacidad del proceso y una representación precisa de la variación del proceso.
- Asegúrese de que el proceso sea estable y esté bajo control antes de realizar el análisis de capacidad, usando herramientas como la gráfica XBarra-S o el Six Pack de Capacidad (No Normal) si es necesario.
- Los datos deben seguir de cerca la distribución no normal seleccionada; use la Identificación de Distribución Individual para encontrar el mejor ajuste y obtener estimaciones de capacidad precisas.
Alternativas: cuándo no usar la capacidad de proceso no normal
- Si no está seguro de qué distribución no normal se ajusta a sus datos, use la Identificación de Distribución Individual antes del análisis.
- Para comprobar el control del proceso y la idoneidad de una distribución no normal concreta, use primero el Six Pack de Capacidad (No Normal).
- Para estimar la variación dentro de los subgrupos y la capacidad potencial junto con la capacidad global, use la Capacidad de Proceso (Distribución Normal) para transformar los datos no normales y evaluarlos con base en una distribución normal.
¿Ejemplo de capacidad de proceso no normal?
Un fabricante de componentes de automoción evalúa si una taladradora puede cumplir las especificaciones de un componente crítico. El componente debe estar dentro de un rango: límite inferior de especificación (LSL) de 22.15 y límite superior de especificación (USL) de 22.35. Para evaluarlo, el ingeniero toma 125 muestras de la máquina y realiza los pasos siguientes:
- Se reunieron los datos necesarios.
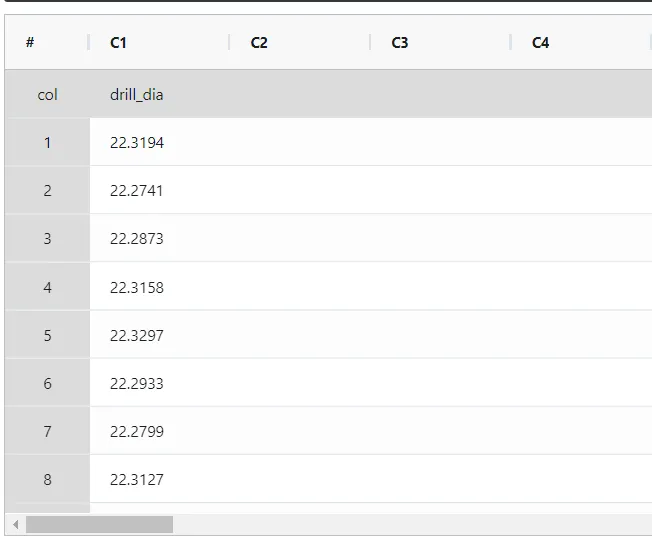
- Ahora analice los datos en Zometric Statistical Software en https://statsai.zometric.com/.
- Para encontrar la capacidad de proceso no normal, elija Statistical module> Process Capability>Non-Normal Process Capability.
- Dentro de la herramienta, introduzca los datos junto con las demás entradas del siguiente modo:
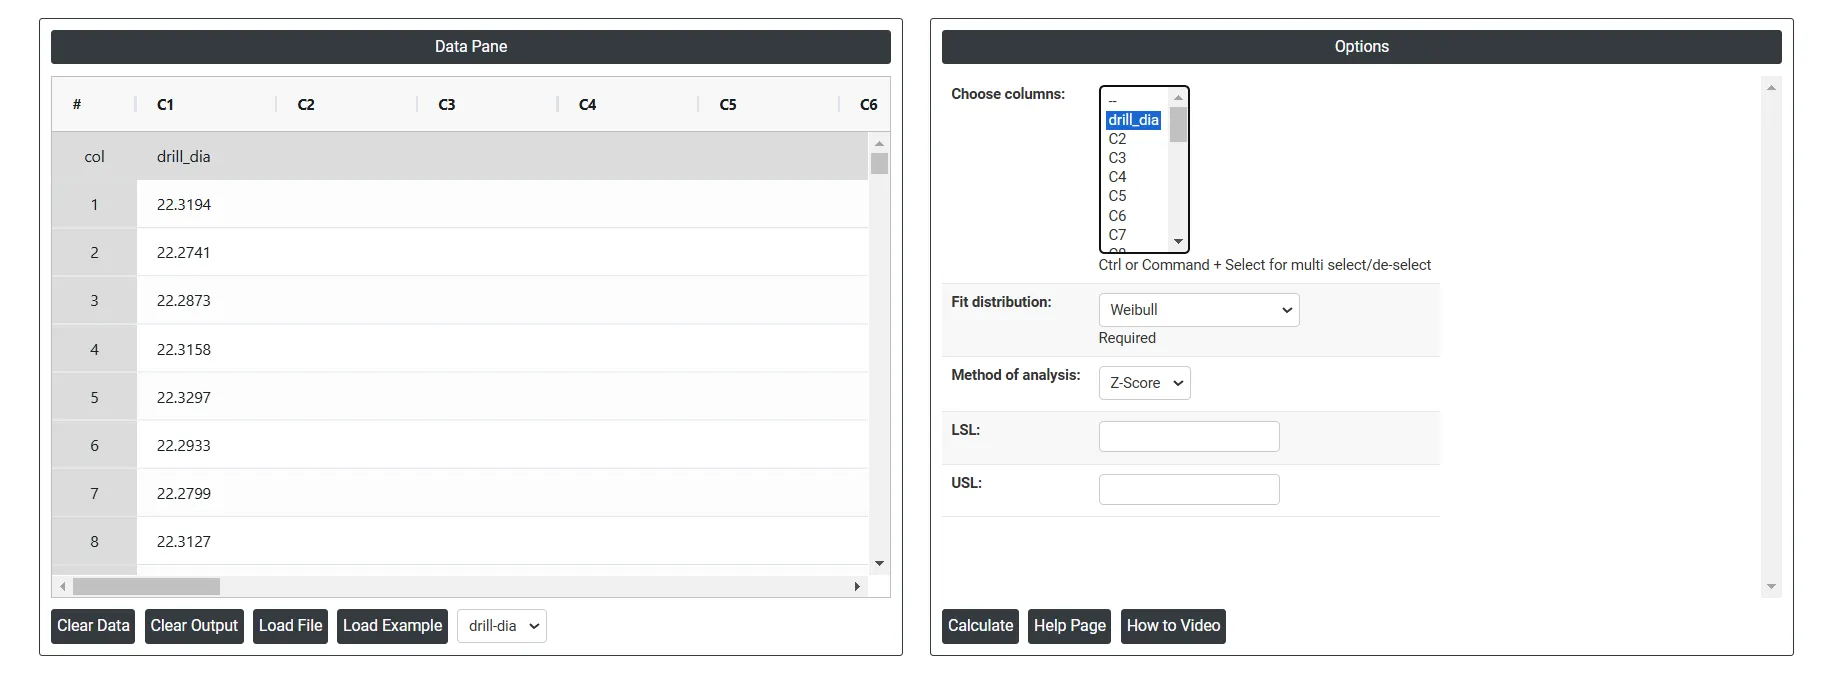
5. Tras usar la herramienta anterior, se obtiene la salida siguiente:
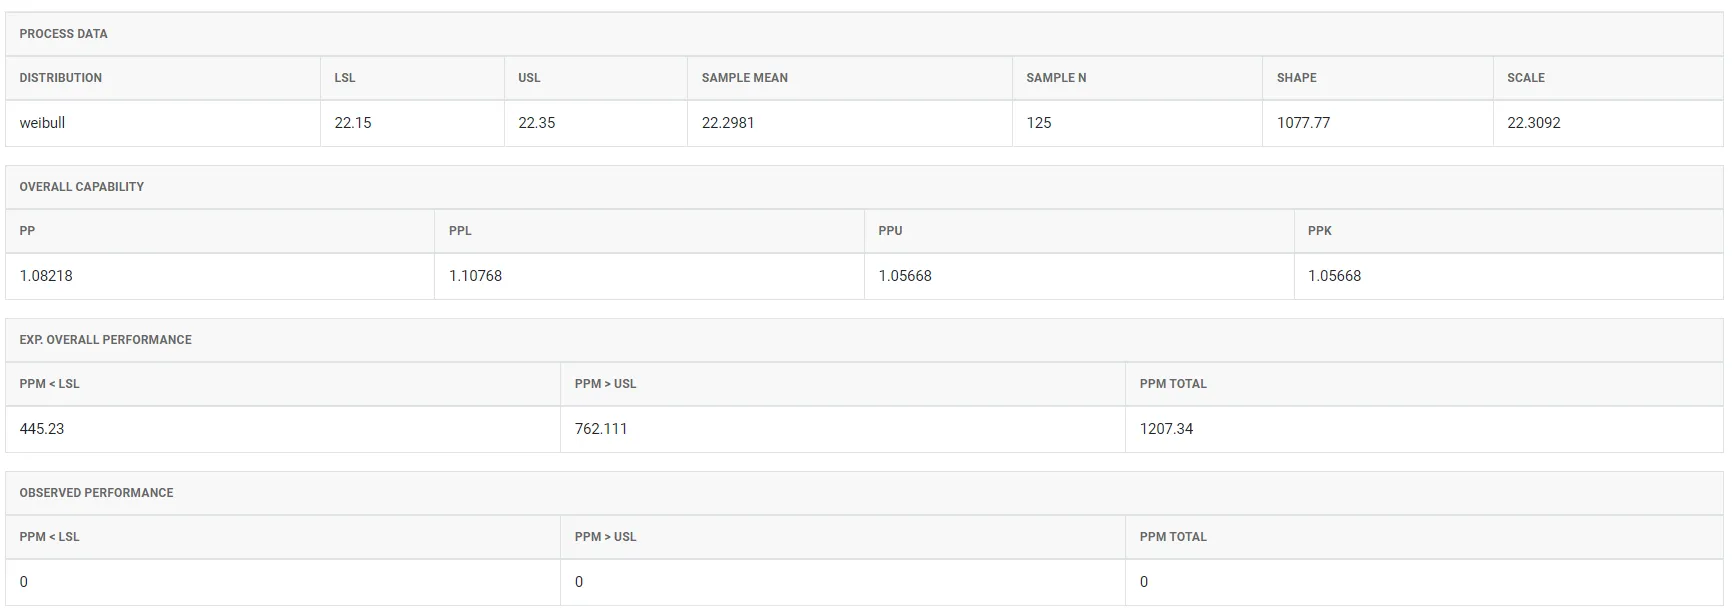
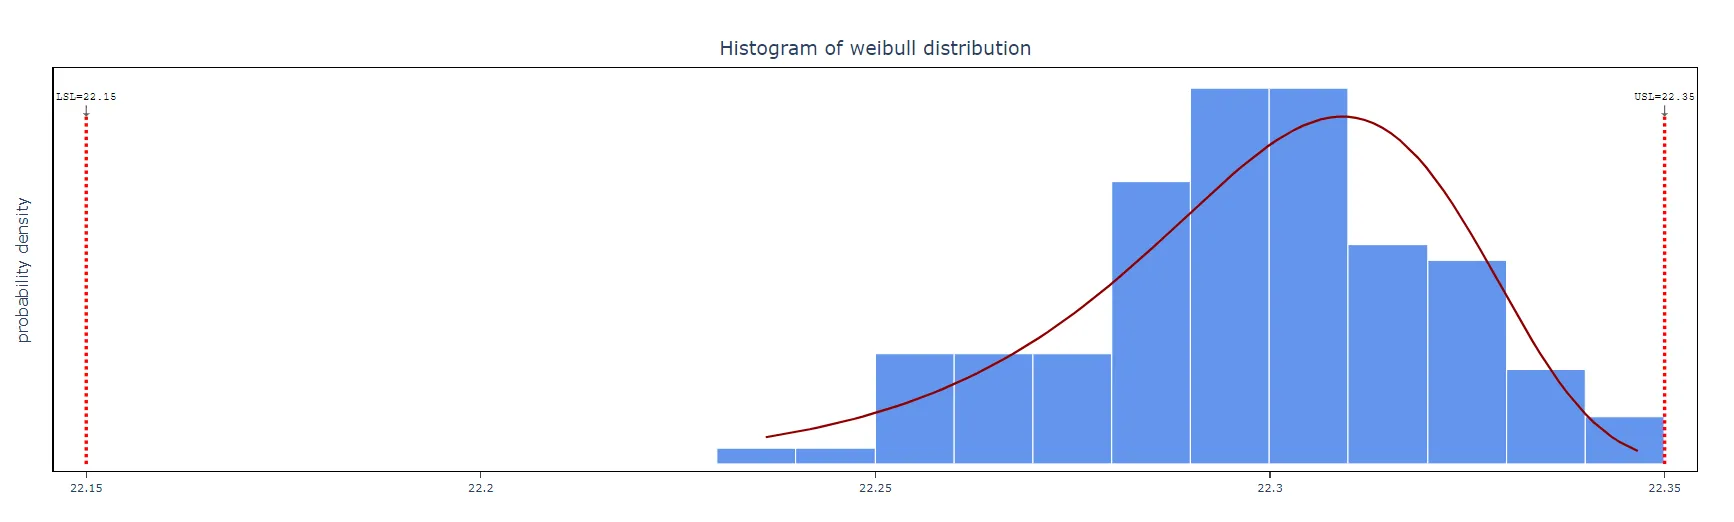
Cómo realizar un análisis de capacidad de proceso no normal
La guía es la siguiente:
- Inicie sesión en Zometric Statistical Software en https://statsai.zometric.com/
- En la página de inicio, elija Statistical Tool> Process Capability >Non-Normal Process Capability.
- Haga clic en Non Normal Process Capability para acceder al tablero.
- A continuación, introduzca los datos manualmente o copie todos los datos (Ctrl+C) de una hoja de Excel y péguelos (Ctrl+V).
- A continuación, debe seleccionar la distribución que se ajustará, introducir LSL y USL y elegir el método de análisis.
- Por último, haga clic en calculate en la parte inferior de la página para obtener los resultados deseados.
En el tablero de la capacidad de proceso no normal, la ventana está dividida en dos partes.
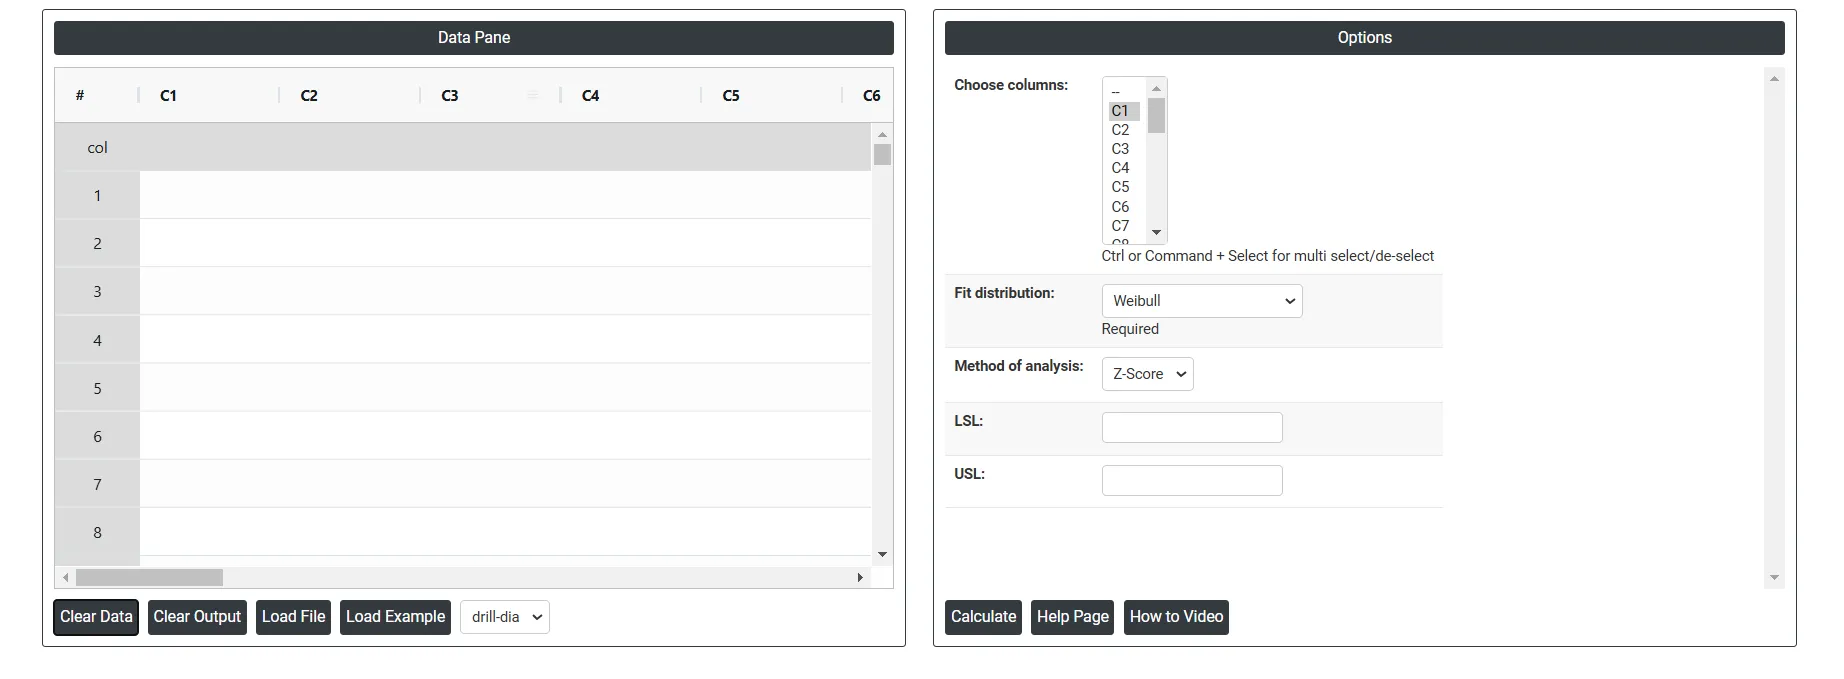
En la parte izquierda se encuentra el panel de datos (Data Pane). En el Data Pane, cada fila forma un subgrupo. Los datos pueden introducirse manualmente o copiarse por completo (Ctrl+C) de una hoja de Excel y pegarse (Ctrl+V) aquí.
Load example: Se cargarán los datos de ejemplo.
Load File: Se usa para cargar directamente los datos de Excel.
En la parte derecha hay numerosas opciones, como las siguientes:
- Fit Distribution:
- Weibull distribution: la distribución de Weibull es un modelo estadístico flexible que se usa en ingeniería, investigación médica, finanzas y climatología, en particular para analizar datos de tiempo hasta el fallo y tratar datos de proceso asimétricos. Se define mediante tres parámetros: forma, escala y umbral. La distribución de Weibull de 3 parámetros incluye los tres, mientras que la versión de 2 parámetros, que excluye el umbral, se usa solo para valores positivos. El parámetro de forma afecta a la asimetría de la distribución, el parámetro de escala indica el punto en el que se espera que falle el 63.2 % de la población y el parámetro de umbral desplaza la distribución a lo largo del eje del tiempo. Esta distribución es fundamental para predecir fallos, estimar ciclos de vida y comprender patrones de datos complejos. Su versatilidad se extiende también al control de calidad y la gestión de riesgos. Exponential: la distribución exponencial es una distribución de probabilidad continua que se usa con frecuencia en el análisis de capacidad de proceso con datos no normales, en particular en situaciones como datos de tiempo hasta el fallo con una tasa de fallos constante y tiempos entre llegadas de eventos en un proceso de Poisson, en el que los eventos ocurren de forma continua e independiente a una tasa promedio constante. Esta distribución es ideal para modelar el tiempo hasta que ocurre un evento concreto, y su propiedad de falta de memoria la hace muy adecuada para situaciones en las que el pasado no influye en el futuro, lo que permite analizar con precisión datos asimétricos que no siguen una distribución normal. Logistic: la distribución logística desempeña un papel importante en el análisis de capacidad de proceso no normal, especialmente cuando los datos son simétricos pero no tienen distribución normal. La distribución logística tiene una forma similar a la de la distribución normal, pero con colas más pesadas, lo que significa que asigna más probabilidad a los valores extremos. Esta característica la hace útil en ciertos análisis de capacidad de proceso en los que los datos tienden a tener valores atípicos o una dispersión mayor que la que admitiría la distribución normal. Loglogistic: la distribución loglogística se usa para datos positivos con asimetría a la derecha cuyo logaritmo sigue una distribución logística. Es similar a la distribución lognormal, pero con colas más pesadas, lo que la hace adecuada para procesos en los que los valores grandes son más probables de lo que predeciría una distribución lognormal. Largest Extreme Value: la distribución de valor extremo máximo es esencial en el análisis de capacidad de proceso no normal cuando se trabaja con datos centrados en valores máximos o con distribuciones asimétricas a la derecha. Garantiza que los valores extremos se modelen con precisión, lo que da lugar a evaluaciones de capacidad más fiables y a decisiones mejor fundamentadas sobre el desempeño y los riesgos del proceso. Smallest Extreme Value: la distribución de valor extremo mínimo (SEV) desempeña un papel crítico en el análisis de capacidad de proceso no normal, especialmente cuando los datos son asimétricos y no se ajustan a la distribución normal. La distribución SEV es particularmente útil para modelar los valores mínimos de un conjunto de datos, como el menor tiempo hasta el fallo o el eslabón más débil de una cadena de eventos. 2-Parameter Exponential: la distribución exponencial de 2 parámetros se define mediante un parámetro de escala (λ) y un parámetro de umbral (θ). El parámetro de umbral desplaza la distribución θ unidades hacia la derecha, lo que indica un tiempo de espera mínimo antes de que puedan ocurrir los eventos. El parámetro de escala controla la tasa a la que ocurren los eventos después del umbral. 3- Parameter Weibull: la distribución de Weibull de 3 parámetros se define mediante un parámetro de forma (β), un parámetro de escala (η) y un parámetro de umbral (γ). El parámetro de forma (β) determina el comportamiento de la tasa de fallos, el parámetro de escala (η) indica la vida característica y el parámetro de umbral (γ) desplaza la distribución, lo que representa el tiempo mínimo antes de que comiencen los fallos. Esta distribución se usa para modelar datos de vida con un período de espera inicial antes de que puedan ocurrir los eventos, lo que añade flexibilidad para un ajuste de datos más preciso. Gamma: la distribución gamma es una distribución de probabilidad continua caracterizada por un parámetro de forma (k o α) y un parámetro de escala (θ). Se usa principalmente para modelar el tiempo de espera hasta que ocurre un número especificado de eventos, lo que la hace ideal para procesos que implican tiempos acumulados o datos asimétricos. Lognormal: la distribución lognormal es una distribución de probabilidad continua en la que el logaritmo de la variable aleatoria tiene distribución normal. Se caracteriza por su asimetría positiva y se define mediante la media (μ) y la desviación estándar (σ) de la distribución normal subyacente. De uso habitual en finanzas, ciencias de la vida y análisis de fiabilidad, modela datos que deben permanecer positivos y presentar crecimiento multiplicativo o comportamiento asimétrico a la derecha.
- LSL: Es el valor mínimo aceptable de una medición del proceso. Cualquier valor por debajo de este límite indica que el producto o el proceso no cumple las normas de calidad y se considera defectuoso.
- USL: Es el valor máximo aceptable de una medición del proceso. Cualquier valor por encima de este límite también indica que el producto o el proceso está fuera de especificación y no cumple los requisitos de calidad.
- Method of Analysis:
- Z-Score: el método de puntuación Z usa la distribución ajustada para hallar la probabilidad de quedar más allá de cada límite de especificación y la convierte en un valor Z normal estándar equivalente. Los índices de capacidad se calculan después a partir de estos valores Z (cada índice unilateral es igual a Z dividido entre 3), de modo que son comparables a los índices usados para datos normales. El método ayuda a identificar problemas de desempeño y permite tomar decisiones basadas en datos para mejorar la calidad.
Use este método cuando:
- Los datos no siguen una distribución normal, lo que es habitual en muchos procesos reales.
- Necesita un enfoque más flexible que pueda admitir distintas distribuciones (p. ej., exponencial, lognormal).
- Desea calcular índices de capacidad del proceso (Cp, Cpk) estandarizados en términos de cuántas desviaciones estándar hay entre la media del proceso y los límites de especificación.
Ventajas:
- El método de puntuación Z ofrece una comprensión más clara del desempeño del proceso respecto de los límites de especificación al expresar la capacidad en desviaciones estándar.
- Permite comparar mejor distintos procesos o características, incluso cuando los datos no son normales.
- ISO: el método ISO sigue la norma ISO 22514 para el análisis de capacidad no normal. Calcula los índices de capacidad directamente a partir de percentiles de la distribución ajustada: los percentiles 0.135 y 99.865, que corresponden a ±3 desviaciones estándar en una distribución normal, y la mediana como centro del proceso. Este método se prefiere cuando se exige el cumplimiento de normas internacionales de calidad.
- Download as Excel: Muestra el resultado en formato Excel, que puede editarse fácilmente y volver a cargarse para los cálculos mediante la opción load file.
Preguntas frecuentes
¿Qué es la capacidad de proceso no normal?
La capacidad de proceso no normal evalúa la capacidad de un proceso de producir salida dentro de los límites de especificación cuando los datos no siguen una distribución normal. Al ajustar un modelo de distribución no normal adecuado, evalúa el desempeño global del proceso y predice el porcentaje de salida que probablemente caerá fuera del rango aceptable.
¿Cuándo debe usarse el análisis de capacidad no normal?
Úselo cuando los datos continuos sean asimétricos, no simétricos o procedan de un proceso que produce de forma natural datos no normales, como el desgaste con el tiempo o los procesos con límites inherentes. Investigue primero los valores atípicos y separe los datos con más de un pico en sus flujos de proceso, como distintas máquinas o lotes, antes de evaluar la capacidad. Para datos de atributos, use el análisis de Capacidad Binomial o de Capacidad de Poisson.
¿Cuántos datos se necesitan para la capacidad de proceso no normal?
Recopile al menos 100 puntos de datos para obtener estimaciones de capacidad fiables. El proceso debe ser estable y estar bajo control antes del análisis, y los datos deben seguir de cerca la distribución seleccionada. Si no está seguro de qué distribución se ajusta, use primero la Identificación de Distribución Individual.
¿Cuál es la diferencia entre los métodos de puntuación Z e ISO para la capacidad no normal?
El método de puntuación Z usa la distribución ajustada para hallar la probabilidad más allá de cada límite de especificación y la convierte en un valor Z normal estándar equivalente; cada índice unilateral es igual a Z dividido entre 3, de modo que los índices son comparables a los de datos normales. El método ISO sigue la norma ISO 22514 y calcula los índices a partir de los percentiles 0.135 y 99.865 de la distribución ajustada, con la mediana como centro del proceso.