
Capacidad del proceso no normal
El análisis de capacidad del proceso no normal mide qué tan bien un proceso cumple sus límites de especificación cuando los datos subyacentes no siguen una distribución normal (en forma de campana). En lugar de imponer el supuesto de normalidad a datos asimétricos o inusuales, este análisis ajusta a los datos una distribución no normal reconocida, como Weibull, lognormal, exponencial o gamma, y luego calcula los índices de capacidad según la forma real de esa distribución.
Última revisión:
Idea clave
El análisis de capacidad del proceso no normal mide qué tan bien un proceso cumple sus límites de especificación cuando los datos subyacentes no siguen una distribución normal (en forma de campana).
En esta página
- ¿Qué es la capacidad del proceso no normal?
- ¿Cuándo usar la capacidad del proceso no normal?
- Pautas para el uso correcto de la capacidad del proceso no normal
- Alternativas: cuándo no usar la capacidad del proceso no normal
- Ejemplo de capacidad del proceso no normal
- Cómo realizar un análisis de capacidad del proceso no normal
¿Qué es la capacidad del proceso no normal?
El análisis de capacidad del proceso no normal mide qué tan bien un proceso cumple sus límites de especificación cuando los datos subyacentes no siguen una distribución normal (en forma de campana). En lugar de imponer el supuesto de normalidad a datos asimétricos o inusuales, este análisis ajusta a los datos una distribución no normal reconocida, como Weibull, lognormal, exponencial o gamma, y luego calcula los índices de capacidad según la forma real de esa distribución.
Los índices de capacidad estándar, como Cp y Cpk, suponen normalidad. Cuando ese supuesto se incumple, esos índices dejan de ser exactos y pueden sobrestimar o subestimar la verdadera capacidad del proceso. La capacidad no normal lo resuelve usando el modelo de distribución correcto, lo que da una imagen mucho más honesta y precisa de si el proceso puede entregar de forma consistente producto dentro de especificación.
Definición sencilla: un análisis de capacidad diseñado para datos asimétricos o no normales: ajusta la distribución adecuada a sus datos y luego calcula los índices de capacidad según esa forma real, en lugar de imponer un supuesto de normalidad incorrecto.
¿Cuándo usar la capacidad del proceso no normal?
- Úsela cuando los datos de su proceso son continuos pero no superan una prueba de normalidad; por ejemplo, tiempos de ciclo, mediciones de resistencia o concentraciones químicas con fuerte asimetría.
- Úsela cuando una gráfica de probabilidad o una prueba de normalidad confirma que sus datos siguen una distribución no normal específica, como Weibull, lognormal, exponencial o gamma.
- Úsela cuando aplicar una transformación de Box-Cox o de Johnson no es apropiado o práctico; por ejemplo, cuando los datos transformados son difíciles de interpretar en las unidades originales.
- Úsela cuando la herramienta de identificación de distribución individual ha confirmado la distribución que mejor se ajusta a sus datos.
Pautas para el uso correcto de la capacidad del proceso no normal
- Ejecute siempre primero la identificación de distribución individual (Individual Distribution Identification) para determinar la distribución que mejor se ajusta antes de seleccionarla en este análisis: elegir una distribución incorrecta producirá índices de capacidad engañosos.
- Recopile al menos 100 datos para que el ajuste de la distribución produzca estimaciones de los parámetros fiables y estables.
- Asegúrese de que el proceso sea estable y esté bajo control estadístico antes de ejecutar el análisis de capacidad: un proceso inestable producirá cifras de capacidad sin sentido, sea cual sea la distribución utilizada.
- No use este análisis con datos de atributos o de conteo : use en su lugar la capacidad binomial o de Poisson.
- Verifique la distribución elegida mediante estadísticos de bondad de ajuste y gráficas de probabilidad : un valor p alto y una línea recta en la gráfica de probabilidad confirman un buen ajuste.
- Los índices de capacidad como Pp, Ppk, Cp y Cpk se informan a partir de los percentiles de la distribución ajustada y no de múltiplos de la desviación estándar; interprételos en consecuencia.
Alternativas: cuándo no usar la capacidad del proceso no normal
- Situación
Use en su lugar
Los datos siguen una distribución normal
Análisis de capacidad normal (estándar)
Los datos pueden transformarse a normalidad
Análisis de capacidad con transformación de Box-Cox o de Johnson
La distribución es desconocida o poco clara
Capacidad del proceso no paramétrica
Los datos son de aprobado/rechazado o recuentos de defectuosos
Análisis de capacidad binomial
Los datos son recuentos de eventos (defectos por unidad)
Análisis de capacidad de Poisson
Se necesita un informe gráfico y estadístico combinado
Capability Six Pack (entre/dentro de subgrupos)
Ejemplo de capacidad del proceso no normal
Un fabricante de componentes automotrices está desarrollando un componente crítico para un cliente OEM. Para asegurar la calidad, un ingeniero comprueba si una máquina taladradora puede cumplir las especificaciones. La pieza debe estar dentro de un rango: LSL (límite inferior de especificación) de 22.15 y USL (límite superior de especificación) de 22.35. El ingeniero toma 125 muestras de la máquina y realiza un estudio de capacidad de máquina. Los pasos son los siguientes:
- Se reunieron los datos necesarios.
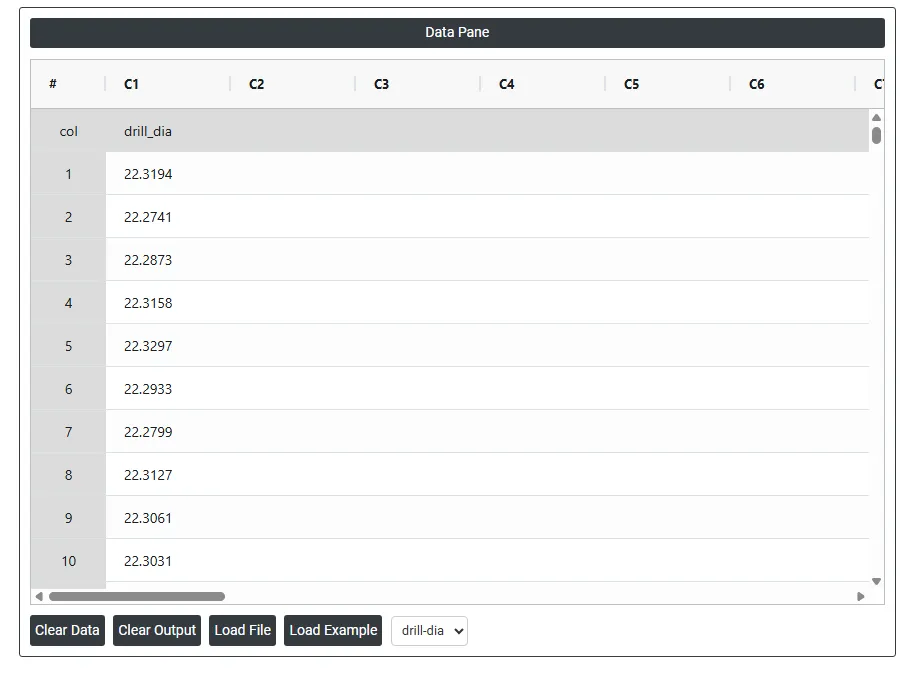
- Ahora analice los datos en Zometric Statistical Software en https://statsai.zometric.com/.
- Para encontrar Non-Normal Process Capability, elija Statistical module> Control Chart>Non-Normal Process Capability.
- Dentro de la herramienta, introduzca los datos junto con las demás entradas de la siguiente manera:
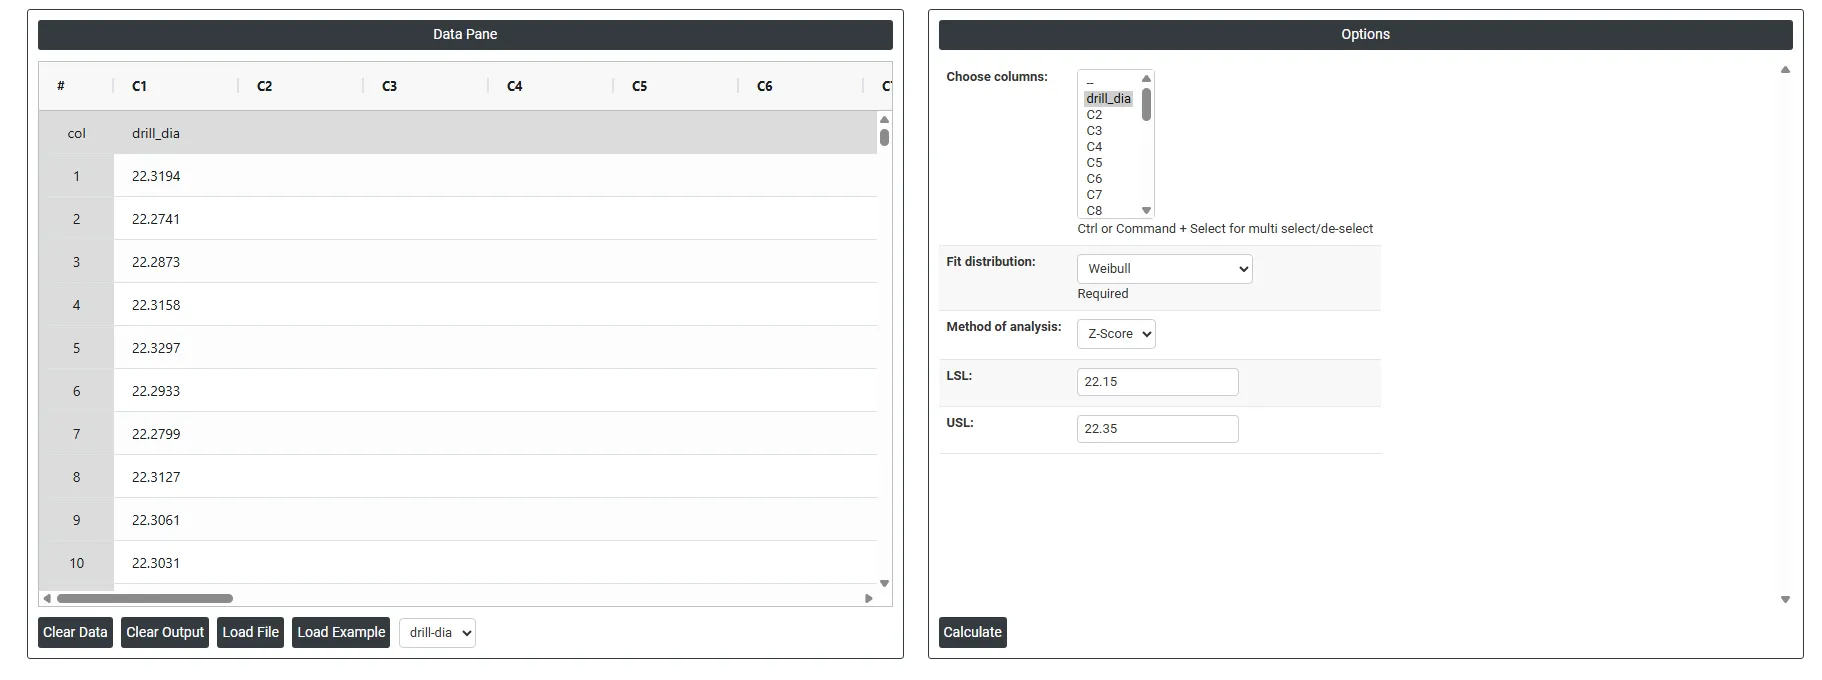
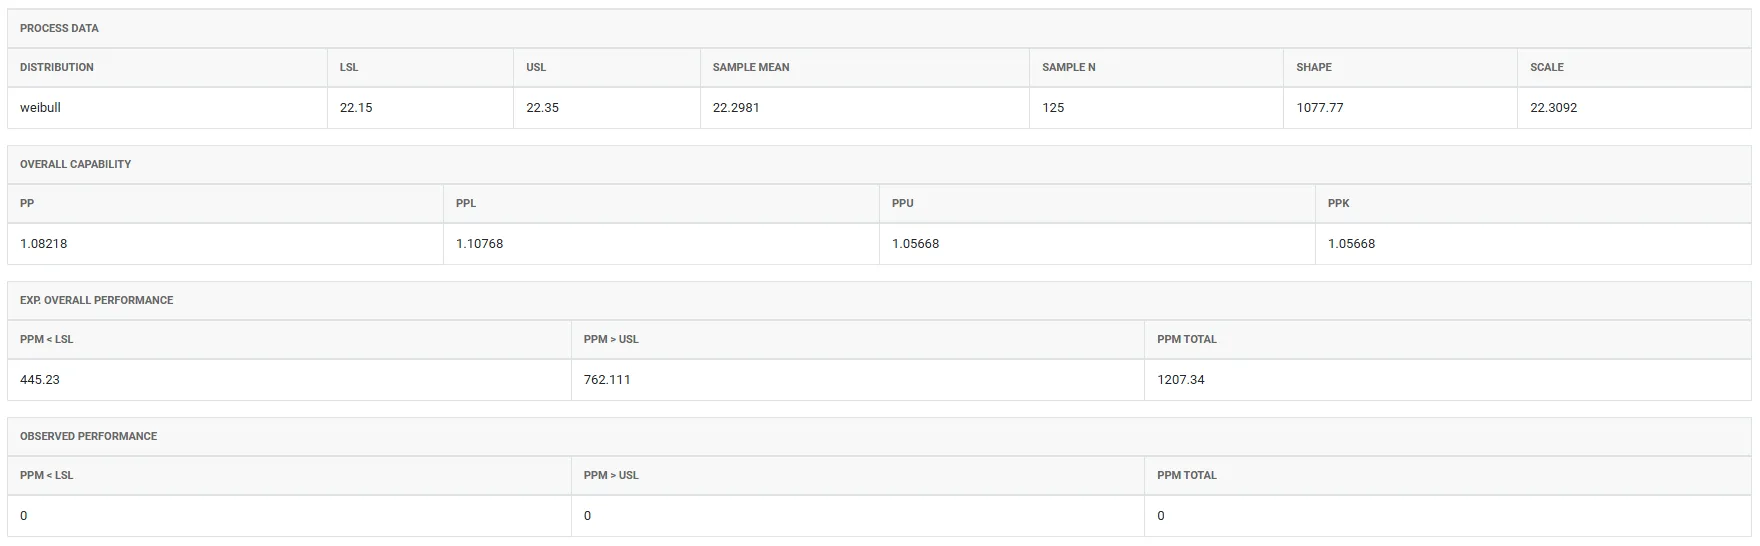
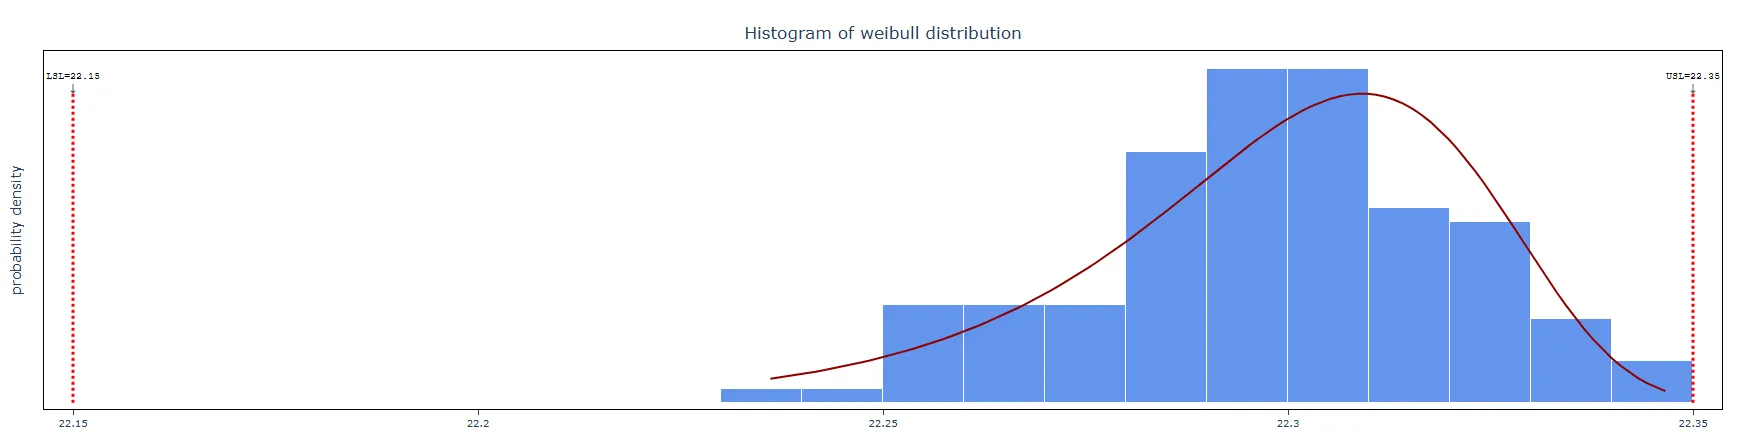
5. Después de usar la herramienta mencionada, se obtiene la siguiente salida:
Cómo realizar un análisis de capacidad del proceso no normal
La guía es la siguiente:
- Inicie sesión en Zometric Statistical Software en https://statsai.zometric.com/
- En la página de inicio, elija Statistical Tool> Control Chart>Non-Normal Process Capability .
- A continuación, introduzca los datos manualmente o copie todos los datos (Ctrl+C) de una hoja de Excel y péguelos (Ctrl+V).
- Complete las opciones requeridas.
- Por último, haga clic en calculate en la parte inferior de la página para obtener los resultados deseados.
En el tablero de Non-Normal Process Capability, la ventana está dividida en dos partes.
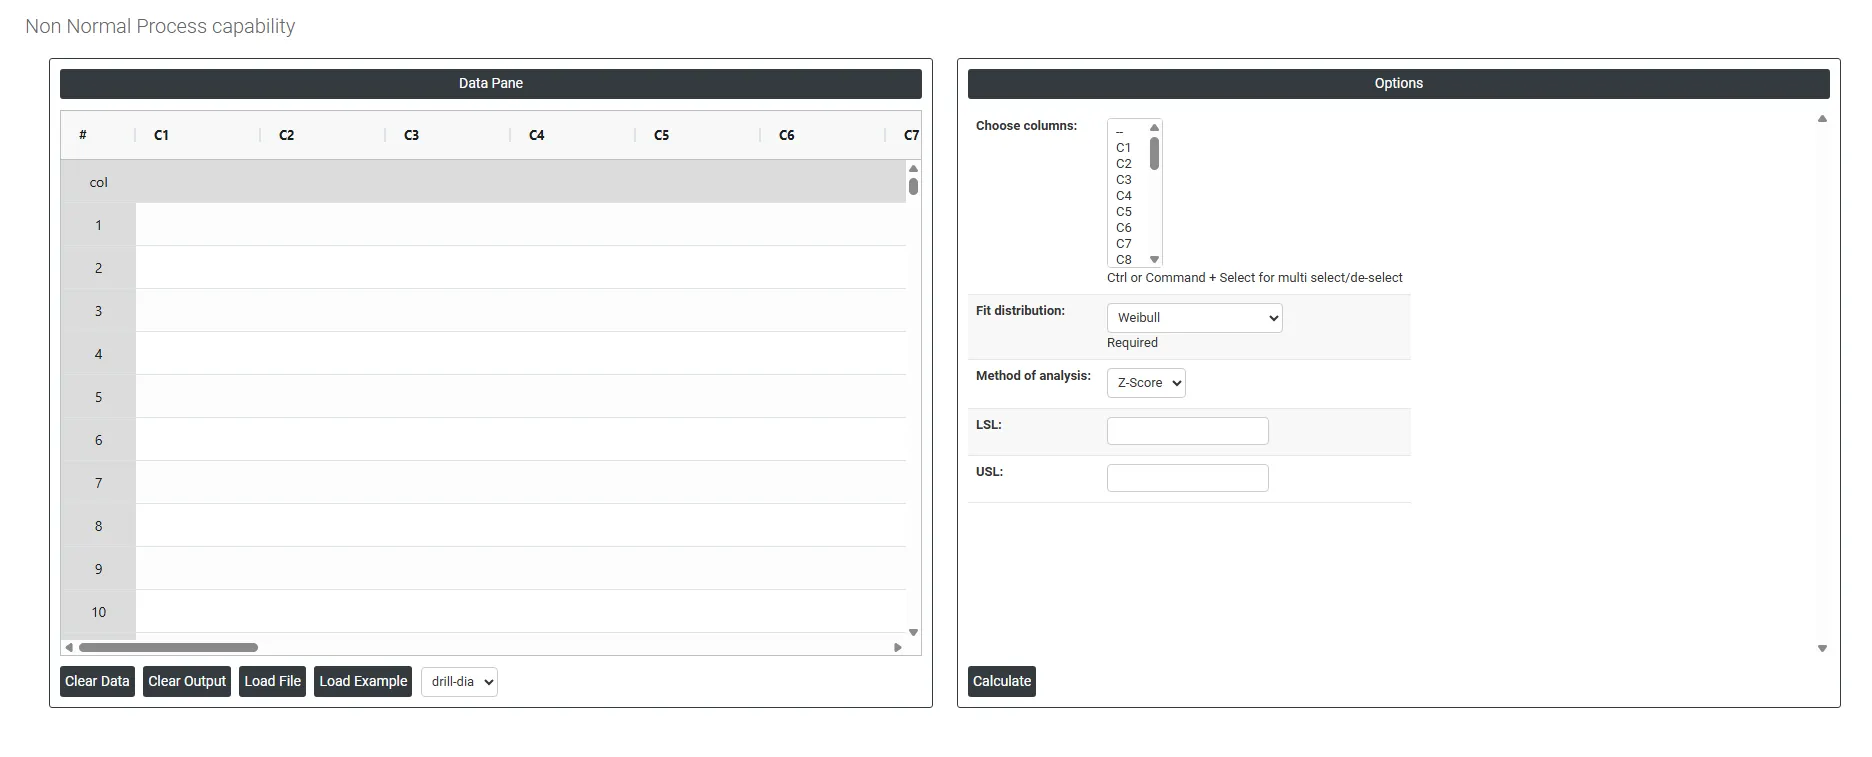
En la parte izquierda se encuentra el panel de datos (Data Pane). En el Data Pane, cada fila forma un subgrupo. Los datos pueden introducirse manualmente o copiarse por completo (Ctrl+C) de una hoja de Excel y pegarse (Ctrl+V) aquí.
Load example: Se cargarán los datos de ejemplo.
Load File: Se usa para cargar directamente los datos de Excel.
En la parte derecha hay varias opciones, como las siguientes:
- Choose Columns Seleccione la(s) columna(s) que contienen sus datos de medición continuos. Use Ctrl o Command + clic para seleccionar varias columnas a la vez. Son las mediciones reales del proceso, como diámetros de taladrado, resistencias a la tracción o tiempos de ciclo, que se analizarán para determinar su capacidad respecto a los límites de especificación con la distribución no normal seleccionada.
- Fit Distribution Seleccione la distribución que mejor describa la forma de sus datos. Este es el ajuste más crítico del análisis: los índices de capacidad se calculan a partir de las propiedades matemáticas de la distribución elegida, por lo que seleccionar la incorrecta producirá resultados inexactos. Ejecute siempre primero la identificación de distribución individual (Individual Distribution Identification) para confirmar qué distribución se ajusta a sus datos antes de hacer esta selección. Las opciones disponibles y sus casos de uso típicos son:
- Weibull — se usa habitualmente para datos de fiabilidad, vida a fatiga y tiempos hasta el fallo. Maneja bien los datos con asimetría a la derecha y es una de las distribuciones no normales más flexibles y de mayor aplicación.
- Exponential — se usa para datos que representan el tiempo entre eventos aleatorios independientes, como el tiempo entre fallos de máquina o entre llegadas de llamadas de servicio. Supone una tasa de fallos constante.
- Logistic — de forma similar a la distribución normal, pero con colas más pesadas. Se usa cuando los datos son simétricos pero tienen más valores extremos de los que predeciría la normalidad.
- Loglogistic — una distribución con asimetría a la derecha que se usa para datos de supervivencia y fiabilidad, similar a la lognormal pero con colas más pesadas. Adecuada para datos de tiempo hasta el fallo o de tipo ingresos.
- Largest Extreme Value — modela la distribución del valor máximo de una muestra. Se usa cuando los datos representan mediciones máximas, como el esfuerzo máximo, los niveles de inundación o las temperaturas más altas.
- Smallest Extreme Value — modela la distribución del valor mínimo de una muestra. Se usa habitualmente para la resistencia mínima o las mediciones observadas más pequeñas.
- 2-Parameter Exponential — una extensión de la distribución exponencial estándar que incluye un parámetro de umbral, lo que permite que la distribución comience en un valor distinto de cero. Útil cuando las mediciones no pueden estar por debajo de cierto valor mínimo.
- 3-Parameter Weibull — añade un parámetro de ubicación (umbral) a la Weibull estándar, lo que permite que la distribución comience en un punto distinto de cero. Útil cuando no puede haber fallos ni mediciones por debajo de un valor mínimo conocido.
- Gamma — una distribución flexible con asimetría a la derecha que se aplica habitualmente a tiempos de proceso, tiempos de espera, cantidades de lluvia y otras mediciones continuas positivas con asimetría moderada.
- Lognormal — se usa cuando el logaritmo de los datos sigue una distribución normal. Habitual en concentraciones químicas, tamaños de partícula, tiempos de reparación y datos financieros en los que los valores son estrictamente positivos y con asimetría a la derecha.
- Method of Analysis Determina cómo se interpretan y se informan los estadísticos de capacidad y los límites de especificación. Hay dos opciones disponibles:
- Z-Score — calcula la capacidad convirtiendo los límites de especificación en puntuaciones Z estandarizadas basadas en los percentiles de la distribución ajustada. Esto expresa la capacidad en términos de cuántas desviaciones estándar están los límites de especificación del centro del proceso, lo que hace comparables los resultados con los índices de capacidad normal estándar, como Cp y Cpk.
- ISO — sigue la metodología de la norma ISO 22514 para el análisis de capacidad no normal. Este método calcula los índices de capacidad directamente a partir de los percentiles de la distribución (en concreto, los percentiles 0.135 y 99.865, que corresponden a los límites de ±3 sigma de una distribución normal), sin convertir a puntuaciones Z. Es el método preferido cuando se exige el cumplimiento de normas internacionales de calidad.
- LSL (Lower Specification Limit) El valor mínimo aceptable de la medición. Cualquier dato que caiga por debajo de este valor se considera fuera de especificación. Introduzca el LSL definido por su plano de ingeniería, el requisito del cliente o la especificación del producto. Debe indicarse al menos un límite de especificación (LSL o USL); pueden introducirse ambos si la medición tiene especificaciones bilaterales.
- USL (Upper Specification Limit) El valor máximo aceptable de la medición. Cualquier dato que supere este valor se considera fuera de especificación. Introduzca el USL de su plano de ingeniería o de la especificación del producto. Si la característica del proceso solo tiene un requisito unilateral (por ejemplo, una resistencia mínima sin límite superior), solo es necesario introducir el límite correspondiente.
Preguntas frecuentes
¿Qué es el análisis de capacidad del proceso no normal?
El análisis de capacidad del proceso no normal mide qué tan bien un proceso cumple sus límites de especificación cuando los datos no siguen una distribución normal. En lugar de imponer un supuesto de normalidad, ajusta una distribución reconocida, como Weibull, lognormal, exponencial o gamma, y calcula los índices de capacidad a partir de la forma real de esa distribución.
¿Por qué no usar los Cp y Cpk estándar con datos no normales?
Los Cp y Cpk estándar suponen normalidad. Cuando los datos son asimétricos o de otro modo no normales, esos índices dejan de ser exactos y pueden sobrestimar o subestimar la verdadera capacidad del proceso. Usar el modelo de distribución correcto da una imagen más honesta y precisa de si el proceso puede entregar de forma consistente producto dentro de especificación.
¿Cómo se elige la distribución adecuada para la capacidad no normal?
Ejecute primero la identificación de distribución individual para encontrar la distribución que mejor se ajusta y luego verifíquela con estadísticos de bondad de ajuste y gráficas de probabilidad; un valor p alto y una línea recta en la gráfica de probabilidad indican un buen ajuste. Elegir una distribución incorrecta produce índices de capacidad engañosos. Si ninguna distribución se ajusta, use la capacidad del proceso no paramétrica.
¿Cuál es la diferencia entre los métodos Z-Score e ISO?
El método Z-Score convierte los límites de especificación en puntuaciones Z estandarizadas basadas en los percentiles de la distribución ajustada, lo que hace comparables los resultados con los Cp y Cpk normales. El método ISO sigue la norma ISO 22514 y calcula los índices directamente a partir de los percentiles 0.135 y 99.865 de la distribución ajustada, y es el preferido cuando se exige el cumplimiento de normas internacionales.