
Regresión no lineal
La regresión no lineal ajusta a una respuesta y un predictor una curva cuyos parámetros no intervienen linealmente. Úsela cuando la física o la química del proceso dicten la forma de la curva. Elija una de siete funciones incorporadas o una definida por el usuario, y proporcione valores iniciales razonables. La salida incluye estimaciones de los parámetros con errores estándar e intervalos de confianza, una gráfica de línea ajustada, una matriz de correlación y una prueba de falta de ajuste.
Última revisión:
Idea clave
La regresión no lineal ajusta una curva cuyos parámetros intervienen de forma no lineal, como una aproximación exponencial a un límite, para estimar parámetros como un valor límite o una constante de velocidad con intervalos de confianza.
En esta página
Propósito
La regresión no lineal ajusta a una respuesta y un predictor una curva cuyos parámetros no intervienen linealmente, como una aproximación exponencial a un límite, una curva de saturación o una curva de crecimiento en forma de S. Úsela cuando la física o la química del proceso le indiquen la forma de la curva y desee estimaciones de sus parámetros, como un valor límite o una constante de velocidad, con intervalos de confianza.
Capacidades principales
- Siete funciones de esperanza incorporadas: decaimiento exponencial, crecimiento exponencial, potencia, logística de 3 parámetros, Michaelis-Menten, Gompertz y cuadrática.
- Función de esperanza definida por el usuario en X con parámetros b1, b2, …, que admite + − * / ^ y exp, log, ln, log10, sqrt, abs, sin, cos, tan, arctan.
- Ajuste por Gauss-Newton, Levenberg-Marquardt o Trust Region Reflective, con sus propios valores iniciales, límite de iteraciones y tolerancia.
- Estimaciones de los parámetros con errores estándar e intervalos de confianza, y su matriz de correlación.
- Gráfica de línea ajustada con bandas de confianza y de predicción opcionales.
- Prueba de falta de ajuste cuando el predictor tiene valores repetidos.
- Columna de ponderaciones opcional y gráficas de residuos.
Métodos estadísticos
La herramienta halla los valores de los parámetros θ que minimizan la suma de cuadrados de los errores SSE = Σ (yᵢ − f(xᵢ, θ))², o Σ wᵢ (yᵢ − f(xᵢ, θ))² con una columna de ponderaciones. Levenberg-Marquardt (predeterminado) y Trust Region Reflective usan los solucionadores de mínimos cuadrados de SciPy; Gauss-Newton usa reducción del paso a la mitad e informa el número de iteraciones. La iteración se detiene cuando el cambio relativo en SSE y en los parámetros cae por debajo de la tolerancia de convergencia. Las filas con un valor faltante en la respuesta, el predictor o las ponderaciones se eliminan.
Los errores estándar provienen de la aproximación lineal en la solución: Cov(θ) = MSE·(JᵀJ)⁻¹, donde J es la matriz de derivadas de f respecto de los parámetros y MSE = SSE / (n − p) para p parámetros; S = √MSE. Los intervalos de confianza son θ ± t(1−α/2, n−p)·SE. La banda de confianza de la curva usa la misma aproximación; la banda de predicción suma MSE para una sola lectura nueva. Estos intervalos son aproximados y dejan de ser fiables si los parámetros están mal determinados, lo que se manifiesta como correlaciones cercanas a ±1 en la matriz de correlación.
Cuando algunos valores del predictor se repiten, la suma de cuadrados del error se divide en error puro (dispersión entre repeticiones) y falta de ajuste, y F = MS lack-of-fit / MS pure error prueba si la curva elegida se ajusta. Los valores iniciales importan: las funciones incorporadas parten de valores predeterminados fijos (por ejemplo, a = 1, b = 1 para Michaelis-Menten), con c en la mediana de X para las curvas logística y de Gompertz; una función definida por el usuario necesita un valor inicial por parámetro. Dé valores cercanos a lo que espera, pues de lo contrario el ajuste puede fallar o hallar un mínimo local deficiente.
Campos y opciones de entrada
Campo | Descripción |
Response (Y) / Predictor (X) | Columnas numéricas; deben ser distintas. Obligatorio. |
Expectation function | Exponential decay y = a·exp(−b·x) (predeterminada), Exponential growth, Power y = a·x^b, Logistic (3-param), Michaelis-Menten y = a·x/(b + x), Gompertz, Quadratic o User-defined expectation function. |
Expectation function (user-defined) | Se muestra para la opción definida por el usuario. Fórmula en X con parámetros b1, b2, …, p. ej., b1 * exp(-b2 * X). |
Weights (optional) | Columna de ponderaciones para mínimos cuadrados ponderados. |
Starting values (space-separated) | Un valor por parámetro, en orden. Opcional para las funciones incorporadas (si se deja en blanco se usan los valores predeterminados), obligatorio para una definida por el usuario. |
Confidence level | Predeterminado 95. |
Fitting algorithm | Gauss-Newton, Levenberg-Marquardt (predeterminado) o Trust Region Reflective. |
Maximum number of iterations / Convergence tolerance | Predeterminados 200 y 1e-05. |
Display confidence interval on fitted curve / Display prediction interval on fitted curve | Añaden las bandas a la gráfica de línea ajustada. Desactivadas de forma predeterminada. |
Histogram of residuals / Normal plot of residuals / Residuals versus fits / Residuals versus order / Four in one | Gráficas de residuos; Four in one dibuja las cuatro juntas. |
Residuals versus the variables | Grafica los residuos frente a una columna elegida. |
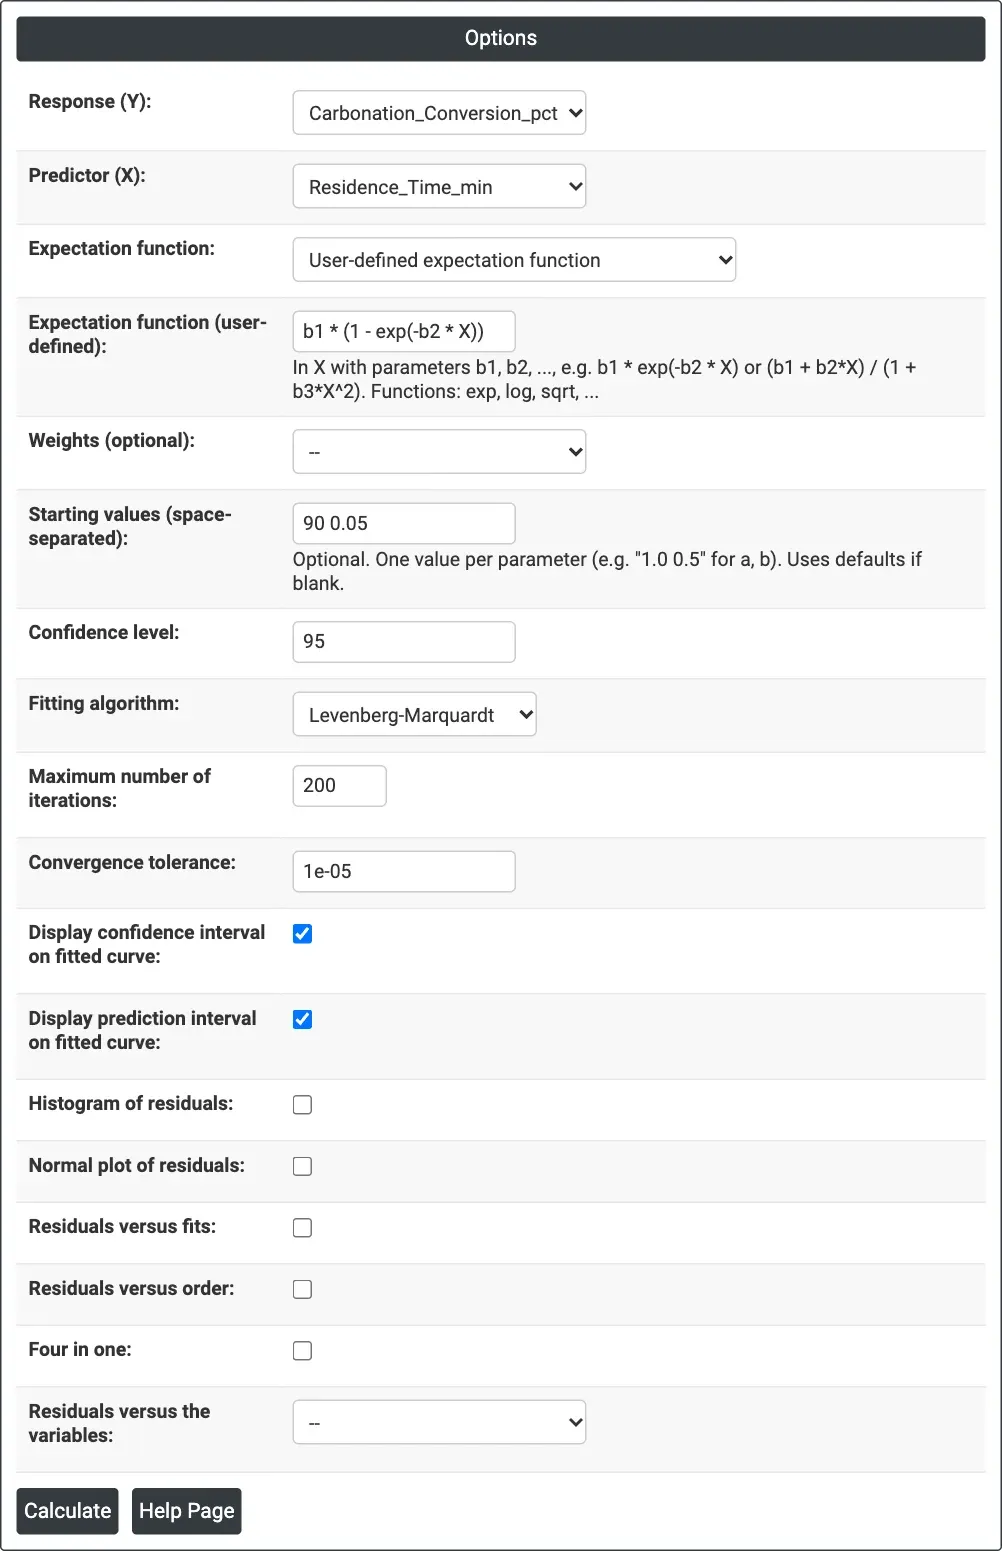
Figura 1 — Opciones del ejemplo de carbonatación: función definida por el usuario b1 * (1 - exp(-b2 * X)) con valores iniciales 90 y 0.05, con las bandas de confianza y de predicción marcadas.
Descripción de la salida
- Method — algoritmo, máximo de iteraciones, tolerancia y, para Gauss-Newton, las iteraciones usadas.
- Starting Values for Parameters — los valores desde los que partió el ajuste.
- Regression Equation — la curva ajustada con los nombres de las columnas.
- Parameter Estimates — Estimate, SE Estimate y límites de confianza de cada parámetro.
- Summary of Fit — Final SSE, DFE, MSE y S.
- Fitted Line Plot — datos, curva ajustada y bandas CI y PI opcionales.
- Correlation Matrix for Parameter Estimates.
- Lack-of-Fit — filas de error, falta de ajuste y error puro con F y P, cuando el predictor tiene valores repetidos.
- Gráficas de residuos, si se seleccionan.
- Exportación a PDF mediante Download.
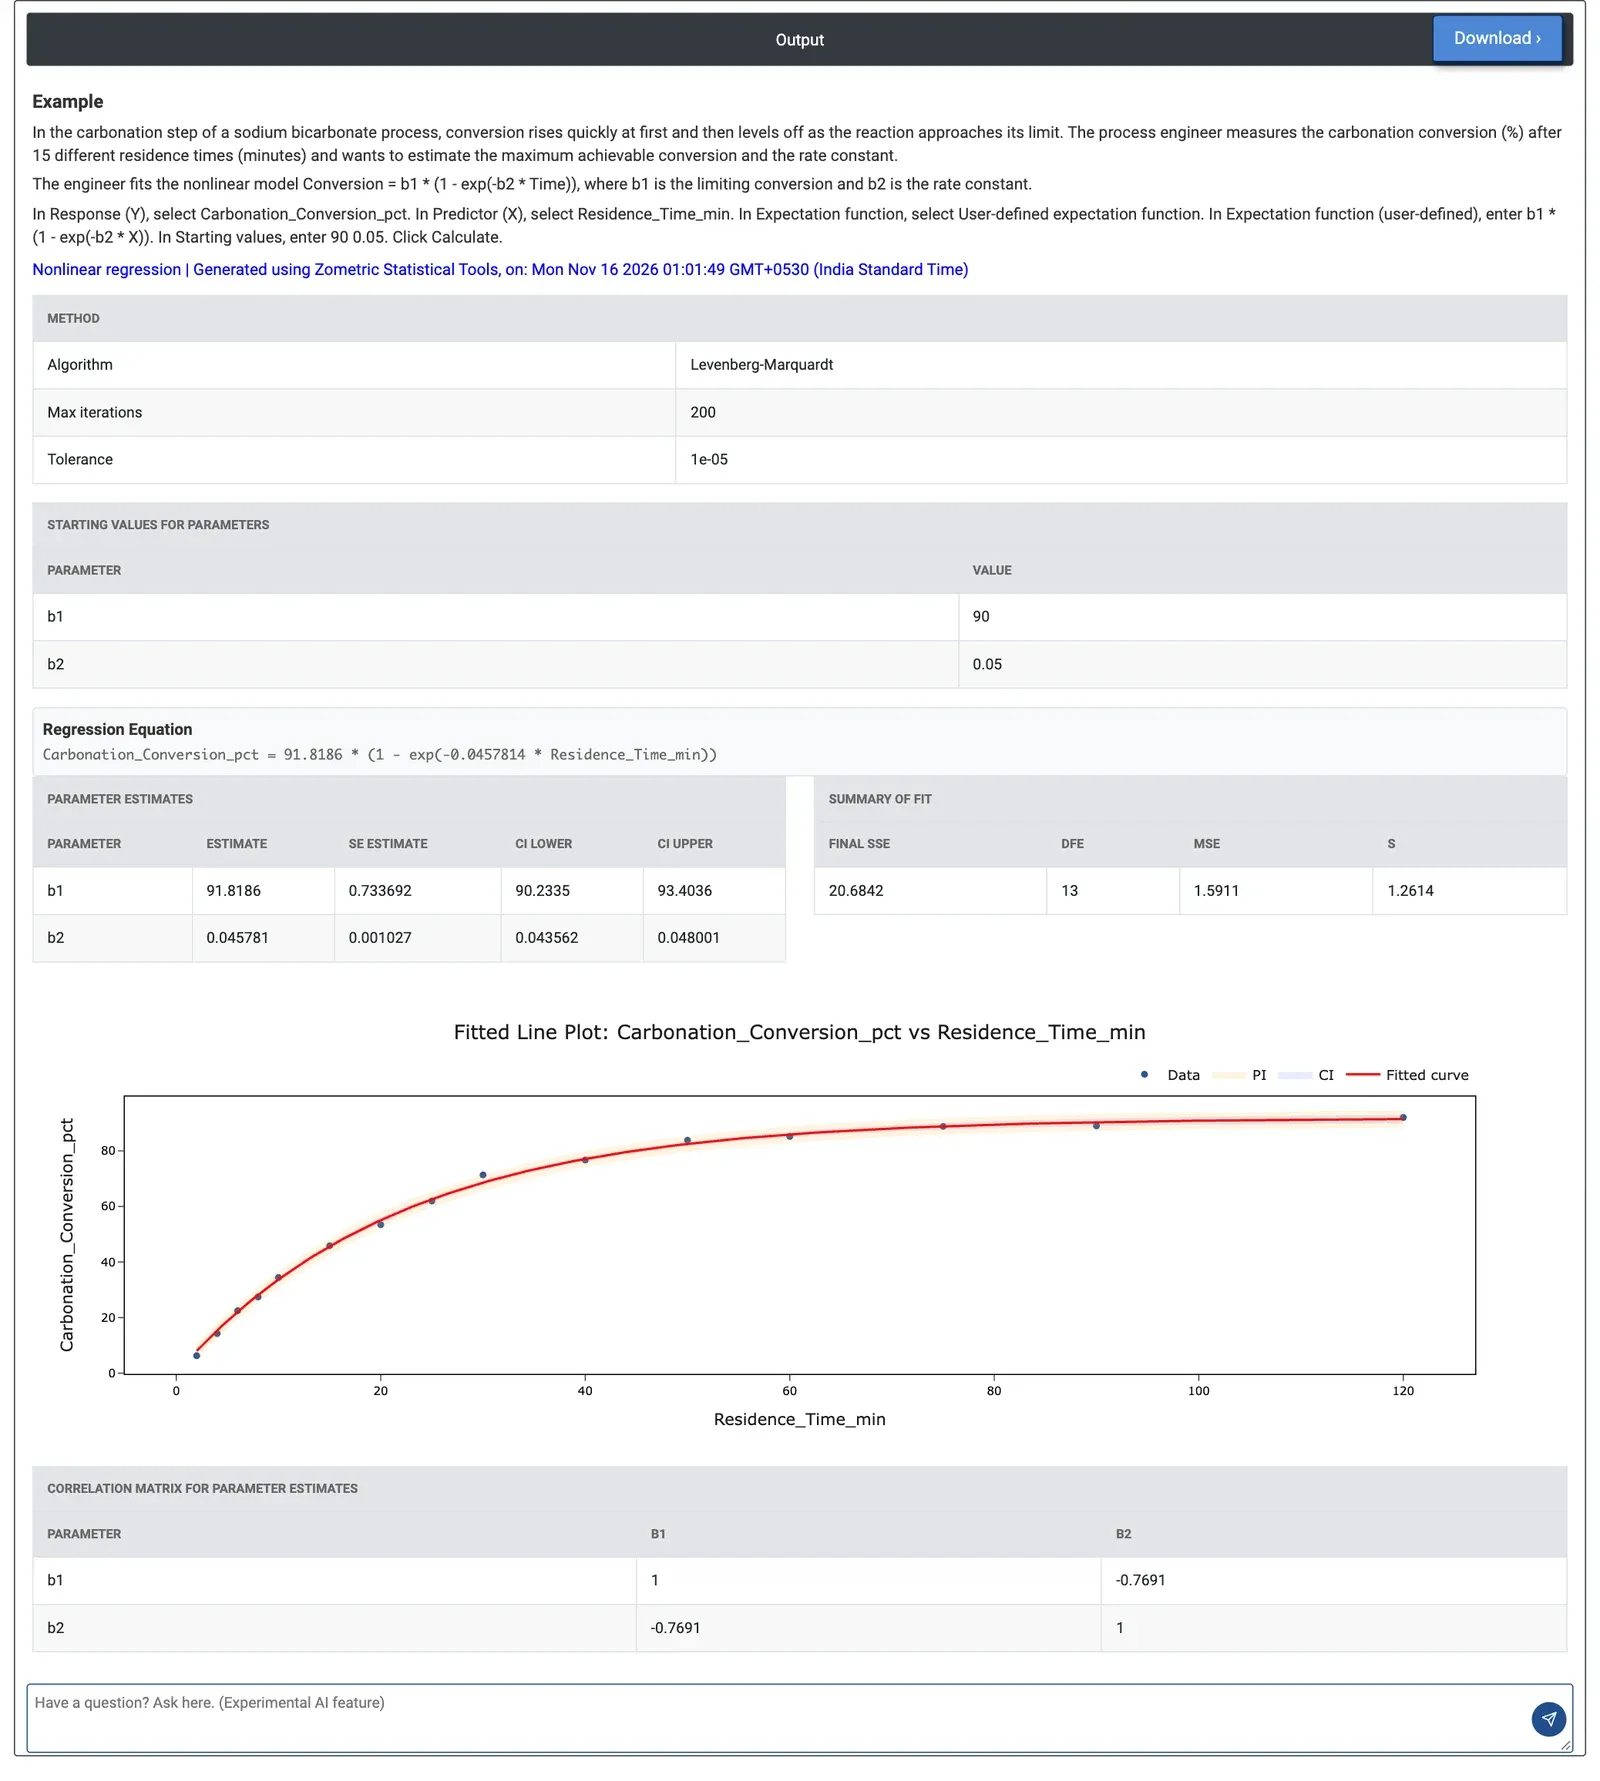
Figura 2 — Conversión de carbonatación frente al tiempo de residencia: conversión límite b1 = 91.82% y constante de velocidad b2 = 0.0458 por minuto, S = 1.26.
Ejemplo
En la etapa de carbonatación de un proceso de bicarbonato de sodio, la conversión sube rápidamente y luego se estabiliza. Un ingeniero de procesos mide la conversión (%) en 15 tiempos de residencia de 2 a 120 minutos y quiere conocer la conversión límite y la constante de velocidad. El ingeniero introduce el modelo de primer orden Conversion = b1·(1 − exp(−b2·Time)) como función definida por el usuario, da los valores iniciales 90 y 0.05 y marca ambas bandas.
El ajuste converge a b1 = 91.82% (IC del 95%: 90.23 a 93.40) y b2 = 0.0458 por minuto (IC del 95%: 0.0436 a 0.0480). S es 1.26 puntos porcentuales, pequeña frente a un rango de 6 a 92%, y los puntos se sitúan sobre la curva en toda su longitud. La correlación entre b1 y b2 es −0.77: moderada, por lo que ambos parámetros están bien determinados. Gauss-Newton da las mismas estimaciones en 3 iteraciones. Al no haber tiempos de residencia repetidos, no se muestra ninguna prueba de falta de ajuste.
A partir de la curva ajustada, el 90% de la conversión límite se alcanza en ln(10)/b2 ≈ 50 minutos y el 95% en unos 65 minutos; a los 30 minutos la conversión es de solo un 69% aproximadamente. Tiempos de residencia muy superiores a una hora aportan poca conversión adicional, lo que ayuda al ingeniero a fijar el caudal de la torre.
Preguntas frecuentes
¿Qué es la regresión no lineal?
La regresión no lineal ajusta a una respuesta y un predictor una curva cuyos parámetros no intervienen linealmente, como una aproximación exponencial a un límite, una curva de saturación o una curva de crecimiento en forma de S. Halla los valores de los parámetros que minimizan la suma de cuadrados de los errores y los informa con errores estándar e intervalos de confianza.
¿Cuándo conviene usar la regresión no lineal?
Use la regresión no lineal cuando la física o la química del proceso le indiquen la forma de la curva y desee estimaciones de sus parámetros, como un valor límite o una constante de velocidad. Las formas incorporadas incluyen decaimiento y crecimiento exponencial, potencia, logística de 3 parámetros, Michaelis-Menten, Gompertz y cuadrática, o puede definir su propia función.
¿Por qué importan los valores iniciales en la regresión no lineal?
El ajuste es iterativo, por lo que parte de valores iniciales. Las funciones incorporadas usan valores predeterminados fijos, mientras que una función definida por el usuario necesita un valor inicial por parámetro. Los valores cercanos a lo que se espera ayudan a que el ajuste converja; unos valores iniciales deficientes pueden hacer que el ajuste falle o se estabilice en un mínimo local deficiente.
¿Cómo saber si el ajuste de una regresión no lineal es fiable?
Revise S y qué tan de cerca siguen los puntos a la curva, y revise las gráficas de residuos. Los intervalos de confianza son aproximados y dejan de ser fiables si los parámetros están mal determinados, lo que se manifiesta como correlaciones cercanas a más o menos 1 en la matriz de correlación de los parámetros. Cuando se repiten valores del predictor, una prueba F de falta de ajuste comprueba si la curva elegida se ajusta.