
Árbol de decisión estadístico de la OCDE
La herramienta OECD Statistical Decision Tree es un sistema guiado de análisis estadístico basado en el marco de decisión para seleccionar y aplicar la prueba estadística correcta a datos experimentales. En lugar de exigir a los usuarios que recorran manualmente una teoría estadística compleja, la herramienta sigue automáticamente la ruta de decisión de la OCDE, evalúa en cada etapa el tipo de datos, la normalidad, la homogeneidad de varianzas y el número de grupos, y aplica la prueba adecuada.
Última revisión:
Idea clave
La herramienta OECD Statistical Decision Tree es un sistema guiado de análisis estadístico basado en el marco de decisión para seleccionar y aplicar la prueba estadística correcta a datos experimentales.
En esta página
¿Qué es OECD?
La herramienta OECD Statistical Decision Tree es un sistema guiado de análisis estadístico basado en el marco de decisión para seleccionar y aplicar la prueba estadística correcta a datos experimentales. En lugar de exigir a los usuarios que recorran manualmente una teoría estadística compleja, la herramienta sigue automáticamente la ruta de decisión de la OCDE, evalúa en cada etapa el tipo de datos, la normalidad, la homogeneidad de varianzas y el número de grupos, y aplica la prueba adecuada.
La herramienta está diseñada para garantizar que las conclusiones estadísticas sean científicamente válidas, totalmente reproducibles y conformes con las directrices reconocidas internacionalmente. Esto es especialmente crítico en toxicología, ciencias ambientales, investigación farmacéutica y estudios para presentaciones regulatorias, donde la elección de la prueba estadística debe estar documentada, justificada y ser defendible en una auditoría.
Definición sencilla: Una herramienta inteligente y automatizada que sigue paso a paso el diagrama de flujo de decisión estadística de la OCDE, evaluando el tipo de datos, la distribución y la estructura de grupos para seleccionar y aplicar automáticamente la prueba estadística correcta, de modo que siempre obtenga un resultado válido y defendible.
¿Cuándo usar OECD?
- El enfoque del diagrama de flujo de la OCDE se usa cuando necesita ejecutar de una sola vez un proceso completo de comparación estadística, en lugar de decidir prueba por prueba sobre la marcha. En vez de detenerse después de cada prueba para averiguar qué sigue, usted introduce de antemano las características de sus datos (tipo de datos, resultado de normalidad, resultado de varianza) y todo el árbol de decisión se resuelve a la vez.
- Es principalmente un marco de comparación : está diseñado específicamente para determinar qué prueba estadística es adecuada al comparar grupos (2 grupos o 3 o más) entre sí o frente a un control. En lugar de decidir prueba por prueba en cada paso, usted introduce de antemano las características de sus datos. Se usa sobre todo en el sector farmacéutico.
La herramienta sigue el diagrama de flujo de la OCDE en una secuencia lógica estricta. Cada paso produce una decisión que determina qué rama de la ruta se sigue a continuación. Comprender este flujo le ayuda a interpretar las salidas de la herramienta y a entender por qué se seleccionó una prueba estadística concreta para sus datos.
Paso 1: evaluación del tipo de datos
El primer punto de decisión determina si sus datos son continuos o discretos/cuantales. Esta distinción condiciona toda la ruta posterior.
Tipo de datos
Descripción y ejemplos
Datos continuos
Valores numéricos medidos que pueden tomar cualquier valor dentro de un rango, como el peso corporal, la actividad enzimática, el peso de órganos, la concentración o parámetros hematológicos. Con datos continuos, la herramienta pasa a una comprobación de normalidad.
Datos discretos o cuantales
Conteos, porcentajes, proporciones, clasificaciones por rangos o resultados categóricos, como el número de animales afectados, la incidencia de una lesión, la presencia o ausencia de una respuesta o puntuaciones de gravedad. La herramienta pasa directamente a la selección de pruebas no paramétricas o categóricas.
Paso 2: comprobación de normalidad (datos continuos)
Con datos continuos, la herramienta comprueba si los datos siguen una distribución normal (en forma de campana) mediante las pruebas de normalidad seleccionadas. El resultado determina qué ruta estadística se sigue.
Si NO se rechaza la normalidad (p ≥ α): los datos son normales:
→ La herramienta continúa por la ruta paramétrica.
→ Las pruebas paramétricas tienen mayor potencia estadística y deben usarse siempre que se confirme la normalidad.
Si SE rechaza la normalidad (p < α): los datos no son normales:
→ Se intenta una transformación de los datos (logaritmo, raíz cuadrada, etc.).
→ Se vuelve a comprobar la normalidad con los datos transformados.
→ Si los datos transformados son normales → se aplican pruebas paramétricas a los datos transformados.
→ Si los datos transformados siguen sin ser normales → la herramienta pasa a la ruta no paramétrica.
Paso 3: ruta paramétrica
Una vez confirmado que los datos son normales (o que se han transformado con éxito a la normalidad), la herramienta determina la prueba paramétrica adecuada según el número de grupos que se comparan.
Comparación de 2 grupos
La herramienta comprueba la homogeneidad de varianzas mediante la prueba F para determinar si los dos grupos tienen varianzas estadísticamente iguales.
Resultado de homogeneidad de varianzas
Prueba estadística aplicada
Varianzas iguales (prueba F no significativa)
Se aplica la prueba t de Student. Es la prueba t de dos muestras estándar, que supone varianzas iguales en ambos grupos.
Varianzas desiguales (prueba F significativa)
Se aplica el método de Satterthwaite (prueba t de Welch). Esta variante no supone varianzas iguales y ajusta los grados de libertad en consecuencia.
Comparación de 3 o más grupos
La herramienta comprueba la homogeneidad de varianzas mediante la prueba de Bartlett, la prueba de Levene o la prueba de Brown-Forsythe.
Resultado de homogeneidad de varianzas
Prueba estadística aplicada
Varianzas iguales (no significativa)
Se aplica el análisis de varianza (ANOVA). → Si el ANOVA es significativo: se realiza la prueba de Dunnett para la comparación por pares de cada grupo de tratamiento con el control. → Si el ANOVA no es significativo: no se requieren más pruebas. Fin.
Varianzas desiguales (significativa)
La herramienta pasa directamente a la prueba adecuada que no supone homogeneidad de varianzas.
Paso 4: ruta no paramétrica
Cuando los datos no pueden normalizarse, o cuando consisten en conteos, porcentajes o rangos, la herramienta sigue la ruta no paramétrica.
Situación de los datos
Prueba aplicada
Resultado / seguimiento
Datos de conteo / porcentaje / rango, ≥ 3 grupos
Prueba de Kruskal-Wallis
Si es significativa → prueba de Dunn (post hoc). Si no es significativa → Fin.
Datos de conteo / porcentaje / rango, 2 grupos
Prueba U de Mann-Whitney
Comparación directa entre dos grupos independientes.
Datos categóricos o de índices
Chi cuadrado
La selección de la prueba depende de la estructura concreta de los datos y del diseño del estudio.
Pautas para el uso correcto de OECD
- Asegúrese de que los datos se introduzcan de forma correcta y coherente: los errores de introducción de datos se propagan por todas las decisiones posteriores del árbol y pueden llevar a aplicar una prueba incorrecta.
- Seleccione con cuidado las columnas de respuesta: si se seleccionan varias respuestas, cada columna debe representar un conjunto de datos de grupo completo e independiente. Si se selecciona una sola respuesta, asegúrese de que la columna de factor identifique de forma correcta y completa la pertenencia de cada observación a su grupo.
- Mantenga activas las dos pruebas de normalidad, Anderson-Darling y Shapiro-Wilk (la opción por defecto). Que dos pruebas independientes confirmen la misma conclusión de normalidad refuerza la defendibilidad científica de la ruta elegida.
Alternativas: cuándo no usar OECD
- Si su estudio no requiere el cumplimiento de las directrices de la OCDE y no tiene contexto regulatorio, use directamente la prueba estadística específica más adecuada: el marco del árbol de decisión de la OCDE añade una carga estructural que puede ser innecesaria para análisis puramente exploratorios o académicos.
- Si su estudio requiere regresión, análisis de correlación o modelado dosis-respuesta en lugar de una simple comparación de grupos, use las herramientas de regresión o de modelado adecuadas: la herramienta OECD está diseñada específicamente para la comparación de medias de grupos, no para ajustar relaciones entre variables continuas.
- Si tiene observaciones pareadas , por ejemplo, mediciones antes y después del mismo sujeto, use la prueba t pareada o la prueba de rangos con signo de Wilcoxon. El árbol de decisión de la OCDE, tal como está implementado aquí, supone grupos independientes.
- Si los datos son de series temporales o longitudinales , es decir, mediciones que evolucionan a lo largo de varios puntos temporales sucesivos, use ANOVA de medidas repetidas, modelos de efectos mixtos o análisis de series temporales
- Si el objetivo analítico principal es la prueba de equivalencia o la evaluación de no inferioridad en lugar de la detección de diferencias, use procedimientos específicos de prueba de equivalencia en lugar del marco estándar de superioridad del árbol de decisión de la OCDE.
Ejemplo de OECD
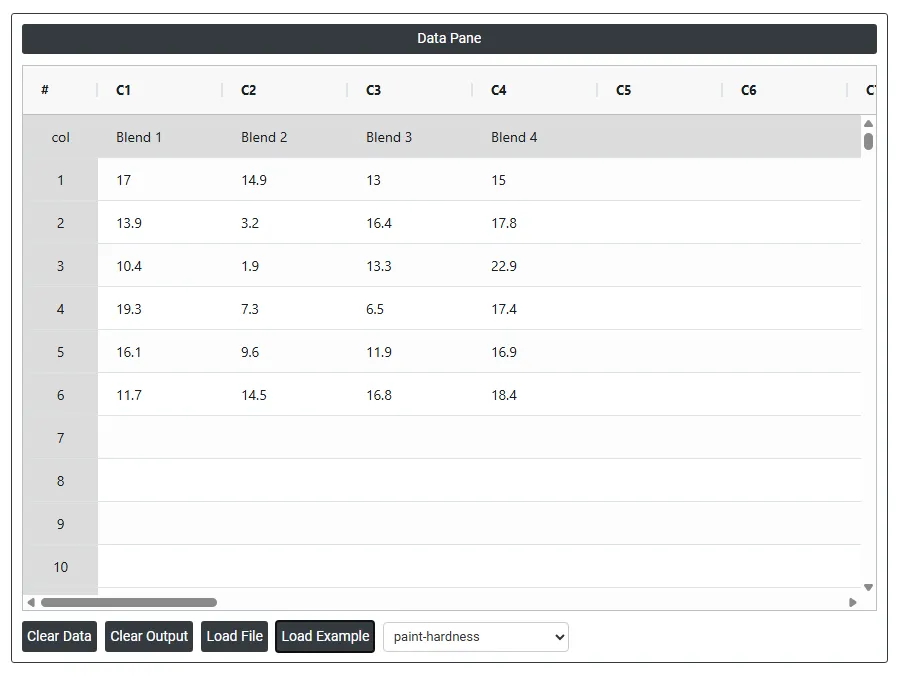
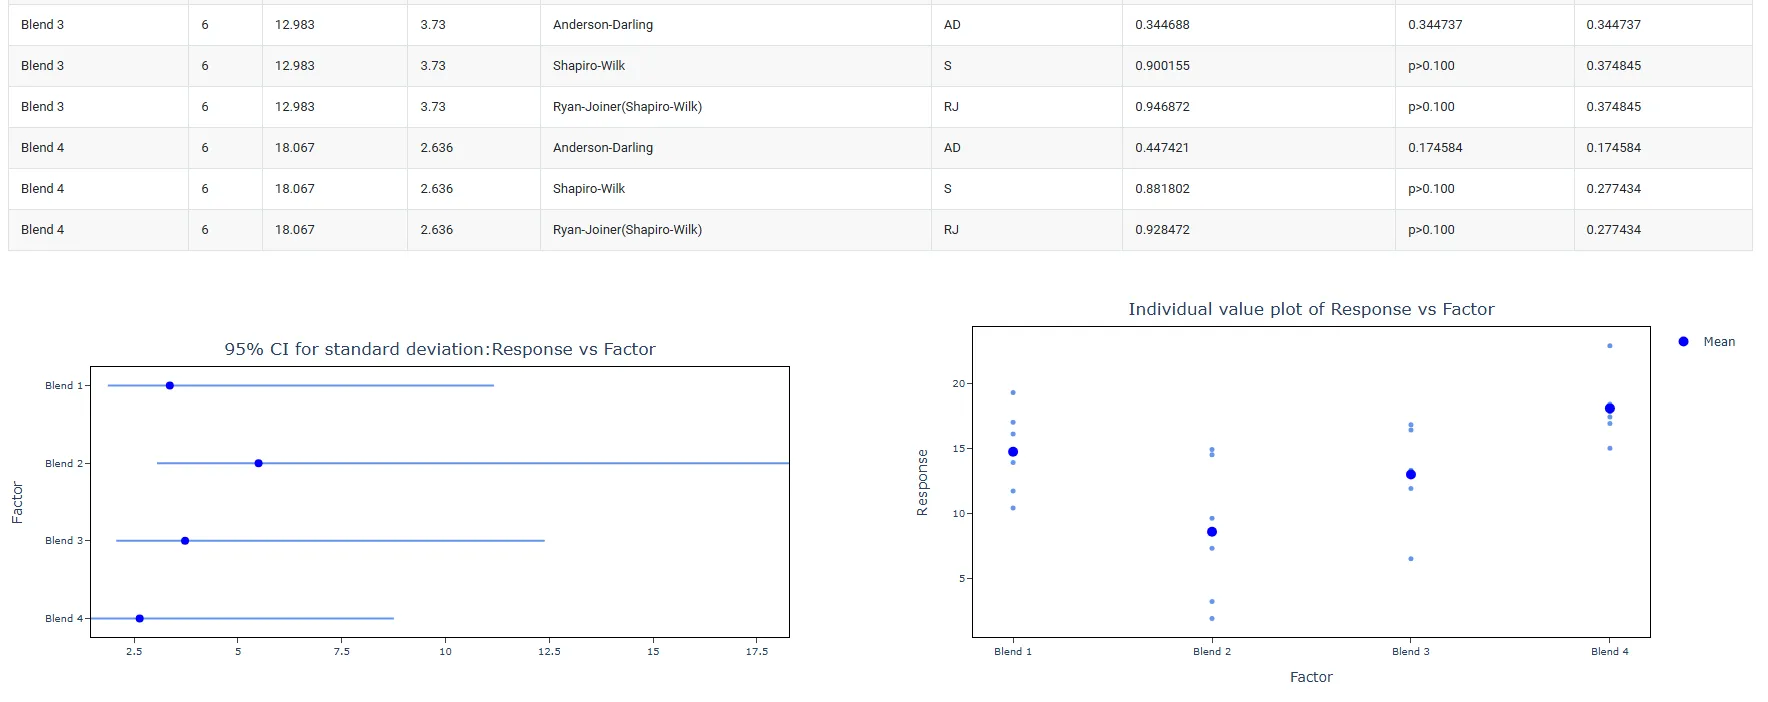
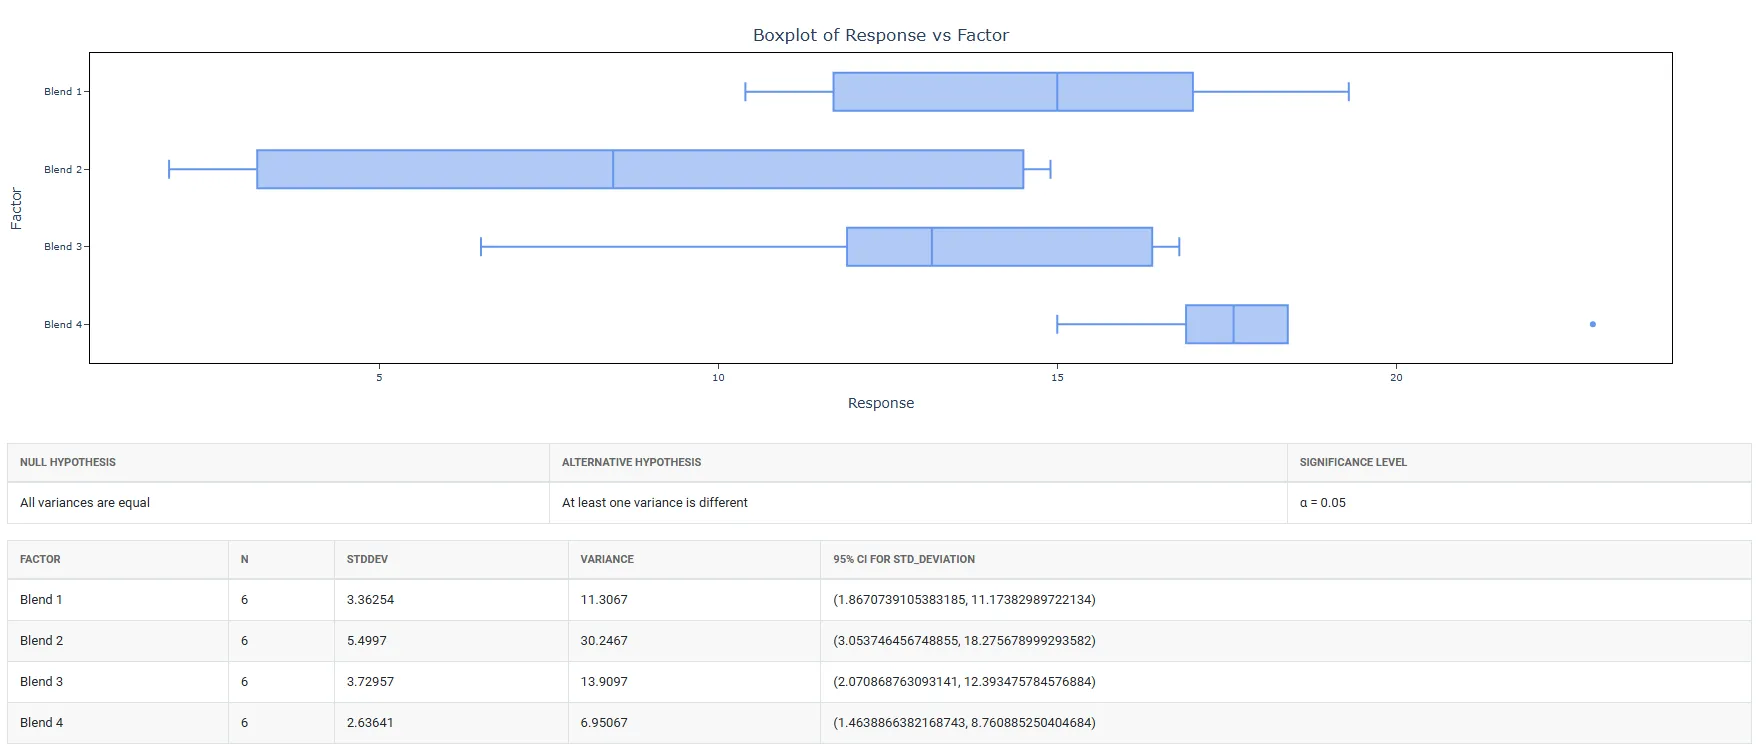
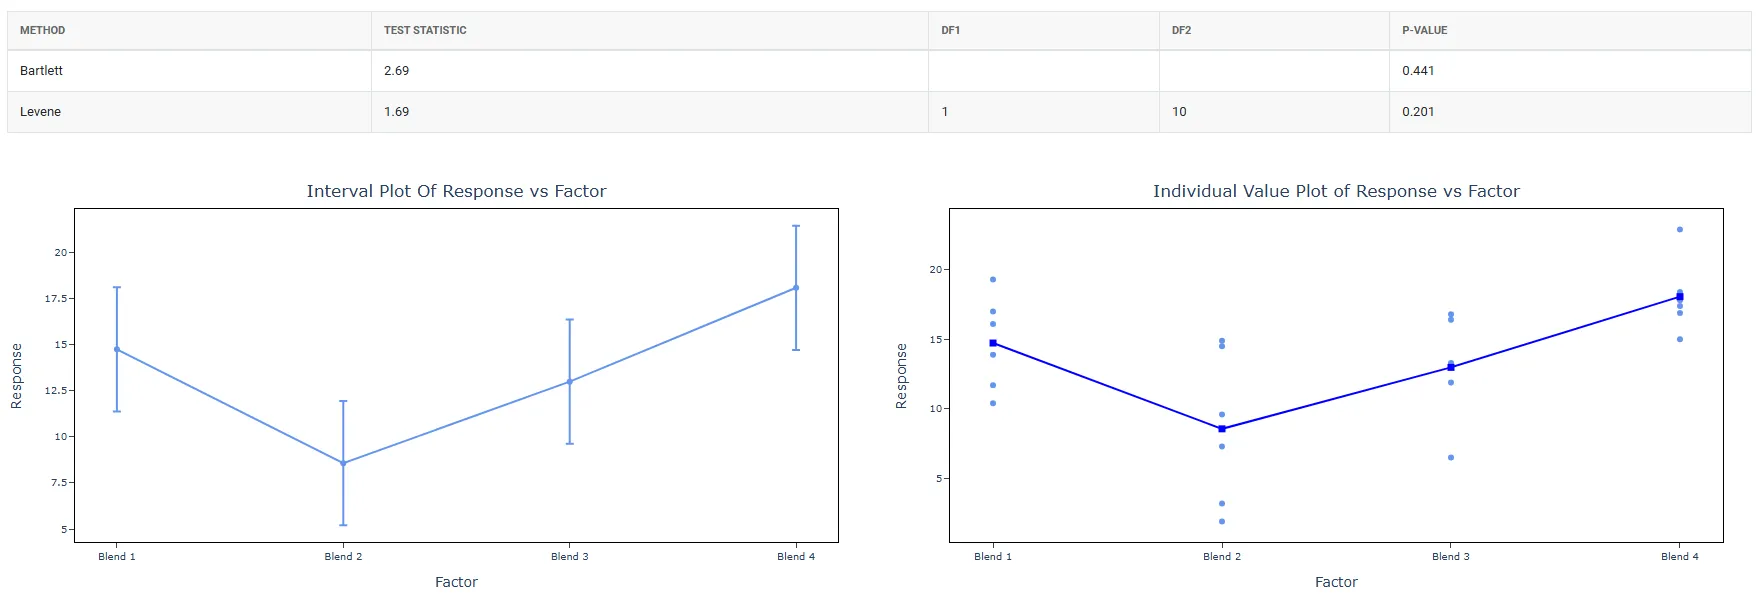
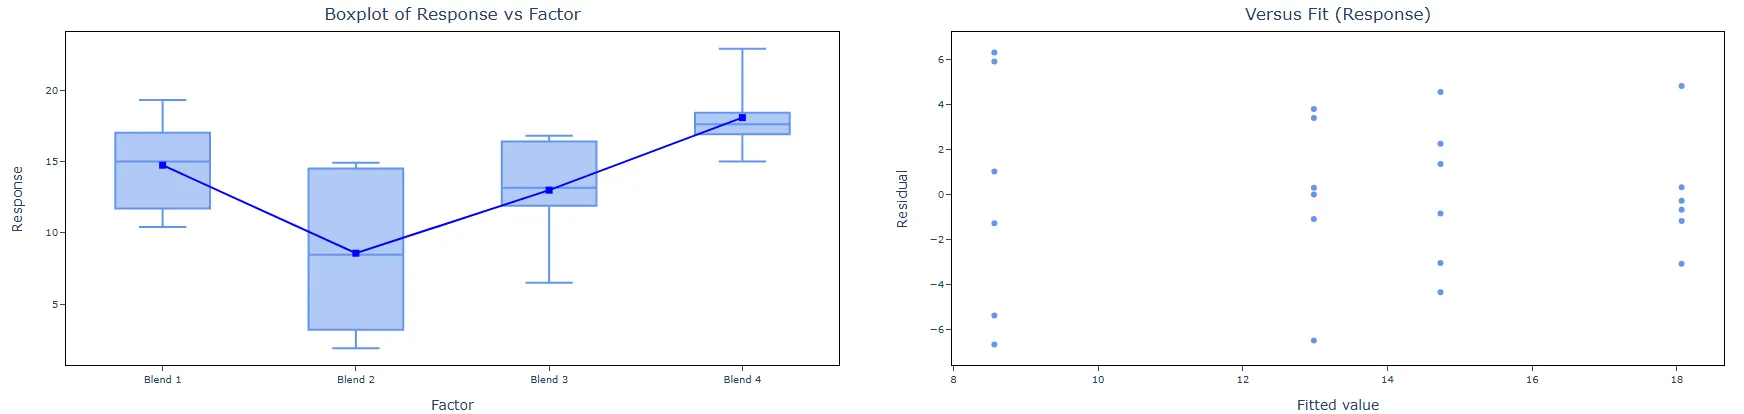
Un ingeniero químico quiere comparar la dureza de cuatro mezclas de pintura. Se aplicaron seis muestras de cada mezcla de pintura a una pieza de metal, que luego se curó. A continuación se midió la dureza de cada muestra. Los pasos son los siguientes:
- Ya dispone de los datos necesarios.
2. Ahora analice los datos en Zometric Statistical Software en https://statsai.zometric.com/.
3. Para encontrar OECD, elija Statistical module> OECD>OECD.
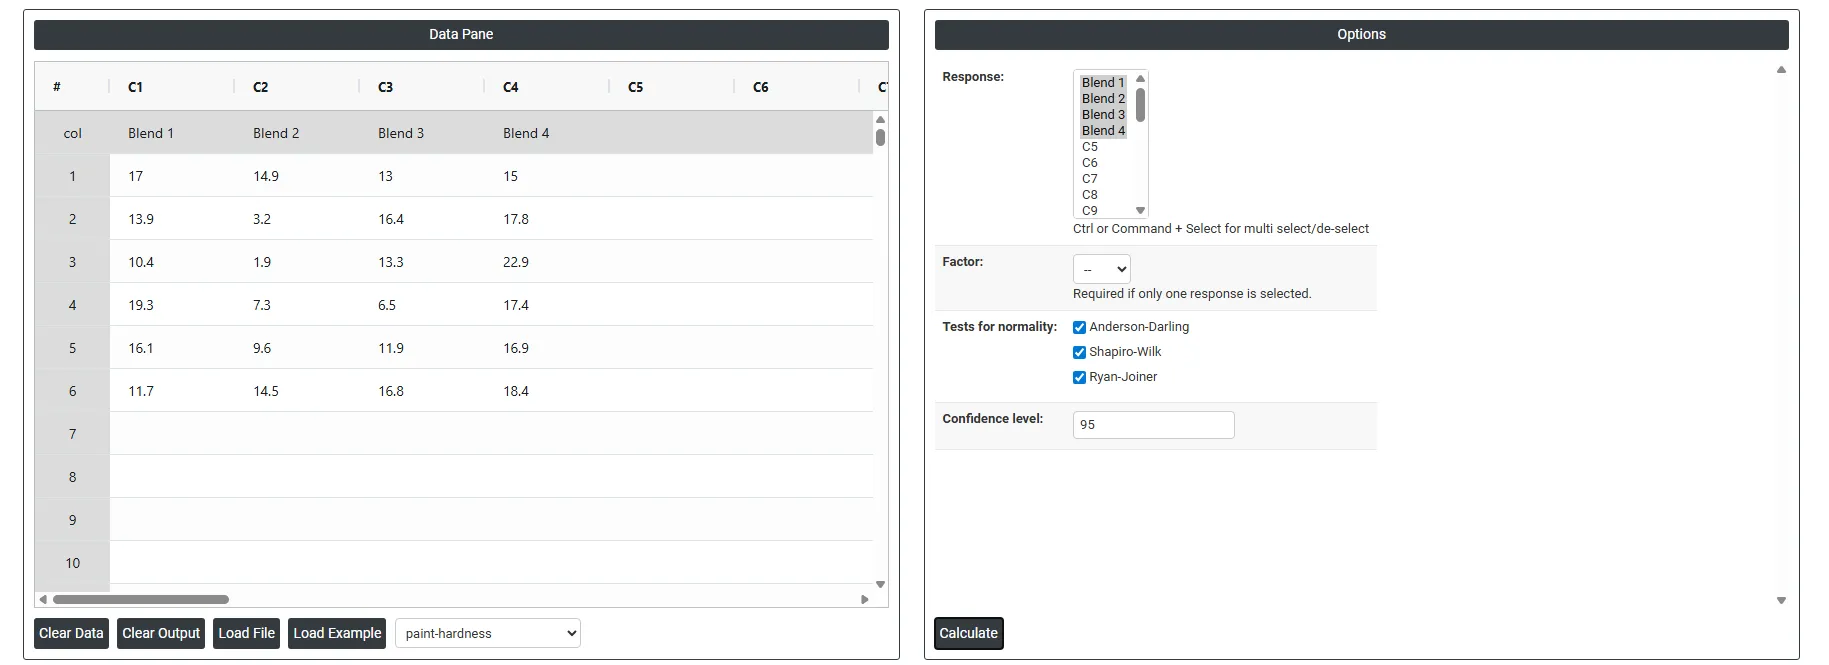
4. Dentro de la herramienta, introduzca los datos junto con las demás entradas de la siguiente manera:
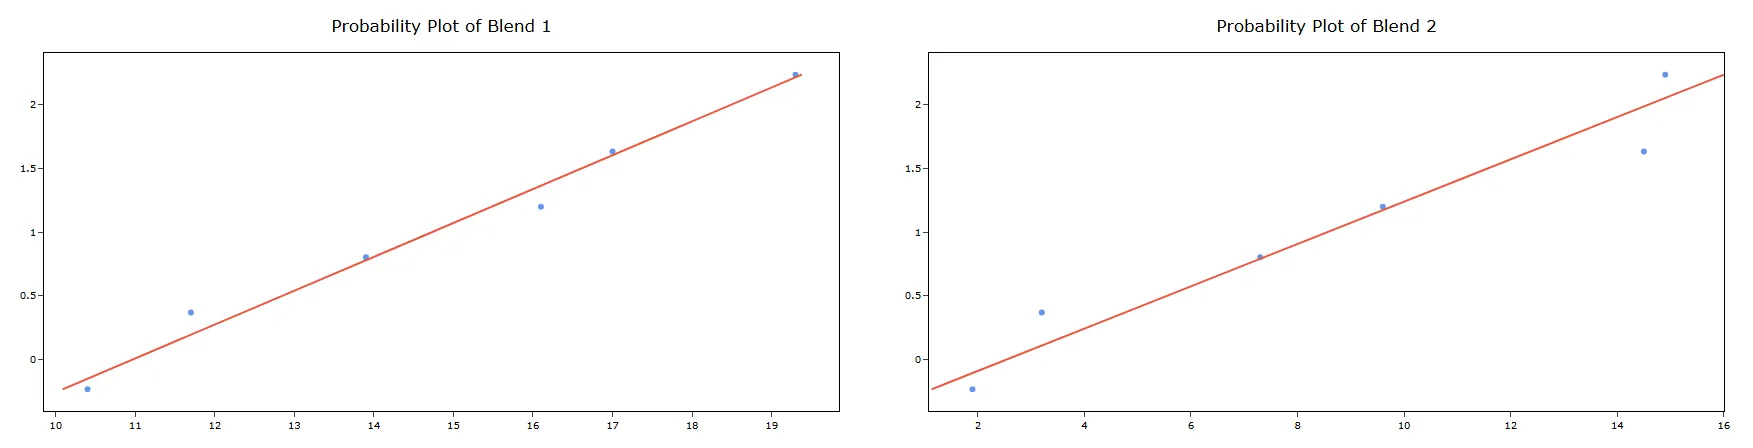
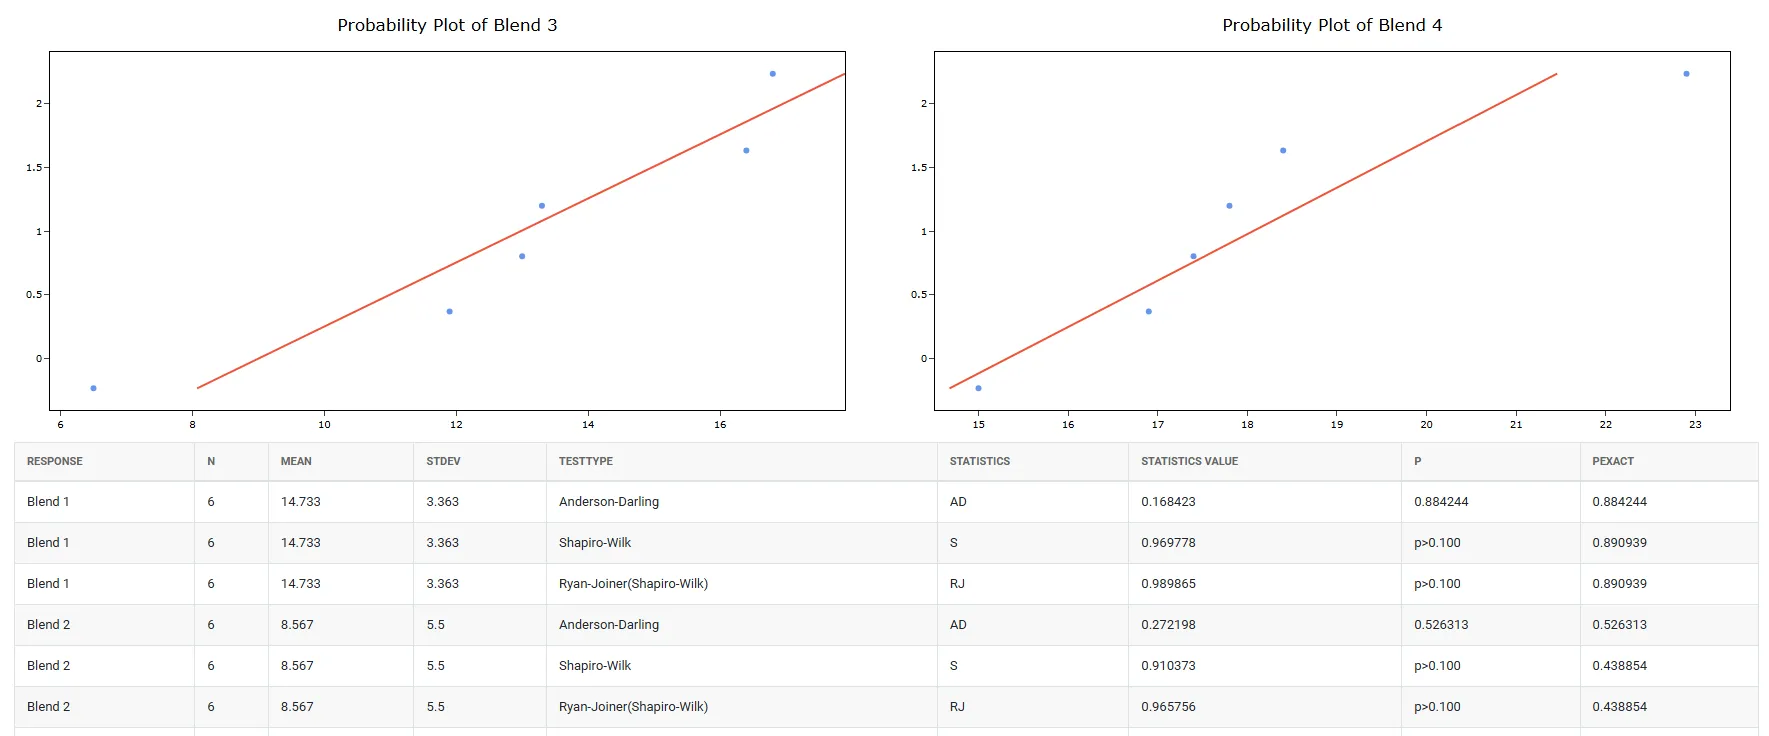
5. Tras usar la herramienta mencionada, se obtiene la siguiente salida:
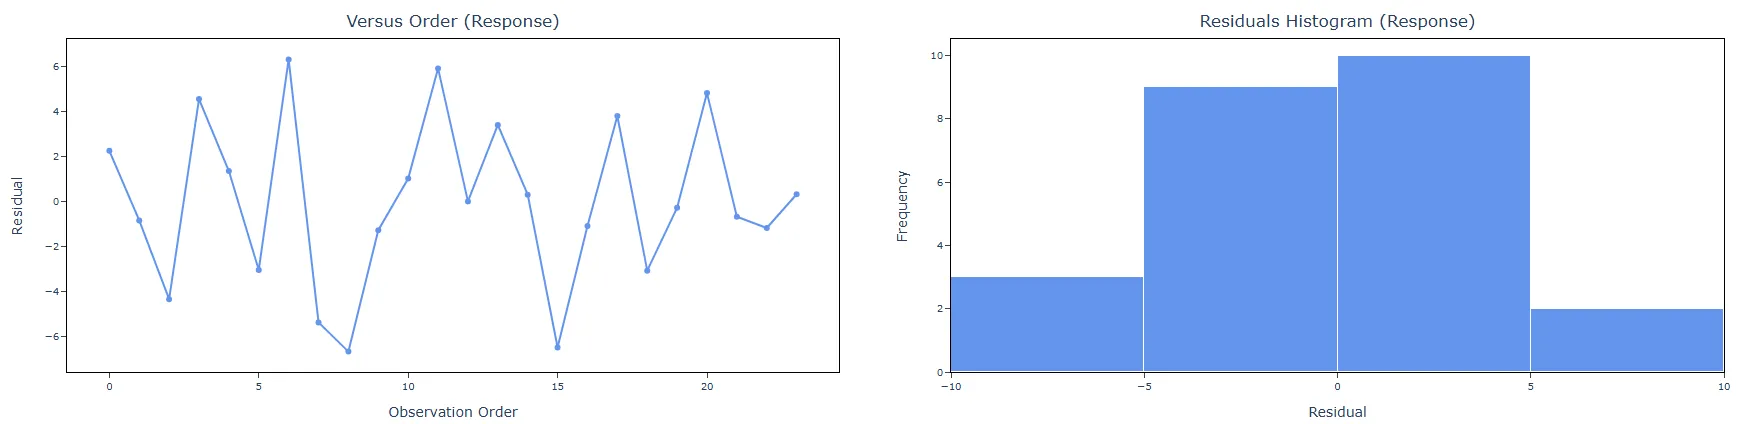
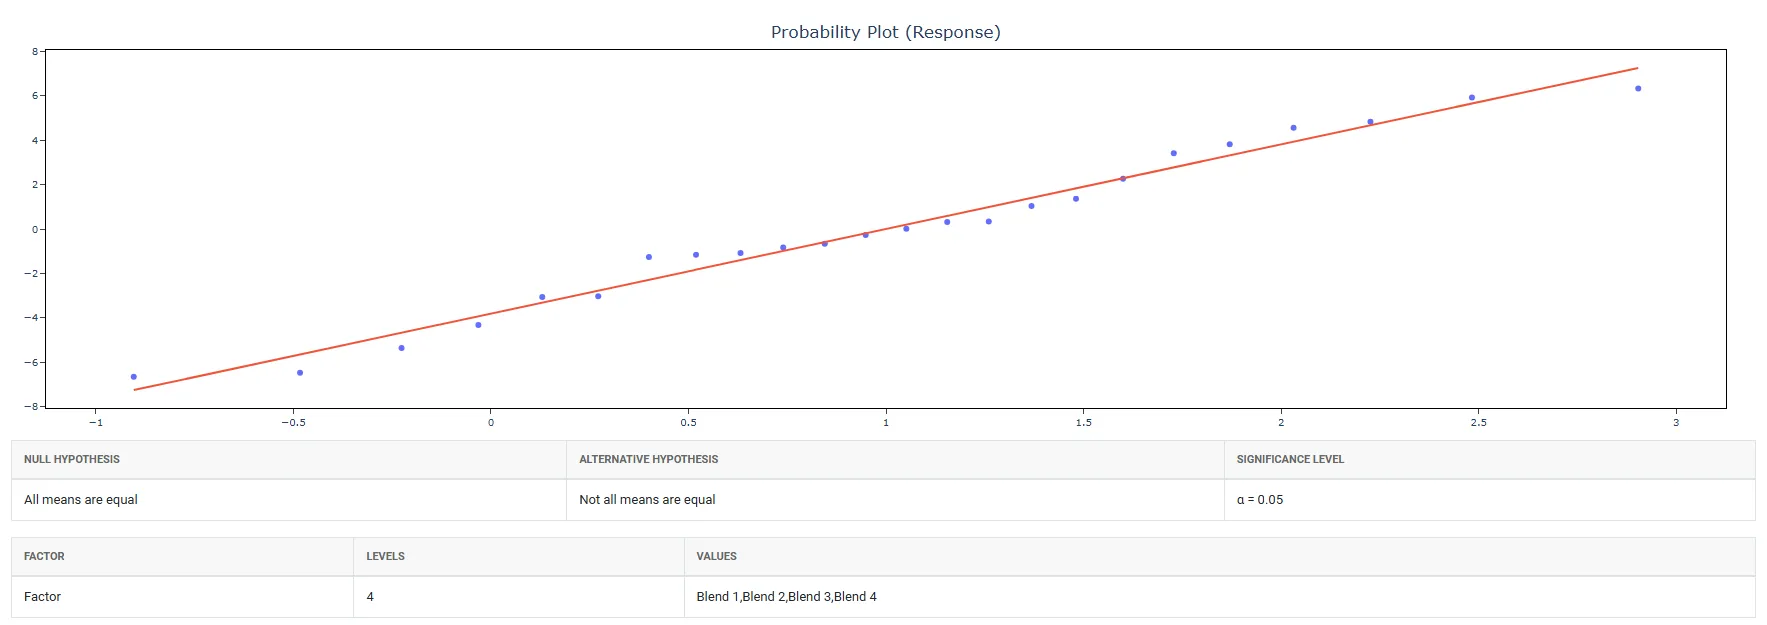
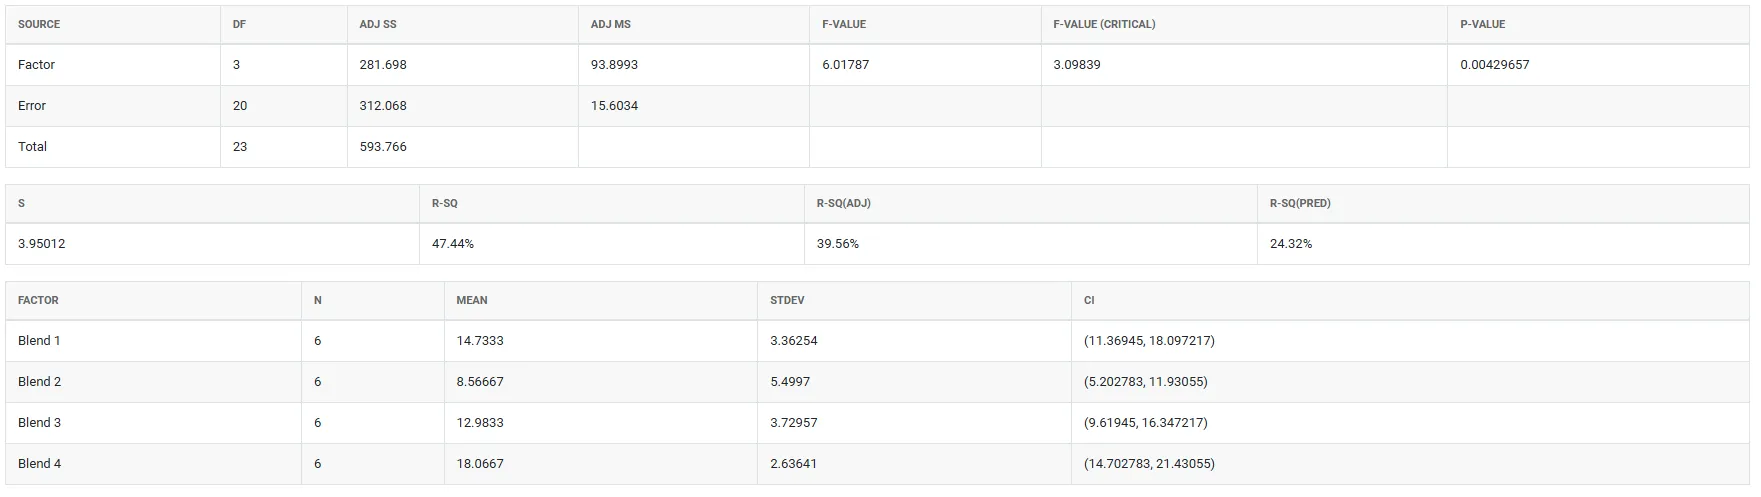
Cómo usar OECD
La guía es la siguiente:
- Inicie sesión en Zometric Statistical Software en https://statsai.zometric.com/
- En la página de inicio, elija Statistical Tool> OECD>OECD.
- A continuación, introduzca los datos manualmente o copie todos los datos (Ctrl+C) de una hoja de Excel y péguelos (Ctrl+V); también puede usar la opción Load Example, con la que se cargarán los datos de ejemplo.
- A continuación, debe completar las opciones necesarias.
- Por último, haga clic en calculate en la parte inferior de la página para obtener los resultados deseados.
En el tablero de OECD, la ventana está dividida en dos partes.
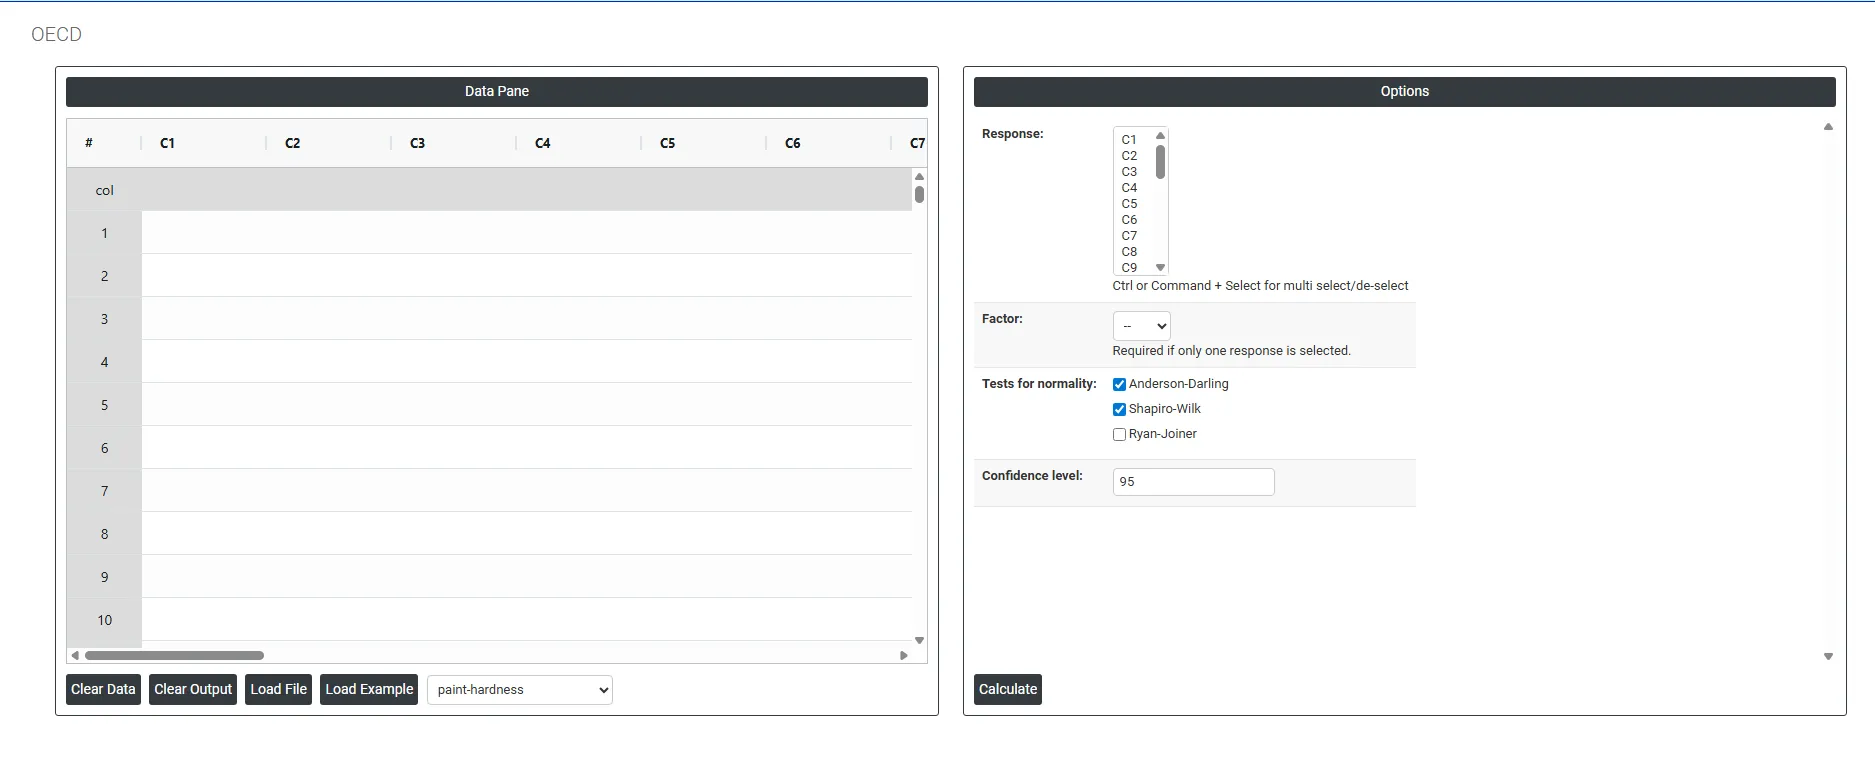
En la parte izquierda se encuentra el panel de datos (Data Pane). En el Data Pane, cada fila forma un subgrupo. Los datos pueden introducirse manualmente o puede copiar todos los datos (Ctrl+C) de una hoja de Excel y pegarlos (Ctrl+V) aquí.
Load example: Se cargarán los datos de ejemplo.
Load File: Se usa para cargar directamente los datos de Excel.
En la parte derecha hay muchas opciones, como las siguientes:
- Response: Seleccione la columna o columnas que contienen las mediciones de resultado que desea analizar, como el peso corporal, la actividad enzimática, la incidencia de tumores, los valores hematológicos o cualquier otro criterio de valoración registrado en los grupos del estudio. Use Ctrl o Command + clic para seleccionar varias columnas de respuesta a la vez.
El número de columnas de respuesta seleccionadas determina directamente si la opción Factor es obligatoria:
Selección
Comportamiento de la herramienta
Varias respuestas seleccionadas
Cada columna seleccionada representa un grupo distinto. La herramienta usa las propias columnas para definir los grupos, por lo que no se necesita ninguna columna Factor adicional. Las mediciones de cada columna se comparan directamente entre sí.
Una sola respuesta seleccionada
Todas las mediciones se apilan en una columna y debe seleccionarse una columna Factor aparte para identificar a qué grupo pertenece cada medición. Sin la columna Factor, la herramienta no puede determinar qué observaciones pertenecen a qué grupo.
⚠ Importante: Cuando se selecciona una sola respuesta, el campo Factor pasa a ser obligatorio. La herramienta le pedirá que seleccione una columna Factor antes de poder continuar con el análisis.
- Factor: Seleccione la columna que identifica la pertenencia de cada observación a un grupo. Esta columna contiene etiquetas o códigos categóricos que indican a qué grupo experimental pertenece cada fila de datos, por ejemplo, Control, Low Dose, Mid Dose, High Dose, o Group 1, Group 2, Group 3. La columna de factor indica a la herramienta cómo dividir la única columna de respuesta en grupos distintos para compararlos. Sin especificar correctamente el factor, todas las mediciones se tratarían como pertenecientes al mismo grupo y no sería posible ninguna comparación significativa. Este campo solo es obligatorio cuando se selecciona exactamente una columna de respuesta. Cuando se seleccionan varias columnas de respuesta, cada columna representa un grupo y no se necesita ningún Factor. El campo aparecerá atenuado o se ignorará cuando se seleccionen varias respuestas.
- Tests for Normality: Define qué prueba o pruebas estadísticas se utilizan en el paso 2 del árbol de decisión para evaluar si los datos de respuesta siguen una distribución normal. El resultado de esta prueba determina si se sigue la ruta analítica paramétrica o no paramétrica durante todo el análisis. Hay tres pruebas disponibles:
- Anderson-Darling : Una potente prueba ómnibus de normalidad que pone especial énfasis en las colas de la distribución, es decir, los valores extremos altos y bajos. Esto la hace especialmente sensible a las desviaciones de la normalidad en las colas, que suelen ser las regiones de mayor importancia práctica en los datos toxicológicos y ambientales. Se recomienda la prueba de Anderson-Darling para un uso de propósito general con una amplia gama de tamaños de muestra, y resulta especialmente eficaz cuando se espera que el comportamiento de las colas difiera de la distribución normal.
- Shapiro-Wilk: Ampliamente considerada la prueba de normalidad más potente y fiable para tamaños de muestra pequeños (normalmente n < 50), que es la situación más común en los estudios según las directrices de la OCDE, donde los tamaños de grupo suelen ser de 5 a 20 animales. La prueba de Shapiro-Wilk es la principal prueba de normalidad citada en la guía estadística de la OCDE y la opción estándar en la estadística farmacéutica y toxicológica. Se recomienda encarecidamente que esta prueba permanezca siempre activa en los análisis de estudios regulatorios.
- Ryan-Joiner: Una prueba de normalidad basada en la correlación que evalúa en qué medida los datos siguen el patrón esperado de una distribución normal midiendo la correlación entre los datos observados y los cuantiles normales teóricos. Es conceptualmente similar a la prueba de Shapiro-Wilk, pero utiliza un enfoque de cálculo distinto. Se requiere con menos frecuencia en trabajos regulatorios, pero puede activarse cuando la autoridad revisora solicita o prefiere específicamente una evaluación de normalidad basada en la correlación.
- Cuando se seleccionan varias pruebas de normalidad, la herramienta ejecuta todas las pruebas marcadas e informa de todos los resultados. La decisión global de normalidad se basa en el resultado más conservador: si cualquiera de las pruebas seleccionadas indica no normalidad (p < α), los datos se tratan como no normales y se sigue la ruta no paramétrica.
Confidence Level (Default: 95): Establece el umbral de significancia que se usa de forma coherente en todas las pruebas de hipótesis del árbol de decisión, incluida la prueba de normalidad, la prueba de homogeneidad de varianzas y la prueba final de comparación de grupos. El valor introducido representa el porcentaje de confianza, y el nivel alfa (α) correspondiente que se usa en todas las decisiones se calcula como (100 − Confidence Level) ÷ 100.
Confidence Level
Nivel alfa y cuándo usarlo
95 (por defecto)
Alfa = 0.05. El nivel de confianza estándar en la mayoría de los estudios científicos y regulatorios de la OCDE. Existe un 5% de probabilidad de una conclusión falsa positiva. Es el nivel que con más frecuencia exigen las directrices de la OCDE y las autoridades regulatorias de todo el mundo.
99
Alfa = 0.01. Una prueba más conservadora: requiere evidencia más sólida antes de declarar un resultado significativo. Reduce los falsos positivos, pero puede pasar por alto efectos reales más pequeños. Úsela cuando las consecuencias de un falso positivo sean especialmente graves.
90
Alfa = 0.10. Una prueba más sensible: detecta diferencias más pequeñas, pero aumenta el riesgo de conclusiones falsas positivas. Solo es adecuada para estudios exploratorios o piloto en los que preocupa más pasar por alto un efecto real.
Preguntas frecuentes
¿Qué es el árbol de decisión estadístico de la OCDE?
La herramienta OECD Statistical Decision Tree es un sistema de análisis guiado que selecciona y aplica la prueba estadística correcta a datos experimentales. Sigue la ruta de decisión de la OCDE, evaluando en cada etapa el tipo de datos, la normalidad, la homogeneidad de varianzas y el número de grupos, de modo que las conclusiones son reproducibles y defendibles. Se utiliza en toxicología, ciencias ambientales, investigación farmacéutica y presentaciones regulatorias.
¿Qué pruebas aplica el árbol de decisión de la OCDE a los datos normales?
Para dos grupos, una prueba F comprueba la varianza: las varianzas iguales conducen a la prueba t de Student y las varianzas desiguales al método de Satterthwaite (prueba t de Welch). Para tres o más grupos, la prueba de Bartlett, de Levene o de Brown-Forsythe comprueba la varianza; con varianzas iguales se aplica el ANOVA, seguido de la prueba de Dunnett frente al control si el ANOVA es significativo.
¿Qué ocurre cuando los datos no son normales en el árbol de decisión de la OCDE?
Si se rechaza la normalidad, se intenta una transformación, como el logaritmo o la raíz cuadrada, y se vuelve a comprobar la normalidad. Si los datos transformados siguen sin ser normales, se sigue la ruta no paramétrica: Kruskal-Wallis con la prueba post hoc de Dunn para tres o más grupos, la prueba U de Mann-Whitney para dos grupos y chi cuadrado para datos categóricos o de índices.
¿Cuándo no se debe usar el árbol de decisión de la OCDE?
No lo use con observaciones pareadas, que requieren una prueba t pareada o la prueba de rangos con signo de Wilcoxon, ni para regresión o modelado dosis-respuesta, datos de series temporales o longitudinales, ni para pruebas de equivalencia y de no inferioridad. Sin un contexto regulatorio de la OCDE, usar directamente la prueba específica más adecuada puede ser más sencillo.