
Regresión de Poisson
La regresión de Poisson modela conteos de eventos en una cantidad fija de tiempo, área o producto frente a predictores continuos y categóricos. Úsela en lugar de la regresión ordinaria porque los conteos no pueden ser negativos y su dispersión crece con la media. Se supone que la respuesta sigue una distribución de Poisson, con enlace logarítmico, de raíz cuadrada o identidad. Las salidas incluyen coeficientes, análisis de devianza, pruebas de bondad de ajuste y gráficas de residuos.
Última revisión:
Idea clave
La regresión de Poisson es un modelo lineal generalizado que relaciona una respuesta de conteo, como defectos por turno o averías por mes, con predictores continuos y categóricos, ajustado por máxima verosimilitud.
En esta página
Finalidad
La regresión de Poisson relaciona una respuesta de conteo, como defectos por turno, averías por mes o imperfecciones por panel, con predictores continuos y categóricos. Úsela en lugar de la regresión ordinaria cuando la respuesta sea un conteo de eventos en una cantidad fija de tiempo, área o producto: los conteos no pueden ser negativos y su dispersión crece con su media, algo que los mínimos cuadrados no contemplan.
Capacidades principales
- Predictores continuos y categóricos, con interacciones y términos al cuadrado de la lista de términos.
- Enlace logarítmico (por defecto), de raíz cuadrada o identidad.
- Selección por pasos (stepwise), selección hacia adelante o eliminación hacia atrás de términos, con términos forzados en todos los modelos.
- Coeficientes con intervalos de confianza y VIF, ecuaciones de regresión para cada nivel de un predictor categórico, resumen del modelo y pruebas de bondad de ajuste.
- Análisis de devianza mediante pruebas de Wald o de razón de verosimilitud (ajustadas o secuenciales).
- Observaciones inusuales, gráficas de residuos, gráficas de efectos principales y de interacción, y gráficas de contorno y de superficie de los conteos ajustados.
- Predicción en los ajustes que usted introduzca y un optimizador de respuesta.
Métodos estadísticos
Se supone que la respuesta sigue una distribución de Poisson con media μ que depende de los predictores a través del enlace: con el enlace logarítmico, ln μ = b₀ + b₁x₁ + … , de modo que cada coeficiente multiplica el conteo esperado por exp(b) por unidad de su predictor. El modelo es un modelo lineal generalizado ajustado por máxima verosimilitud (mínimos cuadrados reponderados iterativamente). Los predictores categóricos usan una codificación (1, 0) respecto a un nivel de referencia, por defecto el primer nivel en el orden de clasificación. Las filas con un valor faltante se descartan; una columna de frecuencia repite filas y una columna de ponderaciones aporta ponderaciones de varianza.
La tabla de coeficientes da los valores z de Wald (Coef / SE Coef) y los intervalos de confianza. El análisis de devianza contrasta cada término: por defecto con un chi cuadrado de Wald (z² para un término continuo, una prueba conjunta para las columnas ficticias de un término categórico); con la prueba LR, mediante el cambio en la devianza cuando el término se elimina del modelo completo (ajustada, Tipo III) o se añade en orden (secuencial, Tipo I). R-Sq de devianza = 1 − devianza residual / devianza nula.
Las pruebas de bondad de ajuste comparan la devianza y el chi cuadrado de Pearson con una distribución chi cuadrado con los grados de libertad del error. Un valor p pequeño, o un Mean (devianza / DF) muy superior a 1, significa que los conteos varían más de lo que permite un modelo de Poisson (sobredispersión), y entonces los valores p de los términos son demasiado pequeños. Las observaciones con un residuo estandarizado fuera de ±2 se marcan con R, y las que tienen un apalancamiento superior a 3p/n se marcan con X.
Campos de entrada y opciones
Campo | Descripción |
Response | Columna de conteos. Obligatorio. |
Continuous Predictors / Categorical Predictor | Columnas de predictores numéricos y de texto (o codificados); al menos una. Ctrl o Command + clic para seleccionar varias. |
Model terms (optional) | Lista de términos: marque los términos, o use Add all, Interactions y Powers hasta el orden elegido en Terms through order (2 o 3). Desmarque In model para quitar un término lineal conservando sus interacciones. |
Reference level (optional) | Para predictores categóricos, “Predictor Level”, separado por comas. Por defecto: el primer nivel en el orden de clasificación. |
Stepwise method | None (por defecto), Stepwise, Forward selection o Backward elimination; con Alpha to enter y Alpha to remove (0.15), reglas de jerarquía, Terms in every model (E), Initial model terms (I) y Model selection details. |
Frequency (optional) / Weights (optional) | Columnas de frecuencias de fila y de ponderaciones. |
Link function | Log (por defecto), Square root o Identity. |
Confidence level / Type of confidence interval | Por defecto 95, Two-sided; o Lower bound o Upper bound. |
Fits and diagnostics for all observations | Muestra el ajuste y el residuo de todas las filas, no solo de las inusuales. |
Test for ANOVA table / Type of deviance (LR test only) | Wald test (por defecto) o LR test; para LR, Adjusted (Type III, por defecto) o Sequential (Type I). |
Residuals for diagnostics/plots | Deviance (por defecto) o Pearson. |
Histogram of residuals / Normal probability plot of residuals / Residuals versus fits / Residuals versus order / Four in one / Residuals versus the variables | Gráficas de residuos. |
Main effects plot / Interaction plot | Conteo ajustado frente a cada predictor, con los demás mantenidos en su media o nivel de referencia. |
Contour plot / Surface plot / Overlaid contour plot of fitted values | Requieren las variables de los ejes X1 y X2; la gráfica de contorno superpuesta requiere además Response low y Response high. |
Prediction / Response Optimizer | Añade un panel para predecir el conteo medio (con SE e intervalo de confianza) en los ajustes que usted introduzca, o para buscar los ajustes que cumplan un objetivo de conteo. |
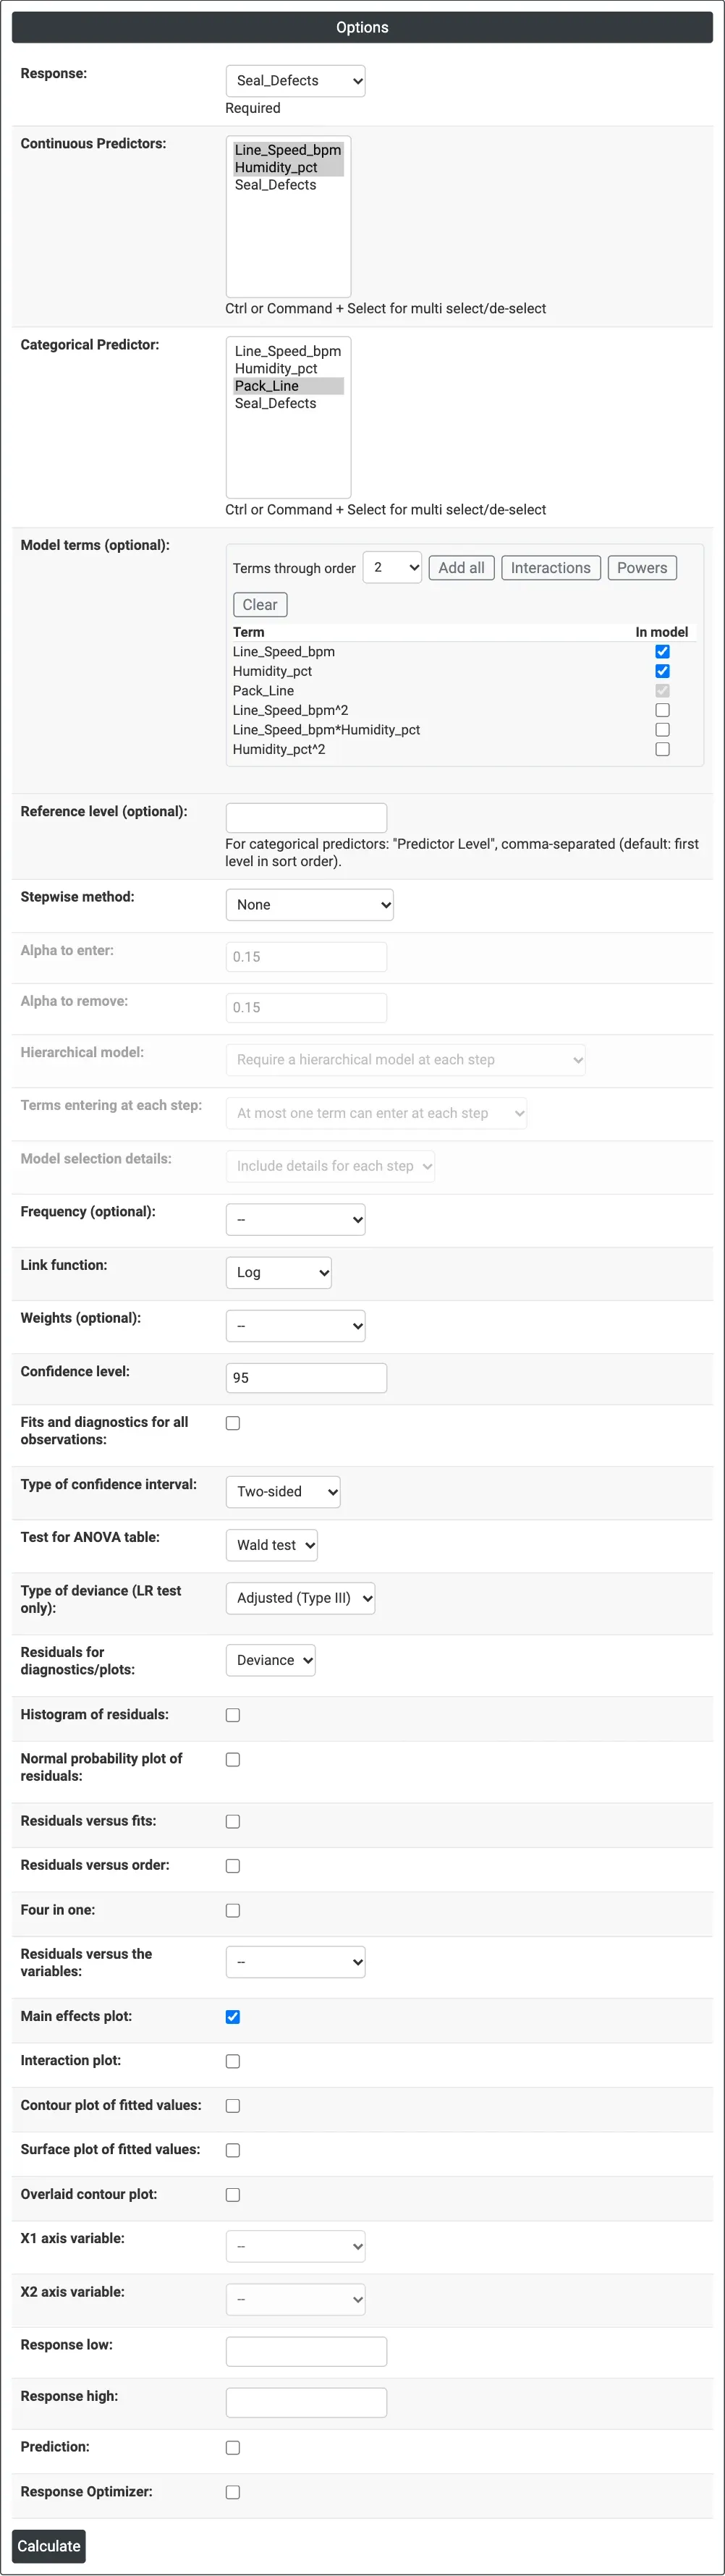
Figura 1: opciones del ejemplo de sellado de bolsas: Seal_Defects como respuesta, velocidad de línea y humedad como predictores continuos, línea de envasado como predictor categórico, gráfica de efectos principales marcado.
Descripción de la salida
- Method: función de enlace, codificación categórica y filas utilizadas.
- Response Information: N, media, desviación estándar, mínimo y máximo de los conteos.
- Coefficients: Coef, SE Coef, Z-Value, P-Value, límites de confianza y VIF.
- Regression Equation: el predictor lineal Y' (ln del conteo esperado con el enlace logarítmico) para cada nivel de los predictores categóricos.
- Model Summary: R-Sq de devianza, Adj R-Sq, AIC, AICc y BIC.
- Goodness-of-Fit Tests: pruebas de chi cuadrado de devianza y de Pearson.
- Fits and Diagnostics for Unusual Observations.
- Analysis of Deviance: chi cuadrado y valor p de la regresión y de cada término.
- Tabla de selección por pasos, gráficas de residuos, factoriales, de contorno y de superficie, y paneles de predicción y de optimizador cuando se seleccionan.
- Exportación a PDF mediante Download.
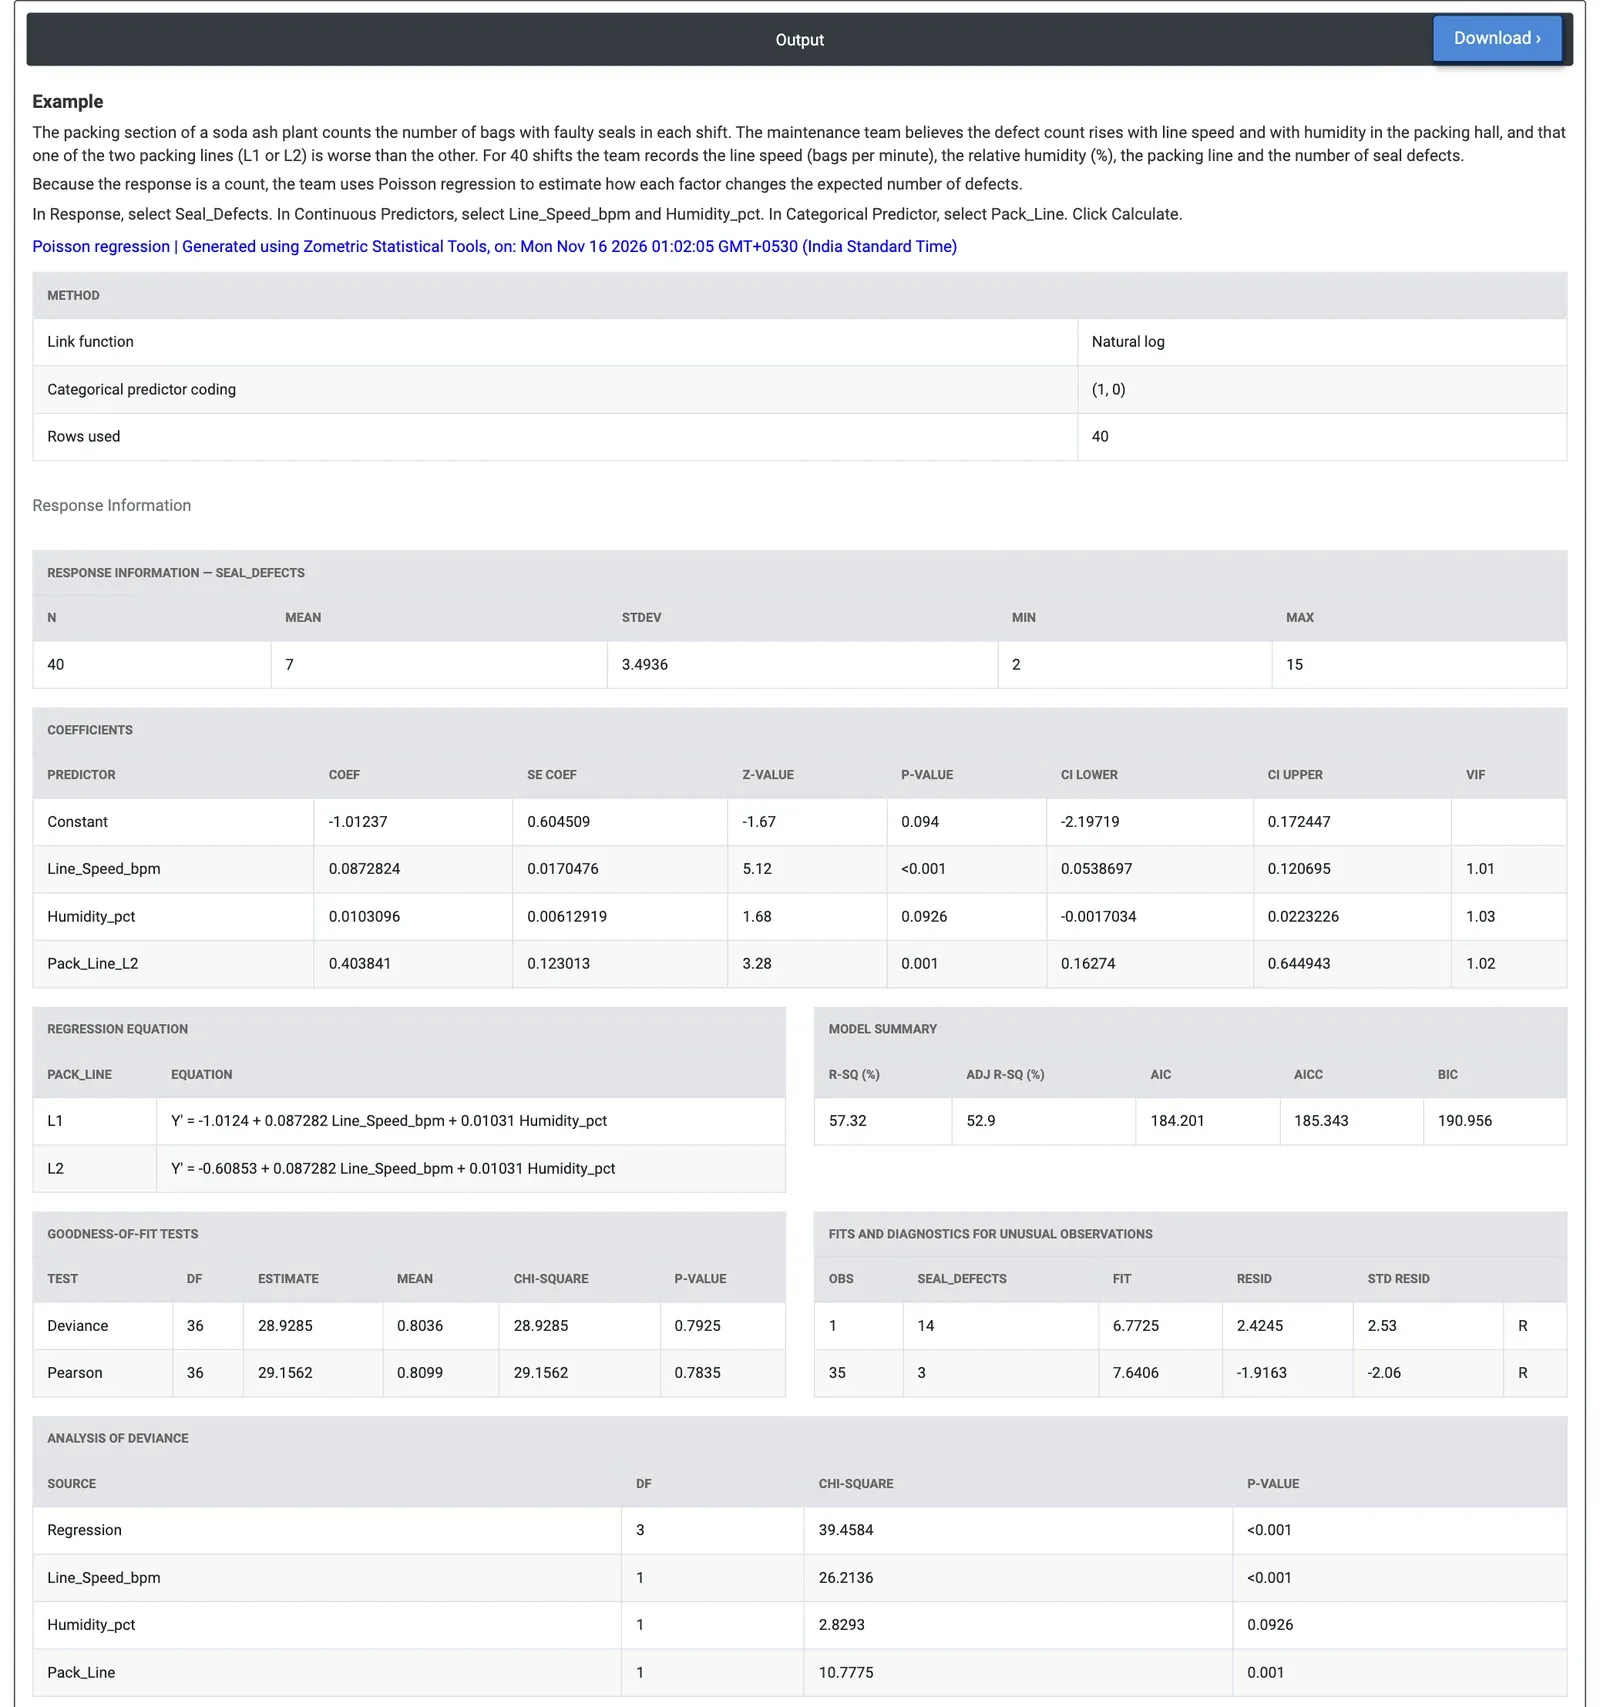
Figura 2: regresión de Poisson de los defectos de sellado por turno: la velocidad de línea (p < 0.001) y la línea de envasado (p = 0.001) importan; la humedad no al nivel del 5% (p = 0.0926).
Ejemplo
La sección de envasado de una planta de carbonato de sodio cuenta las bolsas con sellos defectuosos en cada turno. Durante 40 turnos, el equipo registra la velocidad de línea (bolsas por minuto), la humedad de la sala de envasado (%), la línea de envasado (L1 o L2) y el número de defectos de sellado (de 2 a 15, media 7). Seleccionan Seal_Defects como respuesta, la velocidad de línea y la humedad como predictores continuos y Pack_Line como predictor categórico, y mantienen el enlace logarítmico.
La velocidad de línea tiene el efecto más fuerte (chi cuadrado de Wald 26.21, p < 0.001): su coeficiente 0.0873 significa que cada bolsa adicional por minuto multiplica los defectos esperados por exp(0.0873) = 1.09, y 5 bolsas por minuto más rápido, por aproximadamente 1.55. La línea L2 tiene un coeficiente de 0.404 (p = 0.001), por lo que, con la misma velocidad y humedad, produce aproximadamente 1.50 veces más defectos de sellado que L1. La humedad apunta en el mismo sentido (aproximadamente un 11% más de defectos por cada 10% de HR), pero no es significativa al nivel del 5% (p = 0.0926).
El modelo ajusta los conteos: chi cuadrado de devianza 28.93 con 36 DF (p = 0.7925) y Pearson 29.16 (p = 0.7835), con Mean inferior a 1, por lo que no hay indicio de sobredispersión. Se marcan dos turnos: el turno 1, con 14 defectos frente a un ajuste de 6.8, y el turno 35, con 3 frente a 7.6. El equipo revisa primero las mordazas de sellado de L2 y el punto de consigna de velocidad, y sigue recopilando datos de humedad antes de decidir sobre la deshumidificación.
Preguntas frecuentes
¿Cuándo se debe usar la regresión de Poisson en lugar de la regresión por mínimos cuadrados ordinarios?
Use la regresión de Poisson cuando la respuesta sea un conteo de eventos en una cantidad fija de tiempo, área o producto, como defectos por turno o averías por mes. Los conteos no pueden ser negativos y su dispersión crece con su media, algo que la regresión por mínimos cuadrados no contempla. La regresión de Poisson lo resuelve como un modelo lineal generalizado ajustado por máxima verosimilitud.
¿Cómo se interpretan los coeficientes de la regresión de Poisson?
Con el enlace logarítmico por defecto, el ln del conteo esperado es igual a b0 + b1x1 + ..., de modo que cada coeficiente multiplica el conteo esperado por exp(b) por cada unidad de aumento de su predictor. Por ejemplo, un coeficiente de velocidad de línea de 0.0873 significa que cada bolsa adicional por minuto multiplica los defectos esperados por exp(0.0873) = 1.09. Los predictores categóricos se comparan con un nivel de referencia.
¿Cómo se comprueba la sobredispersión en la regresión de Poisson?
Las pruebas de bondad de ajuste comparan la devianza y el chi cuadrado de Pearson con una distribución chi cuadrado con los grados de libertad del error. Un valor p pequeño, o un Mean (devianza dividida por DF) muy superior a 1, significa que los conteos varían más de lo que permite un modelo de Poisson. En ese caso, los valores p de los términos del modelo son demasiado pequeños y no deben tomarse como fiables.
¿Cómo se marcan las observaciones inusuales en la regresión de Poisson?
Las observaciones con un residuo estandarizado fuera de más o menos 2 se marcan con R, y las observaciones con un apalancamiento superior a 3p/n se marcan con X. Se enumeran en la tabla Fits and Diagnostics for Unusual Observations, y pueden añadirse gráficas de residuos, como residuos frente a ajustes y una gráfica de probabilidad normal de los residuos, para examinarlas con más detalle.