
Potencia y tamaño de muestra para ANOVA de un factor
Planifica un ANOVA de un factor que compara las medias de varios grupos. Introduzca el número de niveles, una desviación estándar común y dos de estos datos: tamaño de muestra por nivel, diferencia máxima entre medias y potencia; la herramienta calcula el tercero. Supone grupos normales con desviaciones estándar iguales y un diseño balanceado, y usa la disposición de medias menos favorable, por lo que los resultados son conservadores.
Última revisión:
Idea clave
Potencia y tamaño de muestra para ANOVA de un factor calcula cuántas unidades necesita cada grupo para detectar una diferencia máxima dada entre tres o más medias, la potencia de un diseño planificado o la diferencia detectable.
En esta página
Propósito
Potencia y tamaño de muestra para ANOVA de un factor planifica una comparación de las medias de tres o más grupos, como varios hornos, proveedores, operadores o recetas. El tamaño del efecto se introduce como la diferencia máxima entre dos medias de grupo cualesquiera que se desea detectar. Introduzca dos de estos datos: tamaño de muestra por nivel, diferencia máxima y potencia, y la herramienta calcula el tercero: cuántas unidades necesita cada grupo, qué potencia ofrece un diseño planificado, o la mayor diferencia entre la media más alta y la más baja que puede detectar un diseño dado. Úsela antes de un ANOVA de un factor.
Capacidades principales
- Calcula el tamaño de muestra, la potencia o la diferencia máxima: deje en blanco el que desee obtener.
- Varios valores a la vez, p. ej., diferencias máximas “1.5 2” y valores de potencia “0.8 0.9”, dan una fila por cada combinación.
- Cualquier número de niveles desde 2, con un diseño balanceado (el mismo tamaño de muestra en cada nivel).
- Al calcular el tamaño de muestra, informa del número entero por nivel y de la potencia real que ofrece.
- Curva de potencia frente al tamaño de muestra por nivel para cada diferencia máxima, con los puntos calculados marcados.
Métodos estadísticos
El cálculo supone k grupos independientes de poblaciones normales con una desviación estándar común σ y n unidades por nivel (N = n·k en total). El nivel de significancia es α = 1 − nivel de confianza / 100. Para convertir la diferencia máxima Δ en un tamaño del efecto, la herramienta usa la disposición de medias que da la menor potencia para ese Δ, como hace Minitab: dos niveles en −Δ/2 y +Δ/2 y los otros k − 2 niveles en la media global. El tamaño del efecto es f = σₘ/σ, donde σₘ es la desviación estándar de esas k medias, de modo que σₘ² = Δ²/(2k).
La potencia es la probabilidad de que la prueba F del ANOVA rechace la hipótesis de medias iguales. Se calcula a partir de la distribución F no central con k − 1 y N − k grados de libertad y parámetro de no centralidad λ = f²·N. Para el tamaño de muestra, se halla el total N que da la potencia objetivo, se divide entre k y se redondea hacia arriba por nivel, y la potencia en ese tamaño se informa como potencia real. Para la diferencia máxima, se halla el tamaño del efecto que alcanza la potencia objetivo y se convierte de nuevo a Δ.
Como se trata de la disposición menos favorable, la respuesta es conservadora: si las medias están más dispersas, por ejemplo dos niveles en cada extremo, la potencia real es mayor que la informada y bastarían menos unidades (véase el ejemplo). Con dos niveles solo hay una disposición.
Campos de entrada y opciones
Campo | Descripción |
Sample sizes | Por nivel (diseño balanceado). Separados por espacios o comas, p. ej., “10 20 30”. Déjelo en blanco para calcular el tamaño de muestra. |
Maximum difference between means | Separadas por espacios o comas, p. ej., “1 2 3”. La diferencia entre la media más alta y la más baja que se desea detectar. Déjelo en blanco para calcular la diferencia. |
Power values | Separados por espacios o comas, p. ej., “0.8 0.9”. Déjelo en blanco para calcular la potencia. |
Standard deviation | Obligatorio. Desviación estándar común supuesta o histórica, igual para todos los niveles. |
Number of levels | Obligatorio, al menos 2. Número de grupos que se comparan. |
Confidence level | Valor predeterminado 95 (α = 0.05); de 75 a 100. |
Power curve | Marcada de forma predeterminada: dibuja la potencia frente al tamaño de muestra por nivel. |
Title | Título que se muestra en la salida y en la curva de potencia. |
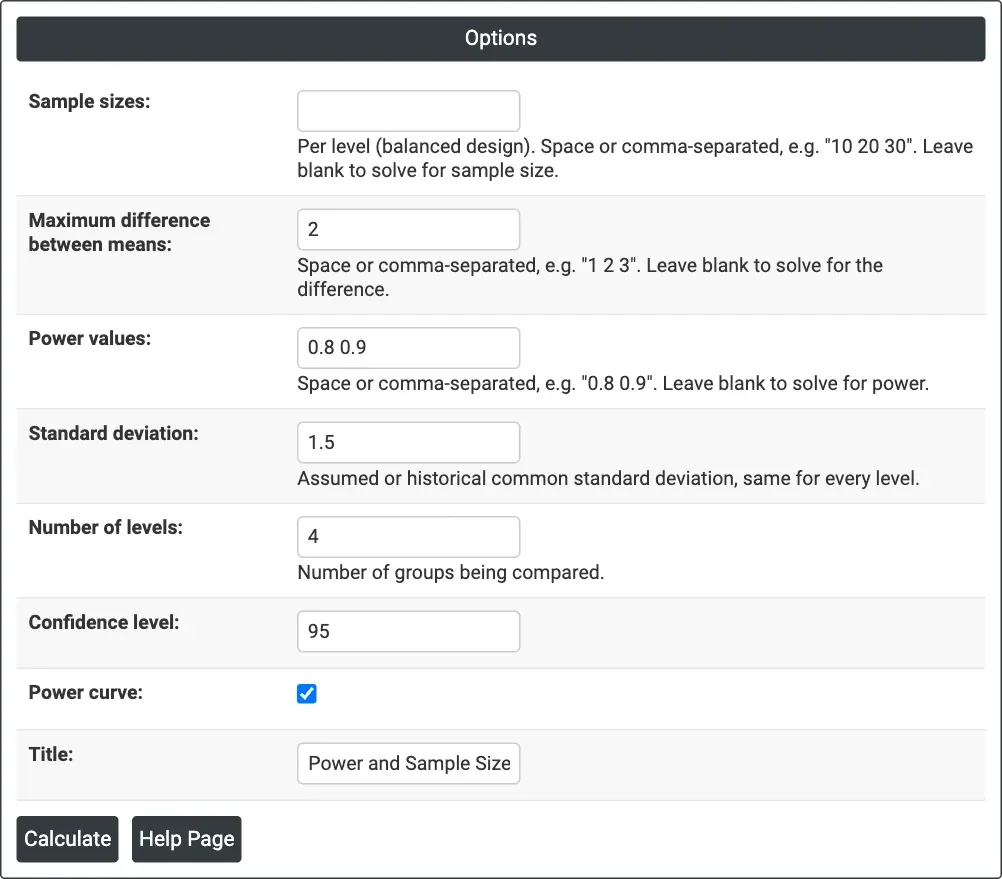
Figura 1 — Cálculo del tamaño de muestra: Maximum difference between means = 2, Power values = 0.8 0.9, Standard deviation = 1.5, Number of levels = 4, con un 95% de confianza.
Descripción de las salidas
- Settings — qué se calculó, el número de niveles, la desviación estándar y el nivel de confianza.
- Results — una fila por combinación: diferencia máxima, tamaño de muestra por nivel y potencia objetivo y real al calcular el tamaño de muestra, o potencia al calcular la potencia, o diferencia máxima al calcularla.
- Power Curve — potencia frente al tamaño de muestra por nivel para cada diferencia máxima, con los puntos calculados marcados.
- Exportación a PDF mediante Download.
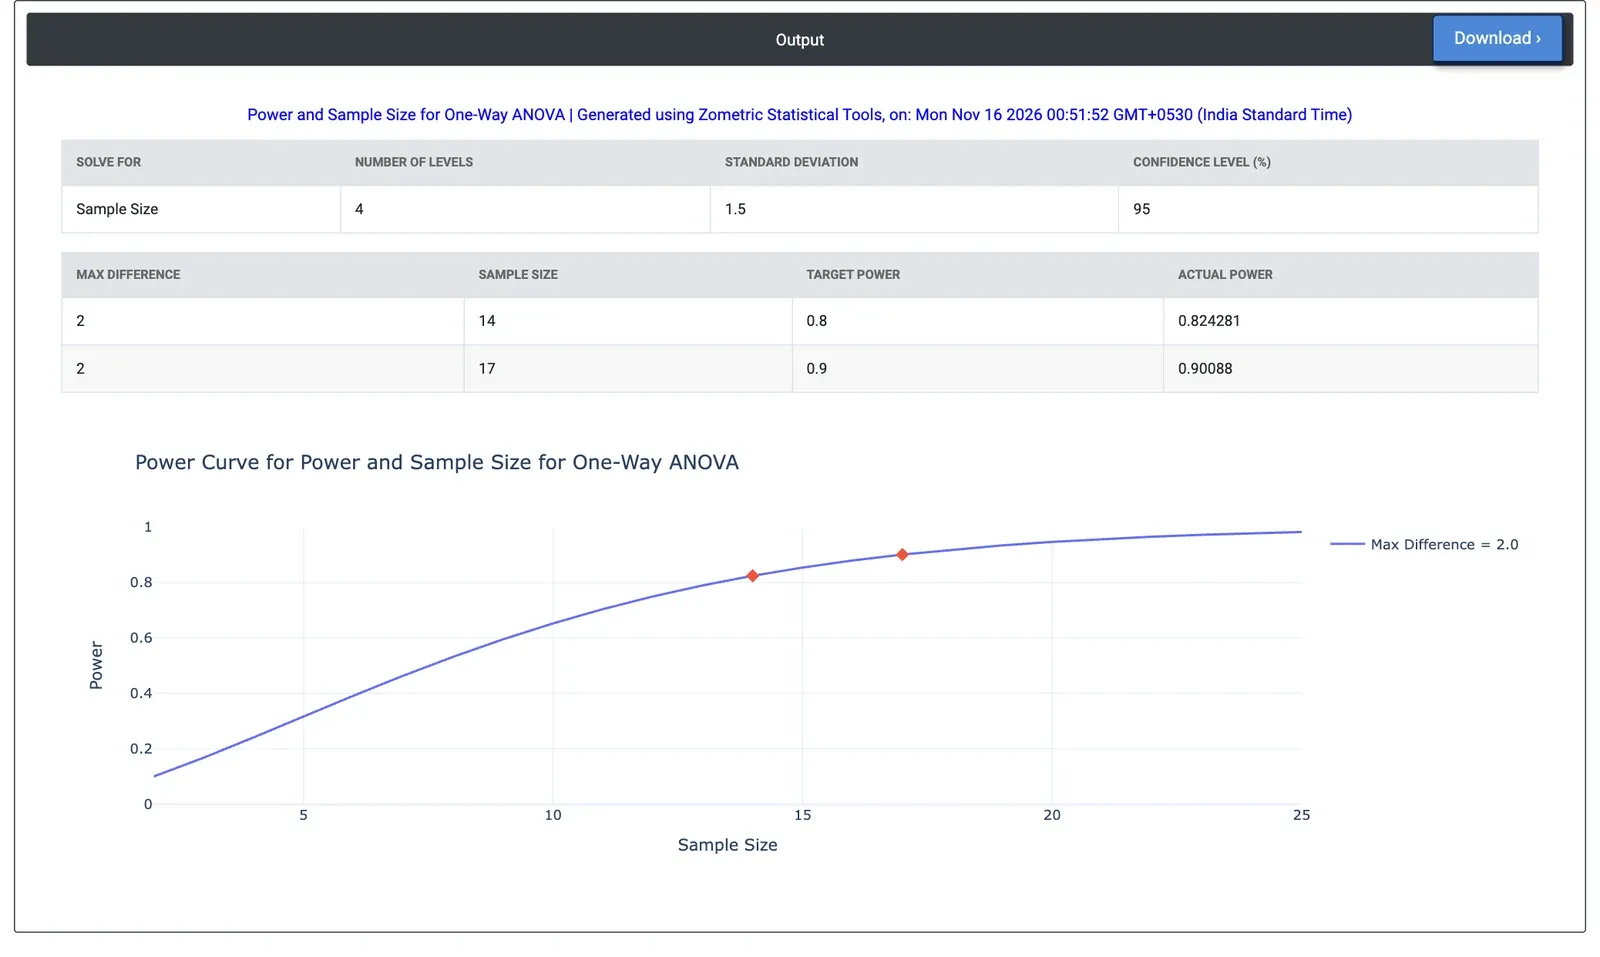
Figura 2 — Resultados del ejemplo: 14 piezas por horno para una potencia del 80% (real 0.824) y 17 para una potencia del 90% (real 0.901).
Ejemplo
Un taller de tratamiento térmico opera cuatro hornos y quiere comprobar si dan la misma dureza superficial media. Una diferencia de 2 HRC entre el mejor y el peor horno sería relevante, y la desviación estándar de la dureza dentro de un horno es de aproximadamente 1.5 HRC. El metalurgista deja Sample sizes en blanco e introduce Maximum difference between means = 2, Power values = 0.8 0.9, Standard deviation = 1.5 y Number of levels = 4, con un 95% de confianza.
La herramienta requiere 14 piezas por horno para una potencia del 80% (potencia real 0.824) y 17 por horno para una potencia del 90% (potencia real 0.901), es decir, 56 y 68 piezas en total. Con 8 piezas por horno la potencia sería de solo 0.532, y con 5 piezas, 0.317. Con 14 piezas por horno y una potencia del 80%, la diferencia máxima más pequeña que puede detectar el estudio es 1.94 HRC. Estas cifras suponen el patrón menos favorable: un horno alto, uno bajo y los otros dos en un punto intermedio. Si en cambio dos hornos están en cada extremo, 8 piezas por horno ya darían una potencia de 0.852, por lo que el plan peca de prudente.
Preguntas frecuentes
¿Cómo se calcula la potencia de un ANOVA de un factor?
La potencia es la probabilidad de que la prueba F del ANOVA rechace la igualdad de medias. Se calcula a partir de la distribución F no central con k - 1 y N - k grados de libertad. La diferencia máxima se convierte en un tamaño del efecto usando la disposición de medias menos favorable: dos niveles en menos y más la mitad de la diferencia y los niveles restantes en la media global.
¿Por qué el tamaño de muestra del ANOVA de un factor es conservador?
La herramienta supone la disposición de medias de grupo que da la menor potencia para la diferencia máxima introducida. Si las medias están más dispersas, por ejemplo dos niveles en cada extremo, la potencia real es mayor que la informada y bastarían menos unidades. En el ejemplo, 8 piezas por horno darían una potencia de 0.852 con ese patrón más favorable.
¿Cuántas muestras por grupo se necesitan para un ANOVA de un factor?
En un ejemplo con cuatro hornos, una desviación estándar de 1.5 HRC y una diferencia máxima de 2 HRC con un 95% de confianza, 14 piezas por horno dan una potencia del 80% y 17 dan el 90%, es decir, 56 y 68 piezas en total. Con 8 piezas por horno la potencia es 0.532, y con 5 piezas, 0.317.
¿Cuáles son los supuestos del cálculo de potencia del ANOVA de un factor?
Supone k grupos independientes de poblaciones normales con una desviación estándar común y un diseño balanceado, con el mismo tamaño de muestra en cada nivel. El número de niveles debe ser al menos 2 y la desviación estándar es obligatoria, normalmente a partir de datos históricos. Con dos niveles solo hay una disposición posible de las medias.